
Microsoft Azure-ი Hugging Face-თან თანამშრომლობას აფართოებს: 10,000-ზე მეტი AI მოდელი Azure AI Foundry-ზე
Microsoft-მა და Hugging Face-მა გააფართოვეს სტრატეგიული თანამშრომლობა, რის შედეგადაც Azure AI Foundry-ზე 10,000-ზე მეტი Hugging Face-ის ღია მოდელი გახდა ხელმისაწვდომი. ეს ინიციატივა დეველოპერებსა და საწარმოებს საშუალებას აძლევს, მარტივად განათავსონ AI აპლიკაციები ტექსტთან, აუდიოსთან და გამოსახულებებთან სამუშაოდ, ღია კოდის გამჭვირვალობისა და Azure-ის უსაფრთხო, საწარმოო დონის ინფრასტრუქტურის გამოყენებით. თანამშრომლობა მიზნად ისახავს AI-ის ინოვაციის დაჩქარებას და ორგანიზაციებს საკუთარი AI ბედის კონ
დიდი ენობრივი მოდელების „ჰალუცინაციების“ საზომი ლიდერბორდი
„ჰალუცინაციების ლიდერბორდი“ წარმოადგენს ყოვლისმომცველ ღია პლატფორმას, რომელიც კონტექსტური სწავლების მეშვეობით აფასებს დიდი ენობრივი მოდელების (LLMs) მიერ გენერირებულ კონტენტში არსებულ „ჰალუცინაციებს“. ეს პროექტი, რომელზეც უკვე გამოქვეყნებულია სამეცნიერო ნაშრომი, მიზნად ისახავს ხელოვნური ინტელექტის სანდოობის გაუმჯობესებას. „ჰალუცინაციები“ იყოფა ფაქტობრივ (როცა მოდელი რეალურ ფაქტებს ეწინააღმდეგება) და ერთგულების (როცა კონტენტი არ ემთხვევა მომხმარებლის ინსტრუქციებს ან კონტექსტს) ტიპებად. ლიდერბორდი

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M
ახალი LLM ლიდერბორდი რეალურ ბიზნეს სცენარებში ენის მოდელების შეფასებისთვის
ეს ლიდერბორდი მიზნად ისახავს ენის დიდი მოდელების (LLM) მუშაობის შეფასებას რეალური ბიზნეს ამოცანების კონტექსტში. ის მხარს უჭერს 6 მრავალფეროვან დავალებას, როგორიცაა FinanceBench და იურიდიული კონფიდენციალურობა, და ზომავს მოდელების ეფექტურობას ისეთი მეტრიკებით, როგორიცაა სიზუსტე, ჩართულობა და ტოქსიკურობა. ლიდერბორდი შემუშავდა იმისათვის, რომ დაეხმაროს მომხმარებლებს პრაქტიკული გამოყენებისთვის საუკეთესო მოდელის არჩევაში და აქტიურად ცდილობს თავიდან აიცილოს ტესტ-კომპლექტის დაბინძურება ზოგიერთი მონაცემთა

Falcon-Arabic: ტექნოლოგიური ინსტიტუტის ახალი ენის მოდელი არაბული ხელოვნური ინტელექტის საზღვრებს ცვლის
არაბთა გაერთიანებული საამიროების ტექნოლოგიური ინოვაციების ინსტიტუტმა (TII) წარმოადგინა Falcon-Arabic, 7 მილიარდი პარამეტრის მრავალენოვანი ენის მოდელი, რომელიც ახალ სტანდარტებს ადგენს არაბული ბუნებრივი ენის დამუშავებისთვის (NLP). Falcon 3 არქიტექტურაზე აგებული, Falcon-Arabic მნიშვნელოვნად აღემატება არსებულ არაბულ LLM-ებს ეფექტურობითა და შესაძლებლობებით, რაც ხელს უწყობს არაბულენოვანი საზოგადოებების სრულ ინტეგრაციას ხელოვნური ინტელექტის რევოლუციაში და უზრუნველყოფს უფრო ბუნებრივ, ინტელექტუალურ და ინ
PatchTST: ინოვაციური მოდელი დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით
ICLR 2023-ზე წარდგენილი PatchTST მოდელი რევოლუციურ მიდგომას გვთავაზობს დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით. მოდელი ეფუძნება ინდივიდუალური დროითი რიგების „პაჩებად“ დაყოფას, რაც არაერთ სარგებელს იძლევა. სტატიაში აღწერილია PatchTST-ის ვარჯიში Electricity მონაცემთა ნაკრებზე და მისი ტრანსფერული სწავლის შესაძლებლობები ETTh1 მონაცემთა ნაკრებზე, სადაც ნაჩვენებია მნიშვნელოვანი გაუმჯობესება ნულოვანი სწავლის (zero-shot), წრფივი გამოძიების (linear probing) და სრული ფაინ

Falcon-H1: ხელოვნური ინტელექტის მოდელების ინოვაციური სერია ჰიბრიდული არქიტექტურით
წარმოგიდგენთ Falcon-H1 სერიას, ექვს ღია კოდის მოდელს 0.5B-დან 34B პარამეტრამდე, რომლებიც ხელმისაწვდომია როგორც საბაზო, ასევე ინსტრუქციებზე მორგებულ ვარიანტებში. ამ მოდელების გულში დგას ჰიბრიდული არქიტექტურა, რომელიც აერთიანებს კლასიკური ტრანსფორმერზე დაფუძნებული ყურადღების მექანიზმისა და მდგომარეობის სივრცის მოდელის (SSM) ძლიერ მხარეებს. ეს ინოვაციური მიდგომა უზრუნველყოფს უპრეცედენტო წარმადობას, მაღალ ეფექტურობას და ფართო მასშტაბურობას, რაც Falcon-H1-ს კონკურენტუნარიანს ხდის წამყვან ტრანსფორმერზ

„პატარა აგენტები“ პითონში: ახალი ეპოქა LLM-ების და ინსტრუმენტების ურთიერთქმედებაში
ეს ბლოგპოსტი წარმოგიდგენთ „პატარა აგენტების“ (Tiny Agents) პითონზე პორტირებას, სადაც `huggingface_hub` კლიენტის SDK გაფართოვდა, რათა იმოქმედოს როგორც MCP კლიენტი. მთავარი სიახლეა MCP (მოდელის კონტექსტის პროტოკოლი), ღია სტანდარტი, რომელიც აერთიანებს დიდი ენობრივი მოდელების (LLM) გარე ინსტრუმენტებთან და API-ებთან ურთიერთქმედებას, რითაც აღარ საჭიროებს ყოველი ინსტრუმენტისთვის მორგებულ ინტეგრაციებს. სტატია განმარტავს, თუ როგორ უნდა დაიწყოთ მუშაობა პითონის აგენტებთან, რომლებიც დაკავშირებულია MCP სერვე

LLM-ების ოპტიმიზაცია: TRL-ის ახალი მიდგომა GRPO სწავლების მეხსიერების შესამცირებლად
დიდი ენობრივი მოდელების (LLM) დახვეწა განმტკიცებითი სწავლის (RL) გამოყენებით გადამწყვეტია რთული ქცევების მისაღწევად. ტრადიციულად ამისთვის გამოიყენება PPO ალგორითმი RLHF-თან ერთად, რაც, თუმცა, რესურსმომხმარებელია და მრავალი მოდელის მეხსიერებაში ჩატვირთვას მოითხოვს. DeepSeek-ის R1 მოდელთან ერთად პოპულარობას იძენს ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO), რომელიც იყენებს შემოწმებად ჯილდოს ფუნქციებს გარე ჯილდოს მოდელის გარეშე, რაც მნიშვნელოვან გაუმჯობესებას იძლევა. მიუხედავად ამისა, RL სწავლე
SegMoE მოდელების გამოშვება: როგორ გავაერთიანოთ დიფუზიური მოდელები მარტივად
SegMoE წარმოადგენს ახალ მიდგომას დიფუზიური მოდელების შექმნაში, რომელიც სტეიბლ დიფუჟენის არქიტექტურას ეფუძნება და Mixtral 8x7b-ის მსგავსად, რამდენიმე მოდელს ერთში აერთიანებს. ის Feed-Forward შრეებს ცვლის იშვიათი MoE შრით, რომელიც ექსპერტთა როუტერულ ქსელს იყენებს. SegMoE პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა, რაც აუმჯობესებს პრომპტების გაგებას. მოდელი მხარს უჭერს Hugging Face-ისა და CivitAI-ის პლატფორმებს. თუმცა, მას აქვს შეზღუდვები, როგორიცაა ნელი სიჩქარე და VRAM-ის მაღალი მ

SmolVLA: ახალი კომპაქტური, ღია კოდის VLA მოდელი რობოტიკისთვის, რომელიც ხელმისაწვდომს ხდის AI კვლევებს
დღეს წარმოდგენილია SmolVLA – კომპაქტური (450M), ღია კოდის Vision-Language-Action (VLA) მოდელი რობოტიკისთვის, რომელიც მომხმარებლისთვის განკუთვნილ აპარატურაზე მუშაობს. მიუხედავად იმისა, რომ ხელოვნური ინტელექტის სფეროში ტრანსფორმერებმა მნიშვნელოვან პროგრესს მიაღწიეს, რობოტიკაში განვითარება შედარებით ნელი ტემპით მიმდინარეობდა, რაც განპირობებულია მაღალი ხარისხის მონაცემების ნაკლებობით და დახურული, ძვირადღირებული მოდელების დომინირებით. SmolVLA მიზნად ისახავს ამ ხარვეზის აღმოფხვრას ღია კოდის, ეფექტური
LoRA ადაპტერების შერწყმის ახალი მეთოდები AI მოდელებში
ეს პოსტი Hugging Face-ის PEFT ბიბლიოთეკაში LoRA ადაპტერების შერწყმის ინოვაციურ მეთოდებს წარმოგიდგენთ. ის დეტალურად განიხილავს, თუ როგორ შეიძლება ერთი და იგივე საბაზისო მოდელიდან მიღებული სხვადასხვა ადაპტერების გაერთიანება, რათა მიღებულ იქნეს ოპტიმალური შედეგები, მეხსიერების შეზღუდვის მიუხედავად. აღწერილია კონკატენაციის, შეწონილი ჯამის, ამოცანის არითმეტიკისა და TIES მეთოდები, კოდის მაგალითებითა და სამომავლო გეგმებით.
Open Ko-LLM ლიდერბორდი: კორეული ხელოვნური ინტელექტის განვითარების ახალი ეტაპი
Upstage-მა 2023 წლის სექტემბერში Open Ko-LLM ლიდერბორდი წარადგინა, რომლის მიზანიც კორეული დიდი ენობრივი მოდელების (LLM) შეფასების ეკოსისტემის შექმნა და გამჭვირვალობის ხელშეწყობა იყო. პლატფორმა, რომელიც კორეული ენის უნიკალურ მახასიათებლებს ითვალისწინებს, მოკლე დროში დიდი პოპულარობით სარგებლობს, 5 თვეში 1000-ზე მეტი მოდელის წარდგენით. მიუხედავად ინფრასტრუქტურული გამოწვევებისა, ლიდერბორდი აქტიურად ვითარდება, რათა რეალურ სამყაროში გამოყენების შემთხვევებს უკეთ მოერგოს და კორეული AI-ის განვითარებას ხე

KV ქეშირება nanoVLM-ში: 38%-იანი აჩქარება გენერაციაში
ეს ბლოგ-პოსტი აღწერს KV ქეშირების ტექნიკას, რომელიც nanoVLM საცავში ნულიდან დავნერგეთ და რომელმაც ენობრივი მოდელების გენერაციაში 38%-იანი აჩქარება მოგვცა. სტატია განმარტავს ავტორეგრესიულ მოდელებში გამოთვლითი სიჭარბის პრობლემას და იმას, თუ როგორ აგვარებს მას KV ქეშირება Q, K, V მნიშვნელობების შენახვით. მოცემულია თეორიული საფუძვლები, nanoVLM-ში პრაქტიკული იმპლემენტაცია და ზოგადი გაკვეთილები, რომლებიც ყველა ავტორეგრესიული ენობრივი მოდელის გენერაციას ეხება. ეს ოპტიმიზაცია აუცილებელია LLM-ების ეფექტუ
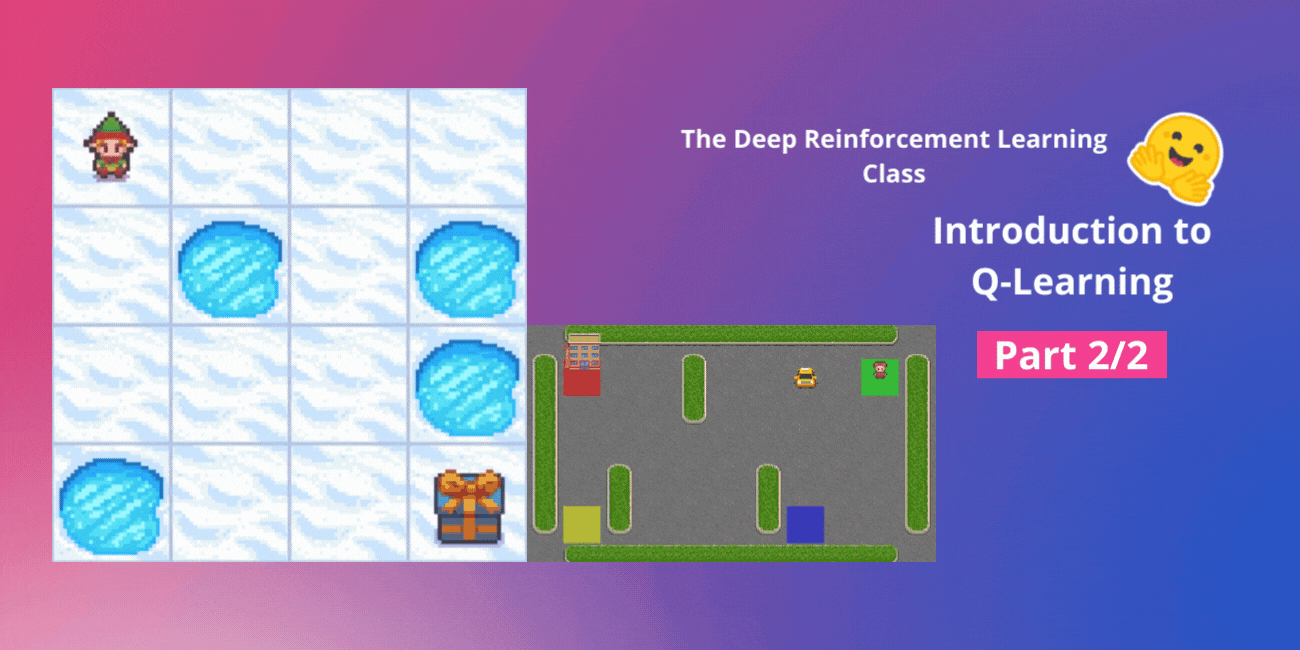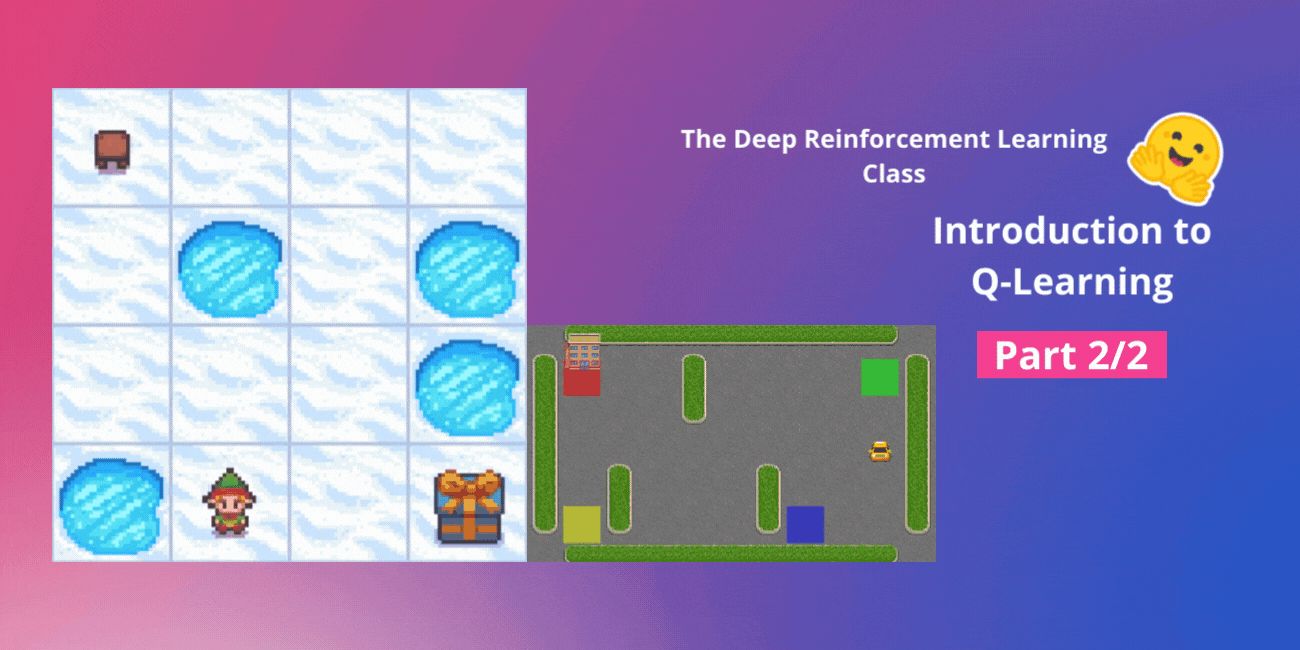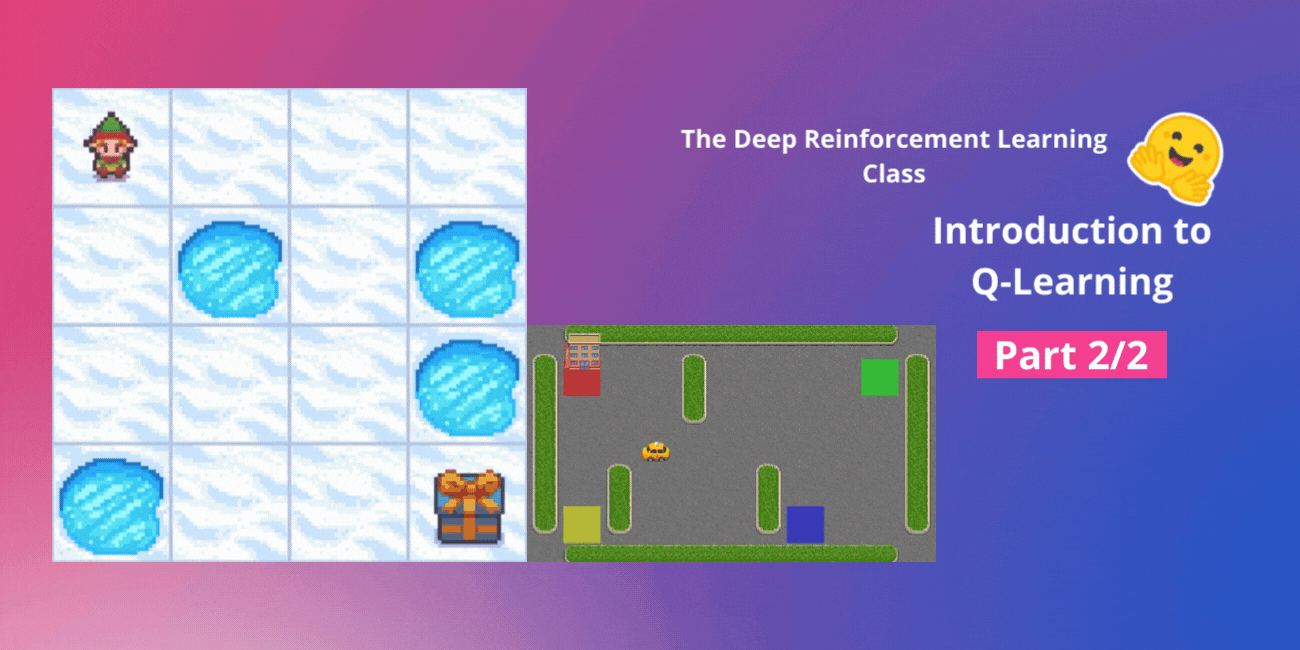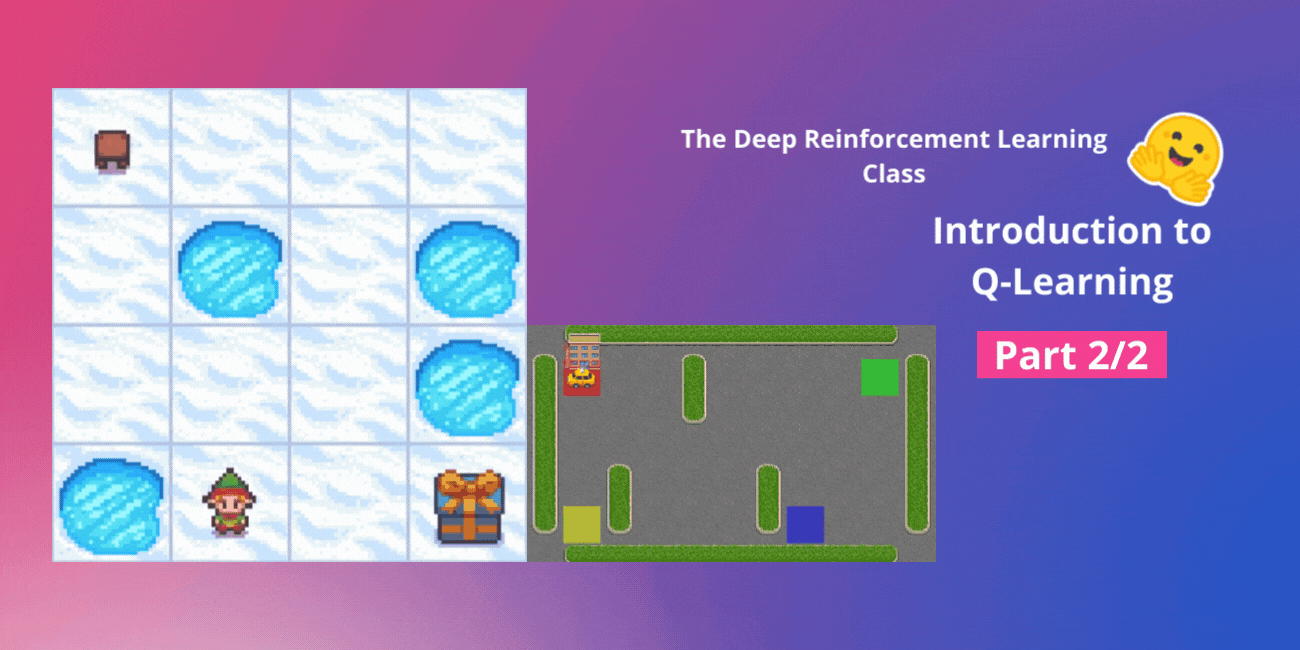
Q-სწავლა: ნულიდან RL აგენტის შექმნის გზამკვლევი
აღმოაჩინეთ Q-სწავლის ალგორითმი, ღრმა გაძლიერებითი სწავლის კლასის ფუნდამენტური ნაწილი. ეს სტატია განმარტავს Q-ფუნქციის, Q-ცხრილისა და ეფსილონ-ხარბი სტრატეგიის მუშაობის პრინციპებს, გასწავლით თუ როგორ შექმნათ თქვენი პირველი გაძლიერებითი სწავლის აგენტი ნულიდან და განაახლოთ მისი ქცევის მოდელი გარემოსთან ურთიერთქმედებისას.

NVIDIA Isaac GR00T N1.5: ინტელექტუალური რობოტების შექმნის ახალი ეტაპი
NVIDIA-მ გამოაცხადა Isaac GR00T N1.5-ის გამოშვება, რომელიც წარმოადგენს მსოფლიოში პირველი ღია ფუნდამენტური მოდელის, Isaac GR00T N1-ის, უმნიშვნელოვანეს განახლებას განზოგადებული ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს პლატფორმა შექმნილია ინტელექტუალური, ადაპტირებადი რობოტების შექმნის დასაჩქარებლად, მრავალმხრივი შეყვანის (ენა, გამოსახულებები) დამუშავებით და მრავალფეროვან გარემოში მანიპულაციური ამოცანების შესასრულებლად. GR00T N1.5 ახლა ხელმისაწვდომია დეველოპერებისთვის, რაც მათ საშუალებას
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.
წარმოგიდგენთ StarCoder2-ს: ინოვაცია პროგრამირების ენობრივ მოდელებში
StarCoder2 არის ღია კოდის დიდი ენობრივი მოდელების (LLM) ოჯახი, შექმნილი კოდის გენერაციისა და ანალიზისთვის. ის ხელმისაწვდომია სამი ზომის ვარიანტში – 3B, 7B და 15B პარამეტრით. ფლაგმანი StarCoder2-15B მოდელი გაწვრთნილია 4 ტრილიონზე მეტ ტოკენსა და 600-ზე მეტ პროგრამირების ენაზე The Stack v2 მონაცემთა ბაზიდან, რაც მას თავის ზომის კლასში საუკეთესოდ აქცევს და კონკურენციას უწევს 33B+ ზომის მოდელებს. პროექტი არის BigCode-ის თანამშრომლობის ნაწილი, რომელიც მიზნად ისახავს კოდისთვის განკუთვნილი LLM-ების პასუ

Groq Hugging Face Hub-ის დასკვნის პროვაიდერებს უერთდება: ხელოვნური ინტელექტის აჩქარება LPU ტექნოლოგიით
Hugging Face Hub-მა განაცხადა, რომ Groq ახლა მისი მხარდაჭერილი დასკვნის პროვაიდერია. ეს ინტეგრაცია მნიშვნელოვნად აფართოებს სერვერული დასკვნის შესაძლებლობებს Hub-ის მოდელის გვერდებზე, განსაკუთრებით LPU™-ზე დაფუძნებული ტექნოლოგიით, რომელიც უზრუნველყოფს ულტრა-დაბალ შეყოვნებასა და მაღალ გამტარუნარიანობას დიდ ენობრივ მოდელებზე (LLMs) დაფუძნებული რეალურ დროში ხელოვნური ინტელექტის აპლიკაციებისთვის.
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.

Gemma 3n: მულტიმოდალური AI მოდელი საბოლოოდ ღია კოდის ბიბლიოთეკებში
Google-ის უახლესი მულტიმოდალური AI მოდელი, Gemma 3n, საბოლოოდ ხელმისაწვდომია ყველაზე პოპულარულ ღია კოდის ბიბლიოთეკებში, მათ შორის transformers & timm, MLX, llama.cpp და სხვებში. ეს გამოშვება მოიცავს ორ ზომას (E2B და E4B), რომლებიც გამოირჩევიან მაღალი ეფექტურობით VRAM-ის გამოყენების მხრივ და უზრუნველყოფენ შესანიშნავ ხარისხს. Gemma 3n არა მხოლოდ ენობრივ დეკოდერს, არამედ აუდიო და ვიზუალურ ენკოდერებსაც მოიცავს, რაც მას სრულყოფილ მულტიმოდალურ ინსტრუმენტად აქცევს დეველოპერებისთვის. სტატია დეტალურად აღ

AI მოდელების შეფასება გამარტივდა: წარმოგიდგენთ „Evaluation on the Hub“-ს
დღეს წარმოვადგენთ „Evaluation on the Hub“-ს, ახალ ინსტრუმენტს, რომელიც „AutoTrain“-ის მეშვეობით საშუალებას გაძლევთ, შეაფასოთ ნებისმიერი მოდელი ნებისმიერ მონაცემთა ნაკრებზე „Hub“-ზე, ერთი ხაზი კოდის დაწერის გარეშე.
ხელოვნური ინტელექტი ვებ-დიზაინს HTML კოდში აქცევს: WebSight და Sightseer
ვებ-დიზაინის HTML კოდში გადაქცევა ხშირად გამოცდილ დეველოპერს მოითხოვს. ეს სტატია იკვლევს, თუ როგორ შეუძლიათ ვიზუალური ენის მოდელებს (VLMs) ამ პროცესის გამარტივება. წარმოდგენილია WebSight მონაცემთა ბაზა და Sightseer მოდელი, რომლებიც ხელოვნურ ინტელექტს საშუალებას აძლევენ ვიზუალური დიზაინი ფუნქციურ HTML კოდში გადაიყვანოს, რაც ვებ-დეველოპმენტს უფრო ეფექტურსა და ხელმისაწვდომს ხდის.