NLP მოდელების შედარებითი ანალიზი: RoBERTa, Mistral-7b და Llama-2-7b LoRA-ს გამოყენებით კატასტროფის ტვიტების კლასიფიკაციისთვის
ბუნებრივი ენის დამუშავების (NLP) სწრაფად განვითარებად სამყაროში, ენობრივი მოდელების შედარება გადამწყვეტია მათი ოპტიმალური გამოყენებისთვის კონკრეტულ ამოცანებში. ეს პოსტი ეძღვნება სამი მოდელის – RoBERTa, Mistral-7b და Llama-2-7b – შედარებას კატასტროფების შესახებ ტვიტების კლასიფიკაციის პრობლემაში. კვლევაში გამოყენებულია PEFT (Parameter-Efficient Fine-Tuning) ტექნიკის LoRA (Low-Rank Adaptation) მეთოდი, რომელიც მნიშვნელოვნად ამცირებს პარამეტრების რაოდენობას მოდელის წვრილად მორგებისას. განხილულია თითო
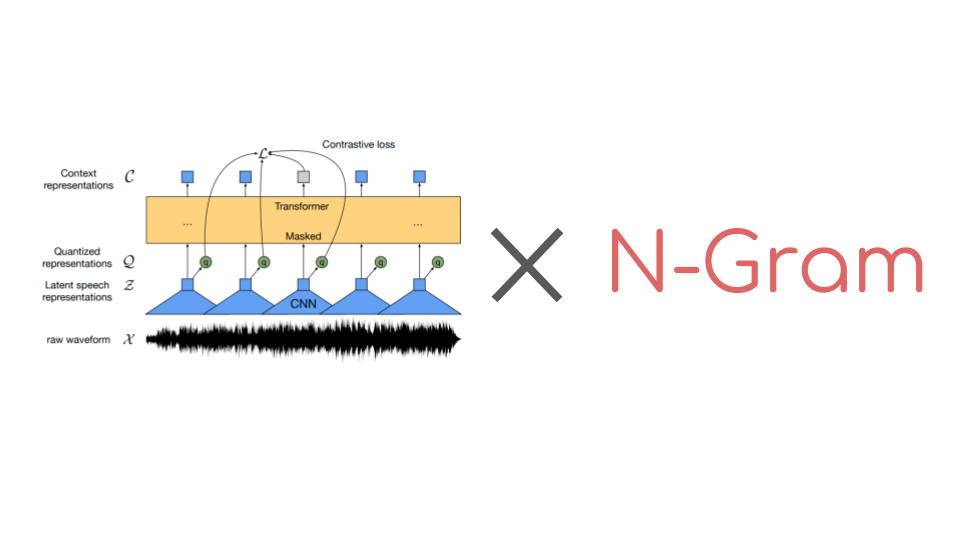
Wav2Vec2: ენობრივი მოდელების ინტეგრაცია ზუსტი მეტყველების ამოცნობისთვის
ეს სტატია განმარტავს, თუ როგორ უნდა დავაზუსტოთ Wav2Vec2 მოდელები მეტყველების ამოცნობისთვის და მნიშვნელოვნად გავაუმჯობესოთ ტრანსკრიფციის სიზუსტე ენობრივი მოდელის (LM) ინტეგრაციით. აღწერილია Connectionist Temporal Classification (CTC) ალგორითმის გამოყენება და დეტალურადაა განხილული pyctcdecode ბიბლიოთეკისა და 🤗 Transformers-ის საშუალებით n-გრამული ენობრივი მოდელის შექმნისა და Wav2Vec2 ჩეკპოინტთან შერწყმის ნაბიჯ-ნაბიჯ პროცესი, განსაკუთრებით ხაზგასმულია გაუმჯობესება მოკლე სასწავლო მონაცემთა ნაკრებებზ
Wav2Vec2: ტრანსფორმერული მოდელების შეზღუდვების დაძლევა ხანგრძლივი აუდიო ფაილების დამუშავებისას
Wav2Vec2, როგორც ტრანსფორმერული მოდელი, აწყდება თანმიმდევრობის სიგრძის შეზღუდვებს, რაც იწვევს პრობლემებს დიდ აუდიო ფაილებთან მუშაობისას. ტრადიციული დაყოფის მეთოდები ხშირად ამცირებს შედეგების ხარისხს კონტექსტის დაკარგვის გამო. ეს სტატია განმარტავს, თუ როგორ იძლევა Wav2Vec2-ის CTC სტრუქტურა საშუალებას, განხორციელდეს მდგრადი მეტყველების ამოცნობა ძალიან დიდ ფაილებზე, „striding“ ტექნიკის გამოყენებით. ასევე განხილულია ენის მოდელების (LM) ინტეგრაცია WER მაჩვენებლის გასაუმჯობესებლად და მოდელის გამოყენებ

Visual Salamandra: ახალი თაობის მულტიმოდალური AI ევროპული ენების აქცენტით
ენის ტექნოლოგიების ლაბორატორიამ წარმოადგინა Visual Salamandra, ინოვაციური მულტიმოდალური AI მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან. ეს სისტემა შექმნილია ვიზუალურ და ტექსტურ მონაცემებს შორის ხარვეზის შესავსებად, რის შედეგადაც მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანის საფუძველზე, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტური ინსტრუქციებიდან. Visual Salamandra გამოირჩევა მრავალენოვანი ინკლუზიურობით, განსაკუთრები
Visual Salamandra: მულტიმოდალური AI მოდელი ევროპული ენობრივი მრავალფეროვნების მხარდასაჭერად
Visual Salamandra, ახალი მულტიმოდალური ხელოვნური ინტელექტის მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან, ხედვისა და ენის დამუშავების უფსკრულს ავსებს. მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანიდან, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტიდან. ლაბორატორიის მიერ შექმნილი ეს ინოვაცია ხაზს უსვამს მრავალენოვან ინკლუზიურობას, განსაკუთრებული აქცენტით ევროპულ ენებზე, რაც ხელს უწყობს მულტიმოდალური AI კვლევის რესურსების ნა

გამოსახულებების ტოკენიზაცია და ViT მოდელების დახვეწა გამოსახულების კლასიფიკაციისთვის
ეს სტატია განიხილავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია ტრანსფორმატორის მოდელებისთვის, ნატურალური ენის დამუშავების (NLP) ამოცანების ანალოგიით. დეტალურად არის აღწერილი 🤗 datasets-ისა და 🤗 transformers-ის გამოყენებით ViT (Vision Transformer) მოდელის წინასწარი წვრთნა და დახვეწა გამოსახულების კლასიფიკაციის ამოცანებისთვის. მოცემულია ინსტრუქციები მონაცემთა ჩამოტვირთვის, დამუშავების, გამოსახულების ტრანსფორმაციებისა და წვრთნის კონვეიერის დაყენების შესახებ, მათ შორის ისეთი კომპონენტების, როგორიც

Hugging Face AMD Instinct GPU-ების სრულყოფილ მხარდაჭერას აცხადებს ხელოვნური ინტელექტის მოდელებისთვის
AMD-ის უახლესი Instinct MI300 სერიის ამაჩქარებლების მოახლოებულ გამოშვებასთან ერთად, Hugging Face აძლიერებს AMD GPU-ების მხარდაჭერას, რაც მომხმარებლებს საშუალებას აძლევს, გაუშვან Transformers-ის ყველა მოდელი და ამოცანა კოდის ყოველგვარი ცვლილების გარეშე. თანამშრომლობა მოიცავს ინტეგრირებულ ტესტირებას, გარემოსდაცვითი კვალის მინიმიზაციას და მნიშვნელოვან წარმადობის გაუმჯობესებას, განსაკუთრებით დიდი ენობრივი მოდელებისთვის და ტექსტის გენერირების ინფერენციისთვის (TGI), სადაც AMD Instinct MI250 GPU აჭარბე
BERT: ხელოვნური ინტელექტის ინოვაცია, რომელმაც ენის დამუშავება შეცვალა
BERT, Google AI-ის მიერ 2018 წელს შექმნილი მანქანური სწავლების მოდელი, რევოლუციური ინოვაციაა ბუნებრივი ენის დამუშავების (NLP) სფეროში. იგი წარმოადგენს მრავალფუნქციურ გადაწყვეტას 11-ზე მეტი ენობრივი ამოცანისთვის, მათ შორის სენტიმენტების ანალიზისა და დასახელებული ერთეულების ამოცნობისთვის. სტატია განმარტავს, თუ როგორ ეხმარება BERT კომპიუტერებს ადამიანის ენის გაგებაში, რა ტექნიკებს (როგორიცაა ნიღბიანი ენის მოდელი და შემდეგი წინადადების პროგნოზირება) იყენებს ამისთვის და რა გავლენა მოახდინა მან Google
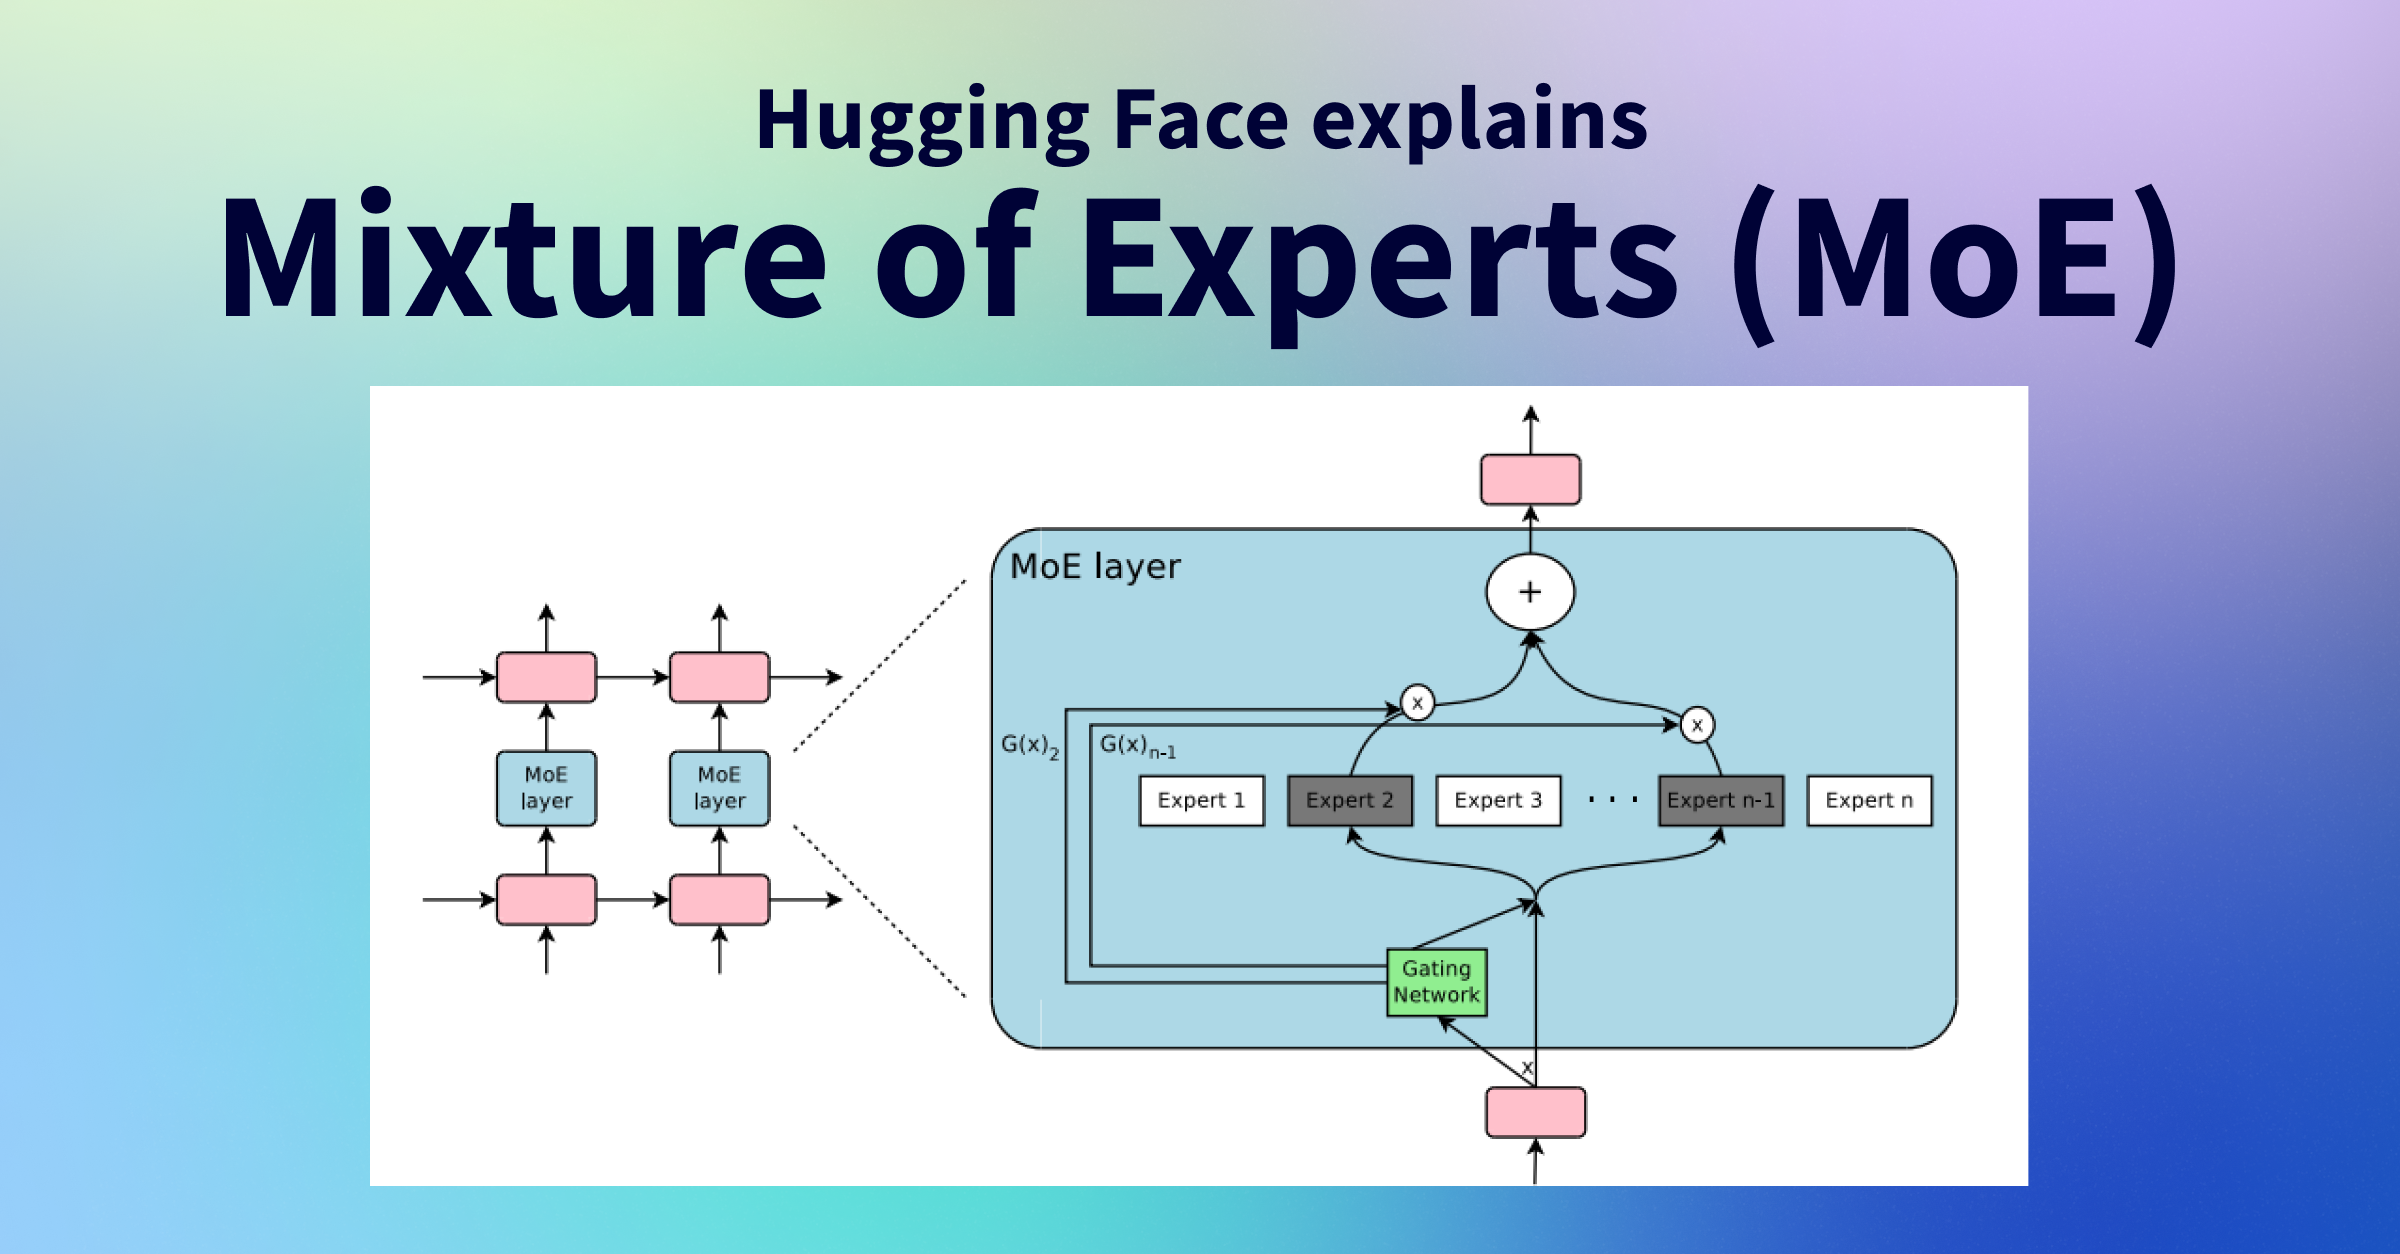
ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი

Cohere Hugging Face Hub-ზე: ინოვაციური AI მოდელები საწარმოებისთვის
კომპანია Cohere Hugging Face Hub-ის მხარდაჭერილი ინფერენს პროვაიდერი გახდა, რაც პირველი შემთხვევაა, როდესაც მოდელის შემქმნელი პირდაპირ ემსახურება საკუთარ მოდელებს პლატფორმაზე. Cohere, თავისი ყოვლისმომცველი, უსაფრთხო AI გადაწყვეტილებებით, რომელიც მოიცავს გენერაციულ AI-ს, ემბედინგსა და რანჟირების მოდელებს, განკუთვნილია საწარმოო გამოყენებისთვის. მათი მოდელები, როგორებიცაა Command R+, Aya, Command R და Aya Vision, ახლა ხელმისაწვდომია უსერვერო ინფერენსისთვის, რაც ხაზს უსვამს მრავალენოვან მხარდაჭერას,
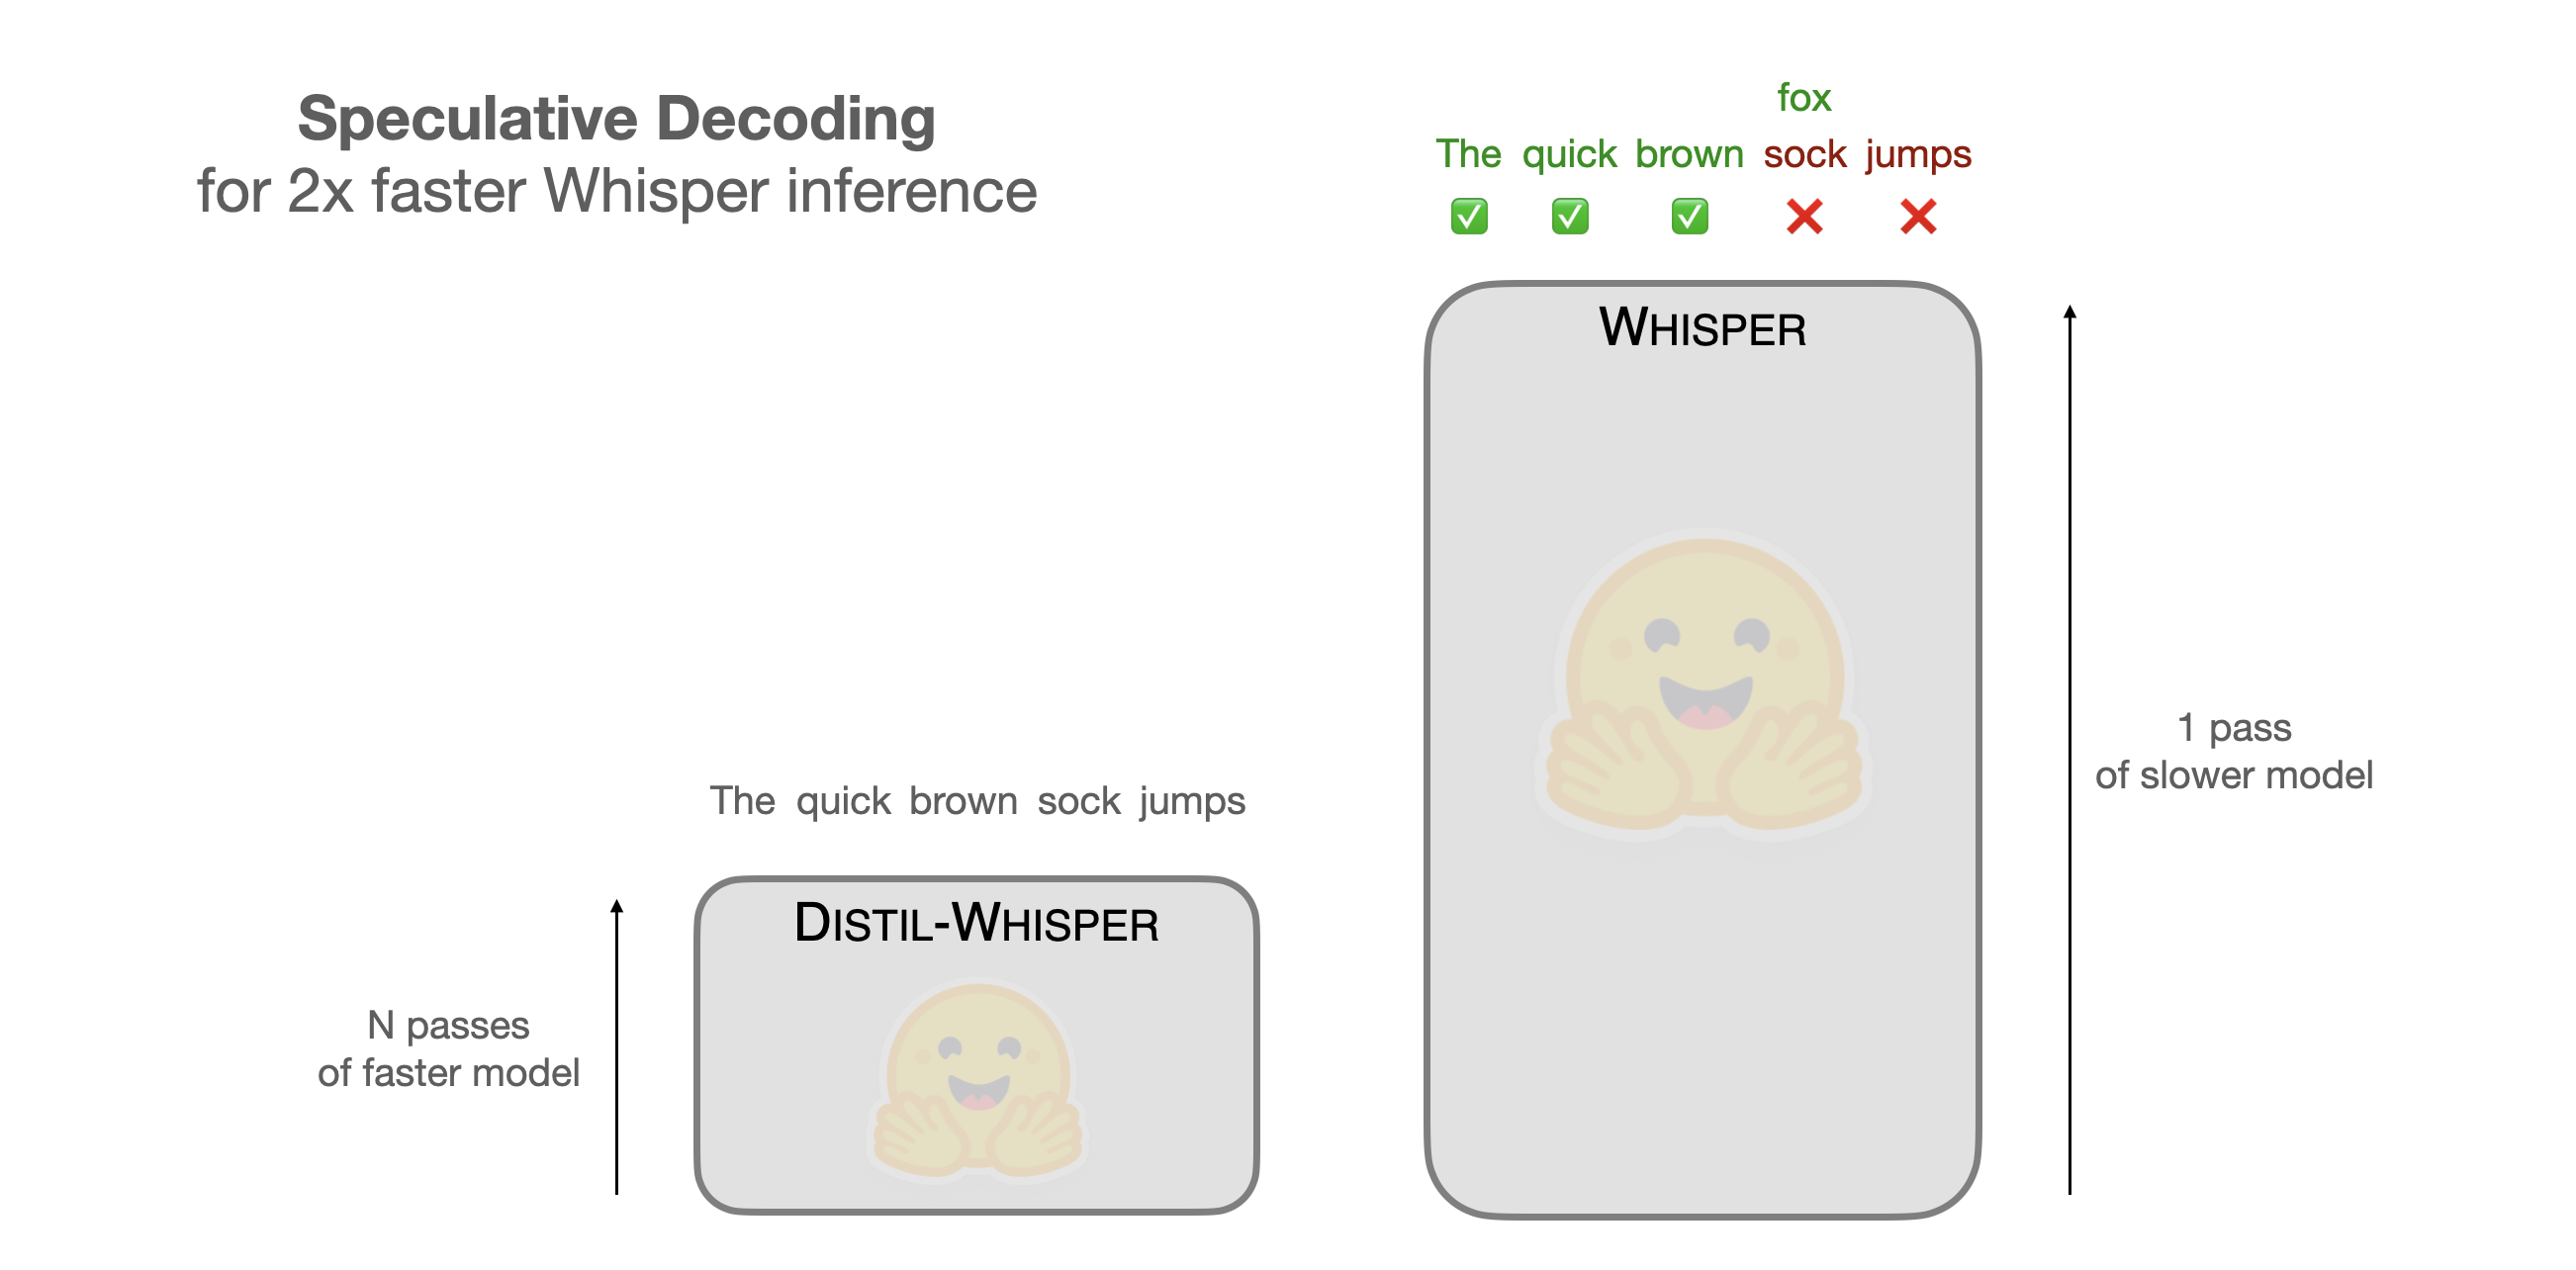
Whisper-ის სიჩქარის გაორმაგება: Speculative Decoding-ის ინოვაციური მეთოდი
მიუხედავად Whisper-ის ტრანსკრიფციის გამორჩეული სიზუსტისა, მისი დამუშავების (ინფერენციის) დრო საკმაოდ ნელია. ეს სტატია წარმოადგენს Speculative Decoding-ის მეთოდს, რომელიც Whisper-ის ინფერენციის დროს 2-ჯერ ამცირებს, სიზუსტის შენარჩუნებით. ეს ინოვაციური მიდგომა უზრუნველყოფს ზუსტად იგივე შედეგებს, რაც მოდელის სტანდარტული გამოყენებისას მიიღება, რაც მას არსებული Whisper-ის სისტემებისთვის იდეალურ ალტერნატივად აქცევს.

olmOCR-ის გაუმჯობესება: სრული დოკუმენტის კონტექსტის ამოცნობა სათაურებისა და ქვედა კოლონტიტულების ჩათვლით
olmOCR ხშირად უგულებელყოფს მნიშვნელოვან ინფორმაციას დოკუმენტების სათაურებსა და ქვედა კოლონტიტულებში, რაც მის საწყის სატრენინგო მონაცემთა ბაზის თავისებურებებით იყო განპირობებული. ამ პრობლემის გადასაჭრელად, მკვლევრებმა olmOCR-ის მოდელი დახვეწეს Qwen2.5-VL-72B-Instruct-ის მიერ გენერირებული 8,000 დოკუმენტისგან შემდგარი ახალი მონაცემთა ბაზის გამოყენებით. შედეგად, მოდელი ახლა სრულყოფილად იღებს მთელ კონტენტს, მათ შორის ადრე გამოტოვებულ მონაცემებსაც, რაც გადამწყვეტია ბიზნეს აპლიკაციებისთვის, როგორიცაა ი
წარმოგიდგენთ aMUSEd-ს: ეფექტურ არადიფუზიურ ტექსტიდან გამოსახულების გენერაციის მოდელს
გაეცანით aMUSEd-ს, Google-ის MUSE-ის ღია რეპროდუქციას. ეს არის სწრაფი, არადიფუზიური ტექსტიდან გამოსახულების გენერაციის მოდელი, რომელიც ეფუძნება ნიღბიანი გამოსახულების მოდელირების (MIM) მეთოდოლოგიას. მიუხედავად იმისა, რომ მისი ხარისხი არ არის უმაღლესი დონის, ის გვთავაზობს სტილის გადაცემის, გამოსახულების inpainting-ის შესაძლებლობებს და ხელს უწყობს MIM ფრეიმვორკების კვლევას. მოდელი გამოშვებულია ნებადართული ლიცენზიით, მარტივია მის დასაკონფიგურირებლად და მუშაობს დაბალი GPU VRAM მოთხოვნებით.
Hugging Face-ი Decision Transformer-ს აინტეგრირებს: ახალი მიდგომა გაძლიერებით სწავლებაში
Hugging Face-მა Decision Transformer, ოფლაინ გაძლიერებითი სწავლის (Offline Reinforcement Learning) მეთოდი, თავის 🤗 transformers ბიბლიოთეკასა და Hugging Face Hub-ში ინტეგრირება მოახდინა. ეს ინტეგრაცია მნიშვნელოვან ნაბიჯს წარმოადგენს Deep Reinforcement Learning-ის (Deep RL) სფეროში ხელმისაწვდომობის გასაუმჯობესებლად. Decision Transformer წარმოადგენს პარადიგმის ცვლას, სადაც ტრადიციული RL მეთოდების ნაცვლად გამოიყენება მიმდევრობის მოდელირების ალგორითმი სასურველი შედეგის მისაღწევად მომავალი მოქმედებები
რატომ არღვევს Hugging Face-ის Transformers ბიბლიოთეკა DRY პრინციპს?
პროგრამული უზრუნველყოფის განვითარებაში ცნობილი „ნუ გაიმეორებ საკუთარ თავს“ (DRY) პრინციპის მიუხედავად, Hugging Face-ის Transformers ბიბლიოთეკა შეგნებულად უარს ამბობს მის გამოყენებაზე და იყენებს „ერთი მოდელის ფაილის პოლიტიკას“. ეს გადაწყვეტილება მიღებულია გარე კონტრიბუციების წახალისების, კოდის წაკითხვადობის გაუმჯობესების და მანქანური სწავლების სფეროს სწრაფი ევოლუციის გამო, რაც სტანდარტული ლოგიკური შაბლონების განსაზღვრას ართულებს.
Vectara-ს HHEM ლიდერბორდი Hugging Face-ის შაბლონით LLM-ის „ჰალუცინაციის“ შესაფასებლად
კომპანია Vectara-მ წარმოადგინა ჰიუზის ჰალუცინაციის შეფასების მოდელი (HHEM), ღია კოდის ინსტრუმენტი, რომელიც ზომავს დიდი ენობრივი მოდელების (LLM) მიერ „ჰალუცინაციის“ (უაზრო ტექსტის გენერირება) ხარისხს. მოდელი აფასებს როგორც ღია კოდის, ასევე კომერციულ LLM-ებს, ხაზს უსვამს მათ შორის არსებულ განსხვავებებს. HHEM ლიდერბორდის მართვის საჭიროების გამო, Vectara-მ Hugging Face-ის ახალი ლიდერბორდის შაბლონები გამოიყენა და გამოუშვა HHEM ლიდერბორდი. ეს ინიციატივა მიზნად ისახავს LLM „ჰალუცინაციების“ შეფასების დე

Qwen-3 მოდელის ჩატის გაუმჯობესებული შაბლონი: სიღრმისეული ანალიზი
Qwen-3 მოდელი წარმოადგენს მნიშვნელოვან გაუმჯობესებებს ჩატის შაბლონში, Qwen-2.5-თან და QwQ-თან შედარებით. მისი სიახლეები მოიცავს აზროვნების ფუნქციის (reasoning) ჩართვა-გამორთვის შესაძლებლობას, კონტექსტის მართვის გაუმჯობესებულ მექანიზმს ('rolling checkpoint'), ინსტრუმენტებთან უკეთეს ინტერაქციას და ნაგულისხმევი სისტემის პრომპტის არარსებობას. ეს ცვლილებები ზრდის მოდელის მოქნილობას და საიმედოობას ხელოვნური ინტელექტის აპლიკაციებში.

რობოტიკის განზოგადების გამოწვევა: მონაცემების მნიშვნელობა და LeRobot-ის წვლილი
ვიზუალურ-ენობრივ-მოქმედებითი (VLA) მოდელების მიღწევებმა რობოტებს საშუალება მისცა შეასრულონ რთული ამოცანები, თუმცა ჭეშმარიტი განზოგადება ახალ გარემოში კვლავ უდიდეს გამოწვევად რჩება. ეს სტატია ხაზს უსვამს, რომ განზოგადება ძირითადად მონაცემების ფენომენია და არა მხოლოდ მოდელის თვისება. განხილულია არსებული, ხშირად აკადემიური, მონაცემთა ნაკრებების შეზღუდვები და ხაზგასმულია მრავალფეროვანი, რეალური სამყაროს მონაცემების საჭიროება. LeRobot აქტიურად მუშაობს მონაცემთა შეგროვების დემოკრატიზაციაზე, რათა ხელი
რობოტების გენერალიზაცია: მონაცემებზე ორიენტირებული მიდგომა და LeRobot-ის როლი
Vision-Language-Action (VLA) მოდელებში მიღწევებმა რობოტებს საშუალება მისცა შეასრულონ რთული ამოცანები, მაგრამ გამოწვევად რჩება გენერალიზაცია ახალ გარემოში და უცნობ ობიექტებთან. ეს მოითხოვს არა მხოლოდ მტკიცე უნარებს, არამედ სამყაროს საღი აზრისეულ გაგებას, რაც ხშირად შეფერხებულია მრავალფეროვანი მონაცემების ნაკლებობით. სტატია ხაზს უსვამს, რომ გენერალიზაცია მონაცემთა ფენომენია და არა მხოლოდ მოდელის თვისება. LeRobot-ის ინიციატივა მიზნად ისახავს რობოტიკის მონაცემთა შეგროვების დემოკრატიზაციას, რათა შეიქ
PatchTSMixer: IBM Research-ისა და Hugging Face-ის რევოლუციური მოდელი დროითი სერიების მოდელირებისთვის
IBM Research-მა Hugging Face-თან ერთად წარმოადგინა PatchTSMixer, ინოვაციური მოდელი, რომელიც Transformers ბიბლიოთეკაშია ინტეგრირებული. ეს მოდელი შექმნილია მრავალვარიანტული დროითი სერიების ეფექტური მოდელირებისთვის, მსუბუქი შერევის გამოყენებით პაჩებს, არხებსა და დამალულ მახასიათებლებს შორის. PatchTSMixer მნიშვნელოვნად აღემატება არსებულ MLP და Transformer მოდელებს პროგნოზირებაში, აჩვენებს 8-60%-იან გაუმჯობესებას და ამცირებს მეხსიერების მოხმარებასა და შესრულების დროს. იგი მხარს უჭერს ტრანსფერულ სწავლ
MetaAI-ის Wav2Vec2-BERT: გაუმჯობესებული მეტყველების ამოცნობა დაბალრესურსიან ენებზე
MetaAI-მ გამოუშვა Wav2Vec2-BERT, ხელოვნური ინტელექტის მოდელი მეტყველების ავტომატური ამოცნობისთვის (ASR), რომელიც Seamless Communication-ის ნაწილია. ორიგინალური Wav2Vec2-ის გაუმჯობესებული ვერსია, Wav2Vec2-BERT, გაწვრთნილია 4.5 მილიონ საათზე მეტ აუდიო მონაცემზე 143-ზე მეტ ენაზე. ის მნიშვნელოვნად აღემატება Whisper-ის მოდელს სიჩქარითა და რესურსების ეფექტურობით, განსაკუთრებით დაბალრესურსიან ენებზე, როგორიცაა მონღოლური, სადაც Whisper-ი დაბალ შედეგებს აჩვენებს. Wav2Vec2-BERT-ს შეუძლია მიაღწიოს კონკურენ
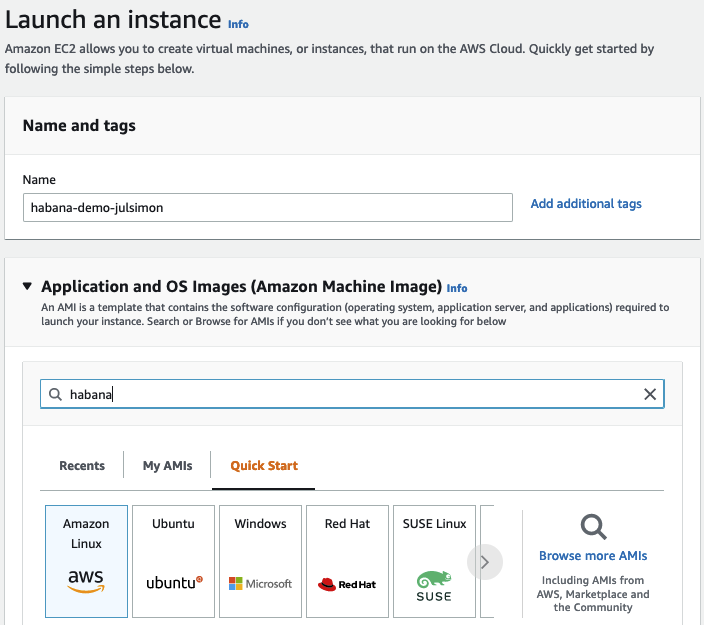
Habana Gaudi-ის ამაჩქარებლები და Transformer-ები: მაღალი წარმადობა და ხარჯთეფექტურობა AWS-ზე
Habana Gaudi-ის ახალი ამაჩქარებლები Amazon EC2 ინსტანციებზე უზრუნველყოფენ 40%-მდე უკეთეს ფასი-წარმადობას მანქანური სწავლის მოდელების, განსაკუთრებით Transformer-ების, წვრთნისთვის, უახლეს GPU-ებთან შედარებით. ეს პოსტი აღწერს, თუ როგორ სწრაფად დავაყენოთ Habana Gaudi ინსტანცია AWS-ზე და დავხვეწოთ BERT მოდელი ტექსტის კლასიფიკაციისთვის, რაც დემონსტრირებას უკეთებს ამ ტექნოლოგიის სიმარტივესა და ხარჯთეფექტურობას.

Falcon-Edge: BitNet არქიტექტურაზე დაფუძნებული მძლავრი ენის მოდელების ახალი სერია
Falcon-Edge წარმოგიდგენთ მძლავრ, უნივერსალურ და კონფიგურირებად ენის მოდელებს, რომლებიც დაფუძნებულია BitNet არქიტექტურაზე და ხელმისაწვდომია სამმაგ ფორმატში. ეს სერია ახორციელებს ახალ წინასწარ წვრთნის პარადიგმას, რომელიც ერთდროულად აწვდის როგორც არაკვანტიზებულ, ასევე კვანტიზებულ მოდელის ვარიანტებს, მათ შორის bfloat16 ფორმატის, მშობლიურ BitNet მოდელს და წინასწარ კვანტიზებულ BitNet ვარიანტს მარტივი დაზუსტებისთვის. მოდელები ხელმისაწვდომია 1 მილიარდი და 3 მილიარდი პარამეტრის ზომებში, როგორც საბაზისო,
მომხმარებლის საჭიროებების გაგება Auto ML-ით: HuggingFace AutoTrain-ისა და Kili-ის ინტეგრაცია
სტატია განიხილავს, თუ როგორ შეიძლება ავტომატური მანქანური სწავლის (Auto ML) გამოყენება, კერძოდ HuggingFace AutoTrain-ისა და Kili პლატფორმის მეშვეობით, მომხმარებელთა საჭიროებების ეფექტურად გასაგებად. წარმოდგენილია ტექსტის კლასიფიკაციისა და სენტიმენტური ანალიზის აქტიური სწავლის პაიპლაინის აგება, Medium-ის მომხმარებლის მიმოხილვების მაგალითზე Google Play Store-იდან. ეს მეთოდი ამცირებს ხარჯებს და აჩქარებს მონაცემთა ეტიკეტირებისა და მოდელის ვარჯიშის პროცესს.