Hugging Face spaCy-ის ინტეგრაციით მოდელების გაზიარებასა და გამოყენებას ამარტივებს
Hugging Face-მა და spaCy-იმ განახორციელეს ინტეგრაცია, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ, დააყენონ და გამოიყენონ spaCy-ის კონვეიერები და მოდელები. ახალი ფუნქციონალი მოიცავს ავტომატურ მეტამონაცემების გენერაციას, დასკვნის (Inference) API-ს NER-ისთვის (Named Entity Recognition), ბრაუზერში ინტერაქტიულ ტესტირებას, `pip install`-ის მხარდაჭერას და `spacy-huggingface-hub` ბიბლიოთეკას მოდელების სწრაფი გაზიარებისთვის. ხელმისაწვდომია 60-ზე მეტი კანონიკური მოდელი, და მალე დაემატება ტექსტ

როგორ დავხვეწოთ Llama 2 70B PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკები და გამოწვევების გადაჭრა
ეს ბლოგპოსტი დეტალურად განიხილავს Llama 2 70B მოდელის დახვეწას PyTorch FSDP-ის გამოყენებით. სტატია ფოკუსირებულია ძირითად გამოწვევებზე, როგორიცაა CPU RAM-ის გადატვირთვა, შუალედური ჩეკპოინტების შენახვის სირთულეები და VRAM-ის მოხმარების ოპტიმიზაცია. წარმოდგენილია გადაწყვეტები Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მეშვეობით, ასევე განხილულია Accelerate-ის გამოყენება SLURM-თან ერთად. მოცემულია საჭირო რესურსები და კონფიგურაციები შედეგების რეპროდუცირებისთვის.
Llama 2 70B-ის დახვეწა PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკა და გამოწვევების გადაწყვეტა
ამ ბლოგ-პოსტში განხილულია Llama 2 70B მოდელის დახვეწის პროცესი PyTorch FSDP-ის გამოყენებით, Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მოშველიებით. დეტალურად არის აღწერილი FSDP-ის მოქმედების პრინციპი, რომელიც ოპტიმიზატორის მდგომარეობებს, გრადიენტებსა და პარამეტრებს მოწყობილობებს შორის ანაწილებს. ასევე, განხილულია ძირითადი გამოწვევები, როგორიცაა CPU RAM-ის მაღალი მოთხოვნები, შუალედური საკონტროლო წერტილების ნელი შენახვა და NCCL Timeout შეცდომები. სტატია გვთავაზობს გადაწყვეტებს ტრე
DeDLOC: რევოლუციური მეთოდი ხელოვნური ინტელექტის კოლაბორაციული წვრთნისთვის
წარმოგიდგენთ DeDLOC-ს — ახალ მეთოდს კოლაბორაციული განაწილებული სწავლებისთვის, რომელსაც შეუძლია მოერგოს მონაწილეთა ქსელურ და აპარატურულ შეზღუდვებს. ჩვენ ვაჩვენებთ, რომ ის წარმატებით გამოიყენება რეალურ სცენარებში: 40 მოხალისის დახმარებით წინასწარ გაიწრთვნა sahajBERT, ბენგალური ენის მოდელი, რომელმაც მიაღწია თითქმის უახლეს ხარისხს, გაცილებით დიდ მოდელებთან შედარებით, რომლებიც ასობით მაღალი კლასის ამაჩქარებელს იყენებენ. ეს მეთოდი გვთავაზობს გამოსავალს ხელოვნური ინტელექტის მოდელების წვრთნის მაღალი ღირ
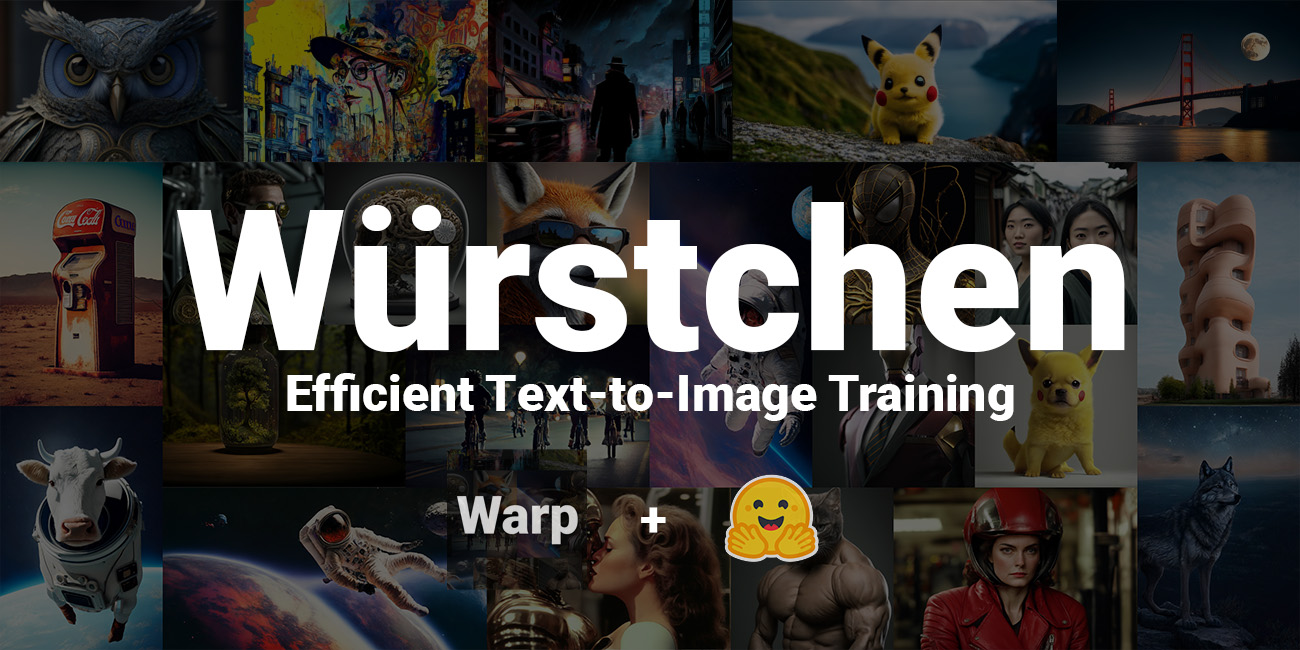
Würstchen: ინოვაციური დიფუზიური მოდელი რეკორდული კომპრესიით, რომელიც რევოლუციას ახდენს გამოსახულების გენერაციაში
Würstchen წარმოადგენს დიფუზიურ მოდელს, რომელიც გამოსახულების გენერაციას ახორციელებს უკიდურესად შეკუმშულ ლატენტურ სივრცეში, აღწევს რა 42x სივრცულ კომპრესიას – მიღწევა, რომელიც აქამდე შეუძლებლად ითვლებოდა. ეს საშუალებას აძლევს მას შექმნას მაღალი ხარისხის გამოსახულებები გაცილებით სწრაფად და ნაკლები რესურსებით, ვიდრე არსებული წამყვანი მოდელები, როგორიცაა Stable Diffusion XL, რაც მნიშვნელოვნად ამცირებს როგორც მოდელის ვარჯიშის, ისე ინფერენციის (შედეგების მიღების) ხარჯებს.
ობიექტის ამოცნობის ლიდერბორდი: მეტრული მაჩვენებლების გაგება და კრიტიკული შეფასება
Hugging Face Hub-მა გამოაქვეყნა ობიექტის ამოცნობის ლიდერბორდი, რომელიც აფასებს მოდელებს სხვადასხვა მეტრიკის საფუძველზე, როგორიცაა „კვეთა გაერთიანებაზე“ (IoU), „საშუალო სიზუსტე“ (AP) და „საშუალო გახსენება“ (AR). ეს ბლოგი დეტალურად განიხილავს მოდელების შეფასების მეთოდებს, განმარტავს გამოყენებულ მეტრიკას და მიზნად ისახავს შეფასებისას წარმოშობილი სირთულეების გამარტივებას, რათა მომხმარებლებს შეეძლოთ მოდელის მუშაობის კრიტიკულად შეფასება. ასევე ახსნილია ობიექტის ამოცნობის კონცეფცია, მისი აპლიკაციები და

Cohere For AI-მ Aya Vision წარადგინა: ახალი მულტილინგვური და მულტიმოდალური AI მოდელი
Cohere For AI-მ გამოუშვა Aya Vision, მულტილინგვური და მულტიმოდალური მოდელების უახლესი ოჯახი, რომელიც 23 ენაზე ენისა და ვიზუალური ინფორმაციის გაგებისთვის მძლავრი საფუძველია. ის ეფუძნება Aya Expanse-ის წარმატებას და აფართოებს მას მოწინავე ტექნიკების გამოყენებით. Aya Vision-ს შეუძლია შეასრულოს ისეთი ამოცანები, როგორიცაა გამოსახულების აღწერა, ვიზუალური შეკითხვებზე პასუხის გაცემა და ტექსტის გენერაცია. მოდელი მნიშვნელოვნად აღემატება თავისი ზომის ბევრ სხვა მოდელს და ხელმისაწვდომია ღია წონით კვლევისთვის

Hugging Face Hub-ის უსაფრთხოება JFrog-ის სკანერის ინტეგრაციით ძლიერდება
Hugging Face-მა JFrog-ის სკანერი თავის პლატფორმაზე დაამატა, რათა Hugging Face Hub-ზე უსაფრთხოება გააუმჯობესოს. ახალი სკანერი ამცირებს ცრუ დადებით შედეგებს და მოდელის წონებში არსებულ კოდს ღრმად აანალიზებს პოტენციური მავნე გამოყენების გამოსავლენად, განსაკუთრებით ისეთი მოწყვლადი სერიალიზაციის ფორმატებისთვის, როგორიცაა Pickle. ყველა საჯარო მოდელის რეპოზიტორი ავტომატურად დასკანირდება, რაც საზოგადოებას მოდელების უსაფრთხოდ გაზიარებაში ეხმარება.
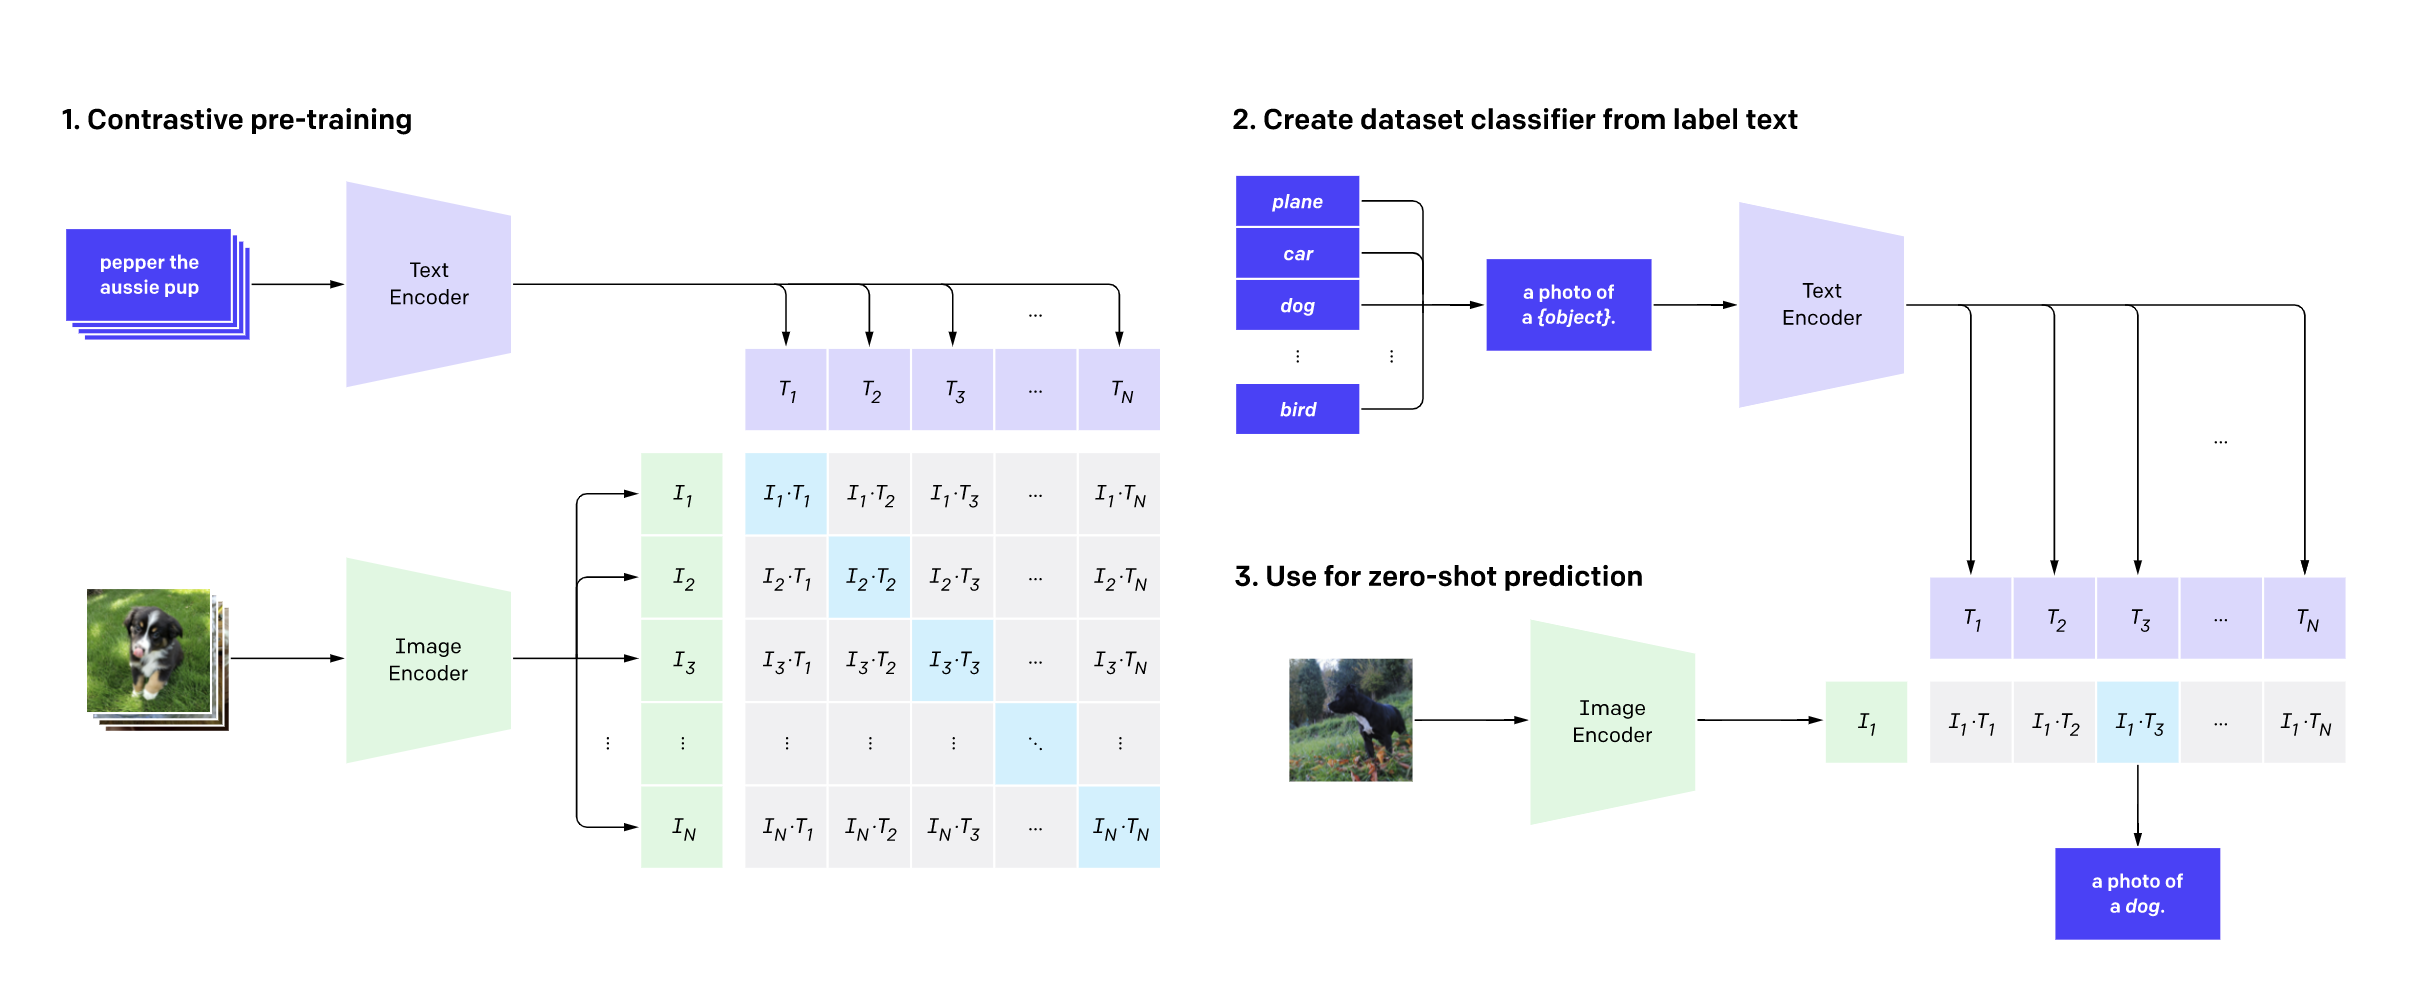
CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ
შექმენით თქვენი საკუთარი ღია კოდის ChatGPT კოდის დაწერის გარეშე Hugging Face-ის ხელსაწყოებით
ეს გაკვეთილი გვიჩვენებს, თუ როგორ შეიძლება შეიქმნას და განთავსდეს ღია კოდის ChatGPT-ის მსგავსი აპლიკაცია Meta-ს LLaMA 2 მოდელის გამოყენებით, რომელიც დახვეწილია ღია კოდის ინსტრუქციების მონაცემთა ნაკრებით, ყოველგვარი კოდის დაწერის გარეშე. სტატია ხაზს უსვამს Hugging Face-ის ინსტრუმენტების (Spaces, AutoTrain, ChatUI) როლს, რათა მანქანური სწავლება ხელმისაწვდომი გახდეს არატექნიკური მომხმარებლებისთვის, რაც გზას უხსნის ხელოვნური ინტელექტის დემოკრატიზებულ მომავალს.
ჩატის მოდელების ეფექტურობის გასაღები: ფორმატის მნიშვნელობა და Jinja შაბლონები
ეს სტატია განმარტავს, თუ რამდენად კრიტიკულია ჩატის ფორმატის შეხამება იმ ფორმატთან, რომელზეც ხელოვნური ინტელექტის მოდელები იყო გაწვრთნილი. არასწორი ფორმატის გამოყენება იწვევს მუშაობის სერიოზულ, ჩუმ გაუარესებას. Hugging Face-ის ტოკენიზატორების ახალი `chat_template` ატრიბუტი, რომელიც Jinja შაბლონებს იყენებს, მიზნად ისახავს ამ პრობლემის გადაჭრას საუბრების სწორად ფორმატირებით, რითაც უზრუნველყოფს მოდელის ოპტიმალურ მუშაობას და ხელს უშლის „განაწილების ცვლილებას“.

NVIDIA-ს რევოლუციური AI სიახლეები: Cosmos Transfer, Physical AI Dataset და Isaac GR00T N1
NVIDIA-მ წარადგინა ხელოვნური ინტელექტის (AI) სამი მნიშვნელოვანი სიახლე: Cosmos Transfer, რომელიც ზრდის ვირტუალური სამყაროს სცენების გენერირების სიზუსტეს; Physical AI Dataset, ღია კოდის მონაცემთა ნაკრები რობოტიკის ვარჯიშისთვის; და Isaac GR00T N1, მსოფლიოში პირველი ღია ფუნდამენტური მოდელი ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს ინოვაციები მიზნად ისახავს ვირტუალური სამყაროების, რობოტიკისა და ავტონომიური სისტემების განვითარებას.
Wav2Vec2 და XLS-R: გარღვევა მეტყველების ავტომატური ამოცნობის ტექნოლოგიაში
2020 წელს გამოშვებული Wav2Vec2 მოდელიდან დაწყებული, Facebook AI-ის მრავალენოვანი XLSR ვერსიის გავლით, 2021 წლის ნოემბერში წარმოდგენილი XLS-R წარმოადგენს მნიშვნელოვან მიღწევას მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. XLS-R, რომელიც გაწვრთნილია 128 ენაზე ნახევარ მილიონ საათამდე აუდიო მონაცემზე, უზრუნველყოფს კონტექსტუალიზებულ მეტყველების წარმოდგენებს და აჩვენებს შთამბეჭდავ გაუმჯობესებას მეტყველების ამოცნობის, თარგმანისა და ენის იდენტიფიკაციის ამოცანებში. სტატია დეტალურად განმარტავს ამ მოდელე

PyTorch-ის სწავლების აჩქარება Intel Xeon პროცესორებზე: ღრმა სწავლის ახალი მიდგომა
გრაფიკული პროცესორები (GPUs) დიდი ხანია ღრმა სწავლის მოდელების სწავლების დე ფაქტო არჩევანი იყო. თუმცა, ტრანსფერული სწავლის ზრდა ცვლის თამაშის წესებს. მოდელები ახლა იშვიათად სწავლება ნულიდან უზარმაზარ მონაცემთა ნაკრებებზე; ამის ნაცვლად, ისინი ხშირად ზუსტდება კონკრეტულ (და მცირე) მონაცემთა ნაკრებებზე, რათა შეიქმნას სპეციალიზებული მოდელები, რომლებიც უფრო ზუსტია კონკრეტული ამოცანებისთვის, ვიდრე საბაზისო მოდელი. რადგან ეს სწავლების ამოცანები ბევრად უფრო ხანმოკლეა, CPU-ზე დაფუძნებული კლასტერის გამოყენ

ONNX Runtime Hugging Face-ის მოდელების მუშაობას აუმჯობესებს
ONNX Runtime არის კროს-პლატფორმული ინსტრუმენტი, რომელიც აჩქარებს მანქანური სწავლების მოდელებს, განსაკუთრებით ONNX-ის მხარდაჭერით. Hugging Face-ზე, ღია კოდის პლატფორმაზე, 130 000-ზე მეტი ასეთი მოდელია, მათ შორის დიდი ენობრივი (LLM) და ღრუბლოვანი მოდელები, რომლებსაც შეუძლიათ მნიშვნელოვნად გააუმჯობესონ მუშაობა ONNX Runtime-ის მეშვეობით. მაგალითად, whisper-tiny მოდელის დაჩქარება PyTorch-თან შედარებით 74.30%-მდე ეფექტურობას იძლევა. ONNX Runtime მჭიდროდ თანამშრომლობს Hugging Face-თან 90-ზე მეტი არქიტე
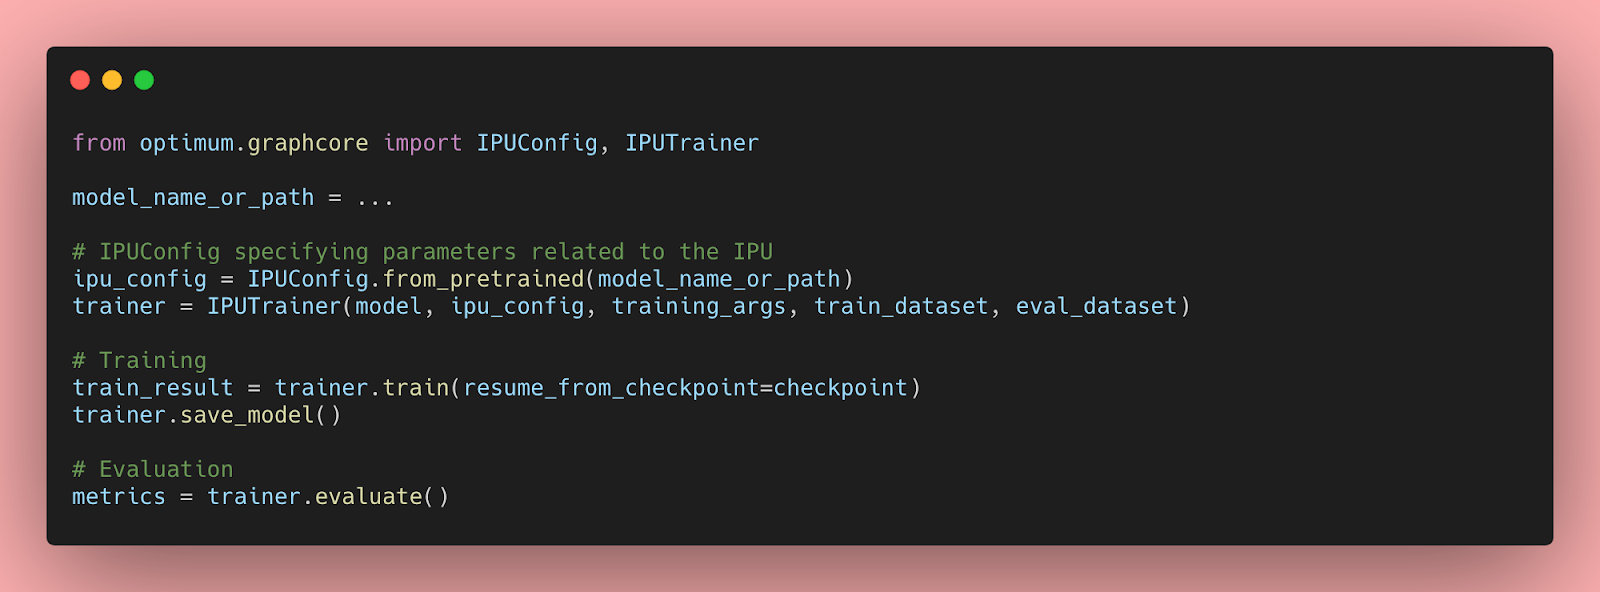
Transformer მოდელების აჩქარება Graphcore IPU-ებზე Hugging Face Optimum-ით
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. Graphcore-სა და Hugging Face-ის პარტნიორობის ფარგლებში, ახლა წარმოდგენილია BERT, როგორც პირველი IPU-ზე ოპტიმიზებული მოდელი, რომელიც განკუთვნილია Graphcore-ის ინტელექტუალური დამუშავების ერთეულისთვის (IPU). ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ Optimum და IPU-ები BERT მოდელების მარტივად გასაწვრთნელად და დასაჩქარებლად, მ
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
SDXL-ის ოპტიმიზაცია: როგორ დავაჩქაროთ ინფერენცია და შევამციროთ მეხსიერების მოხმარება
SDXL მოდელი, მიუხედავად მისი გაუმჯობესებული შესაძლებლობებისა, მნიშვნელოვნად დიდია, რაც დიდ მოთხოვნებს აყენებს GPU მეხსიერებასა და გამოთვლით დროს. ეს სტატია იკვლევს ოპტიმიზაციის ტექნიკებს, როგორიცაა დაბალი სიზუსტის (fp16) წონების გამოყენება, PyTorch 2.0-ის SDPA და torch.compile ფუნქციები, ასევე CPU-ზე გადმოტვირთვა, რათა გაიზარდოს ინფერენციის სიჩქარე და შემცირდეს მეხსიერების მოხმარება, რაც SDXL-ს უფრო პრაქტიკულს ხდის ფართო სპექტრის მომხმარებლებისთვის.
კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)

DeepSeek-V3-0324: AI მოდელის ჩუმი გამოშვება გაუმჯობესებული შესაძლებლობებით
ამ კვირაში DeepSeek-მა ჩუმად გამოუშვა DeepSeek-V3-ის განახლებული ვერსია, DeepSeek-V3-0324, რომელიც ახლა MIT ლიცენზიით არის ხელმისაწვდომი. ეს ახალი მოდელი, რომელიც ორიგინალ V3-თან ერთნაირ არქიტექტურას იზიარებს, ფოკუსირებულია ინსტრუქციების შესრულების, კოდირებისა და მათემატიკური შესაძლებლობების გაუმჯობესებაზე. ის აჩვენებს ძლიერ შედეგებს ბენჩმარკებში, ხშირად GPT-4.5-ის დონეზე. სტატია ასევე განიხილავს მოდელის გამოყენების მეთოდებსა და უსაფრთხოების მნიშვნელოვან ასპექტებს, როგორიცაა ჩამოტვირთვის უსაფრთხ
Perceiver: ტრანსფორმერის არქიტექტურის შეზღუდვების დაძლევა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს Transformer-ის მოდელის რევოლუციურ ზეგავლენას ხელოვნური ინტელექტის (AI) სფეროზე, თუმცა ხაზს უსვამს მის მნიშვნელოვან შეზღუდვას: თვითყურადღების მექანიზმის გამო, ის ცუდად მასშტაბირდება მაღალი განზომილების მონაცემებთან. სტატია წარმოგიდგენთ Perceiver-ის არქიტექტურას, როგორც ამ პრობლემის გადაჭრის საშუალებას. Perceiver იყენებს ლატენტურ ცვლადებსა და ჯვარედინ ყურადღებას, რაც უზრუნველყოფს ხაზოვან დამოკიდებულებას შეყვანის ზომაზე და საშუალებას აძლევს მას ეფექტურად იმუშაოს მრავალფეროვან მ
Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.
Renumics Spotlight: გაამარტივეთ მონაცემთა ინსპექტირება Hugging Face ეკოსისტემაში
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს, რომლებიც ეხმარება მომხმარებლებს კრიტიკული კლასტერების იდენტიფიცირებაში Hugging Face მონაცემთა ნაკრებებში. ინსტრუმენტი უპრობლემოდ ინტეგრირდება Hugging Face-ის ეკოსისტემასთან, საშუალებას გაძლევთ გამოიყენოთ მოდელის შედეგები, როგორიცაა პროგნოზები და ემბედინგები, რათა ღრმად შეისწავლოთ მონაცემთა სეგმენტები და მოდელის ხარვეზები. Spotlight მნიშვნელოვნად ზრდის მონაცემთა ინსპექტირების მასშტაბურობას, ამარტივებს სამუშაო პროცესებს და ამცირებს დროის ხარ
GPT-J-ის ეფექტური დეპლოირება Amazon SageMaker-ისა და Hugging Face-ის გამოყენებით
სტატია განიხილავს EleutherAI-ის GPT-J მოდელის წარმოებაში ინტეგრაციის გამოწვევებს, განსაკუთრებით მეხსიერების მოხმარებისა და ჩატვირთვის ხანგრძლივი დროის თვალსაზრისით. ის წარმოადგენს გადაწყვეტას Amazon SageMaker-ისა და Hugging Face Inference Toolkit-ის გამოყენებით, PyTorch-ის მოდელების შენახვის ოპტიმიზებული მეთოდის მეშვეობით, რაც მნიშვნელოვნად ამცირებს ჩატვირთვის დროს (1 წუთი და 23 წამიდან 7.7 წამამდე) და GPT-J-ს საწარმოო სცენარებისთვის თავსებადს ხდის.