DeepSeek-R1-ის გარღვევა მსჯელობის მოდელებში და Open-R1 პროექტი: საიდუმლოების გამჟღავნებისკენ
DeepSeek-R1-ის ახალი მოდელი, რომელიც OpenAI-ის o1-ს უტოლდება ან აღემატება, დეტალური ტექნიკური ანგარიშით გამოვიდა, რამაც ხელოვნური ინტელექტის საზოგადოებაში დიდი აჟიოტაჟი გამოიწვია. მოდელი ეფუძნება ინოვაციურ მიდგომას, მათ შორის გაძლიერებულ სწავლებას ადამიანის ზედამხედველობის გარეშე. თუმცა, DeepSeek-მა არ გაასაჯაროვა თავისი მონაცემთა ნაკრებები და კოდი, რამაც Open-R1 პროექტი გააჩინა, რომელიც მიზნად ისახავს DeepSeek-R1-ის „რეცეპტის“ რეკონსტრუქციას, გამჭვირვალობის გაზრდას და ღია წყაროს მსჯელობის მოდელ
DeepSeek-R1-ის რევოლუცია: ღია წყაროს ინიციატივა მსჯელობის მოდელების გასახსნელად
DeepSeek-R1-ის გამოშვებამ ხელოვნური ინტელექტის სამყაროში მნიშვნელოვანი გარღვევა მოახდინა, წარმოადგინა მსჯელობის უნარის მქონე მოდელი, რომელიც OpenAI-ის o1-ზე არანაკლებ ან უკეთესად მუშაობს. მისი შექმნის მეთოდოლოგია, განსაკუთრებით კი გაძლიერებითი სწავლის (RL) გამოყენება ადამიანის ზედამხედველობის გარეშე, დეტალურად იქნა აღწერილი. მიუხედავად იმისა, რომ მოდელის წონები ღიაა, მისი სავარჯიშო მონაცემები და კოდი საიდუმლოდ დარჩა. ამის საპასუხოდ, Open-R1 პროექტი მიზნად ისახავს DeepSeek-R1-ის მონაცემთა და სავა

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ
BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს

Deepseek R1-ის 'აჰა მომენტი' და მისი ხელახლა შექმნა GRPO-სა და Countdown თამაშის მეშვეობით
Deepseek R1-ის გამოშვებამ ინდუსტრია შეძრა, რადგან ის არის ღია მოდელი, რომელიც OpenAI-ის o1-ს ეჯიბრება კომპლექსური მსჯელობის ამოცანებში. მოდელი გამოირჩევა „აჰა მომენტით“ – თვითვერიფიკაციის უნარით ადამიანური ჩარევის გარეშე. ეს ბლოგ პოსტი მიზნად ისახავს ამ უნიკალური ქცევის ხელახლა შექმნას Group Relative Policy Optimization (GRPO) და Countdown თამაშის გამოყენებით, დისტრიბუციულ ტრენინგზე ფოკუსირებით Deepspeed-ისა და vLLM-ის მეშვეობით.
DeepFloyd IF-ის ინტეგრაცია BentoML-თან პროდუქტიული განთავსებისთვის
სტატია მიმოიხილავს, თუ როგორ ხდება BentoML-ის, ღია კოდის პლატფორმის, გამოყენება DeepFloyd IF-ის, თანამედროვე ტექსტიდან გამოსახულების გენერირების მოდელის, განთავსებისთვის. აღწერილია DeepFloyd IF-ის უნიკალური არქიტექტურა (პიქსელურ სივრცეში მუშაობა, კასკადური დიფუზია, LLM-ის გამოყენება მოთხოვნებისთვის) და BentoML-ის მეშვეობით რესურსების ოპტიმალური მართვა, მათ შორის GPU-ს განაწილება. მოცემულია ინსტრუქციები პროექტის ლოკალურად გაშვებისთვის, მოდელების ჩამოტვირთვისთვის, სერვერის Gradio-სთან ერთად გაშვებ
Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.

ფიზიკური ინტელექტის ინოვაცია: რობოტების გენერალისტი კონტროლის მოდელები π0 და π0-FAST
Physical Intelligence-მა წარმოადგინა π0 და π0-FAST, პროტოტიპული მოდელები და სასწავლო ფრეიმვორკები, რომლებიც შექმნილია რობოტების გენერალისტური კონტროლისთვის. ისინი მიზნად ისახავს ხიდის გადებას ხელოვნური ინტელექტის სისტემებსა და ფიზიკურ სამყაროს შორის არსებულ ხარვეზებს შორის, LLM-ებისა და VLM-ებისგან განსხვავებით, რომელთაც ფიზიკურ სამყაროსთან ურთიერთქმედება აკლიათ. π0, ხედვით-ენობრივ-მოქმედებითი (VLA) მოდელი, გაწვრთნილია 7 რობოტული პლატფორმისა და 68 უნიკალური ამოცანის მონაცემებზე, რაც მას საშუალებ
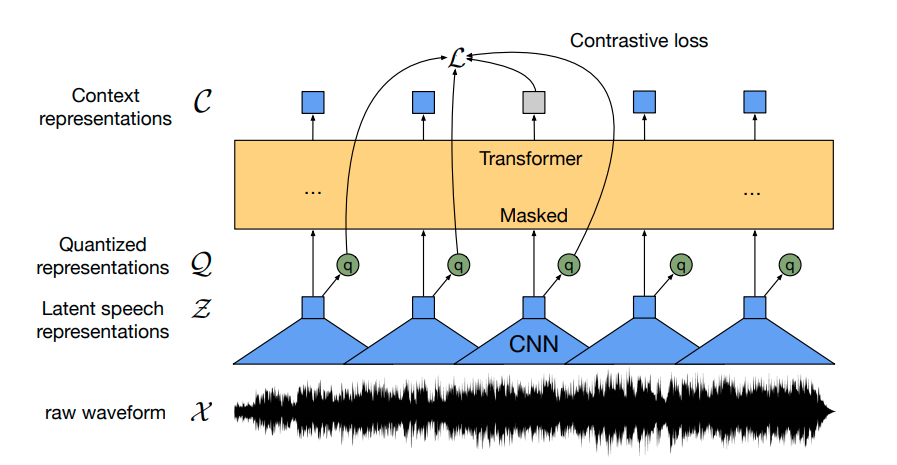
Wav2Vec2: გარღვევა მეტყველების ამოცნობაში მინიმალური მარკირებული მონაცემებით
Wav2Vec2, რევოლუციური ხელოვნური ინტელექტის მოდელი, სწავლობს მეტყველების მძლავრ წარმოდგენებს დიდი მოცულობის არამარკირებული აუდიო მონაცემებიდან, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მეთოდის გამოყენებით. მან აჩვენა უპრეცედენტო შედეგები ავტომატური მეტყველების ამოცნობის (ASR) სფეროში, მიაღწია უმაღლეს დონეს მაშინაც კი, როდესაც დამატებითი ვარჯიში (fine-tuning) ხდება სულ რაღაც 10 წუთის მარკირებულ მეტყველების მონაცემებზე. ეს მას ქმნის მაღალეფექტურ გადაწყვეტილებად ძლიერი ASR სისტემების შესაქმნელად, რ
IDEFICS: ღია მულტიმოდალური AI მოდელი გამჭვირვალე კვლევისთვის
IDEFICS, 80 მილიარდი პარამეტრის მულტიმოდალური ხელოვნური ინტელექტის (AI) მოდელი, რომელიც Flamingo-ს ღია წყაროს რეპროდუქციას წარმოადგენს, უკვე ხელმისაწვდომია. მისი შექმნისას დიდი აქცენტი გაკეთდა გამჭვირვალობაზე, გამოყენებულ იქნა მხოლოდ საჯაროდ ხელმისაწვდომი მონაცემები და შეფასდა პოტენციური მიკერძოებები. მოდელი მიზნად ისახავს მულტიმოდალური AI სისტემების სფეროში უფრო ღია კვლევების წახალისებას და მისი დემო ვერსიები Hugging Face Hub-ზეა განთავსებული.
მომხმარებელთა შეფასებების სენტიმენტური ანალიზის მიკროსერვისის შექმნა Google Cloud-ზე
სტატია აღწერს მიკროსერვისის შექმნის პროცესს, რომელიც Discord-ში დატოვებულ მომხმარებელთა შეფასებებს ავტომატურად აანალიზებს და მათ პოზიტიურ ან ნეგატიურ შინაარსს განსაზღვრავს. ავტორი განიხილავს საწყის სირთულეებს მოდელის ჩატვირთვისა (როგორიცაა .h5 ფაილის ტიპის გაგება) და შესაბამისი ღრუბლოვანი პლატფორმის შერჩევისას (AI-Platform Prediction, App Engine, Cloud Run). საბოლოოდ, წარმოადგენს Cloud Run-სა და PyTorch-ზე დაფუძნებულ, Docker-ის გამოყენებით განხორციელებულ გადაწყვეტას, რომელიც ოპტიმიზირებულია მეხს
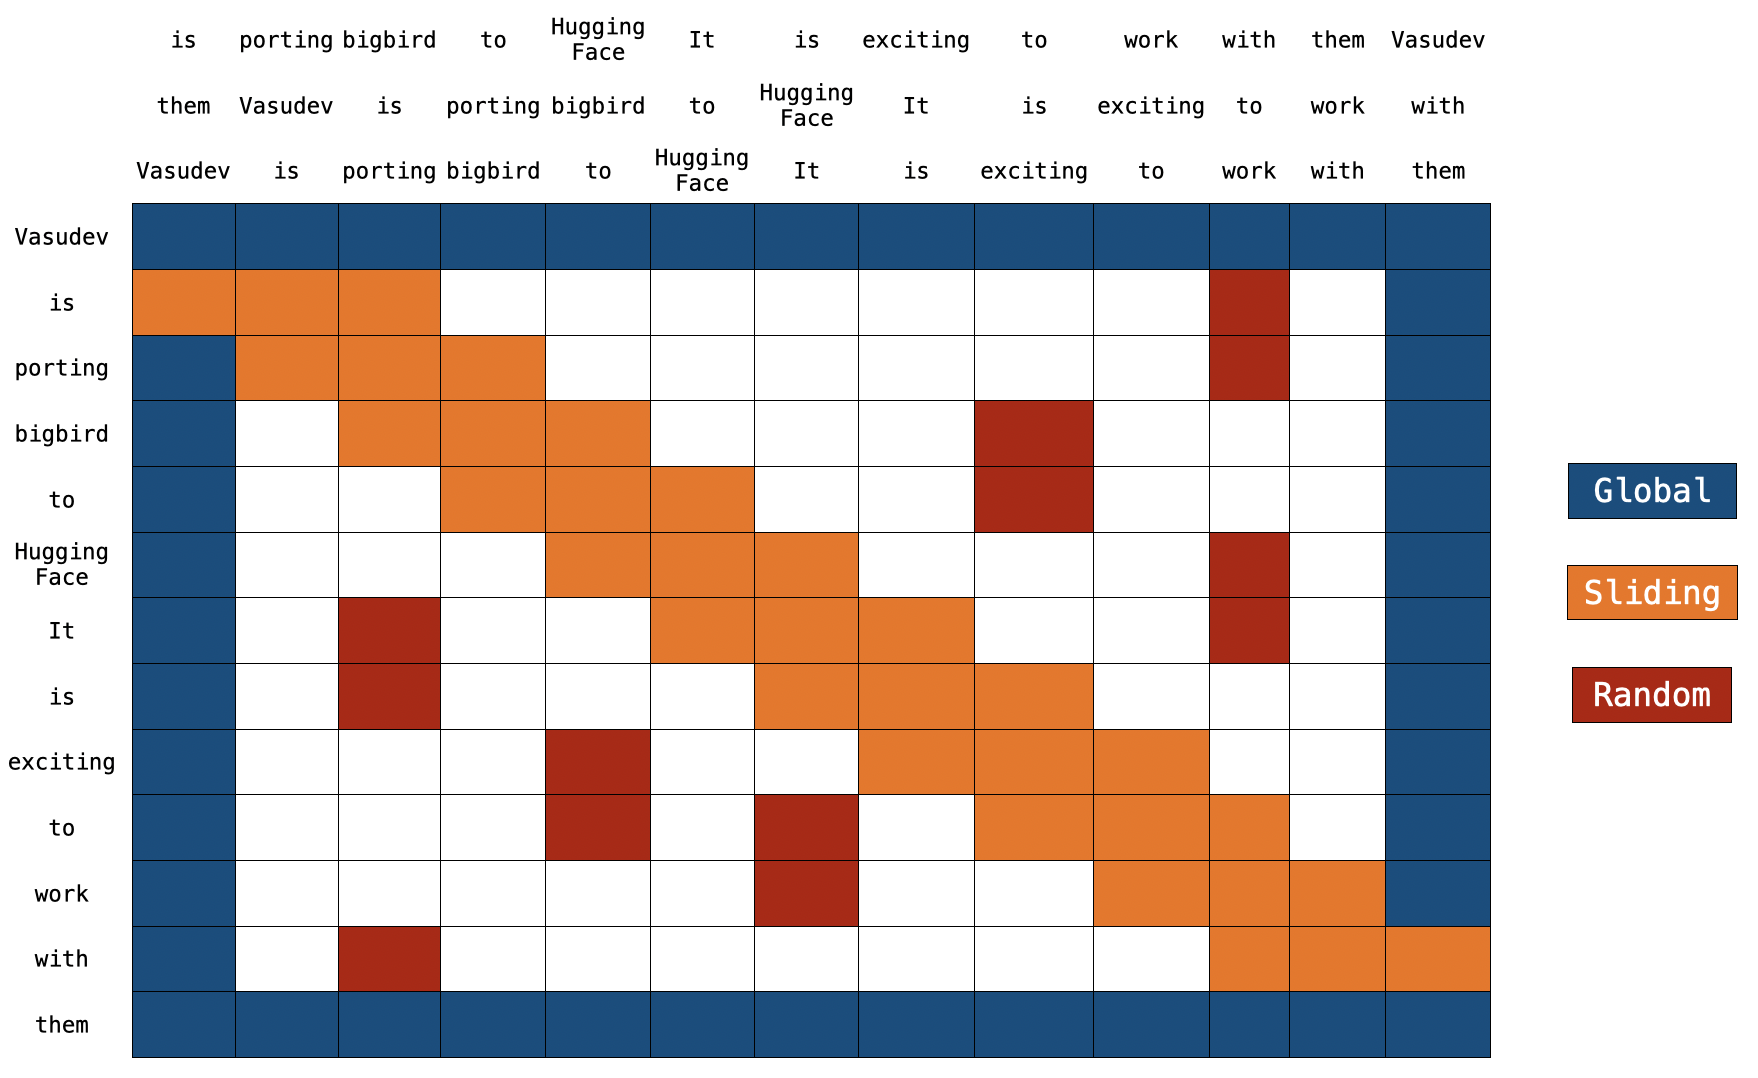
BigBird: ტრანსფორმატორების ახალი ეფექტური მიდგომა გრძელი თანმიმდევრობებისთვის
ტრანსფორმატორული მოდელები ფართოდ გამოიყენება NLP ამოცანებში, თუმცა მათი O(n^2) დროითი და მეხსიერების სირთულე ზღუდავს მათ გამოყენებას გრძელ თანმიმდევრობებზე (n > 512). BigBird, ახალი მოდელი, ამ პრობლემას ბლოკ-სპარსული ყურადღების (block sparse attention) გამოყენებით აგვარებს, რაც საშუალებას აძლევს მას დაამუშაოს თანმიმდევრობები 4096 სიგრძემდე, მნიშვნელოვნად დაბალი გამოთვლითი დანახარჯით, ვიდრე BERT. BigBird-მა მიაღწია საუკეთესო შედეგებს (SOTA) გრძელ დოკუმენტებთან დაკავშირებულ ამოცანებში, როგორიცაა შ
Hugging Face Transformers-ისა და AWS SageMaker-ის ინტეგრაცია: მარტივი და სწრაფი AI მოდელების ტრენინგი
Hugging Face-ისა და AWS SageMaker-ის გუნდებმა ერთობლივად შექმნეს Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები, რაც მნიშვნელოვნად აჩქარებს Transformers-ზე დაფუძნებული მოდელების ტრენინგს. ახალი HuggingFace estimator-ის წყალობით SageMaker Python SDK-ში, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ეს ინტეგრაცია დეტალურად აღწერილია ბლოგ-პოსტში, რომელიც მოიცავს დაწყების მაგალითებსა და დოკუმენტაციას. სტატია განმარტავს, თუ როგორ ხდება Facebook-ის BART-large-cnn მოდელის დახვეწა Samsum მ
AWS SageMaker-ისა და Hugging Face-ის ინტეგრაცია: Transformer-ზე დაფუძნებული მოდელების ოპტიმიზებული ტრენინგი
AWS SageMaker-ისა და Hugging Face-ის გუნდებმა ერთობლივად შექმნეს ოპტიმიზებული ღრმა სწავლის კონტეინერები (DLCs) Transformer-ზე დაფუძნებული მოდელების ტრენინგის დასაჩქარებლად. ახალი HuggingFace estimator-ის SageMaker Python SDK-ში ინტეგრაციის წყალობით, მომხმარებლებს შეუძლიათ ტრენინგის დაწყება კოდის მხოლოდ ერთი ხაზით. სტატია დეტალურად აღწერს ამ ინტეგრაციას, მოიცავს განაწილებული Seq2Seq-transformer მოდელის გაწვრთნის პროცესს შეჯამების ამოცანისთვის და განხილულია მოდელის ატვირთვისა და ტესტირების ნაბიჯებ
AI აუდიო გენერაცია: AudioLDM 2-ის სიჩქარის რეკორდი - 10 წამი 1 წამში
AudioLDM 2, ტექსტიდან აუდიოს გენერირების ხელოვნური ინტელექტის მძლავრი მოდელი, ადრე გამოირჩეოდა ნელი მუშაობით, 10-წამიანი აუდიოს შესაქმნელად 30 წამზე მეტი სჭირდებოდა. ახალი ბლოგ პოსტი დეტალურად აღწერს, თუ როგორ იქნა მიღწეული ინფერენციის დროის 10-ჯერ შემცირება, კოდისა და მოდელის ოპტიმიზაციების, მათ შორის ნახევრად ზუსტი გამოთვლებისა და Flash Attention-ის გამოყენებით. შედეგად, შესაძლებელია 10-წამიანი აუდიო ნიმუშის გენერირება მხოლოდ 1 წამში, ხარისხის მინიმალური გაუარესებით, Hugging Face Diffusers ბიბ
Fetch-მა ქვითრების სკანირების სიზუსტე 200%-ით გაზარდა AWS-ის მანქანური სწავლისა და Hugging Face-ის გამოყენებით
Fetch-მა, მომხმარებლის ჩართულობისა და ჯილდოების კომპანიამ, მნიშვნელოვნად გააუმჯობესა ქვითრების სკანირების აპლიკაციის სიჩქარე და სიზუსტე, Amazon Web Services-ზე (AWS) მანქანური სწავლების პაიპლაინის ოპტიმიზაციით, Hugging Face-ისა და Amazon SageMaker-ის გამოყენებით. ამ ცვლილებამ დოკუმენტის აღქმის მოდელის სიზუსტე 200%-ით გაზარდა და ნელი სკანირებისთვის დაყოვნება 50%-ით შეამცირა, რამაც დააჩქარა ჯილდოების დამუშავება და გაზარდა პარტნიორების ნდობა.

Math-Verify-ის დანერგვა: ღია LLM ლიდერბორდის რეიტინგების გადაფასება უფრო სამართლიანი შედარებებისთვის
Hugging Face-ის ღია LLM ლიდერბორდმა მნიშვნელოვანი განახლება განიცადა Math-Verify ინსტრუმენტის დანერგვით. ამ ახალმა სისტემამ ხელახლა შეაფასა ყველა 3,751 წარმოდგენილი მოდელი, რამაც გამოასწორა მათემატიკური ამოცანების შეფასების კრიტიკული პრობლემები. შედეგად, ბევრი მოდელის, განსაკუთრებით Qwen-ისა და DeepSeek-ის, ქულები მნიშვნელოვნად გაუმჯობესდა, ხოლო MATH ქვეჯგუფის ტოპ 20 რეიტინგი სრულად გადალაგდა, სადაც Nvidia-ს AceMath მოდელები ახლა დომინირებენ. ეს უზრუნველყოფს მსხვილი ენობრივი მოდელების (LLM) უფრო
Gradio 2.0: Hugging Face-ის მოდელების გამოყენება გრაფიკული ინტერფეისით კოდის მხოლოდ 1 ხაზში
Hugging Face-ის მოდელების ცენტრში ათასობით მანქანური სწავლების მოდელია ხელმისაწვდომი. Gradio-ს ბიბლიოთეკა დეველოპერებს უკვე აძლევდა საშუალებას, მარტივად შეექმნათ დემოები. ახლა, Gradio 2.0-ით, Hugging Face-ის თითქმის ნებისმიერი მოდელის ჩატვირთვა და გრაფიკული ინტერფეისით (GUI) გამოყენება კოდის მხოლოდ 1 ხაზშია შესაძლებელი. ეს სიახლე მნიშვნელოვნად ამარტივებს ხელოვნური ინტელექტის მოდელების ხელმისაწვდომობას როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის და ხსნის ახალ შესაძლებლობებს კომპლექსური
Hugging Face წარმოგიდგენთ TII-ის Falcon 180B-ს: ღია წყაროს მოდელების უახლესი მიღწევა
Hugging Face სიამაყით წარადგენს TII-ის Falcon 180B-ს – ღია წყაროს უდიდეს და უახლესი ტექნოლოგიების მწვერვალზე მდგომ ენობრივ მოდელს. 180 მილიარდი პარამეტრით და 3.5 ტრილიონ ტოკენზე გაწვრთნილი Falcon 180B ლიდერობს ღია წყაროს მოდელებს შორის და კონკურენციას უწევს ისეთ კომერციულ გიგანტებს, როგორიცაა Google-ის PaLM-2. მოდელი უკვე ხელმისაწვდომია Hugging Face Hub-ზე, რაც მაღალი შესაძლებლობის ხელოვნურ ინტელექტს ფართო საზოგადოებისთვის ხელმისაწვდომს ხდის.

Few-Shot Learning ხელოვნურ ინტელექტში: GPT-Neo და აჩქარებული დასკვნის API
სტატია განმარტავს „Few-Shot Learning“ (რამდენიმე მაგალითზე დაფუძნებული სწავლების) კონცეფციას, როგორც მანქანური სწავლების ტექნიკას, რომელიც მოდელს მცირე რაოდენობის მონაცემებით წვრთნის. განხილულია მისი გამოყენება ბუნებრივი ენის დამუშავებაში (NLP) დიდი ენობრივი მოდელების, როგორიცაა EleutherAI GPT-Neo და OpenAI GPT-3, მეშვეობით. სტატია ასევე მიმოიხილავს Hugging Face-ის აჩქარებული დასკვნის (Accelerated Inference) API-ის როლს, ამ ტექნიკის ოპტიმიზაციას, გამოწვევებს (მაგ., მოდელის მგრძნობელობა მაგალითებ

Sentence Transformers v2: რევოლუციური განახლებები და ინტეგრაცია Hugging Face Hub-თან
Sentence Transformers-ის v2 ვერსიის გამოშვება ახალ შესაძლებლობებს გვთავაზობს წინადადების, აბზაცისა და გამოსახულების ემბედინგებისთვის. განახლება მოიცავს Hugging Face Hub-თან ღრმა ინტეგრაციას, 90-ზე მეტი წინასწარ გაწვრთნილი მოდელით 100-ზე მეტი ენისთვის. წარმოდგენილია ახალი ვიჯეტები – ფუნქციის ექსტრაქციისა და წინადადების მსგავსების გამოსათვლელად, ასევე API ინტერფეისები მოდელებთან პროგრამული წვდომისთვის, რაც საზოგადოებას საშუალებას აძლევს მარტივად გააზიაროს და გამოიყენოს თავისი გაწვრთნილი მოდელები.
Amazon SageMaker ამარტივებს Hugging Face Transformers-ის დეპლოირებას ახალი Inference DLC-ებითა და ხელსაწყოებით
Amazon SageMaker-მა გამოუშვა Hugging Face Inference DLC-ები და ახალი Inference Toolkit, რაც მნიშვნელოვნად ამარტივებს Hugging Face Transformers მოდელების დეპლოირებას. ეს სიახლე საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ როგორც საკუთარი გაწვრთნილი მოდელები, ისე Hugging Face Model Hub-დან 10,000-ზე მეტი საჯაროდ ხელმისაწვდომი მოდელი, სულ ერთი დამატებითი კოდის ხაზით. SageMaker უზრუნველყოფს საპროდუქციო გარემოსთვის მზა ენდპოინტებს ჩაშენებული მონიტორინგითა და მასშტაბირებადი შესაძლებლობებით.
SmolVLM2: ვიდეოს გაგება ხელმისაწვდომი ხდება ყველა მოწყობილობაზე
SmolVLM2 წარმოადგენს ფუნდამენტურ ცვლილებას ვიდეოს გაგების მიდგომაში, მოძრაობს მასიური, რესურსმომთხოვნი მოდელებიდან ეფექტურ, ნებისმიერ მოწყობილობაზე გაშვებად გადაწყვეტილებებზე. მიზანია ვიდეოს გაგება ხელმისაწვდომი გახდეს ყველა მოწყობილობისთვის, ტელეფონებიდან სერვერებამდე. გამოშვებულია სამი ზომის (2.2B, 500M და 256M) მოდელი, MLX-თან თავსებადობით (Python და Swift API-ები). ეს მოდელები, მიუხედავად მცირე ზომისა, მნიშვნელოვნად აღემატება არსებულ ანალოგებს მეხსიერების მოხმარების მხრივ და ზოგიერთ შემთხვევ