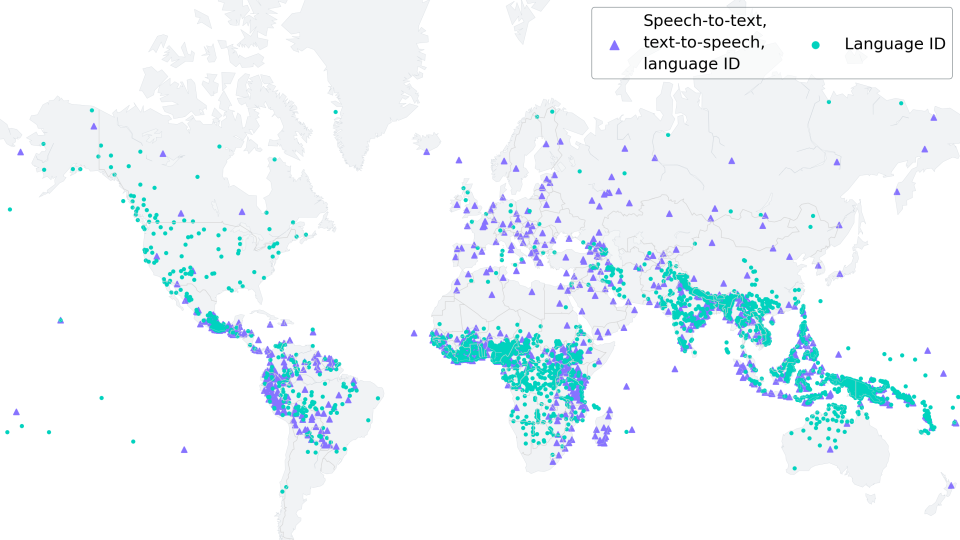
Meta AI-ის რევოლუციური MMS მოდელი: 1100-ზე მეტი ენის მხარდაჭერა და გადაშენების პირას მყოფი ენების შენარჩუნება
Meta AI-მ წარმოადგინა Massive Multilingual Speech (MMS) მოდელი, რომელსაც შეუძლია 1100-ზე მეტი ენის ამოცნობა, ტრანსკრიფცია და გენერაცია. ეს ინოვაციური სისტემა, რომელიც იყენებს „ადაპტერის“ წვრთნის მეთოდს, მნიშვნელოვნად ამცირებს შეცდომის მაჩვენებელს მცირე რესურსების მქონე ენებისთვის და ხელს უწყობს გადაშენების პირას მყოფი ენების შენარჩუნებას, რადგან მათთვის წერილობითი ჩანაწერების შექმნასა და მშობლიურ ენაზე კომუნიკაციას უწყობს ხელს. MMS-ის ადაპტერის წვრთნა უფრო ეფექტურია მეხსიერების თვალსაზრისით, უფრ

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი
Bamba-9B: ახალი ჰიბრიდული Mamba2 მოდელი გაუმჯობესებული ეფექტურობით და ღია წყაროს ხელმისაწვდომობით
წარმოგიდგენთ Bamba-9B-ს, დასკვნის ეფექტურობაზე ორიენტირებულ ჰიბრიდულ Mamba2 მოდელს, რომელიც შემუშავებულია IBM-ის, პრინსტონის, CMU-სა და UIUC-ის მიერ, სრულად ღია მონაცემებზე. მოდელი უზრუნველყოფს 2.5-ჯერ გამტარუნარიანობის გაუმჯობესებას და 2-ჯერ შეყოვნების შემცირებას სტანდარტულ ტრანსფორმერებთან შედარებით და დაუყოვნებლივ ხელმისაწვდომია საზოგადოებისთვის ექსპერიმენტებისთვის სხვადასხვა პოპულარულ ბიბლიოთეკაში. მისი მიზანია KV-ქეშის შეზღუდვების დაძლევა და Mamba არქიტექტურების ფართოდ დანერგვა.
როგორ ვებრძოლოთ მიკერძოებას ტექსტიდან გამოსახულების გენერაციის სისტემებში?
ტექსტიდან გამოსახულების გენერაციის (TTI) მოდელები სულ უფრო პოპულარული ხდება, თუმცა მათში ჩაშენებული მიკერძოებები მნიშვნელოვან ეთიკურ გამოწვევას წარმოადგენს. ეს ბლოგპოსტი იკვლევს მიკერძოების წყაროებს TTI სისტემებში, მათ შორის საწვრთნელ მონაცემებში, ფილტრაციის პროცესებში, ინფერენციასა და მოდელის ლატენტურ სივრცეში არსებულ პრობლემებს, ასევე განიხილავს მათ გადასაჭრელ ინსტრუმენტებსა და პოტენციურ გადაწყვეტებს.
Habana Gaudi2-ის რეკორდული სისწრაფე BridgeTower-ის დახვეწისას: A100-ზე 2.5-ჯერ, H100-ზე 1.4-ჯერ სწრაფი
უახლესი კვლევის მიხედვით, Habana Gaudi2-ზე Optimum Habana v1.7-ის გამოყენებით, შესაძლებელია BridgeTower ხედვა-ენის მოდელის დახვეწის პროცესის მნიშვნელოვნად დაჩქარება. ეს მიღწევა, რომელიც A100-თან შედარებით 2.5-ჯერ, ხოლო H100-თან შედარებით 1.4-ჯერ ზრდის სისწრაფეს, ეფუძნება აპარატურულად აჩქარებულ მონაცემთა ჩატვირთვას. ეს ტექნიკები ნებისმიერ სხვა სამუშაო დატვირთვასაც ესადაგება, სადაც მონაცემთა ჩატვირთვა წარმოადგენს შეფერხებას, რაც ხედვის მოდელებისთვის ხშირია.

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერების გამოყენებას PyTorch-ში
ეს სტატია დეტალურად განიხილავს, თუ როგორ უნდა მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია, გაგება და ოპტიმიზაცია PyTorch-ში ტრენინგის დროს. ის ეტაპობრივად ხსნის მეხსიერების განაწილებას მოდელის შექმნის, შეყვანის ტენზორების, Forward/Backward გავლისა და ოპტიმიზატორის ნაბიჯებისთვის, დეტალური მაგალითებისა და პროფაილინგის ხელსაწყოების გამოყენებით. გაანალიზებულია როგორც გამარტივებული, ასევე რეალური LLM-ის ტრენინგის მეხსიერების პროფილი.
როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერებას PyTorch-ში
ეს გაკვეთილი ეტაპობრივად განმარტავს, თუ როგორ მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია და გაგება PyTorch-ში ტრენინგის დროს. ის მოიცავს მეხსიერების მოთხოვნების შეფასებას, გამოყენების ოპტიმიზაციას PyTorch-ის პროფილის ხელსაწყოების მეშვეობით და დეტალურ ანალიზს იმის შესახებ, თუ როგორ იქცევა მეხსიერება მოდელის შექმნის, წინსვლის, უკუგადაცემის და ოპტიმიზატორის ნაბიჯების განმავლობაში, მათ შორის დიდი ენობრივი მოდელების (LLM) რეალურ სცენარებში.
როგორ შევქმნათ AI-ზე დაფუძნებული ხატვის თამაში ბრაუზერში: Quick, Draw!-ის შთაგონებით
გაეცანით დეტალურ სახელმძღვანელოს, თუ როგორ უნდა შექმნათ ხელოვნური ინტელექტზე დაფუძნებული ხატვის თამაში, რომელიც Google-ის „Quick, Draw!“-ით არის შთაგონებული. პროექტი გვიჩვენებს, როგორ მივაღწიოთ რეალურ დროში, წამში 60-ზე მეტ პროგნოზს, მოდელის ბრაუზერში გაშვებით, Transformers.js-ის, MobileViT მოდელისა და Web Workers-ის გამოყენებით. სტატია მოიცავს მოდელის მომზადებას, ONNX-ში კონვერტაციას და React აპლიკაციის აგებას.
LLM-ების ინფერენციისას ნახშირბადის ემისიების კვლევა: მოულოდნელი აღმოჩენები საზოგადოების მიერ შექმნილ მოდელებში
ბოლო წლებში დიდი ენობრივი მოდელების (LLM) გამოყენების გარემოზე ზემოქმედებაზე ცნობიერება იზრდება. ეს სტატია იკვლევს LLM-ების ინფერენციის ფაზაში ნახშირბადის ემისიებს, წარმოადგენს Open LLM Leaderboard-ში ემისიის შეფასებების ინტეგრაციას და მოულოდნელ აღმოჩენებს, მაგალითად, რომ საზოგადოების მიერ მორგებული მოდელები (community fine-tunes) ხშირად უფრო ნახშირბადეფექტურია, ვიდრე ოფიციალური მოდელები. განხილულია ემისიების ცვლილებები სხვადასხვა მოდელის ტიპისა და ზომის მიხედვით, რაც მიზნად ისახავს მომხმარებლებ
vdr-2b-multi-v1: მრავალენოვანი ჩაშენების მოდელი ვიზუალური დოკუმენტების ეფექტური მოძიებისთვის
Hugging Face-ის მიერ წარდგენილია vdr-2b-multi-v1, მრავალენოვანი ჩაშენების მოდელი, რომელიც განკუთვნილია ვიზუალური დოკუმენტების მოძიებისთვის სხვადასხვა ენასა და დომენში. ეს მოდელი აკოდირებს დოკუმენტის გვერდის სქრინშოტებს მკვრივ ერთვექტორულ წარმოდგენებად, რაც შესაძლებელს ხდის ვიზუალურად მდიდარი მრავალენოვანი დოკუმენტების ძიებას და მოთხოვნას OCR-ის, მონაცემთა ამოღების კონვეიერების ან დანაწილების გარეშე. იგი აგებულია MrLight/dse-qwen2-2b-mrl-v1-ზე და გაწვრთნილია ვრცელ, თვითშექმნილ მონაცემთა ბაზაზე. L

ახალი მეთოდი სტატიკური ემბედინგის მოდელების საწვრთნელად: 100-400-ჯერ უფრო სწრაფი CPU-ზე
ეს ბლოგპოსტი წარმოგიდგენთ მეთოდს სტატიკური ემბედინგის მოდელების საწვრთნელად, რომლებიც CPU-ზე 100-400-ჯერ უფრო სწრაფად მუშაობენ, ვიდრე უახლესი მოდელები, ხარისხის უმეტესი ნაწილის შენარჩუნებით. ეს ხსნის უამრავ საინტერესო გამოყენების შესაძლებლობას, მათ შორის მოწყობილობაზე და ბრაუზერში გაშვებას, Edge Computing-ს, დაბალენერგეტიკულ და ჩაშენებულ აპლიკაციებს. ჩვენ გამოვიყენეთ ეს მიდგომა ორი უკიდურესად ეფექტური ემბედინგის მოდელის მოსამზადებლად: sentence-transformers/static-retrieval-mrl-en-v1 ინგლისური ინ
Meta-მ Llama 2 გამოუშვა: ღია წვდომის დიდი ენობრივი მოდელი კომერციული გამოყენებისთვის, Hugging Face-ის ინტეგრაციით
Meta-მ წარმოადგინა Llama 2, თანამედროვე, ღია წვდომის დიდი ენობრივი მოდელების ოჯახი, რომელიც 7B-დან 70B პარამეტრამდე მერყეობს და ხელმისაწვდომია კომერციული გამოყენებისთვის. Hugging Face სრულად უჭერს მხარს გამოშვებას ყოვლისმომცველი ინტეგრაციით, რაც დეველოპერებს საშუალებას აძლევს მარტივად გამოიყენონ, გაუშვან ინფერენცია და დახვეწონ მოდელები. Llama 2-Chat ვერსიები, რომლებიც ოპტიმიზებულია დიალოგისთვის, ChatGPT-ის მსგავს შესრულებას აჩვენებს სარგებლიანობისა და უსაფრთხოების ბენჩმარკებზე.
Hugging Face-ის TGI წარმოგიდგენთ ახალ Backends არქიტექტურას: გამარტივებული LLM-ების განთავსება და გაუმჯობესებული წარმადობა
Hugging Face-მა წარმოადგინა TGI Backends, ახალი არქიტექტურა Text-Generation-Inference (TGI)-ისთვის, რომელიც მიზნად ისახავს LLM-ების განთავსების პროცესის გამარტივებას და ოპტიმალური წარმადობის უზრუნველყოფას. ეს სიახლე აერთიანებს სხვადასხვა ინფერენსინგის გადაწყვეტებს ერთიან ფრონტენდ ფენაში, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შეცვალონ ბეკენდები მათი მოდელირების, აპარატურის და წარმადობის მოთხოვნების შესაბამისად.
EsperBERTo: ხელოვნური ინტელექტის მოდელის შექმნა და ტრენინგი ესპერანტოზე
ამ პოსტში წარმოდგენილია, თუ როგორ ხდება ხელოვნური ინტელექტის მცირე ენობრივი მოდელის, EsperBERTo-ს, შექმნა და ტრენინგი ესპერანტოზე. მოდელი, რომელიც ზომით DistilBERT-ის მსგავსია, იყენებს სპეციალურად ოპტიმიზებულ ტოკენიზატორს და შემდგომში ადაპტირდება სიტყვის ნაწილების ამოცნობის ამოცანისთვის. ესპერანტო, როგორც ხელოვნური და ადვილად სასწავლი ენა, შერჩეულია დემონსტრაციისთვის, რათა ნათლად გამოჩნდეს მოდელის შესაძლებლობები.
ენის გენერაციის დეკოდირების სტრატეგიები: ხარბი და სხივური ძიება
ბოლო წლებში, დიდი ტრანსფორმერზე დაფუძნებული ენობრივი მოდელების (როგორიცაა ChatGPT და LLaMA) აღზევებამ მნიშვნელოვნად გაზარდა ინტერესი ღია ტიპის ენის გენერაციის მიმართ. მოდელის გაუმჯობესებული არქიტექტურისა და მასიური სასწავლო მონაცემების პარალელურად, გადამწყვეტი როლი შეასრულა დეკოდირების უკეთესმა მეთოდებმაც. ეს სტატია წარმოგიდგენთ დეკოდირების ძირითად სტრატეგიებს – ხარბ ძიებას (Greedy search), სხივურ ძიებას (Beam search) და სემპლინგს (Sampling) – და განმარტავს, თუ როგორ ხორციელდება მათი დანერგვა პო
„Reformer“ მოდელი: ტრანსფორმერის ახალი ერა გრძელი თანმიმდევრობების დამუშავებაში
ეს სტატია განიხილავს „Reformer“ მოდელს, რომელიც ქიტაევის, კაიზერის და სხვების (2020) მიერ იქნა წარმოდგენილი, როგორც დღესდღეობით ერთ-ერთი ყველაზე მეხსიერების ეფექტური „ტრანსფორმერის“ მოდელი გრძელი თანმიმდევრობის მოდელირებისთვის. აღწერილია მისი უპირატესობები სტანდარტულ მოდელებთან შედარებით NLP ამოცანებში, როგორიცაა შეჯამება და კითხვა-პასუხი, და განმარტებულია, თუ როგორ შეუძლია მას ერთდროულად ნახევარ მილიონამდე ტოკენის დამუშავება. პოსტი დეტალურად განიხილავს „Reformer“-ის ოთხ ძირითად მახასიათებელს, რ
Reformer მოდელი: მეხსიერება-ეფექტური ტრანსფორმერული არქიტექტურა გრძელი მიმდევრობების მოდელირებისთვის
კიტაევის, კაიზერისა და სხვების (2020) მიერ შემოთავაზებული Reformer მოდელი წარმოადგენს ერთ-ერთ ყველაზე მეხსიერება-ეფექტურ ტრანსფორმერულ არქიტექტურას გრძელი მიმდევრობების მოდელირებისთვის. NLP ამოცანების (მაგ. რეფერირება, კითხვა-პასუხის სისტემები) მზარდი მოთხოვნების დასაკმაყოფილებლად, Reformer-ს შეუძლია ნახევარ მილიონამდე ტოკენის დამუშავება, მაშინ როცა სტანდარტული BERT მოდელები 512 ტოკენით შემოიფარგლებიან. მისი არქიტექტურის თითოეული ნაწილი გადაკეთებულია მინიმალური მეხსიერების მოთხოვნილების ოპტიმიზა

SmolVLM-256M და SmolVLM-500M: მსოფლიოს ყველაზე პატარა ხედვის ენის მოდელები
კომპანიამ SmolVLM ოჯახის ორი ახალი წევრი, SmolVLM-256M და SmolVLM-500M, წარადგინა. 256 მილიონი პარამეტრის მქონე მოდელი მსოფლიოში ყველაზე პატარა ხედვის ენის მოდელია. ახალი მოდელები ეფუძნება SmolVLM 2B-დან მიღებულ გამოცდილებას, აქცენტი კეთდება ეფექტურობაზე, მონაცემთა ნარევებზე და დიზაინის ახალ კომპრომისებზე. ისინი ინარჩუნებენ მძლავრ მულტიმოდალურ მუშაობას გაცილებით მცირე ზომებში და მარტივად ინტეგრირდება არსებულ სისტემებში. ეს მოდელები განკუთვნილია როგორც შეზღუდული მოწყობილობებისთვის, ასევე დიდი მოც
ტრანსფორმერზე დაფუძნებული ენკოდერ-დეკოდერის მოდელები: არქიტექტურისა და ინფერენციის სიღრმისეული მიმოხილვა
ეს ბლოგ-პოსტი დეტალურად განმარტავს, თუ როგორ ამუშავებენ ტრანსფორმერზე დაფუძნებული ენკოდერ-დეკოდერის არქიტექტურის მოდელები მიმდევრობა-მიმდევრობაზე ამოცანებს. განხილულია მათემატიკური მოდელი და მისი გამოყენება ინფერენციაში, NLP-ში მიმდევრობა-მიმდევრობაზე მოდელების ისტორიულ კონტექსტთან ერთად. იგი ყოფს ტრანსფორმერის არქიტექტურას ენკოდერისა და დეკოდერის ნაწილებად, გვაწვდის ვიზუალურ მასალას და აკავშირებს თეორიას 🤗Transformers-ის პრაქტიკულ გამოყენებასთან. სტატია მოკლედ მიმოიხილავს ნეირონული ენკოდერ-დეკო
Stable Diffusion XL Core ML-ზე: მოდელის ზომის შემცირება და მუშაობის გაუმჯობესება
Hugging Face-ი და Apple-ი აგრძელებენ ხელოვნური ინტელექტის მოდელების ოპტიმიზაციას სამომხმარებლო მოწყობილობებზე ადგილობრივად გასაშვებად. უახლესი მცდელობა Stable Diffusion XL-ის Core ML-ზე ადაპტაციაა Apple Silicon-ის Mac-ებისთვის, რაც საშუალებას იძლევა მოდელი შემცირდეს ზომით და გაუმჯობესდეს მისი მუშაობა ინოვაციური კვანტიზაციის მეთოდებით, მათ შორის შერეული ბიტების პალეტიზაციით. პროექტი სრულად ღია კოდით არის ხელმისაწვდომი და community-ის ჩართულობას ელის.
Stable Diffusion XL სამომხმარებლო აპარატურაზე: მოდელის ზომისა და მუშაობის ოპტიმიზაციის ახალი გზები
Stable Diffusion XL (SDXL) დიდი ზომის მოდელია, თუმცა მისი გაშვება უკვე შესაძლებელია 16 GB GPU RAM-ის მქონე CUDA აპარატურაზე, მათ შორის Colab-ის უფასო ვერსიაზეც. ბოლო თვეებში გაიზარდა ინტერესი ML მოდელების ადგილობრივად გაშვების მიმართ, რაც განპირობებულია კონფიდენციალურობითა და მოხერხებულობით. Apple-მა და Hugging Face-მა წარმოადგინეს SDXL-ის Core ML ვერსია, რომელიც ღია წყაროა. ნერგდება ახალი ტექნიკა – შერეული ბიტის პალეტიზაცია (mixed-bit palettization), რომელიც მნიშვნელოვნად ამცირებს მოდელის ზომას

დიდი ენობრივი მოდელების კონტექსტის ფანჯრის გამოწვევები: KV Cache-ის მეხსიერების ოპტიმიზაცია KVPress-ით
დიდი ენობრივი მოდელების (LLM) გაფართოებული კონტექსტის ფანჯრები წარმოუდგენელ შესაძლებლობებს იძლევა, თუმცა KV Cache-ის მიერ მოხმარებული მეხსიერების მართვას ართულებს. მაგალითად, 1 მილიონი ტოკენის დამუშავება Llama 3-70B-ით 330 GB-ს მოითხოვს მხოლოდ KV Cache-ისთვის. NVIDIA-ს მიერ შემუშავებული KVPress ამ პრობლემის გადასაჭრელად კომპრესიის ინოვაციურ ტექნიკას გვთავაზობს, რომელიც მეხსიერების მოხმარებას ამცირებს მოდელის სიზუსტის შენარჩუნებით.
როგორ შევქმნათ PS1-ის სტილის 3D აქტივები გენერაციული ხელოვნური ინტელექტის გამოყენებით
ეს სტატია გთავაზობთ პრაქტიკულ სახელმძღვანელოს, თუ როგორ უნდა მოხდეს გენერაციული ხელოვნური ინტელექტის ინტეგრირება PlayStation 1-ის სტილის 3D აქტივების შექმნაში თამაშებისთვის. ის განმარტავს, თუ რატომ არის ეს სტილი იდეალური არსებული text-to-3D მოდელების დაბალი ხარისხისთვის და გვიჩვენებს ნაბიჯ-ნაბიჯ პროცესს Shap-E-სა და Blender-ის (Dream Textures-თან ერთად) გამოყენებით, ტექსტიდან გამოსაყენებელი დაბალხარისხოვანი 3D მოდელის მისაღებად. სტატია ხაზს უსვამს ამ მეთოდის პოტენციალს უსასრულო დაბალხარისხოვანი
LLM-ების კონფიდენციალურობისა და ინტელექტუალური საკუთრების დაცვა: Zama-ს გადაწყვეტა ჰომომორფული დაშიფვრით
დიდი ენობრივი მოდელების (LLM) ფართო გამოყენების მიუხედავად, მომხმარებლის მონაცემთა კონფიდენციალურობის საკითხი კვლავ გადაუჭრელ პრობლემად რჩება, რადგან არსებობს სენსიტიური ინფორმაციის LLM სერვისის მიმწოდებელთან გაჟონვის რისკი. Zama გვთავაზობს ინოვაციურ გადაწყვეტას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით, რომელიც საშუალებას აძლევს LLM-ებს, იმუშაონ დაშიფრულ მონაცემებზე. ეს მეთოდი იცავს როგორც მომხმარებლის კონფიდენციალურობას, ასევე მოდელის ინტელექტუალურ საკუთრებას, პროგნოზების ხარისხის შენარჩუ