ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.
Hugging Face: მრავალფეროვნება და ინკლუზია ხელოვნურ ინტელექტში – სტაჟირების პროგრამა
Hugging Face აცხადებს სტაჟირების პროგრამას და მოუწოდებს ყველა წარმოშობის კანდიდატს, წარმოადგინონ განაცხადები. კომპანია ხაზს უსვამს პასუხისმგებლიანი მანქანური სწავლების მნიშვნელობას, რათა ტექნოლოგიურმა პროგრესმა არ გაამწვავოს არსებული უთანასწორობა და მიზნად ისახავს ისეთი კულტურის შექმნას, რომელიც აფასებს მრავალფეროვნებას, თანასწორობასა და ინკლუზიურობას.
როგორ გავუშვათ Stable Diffusion Apple-ის მოწყობილობებზე Core ML-ის გამოყენებით
Apple-ის რეპოზიტორიუმი გვთავაზობს Stable Diffusion-ის კონვერტაციის სკრიპტებსა და დასკვნის (inference) კოდს Core ML-ისთვის. სიმარტივისთვის, მოდელების Core ML ვერსიები უკვე გადაყვანილია და ხელმისაწვდომია Hugging Face Hub-ზე. ასევე, შეიქმნა მშობლიური Swift აპლიკაცია, რომელიც Mac App Store-სა და ღია კოდის სახითაა გამოქვეყნებული, რათა მომხმარებლებმა მარტივად გაუშვან Stable Diffusion საკუთარ აპარატურაზე. სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ კონვერტირებული წონები, ან თავად გადაიყვანოთ დამატებით

Prezi და Hugging Face: როგორ ეხმარება ხელოვნური ინტელექტის ექსპერტთა მხარდაჭერა პრეზენტაციების ინოვაციებში
Prezi შეუერთდა Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას, რათა სრულად გამოიყენოს მანქანური სწავლების პოტენციალი. ბოლო თვეების განმავლობაში, Hugging Face-მა Prezi-ს მხარი დაუჭირა მცირე, უფრო ეფექტური ღია წყაროს მოდელების ინტეგრაციაში მათ ML სამუშაო პროცესებში. Prezi-ის Backend ინჟინერი, მათე ბორჩოკი, ხაზს უსვამს, თუ როგორ დააჩქარა ამ თანამშრომლობამ მათი AI პროდუქტების განვითარება, გააუმჯობესა პრეზენტაციების შექმნა და დეპლოირების ეფექტურობა მორგებული რჩევებისა და მოწინავე ინსტრუმენტების, მაგ
Prezi Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას უერთდება: ML პოტენციალის სრული გამოყენება
პრეზენტაციების ონლაინ ხელსაწყო Prezi, Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას შეუერთდა, რათა მაქსიმალურად აითვისოს თანამედროვე მანქანური სწავლების (ML) შესაძლებლობები. ამ თანამშრომლობის ფარგლებში, Hugging Face ეხმარება Prezi-ს უფრო მცირე და ეფექტური ღია კოდის მოდელების ინტეგრირებაში, რაც განსაკუთრებით მნიშვნელოვანია მულტიმოდალური მოდელების მზარდი შესაძლებლობების ფონზე. Prezi-ის ბექენდ ინჟინერი, მატე ბორჩოკი, იზიარებს თავის გამოცდილებას პროგრამაში მონაწილეობის შესახებ, ხაზს უსვამს ექსპერტ

მონაცემთა ნაკრებების შექმნა: საზოგადოების ძალისხმევა და მრავალენოვანი ინიციატივები Hugging Face-ისგან
სტატია აღწერს Hugging Face-ის საზოგადოების მიერ მონაცემთა ნაკრებების შექმნის მიზნით გაწეულ ძალისხმევას. ინიციატივა მოიცავს მოთხოვნების (prompts) რანჟირების პროექტსა და მრავალენოვანი მოთხოვნების შეფასების პროექტს (MPEP), რომელიც მიზნად ისახავს ღია LLM-ებისთვის ენობრივი ბენჩმარკების გაუმჯობესებას. ხაზგასმულია საზოგადოების წვლილის მნიშვნელობა მყარი და ყოვლისმომცველი რესურსების შესაქმნელად.
XLSCOUT-ი Hugging Face-თან პარტნიორობით პატენტების ანალიზში რევოლუციას ახდენს ParaEmbed 2.0-ით
ინტელექტუალურ საკუთრებაში ხელოვნური ინტელექტის (AI) გამოყენების ლიდერმა, XLSCOUT-მა, Hugging Face-თან თანამშრომლობით შეიმუშავა ParaEmbed 2.0 – მძლავრი საკუთრების მოდელი, რომელიც 23%-ით აუმჯობესებს სიზუსტეს პატენტების რთული დოკუმენტების ანალიზში. ეს პარტნიორობა, ღია კოდის AI მოდელებისა და XLSCOUT-ის სპეციალიზებული მონაცემების გაერთიანებით, უზრუნველყოფს მოწინავე გადაწყვეტილებებს პატენტების შედგენის, სიახლის ძიებისა და ბათილობის კვლევებისთვის, რითაც სარგებელს მიიღებენ კორპორაციები, უნივერსიტეტები დ
Hugging Face-ის 🤗 Datasets: აუდიო მონაცემთა ნაკრებების ჩამოტვირთვა და დამუშავება
🤗 Datasets წარმოადგენს ღია კოდის ბიბლიოთეკას, რომელიც უზრუნველყოფს სხვადასხვა სფეროდან მონაცემთა ნაკრებების მარტივად ჩამოტვირთვასა და მომზადებას. მისი მინიმალისტური API მომხმარებლებს საშუალებას აძლევს, ერთი ხაზის კოდით მოამზადონ მონაცემები, განსაკუთრებული ყურადღება ეთმობა აუდიო მონაცემთა დამუშავებას. Hugging Face Hub-თან ინტეგრაციის წყალობით, ბიბლიოთეკა მკვლევრებსა და პრაქტიკოსებს სთავაზობს უპრეცედენტო რაოდენობის აუდიო მონაცემთა ნაკრებებს.
მანქანური სწავლების სისტემებში მიკერძოების დაძლევა: Hugging Face-ის ინსტრუმენტები და გაკვეთილები
Hugging Face-ის ეთიკისა და საზოგადოების გუნდის ბლოგ-პოსტი ყურადღებას ამახვილებს მანქანური სწავლების (ML) სისტემებში მიკერძოების დაძლევის მნიშვნელობაზე. სტატია გთავაზობთ გაკვეთილებს და წარმოადგენს ინსტრუმენტებს ალგორითმული მიკერძოების ანალიზისა და შესამცირებლად ML განვითარების ყველა დონეზე. იგი ხაზს უსვამს კონტექსტის როლს, აფრთხილებს დისკრიმინაციის გამწვავების პოტენციალის შესახებ და მოუწოდებს ეთიკურ მიდგომას ამ სფეროში.
მანქანურ სწავლებაში მიკერძოების დაძლევა: Hugging Face-ის მიდგომები და ინსტრუმენტები
Hugging Face-ის „ეთიკა და საზოგადოება“ გუნდი წარმოგიდგენთ გაკვეთილებსა და ინსტრუმენტებს, რომლებიც შემუშავებულია მანქანურ სწავლებაში (ML) მიკერძოების წინააღმდეგ საბრძოლველად. სტატია ხაზს უსვამს ML სისტემების პოტენციურ უარყოფით გავლენას, მათ შორის დისკრიმინაციული ქცევების გამეორებას, და აჩვენებს Hugging Face-ის პიროვნულ მოტივაციას ამ რისკების გაგებისა და შემცირების მიმართ. იგი მოუწოდებს გულისხმიერ განვითარებას, კონტექსტის გათვალისწინებას და ინსტრუმენტების გამოყენებას მიკერძოების ყველა ეტაპზე გამოს
Hugging Face-ი მანქანური სწავლების მოდელების დოკუმენტაციის გასაუმჯობესებლად ახალ ხელსაწყოებსა და სახელმძღვანელოს უშვებს
Hugging Face-ი აქვეყნებს მოდელის ბარათის შექმნის ხელსაწყოსა და სახელმძღვანელოს, რაც მიზნად ისახავს მანქანური სწავლების (ML) მოდელების დოკუმენტაციის გამარტივებას, სტანდარტიზაციასა და გაუმჯობესებას. ეს ინიციატივა ხელს შეუწყობს სხვადასხვა წარმომავლობისა და როლის მქონე მომხმარებლების ჩართულობას, მათ შორის დეველოპერების, სტუდენტების, პოლიტიკოსების, ეთიკოსების და მათ, ვისზეც ML მოდელები გავლენას ახდენენ. პროექტი მოიცავს პროგრამირების გარეშე ბარათების შექმნის საშუალებას, განახლებულ შაბლონს და დეტალურ ი

Google Cloud C4 VM-ები Intel Xeon 6 პროცესორებით: AI-სთვის ოპტიმიზაცია და მფლობელობის ხარჯების 1.7x შემცირება
უახლესი კვლევის შედეგები აჩვენებს, რომ Google Cloud C4 VM ინსტანციები, რომლებიც Intel Xeon 6 პროცესორებითაა აღჭურვილი, 1.7-ჯერ აუმჯობესებს მფლობელობის საერთო ღირებულებას (TCO) წინა თაობის Google C3 VM-ებთან შედარებით. ეს შთამბეჭდავი წინსვლა მიღწეულია GPT OSS (Mixture of Experts – MoE) მოდელების ეფექტური მხარდაჭერით, Intel-ისა და Hugging Face-ის მიერ განხორციელებული ოპტიმიზაციების წყალობით, რაც უზრუნველყოფს გაუმჯობესებულ გამტარობას, შემცირებულ შეყოვნებას და ხარჯების ოპტიმიზაციას მსხვილი MoE ინფერ

Hugging Face მონაცემთა ნაკრებების ძებნის ოთხ ახალ ფუნქციას წარმოგიდგენთ
Hugging Face განაგრძობს Dataset Hub-ის გაუმჯობესებას და Dataset Search-ისთვის ოთხ ახალ ფუნქციას აცხადებს. ეს სიახლეები მოიცავს მონაცემთა მოდალობის (ტიპის) მიხედვით ფილტრაციას, სტრიქონების რაოდენობის მიხედვით ძებნას, მონაცემთა ფორმატების ფილტრაციას და ბიბლიოთეკებთან თავსებადობის მიხედვით ძებნას, რაც მომხმარებლებს საშუალებას მისცემს, უფრო ეფექტურად იპოვონ სასურველი ღია მონაცემთა ნაკრებები.
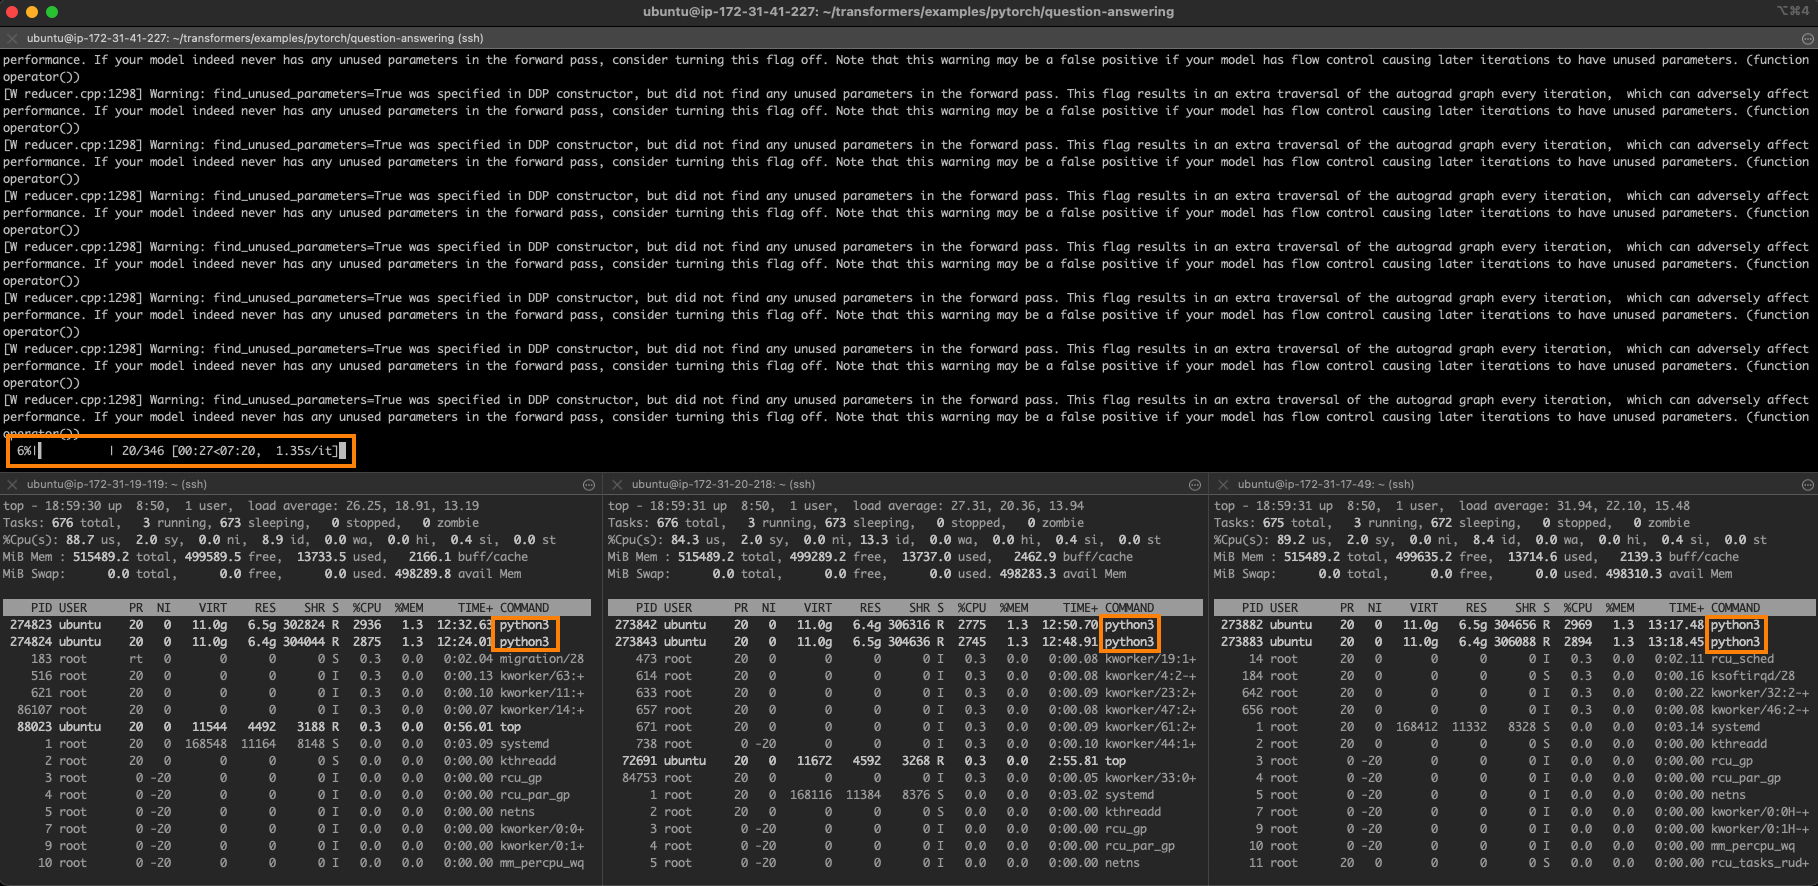
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო
საფრანგეთი: ხელოვნური ინტელექტი სკოლების ეკოლოგიური განახლებისთვის მონაცემთა სუვერენიტეტის დაცვით
Banque des Territoires-ს, Polyconseil-სა და Hugging Face-ს შორის დაწყებული თანამშრომლობა გენერაციული ხელოვნური ინტელექტის პოტენციალს მონაცემთა სუვერენიტეტის მოთხოვნებთან აერთიანებს. პროექტის პირველი ფაზის დასრულების შემდეგ, შემუშავებული ინსტრუმენტი ოპტიმიზაციას უკეთებს Banque des Territoires-ის EduRénov პროგრამის მხარდაჭერის ჩარჩოს, რომელიც საფრანგეთში 10,000 საჯარო სკოლის დაწესებულების ეკოლოგიურ განახლებას ემსახურება. RAG სისტემაზე დაფუძნებული ეს გადაწყვეტა მონაცემთა უსაფრთხოებასა და სუვერენიტე
AI და მონაცემთა სუვერენიტეტი: საფრანგეთის სკოლების ეკოლოგიური რენოვაციის ინოვაციური პროექტი
Banque des Territoires-ის, Polyconseil-ისა და Hugging Face-ის თანამშრომლობამ შექმნა გენერაციული ხელოვნური ინტელექტის გადაწყვეტა, რომელიც მხარს უჭერს საფრანგეთის EduRénov პროგრამას. ეს პროექტი მიზნად ისახავს 10,000 საჯარო სკოლის ეკოლოგიურ რენოვაციას, მონაცემთა სუვერენიტეტისა და ღია წყაროს ტექნოლოგიების გამოყენებაზე განსაკუთრებული აქცენტით. პირველი ფაზის წარმატებით დასრულების შემდეგ, ინსტრუმენტი განკუთვნილია ადგილობრივ თვითმმართველობებთან ურთიერთობის ოპტიმიზაციისა და ენერგოეფექტურობის მიზნების მის

Hugging Face AI Sheets-ის რევოლუციური განახლება: ხელოვნური ინტელექტით ვიზუალური მონაცემების დამუშავება
Hugging Face-მა გამოაქვეყნა AI Sheets-ის მასშტაბური განახლება, ღია კოდის ინსტრუმენტი, რომელიც ახლა ვიზუალური კონტენტის დამუშავების შესაძლებლობებსაც მოიცავს. მომხმარებლებს შეუძლიათ ატვირთონ სურათები, გამოიყენონ AI მოდელები მათგან ინფორმაციის ამოსაღებად, გასაანალიზებლად, ახლის გენერირებისთვის და რედაქტირებისთვის, რაც მნიშვნელოვნად ამარტივებს მონაცემთა სტრუქტურირებისა და კონტენტის შექმნის პროცესებს. განახლება მოიცავს ათასობით ღია AI მოდელის გამოყენების შესაძლებლობას სხვადასხვა ამოცანისთვის, როგორიც
Google Cloud TPUs-ის ხელმისაწვდომობა Hugging Face-ზე: განცხადება და შემდგომი შეჩერება
Google Cloud TPUs-ის Hugging Face-ის Inference Endpoints-სა და Spaces-ზე ხელმისაწვდომობის შესახებ გაკეთდა განცხადება, რაც ხელოვნური ინტელექტის აპლიკაციების დაჩქარებას გვპირდებოდა. თუმცა, ამ ფუნქციის დანერგვიდან მალევე, ის დროებით შეჩერდა. ეს ინტეგრაცია მიზნად ისახავდა Google-ის ხელოვნური ინტელექტის აპარატურის, რომელიც ცნობილია თავისი მაღალი წარმადობითა და ეკონომიურობით, Hugging Face-ის მომხმარებლებისთვის მიწოდებას, მაგრამ ამჟამად მიუწვდომელია.

Sentence Transformers Hugging Face-ის ოჯახს უერთდება
Sentence Transformers (SBERT), სემანტიკური მნიშვნელობის მქონე მაღალი ხარისხის ემბედინგების გენერირების პოპულარული ღია კოდის ბიბლიოთეკა, ოფიციალურად შეუერთდა Hugging Face-ის ოჯახს. 2019 წელს ნილს რაიმერსის მიერ დაარსებული პროექტი ფართოდ გამოიყენება ბუნებრივი ენის დამუშავების (NLP) ამოცანებში და უკვე 16,000-ზე მეტ მოდელს მოიცავს, რომლებიც ყოველთვიურად მილიონობით მომხმარებელს ემსახურება. Hugging Face პირობას დებს, რომ გააგრძელებს პროექტის ზრდისა და ინოვაციების მხარდაჭერას, ამავდროულად შეინარჩუნებს
Hugging Face-ი ხელოვნურ ინტელექტში პერსონალური მონაცემების დაცვას აძლიერებს: Presidio-ს ინტეგრაცია Dataset Hub-ში
Hugging Face-მა Dataset Hub-ზე ახალი ფუნქცია დანერგა, რომელიც Presidio-ს, ღია კოდის PII (პერსონალური საიდენტიფიკაციო ინფორმაციის) გამოვლენის ინსტრუმენტს იყენებს. ეს ფუნქცია მომხმარებლებს საშუალებას აძლევს, შეაფასონ PII-ის არსებობა მონაცემთა ნაკრებებში, რაც ეხმარება მათ მიიღონ ინფორმირებული გადაწყვეტილებები, თავიდან აიცილონ მიკერძოებული პროგნოზები და შექმნან უფრო ეთიკური ML მოდელები. ინიციატივა მიზნად ისახავს PII-ის გამოწვევების მოგვარებას მანქანურ სწავლებაში.

Hugging Face Hub-ი 2.2 მილიონ მოდელსა და მონაცემთა ნაკრებს VirusTotal-ის სკანერით დაიცავს
ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების უმსხვილესმა ღია პლატფორმამ, Hugging Face Hub-მა, დაიწყო 2.2 მილიონზე მეტი საჯარო რეპოზიტორიის უწყვეტი სკანირება VirusTotal-ის მეშვეობით. ეს ნაბიჯი მიზნად ისახავს AI მოდელებში არსებული ფარული რისკების, როგორიცაა მავნე ბინარული ფაილები და დამოკიდებულებები, გამოვლენასა და პრევენციას, რითაც უზრუნველყოფილია მომხმარებლებისთვის უსაფრთხო გარემო. ინტეგრაცია დამატებით დაცვასა და ხილვადობას უზრუნველყოფს მსოფლიოს ერთ-ერთი უმსხვილესი მავნე პროგრამების ს
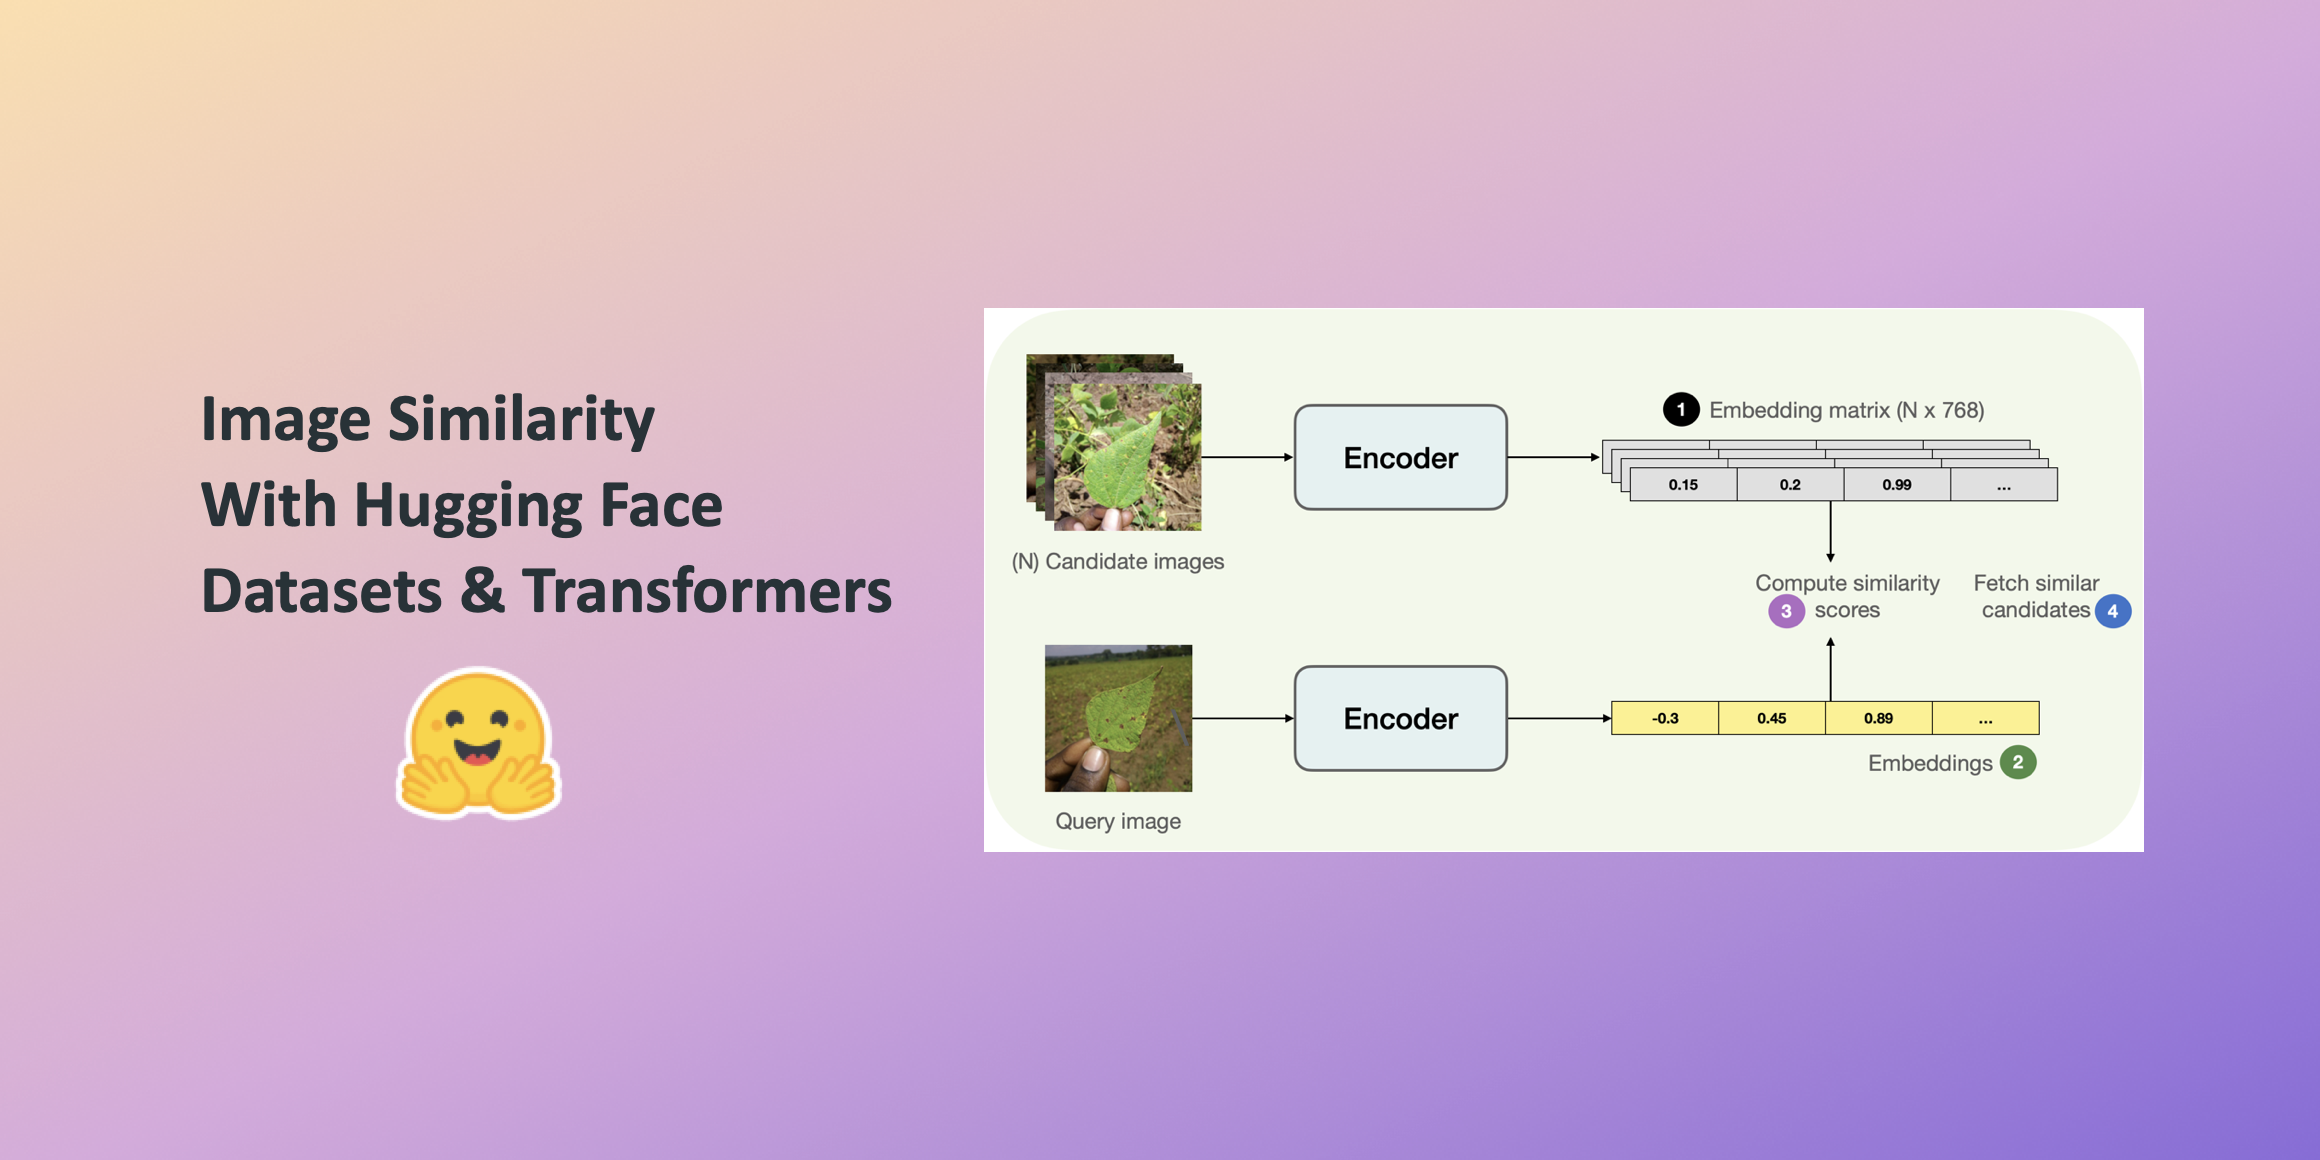
როგორ ავაშენოთ გამოსახულების მსგავსების სისტემა: ღრმა სწავლისა და ეფექტური ძიების გზები
ეს სტატია დეტალურად აღწერს გამოსახულების მსგავსების სისტემის აგების პროცესს, რომელიც ეფუძნება ღრმა სწავლებას და ემბედინგების გამოყენებას. განხილულია გამოსახულებების ვექტორულ სივრცეში წარმოდგენა, კოსინუსური მსგავსების გამოთვლა, Hugging Face-ის `datasets` ბიბლიოთეკისა და `AutoModel` კლასის გამოყენება. ასევე, მოცემულია რჩევები მოდელის შერჩევისა და სისტემის ეფექტურობის გაუმჯობესების შესახებ, მათ შორის განზომილების შემცირებისა და FAISS ინტეგრაციის შესაძლებლობები.

KerasHub-ისა და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი ხდება 300 ათასზე მეტი AI მოდელი
KerasHub-მა და Hugging Face-მა მნიშვნელოვანი ნაბიჯი გადადგეს წინ, წარმოადგინეს მოდელების შენახვის საერთო ფორმატი, რომელიც KerasHub-ის მომხმარებლებს საშუალებას აძლევს პირდაპირ გამოიყენონ Transformers ბიბლიოთეკის 300 ათასზე მეტი მოდელი Hugging Face Hub-იდან. ეს ინტეგრაცია მნიშვნელოვნად აფართოებს მოდელების არჩევანსა და შესაძლებლობებს, მხარს უჭერს TensorFlow, JAX და PyTorch უკანა სისტემებს, რაც ამარტივებს AI მოდელების განთავსებას და კვლევას. თავდაპირველად ფოკუსირებულია Gemma (1 და 2), Llama 3 და Pal

Meta-PyTorch და Hugging Face OpenEnv ჰაბს უშვებენ აგენტური გარემოებებისთვის
Meta-PyTorch და Hugging Face პარტნიორობენ OpenEnv ჰაბის გასაშვებად, საერთო პლატფორმისთვის, სადაც დეველოპერებს შეუძლიათ შექმნან, გააზიარონ და გამოიკვლიონ OpenEnv-თან თავსებადი გარემოებები ხელოვნური ინტელექტის აგენტების ტრენინგისა და განლაგებისთვის. ეს ინიციატივა მიზნად ისახავს აგენტური განვითარების სტანდარტიზაციას, უსაფრთხოებას და კონტროლს, მკაფიო, იზოლირებული „ქვიშის ყუთის“ (sandbox) გარემოებების შეთავაზებით.