პერსონალიზებული AI მოდელები LLM-ების დახმარებით: დაზოგეთ ხარჯები და გაზარდეთ ეფექტურობა
სტატია განიხილავს პერსონალიზებული ხელოვნური ინტელექტის (AI) მოდელების დახვეწასა და LLM API-ების გამოყენებას შორის არსებულ დილემას, შემდეგ კი წარმოადგენს ინოვაციურ ჰიბრიდულ მიდგომას. ეს მეთოდი იყენებს ღია კოდის LLM-ებს მაღალი ხარისხის სინთეზური მონაცემების გენერირებისთვის, რათა მოამზადოს სპეციალიზებული მოდელები. შემთხვევის შესწავლა აჩვენებს ხარჯების, ენერგიის მოხმარების და დაყოვნების დროის მნიშვნელოვან გაუმჯობესებას GPT-4-ის მსგავს დიდ LLM API-ებთან შედარებით, პარალელურად ინარჩუნებს მსგავს ეფექტუ
მოდელების შერწყმა: LoRA ადაპტერების გაერთიანების ახალი მიდგომები PEFT-ში
ამ პოსტში წარმოდგენილია 🤗 PEFT-ის ფარგლებში შემუშავებული LoRA ადაპტერების შერწყმის ახალი, ოპტიმიზებული მეთოდები. განხილულია სტანდარტული მოდელების გაერთიანების მიდგომები, მეხსიერების ინტენსივობის გამოწვევები და შემოთავაზებულია სხვადასხვა ტექნიკა, მათ შორის კონკატენაცია, მატრიცების შეწონილი ჯამი და დავალების არითმეტიკა (Task Arithmetic). სტატია მოიცავს კოდის მაგალითებს, შთამბეჭდავ შედეგებსა და სამომავლო გეგმებს.

AI-ის ძალა მუსიკალურ შემოქმედებაში: Arm-ის პროცესორებით სტუდიური ხმის გენერაცია პირდაპირ მოწყობილობაზე
პროგრამისტმა და მუსიკალურმა პროდიუსერმა შექმნა ინოვაციური აპლიკაცია, რომელიც Arm-ზე დაფუძნებული CPU-სა და ღია კოდის AI მოდელების გამოყენებით, პირდაპირ მოწყობილობაზე გენერირებს სტუდიური ხარისხის ჟღერადობას. ეს ინსტრუმენტი უზრუნველყოფს სწრაფ, პირად და შეუფერხებელ სამუშაო პროცესს მუსიკალური პროდიუსერებისთვის, რაც მათ საშუალებას აძლევს, წამებში შექმნან უნიკალური ხმები მარტივი მოთხოვნებით, ყოველგვარი ღრუბლოვანი სერვისების ან GPU-ს საჭიროების გარეშე. პროექტი გვიჩვენებს კონტენტის შექმნის მომავალს მოწყო
Open Ko-LLM ლიდერბორდი: კორეული ხელოვნური ინტელექტის განვითარების ახალი ეტაპი
Upstage-მა 2023 წლის სექტემბერში Open Ko-LLM ლიდერბორდი წარადგინა, რომლის მიზანიც კორეული დიდი ენობრივი მოდელების (LLM) შეფასების ეკოსისტემის შექმნა და გამჭვირვალობის ხელშეწყობა იყო. პლატფორმა, რომელიც კორეული ენის უნიკალურ მახასიათებლებს ითვალისწინებს, მოკლე დროში დიდი პოპულარობით სარგებლობს, 5 თვეში 1000-ზე მეტი მოდელის წარდგენით. მიუხედავად ინფრასტრუქტურული გამოწვევებისა, ლიდერბორდი აქტიურად ვითარდება, რათა რეალურ სამყაროში გამოყენების შემთხვევებს უკეთ მოერგოს და კორეული AI-ის განვითარებას ხე

KV ქეშირება nanoVLM-ში: 38%-იანი აჩქარება გენერაციაში
ეს ბლოგ-პოსტი აღწერს KV ქეშირების ტექნიკას, რომელიც nanoVLM საცავში ნულიდან დავნერგეთ და რომელმაც ენობრივი მოდელების გენერაციაში 38%-იანი აჩქარება მოგვცა. სტატია განმარტავს ავტორეგრესიულ მოდელებში გამოთვლითი სიჭარბის პრობლემას და იმას, თუ როგორ აგვარებს მას KV ქეშირება Q, K, V მნიშვნელობების შენახვით. მოცემულია თეორიული საფუძვლები, nanoVLM-ში პრაქტიკული იმპლემენტაცია და ზოგადი გაკვეთილები, რომლებიც ყველა ავტორეგრესიული ენობრივი მოდელის გენერაციას ეხება. ეს ოპტიმიზაცია აუცილებელია LLM-ების ეფექტუ
Google-მა Gemma, უახლესი ღია LLM-ების ოჯახი გამოუშვა
Google-მა დღეს გამოუშვა Gemma, ხელოვნური ინტელექტის (AI) უახლესი ღია ენის მოდელების (LLM) ოჯახი, რაც აძლიერებს კომპანიის ერთგულებას ღია კოდის AI მიმართ. Gemma ხელმისაწვდომია ორი ზომის (7B და 2B პარამეტრი) და ორი ვარიანტის (ძირითადი და ინსტრუქციებზე მორგებული) სახით. ის შექმნილია ეფექტური გამოყენებისთვის სხვადასხვა მოწყობილობაზე, მათ შორის სამომხმარებლო GPU-ებზე, CPU-ებზე და ჩაშენებულ სისტემებზე. Hugging Face-თან თანამშრომლობით უზრუნველყოფილია სრული ინტეგრაცია და ყველა ვარიანტი ხელმისაწვდომია Hug
TAPEX: რევოლუციური მიდგომა ცხრილის წინასწარი ვარჯიშისთვის ნერვული SQL შემსრულებლის მეშვეობით
ნაშრომში „TAPEX: ცხრილის წინასწარი ვარჯიში ნერვული SQL შემსრულებლის სწავლით“ წარმოდგენილია ინოვაციური მეთოდი, რომელიც იყენებს სინთეზურ მონაცემებს და ნერვულ SQL შემსრულებელს ცხრილების წინასწარი ვარჯიშისთვის. ეს მიდგომა უზრუნველყოფს პროგრამების მრავალფეროვნებასა და მასშტაბს, რაც გაუვალია ბუნებრივი ენის მოდელებისთვის. TAPEX-მა აჩვენა რეკორდული შედეგები სხვადასხვა ამოცანებზე, მათ შორის ცხრილის კითხვებზე პასუხის გაცემასა და ფაქტების გადამოწმებაზე, რითაც მნიშვნელოვნად აჯობა წინა მეთოდებს და მიაღწია 50
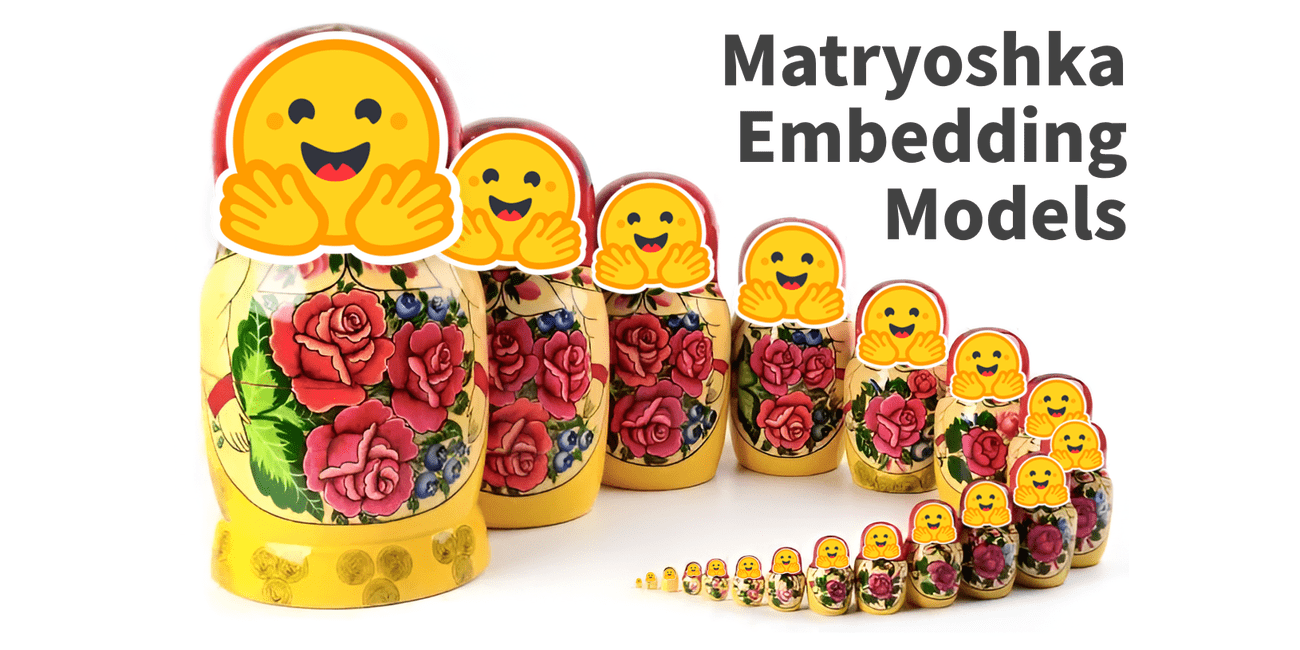
მატრიოშკა Embeddings-ის მოდელები: მოქნილობა და ეფექტურობა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს მატრიოშკა Embeddings-ის მოდელებს, რომლებიც გვთავაზობენ მოქნილობასა და ეფექტურობას ბუნებრივი ენის დამუშავებასა და ხელოვნურ ინტელექტში. განმარტებულია მათი მუშაობის პრინციპი, რომელიც რუსული მატრიოშკის თოჯინების მსგავსად, საშუალებას იძლევა, Embeddings-ის ზომა შემცირდეს ინფორმაციის მნიშვნელოვანი დაკარგვის გარეშე. სტატია ასევე მოიცავს პრაქტიკულ რჩევებს მათი გამოყენებისა და ტრენინგის მეთოდებზე, მათ შორის Sentence Transformers-ის ფარგლებში, ხაზს უსვამს მათ უპირატესობებს ტრადიციულ Em

Hugging Face და NVIDIA AI კვლევისთვის GPU რესურსებს ხელმისაწვდომს ხდიან „ტრენინგ კლასტერი როგორც სერვისი“ (TCaaS) მეშვეობით
Hugging Face და NVIDIA აცხადებენ თანამშრომლობის შესახებ და წარმოადგენენ „ტრენინგ კლასტერი როგორც სერვისი“ (TCaaS) ინიციატივას. ეს პლატფორმა მიზნად ისახავს AI-ის მკვლევრებისთვის და ორგანიზაციებისთვის GPU კლასტერებზე ხელმისაწვდომობის გაფართოებას, რათა მათ შეძლონ ხელოვნური ინტელექტის მოდელების ეფექტურად მომზადება. სერვისი გთავაზობთ მოქნილ გადახდის მოდელს, რაც რესურსების მოთხოვნისამებრ გამოყენების საშუალებას იძლევა და ამცირებს „გამოთვლითი რესურსების ხარვეზს“.
Haize Labs-ი Hugging Face-ის მხარდაჭერით LLM-ების „წითელი გუნდის“ წინააღმდეგობის ახალ ბენჩმარკს წარადგენს
ხელოვნური ინტელექტის (AI) სფეროში, დიდი ენობრივი მოდელების (LLM) უსაფრთხოებასა და არასასურველ ქცევებთან დაკავშირებით მზარდი შეშფოთებაა. ამ გამოწვევის საპასუხოდ, Haize Labs-მა, Hugging Face-ის გუნდის მხარდაჭერით, შექმნა „Red Teaming Resistance Benchmark“ – ახალი საორიენტაციო სისტემა. ის მიზნად ისახავს უახლესი LLM მოდელების მდგრადობის შემოწმებას ადამიანის მიერ შემუშავებული, დახვეწილი „წითელი გუნდის“ (red teaming) შეტევების გამოყენებით, რათა გამოავლინოს მათი სისუსტეები და მოწყვლადობები. ბენჩმარკი ფ
Haize Labs-მა და Hugging Face-მა დიდი ენობრივი მოდელების უსაფრთხოების ახალი ეტალონი, „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ წარადგინეს
დიდი ენობრივი მოდელების (დემ) კვლევის სწრაფი ტემპის ფონზე, Haize Labs-მა, Hugging Face-ის გულუხვი მხარდაჭერით, გამოაქვეყნა „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ (Red Teaming Resistance Benchmark). ეს ახალი ეტალონი მიზნად ისახავს მოწინავე დემ-ების მოწყვლადობების საფუძვლიან შემოწმებას ადამიანის მიერ შექმნილი, ბუნებრივი ენის მსგავსი მავნე მოთხოვნების (prompts) გამოყენებით, განსხვავებით ხელოვნური, ავტომატიზებული შეტევებისგან. ბენჩმარკი აფასებს მოდელების მდგრადობას არასასურველი ქცევების მიმართ, რო
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.
Hugging Face: Gemma მოდელების PEFT-ით ოპტიმიზაცია
ამ პოსტში განხილულია, თუ როგორ შეიძლება Gemma მოდელების პარამეტრულად ეფექტური წვრილმანი მორგება (PEFT) Hugging Face Transformers-ისა და PEFT ბიბლიოთეკების გამოყენებით GPU-ებსა და Cloud TPU-ებზე. ეს ტექნიკა განსაკუთრებით გამოსადეგია მეხსიერებისა და გამოთვლითი რესურსების დაზოგვისთვის, რაც საშუალებას აძლევს მომხმარებლებს, მათ შორის მათ, ვინც Colab-სა და Kaggle-ზე მუშაობს, ოპტიმიზაცია გაუკეთონ მოდელებს საკუთარ მონაცემთა ნაკრებებზე დაბალი დანახარჯით. სტატია დეტალურად განიხილავს LoRA-სა და QLoRA-ს გამ

Featherless AI Hugging Face Hub-ის მხარდაჭერილი ინფერენს პროვაიდერი გახდა
Featherless AI უერთდება Hugging Face Hub-ის მზარდ ეკოსისტემას, აფართოებს სერვერული ინფერენციის შესაძლებლობებს და მომხმარებლებს სთავაზობს მოდელების შეუდარებელ მრავალფეროვნებას ხელმისაწვდომ ფასად. ის მხარს უჭერს უახლეს ღია კოდის მოდელებს DeepSeek-დან, Meta-დან, Google-დან და Qwen-დან, რაც აერთიანებს მოდელების დიდ არჩევანს სერვერულ ფასებთან.

Hugging Face-ის Kernel Hub: ხელოვნური ინტელექტის მოდელების მუშაობის დაჩქარება ოპტიმიზებული ბირთვებით
Hugging Face-ის ახალი Kernel Hub რევოლუციას ახდენს მანქანური სწავლების მოდელების ოპტიმიზაციაში. ის უზრუნველყოფს ცენტრალიზებულ საცავს წინასწარ კომპილირებული, მაღალეფექტური გამოთვლითი ბირთვებისთვის, რაც დეველოპერებს საშუალებას აძლევს, მარტივად ჩართონ ოპტიმიზებული კოდი სწრაფი ოპერაციებისთვის, განსაკუთრებით GPU-ებზე, რთული კომპილაციის პროცესების გარეშე. ეს დრამატულად ამარტივებს მაღალი წარმადობის მიღწევას ML პროექტებში, რაც დეველოპერებს საშუალებას აძლევს, მეტი დრო დაუთმონ მოდელების აგებას და ნაკლები
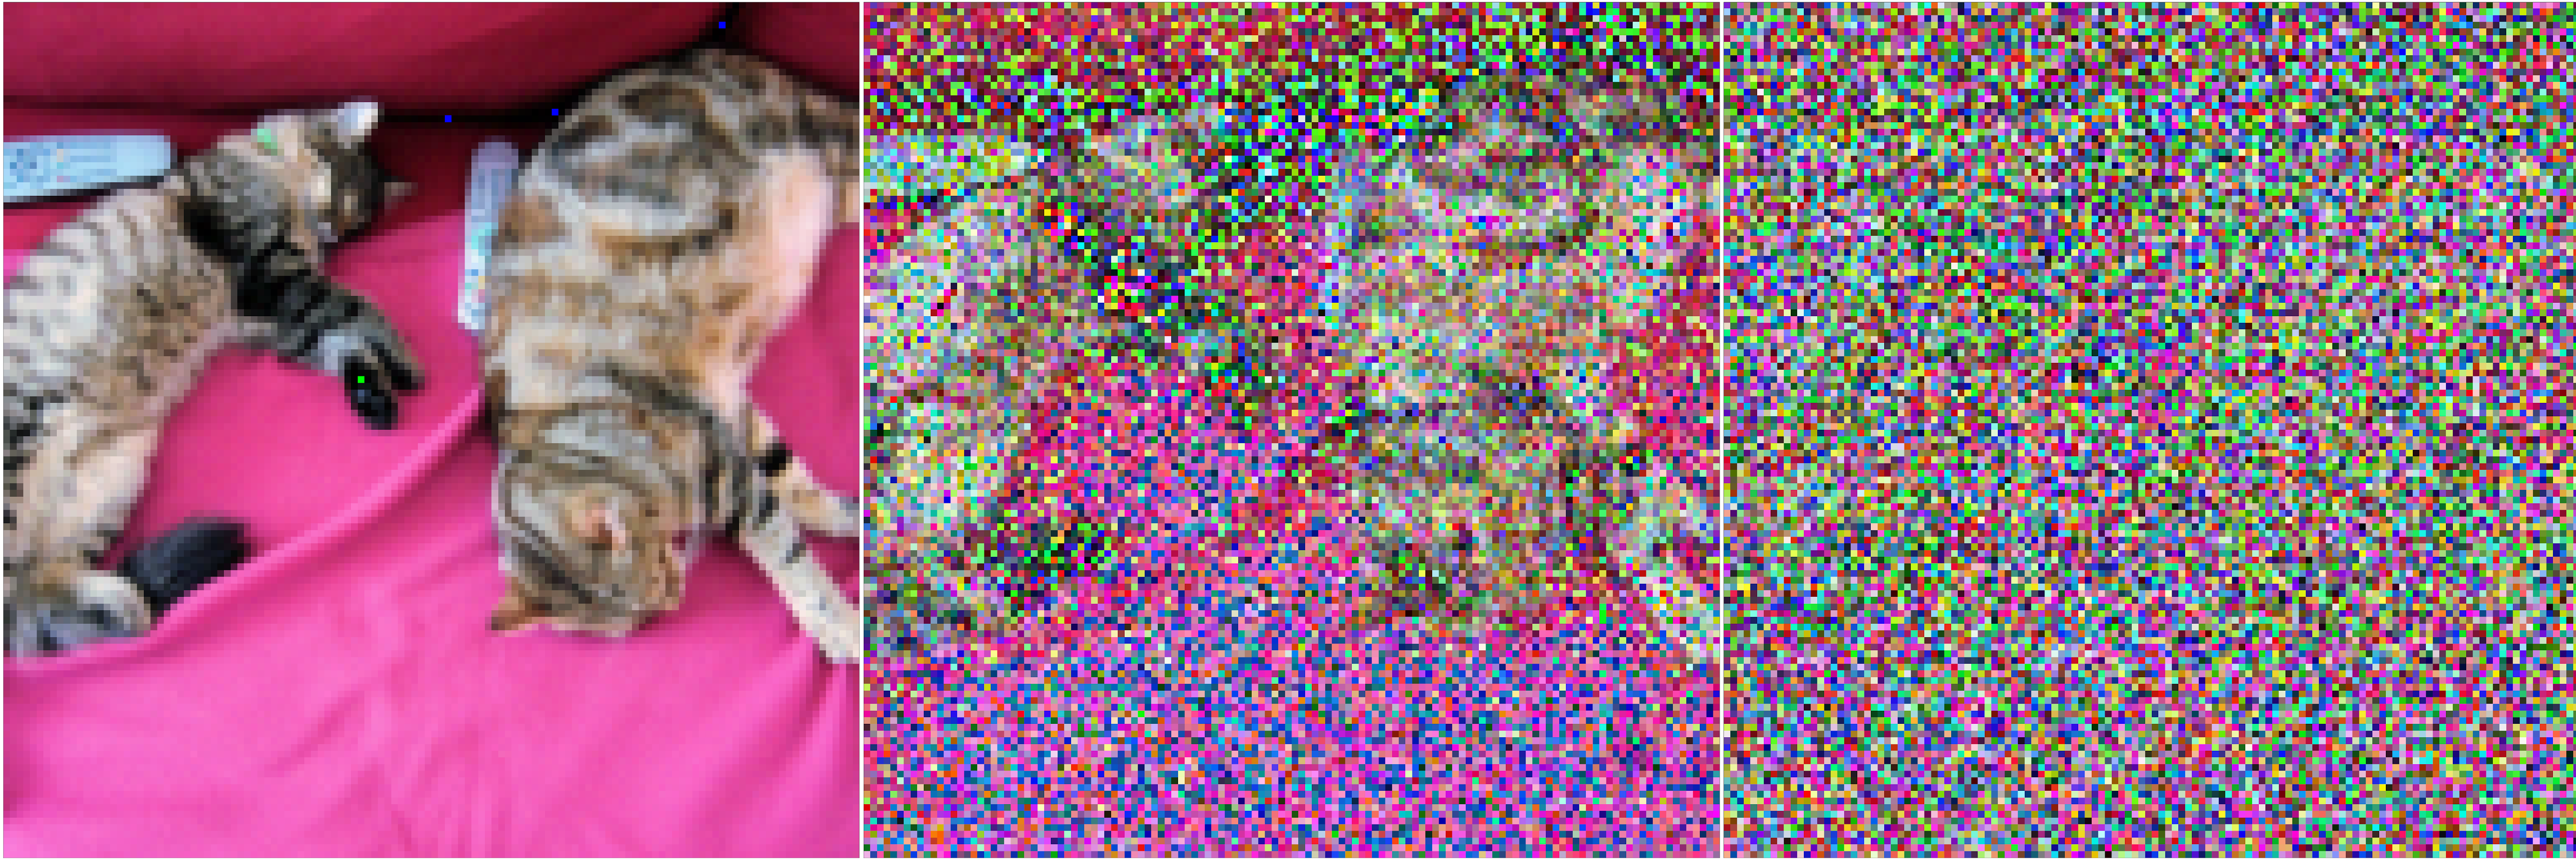
დენოიზინგ დიფუზიური ალბათური მოდელები (DDPM): კონცეფციიდან იმპლემენტაციამდე PyTorch-ში
ეს სტატია განიხილავს Ho et al.-ის (2020) ორიგინალური ნაშრომის მიხედვით დენოიზინგ დიფუზიურ ალბათურ მოდელებს (DDPM) და მათ ნაბიჯ-ნაბიჯ იმპლემენტაციას PyTorch-ში. იგი აშუქებს დიფუზიური მოდელების ისტორიულ კონტექსტს, მათ მათემატიკურ საფუძვლებს და ხსნის როგორც პირდაპირ, ასევე შებრუნებულ პროცესებს, რომლებიც საშუალებას აძლევს ნერვულ ქსელს გარდაქმნას ხმაურიანი მონაცემები რეალურ ნიმუშებად.
TTS Arena: მეტყველების სინთეზის მოდელების შეფასების დემოკრატიზაცია
მეტყველების სინთეზის სფეროში დიდი ხანია არ არსებობდა მოდელების ხარისხის ზუსტი გაზომვის მეთოდი. არსებული ობიექტური და სუბიექტური მეთოდები არაეფექტურია მსგავსი ხარისხის მოდელების შესადარებლად. ამ გამოწვევის საპასუხოდ, შეიქმნა TTS Arena, სადაც საზოგადოებას შეუძლია შეაფასოს სინთეზირებული აუდიო და დაეხმაროს მოდელების რანჟირების დემოკრატიზაციას. პლატფორმა იყენებს ადამიანის შეფასებას, მსგავსად Chatbot Arena-ისა, მოდელების ობიექტური შედარებისთვის.

vLLM-ის ოპტიმიზაცია: პრეფილისა და დეკოდირების გამოწვევების დაძლევა
ეს სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაციის გამოწვევებს vLLM-ში, განსაკუთრებით "პრეფილის" ფაზაში, სადაც გრძელ პრომპტებს შეუძლიათ შეაფერხონ მომდევნო მოთხოვნები. იგი აღწერს გაუმჯობესებულ სტრატეგიას, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას, ხოლო გრძელი მოთხოვნებისთვის თანმიმდევრულ დამუშავებას ინარჩუნებს. ასევე წარმოდგენილია "დეზაგრეგირებული პრეფილი" – უფრო რადიკალური გადაწყვეტა ტოკენის გენერაციის შენელების აღმოსაფხვრელად, თუმცა რესურსების უფრო
მანქანური სწავლება ფინანსურ სექტორში: გამოწვევები, ნდობა და ინოვაციების როლი
სტატია განიხილავს მანქანური სწავლების (ML) დირექტორების უნიკალურ გამოწვევებს ფინანსურ სექტორში, მათ შორის მოძველებული სისტემების მართვას, მოდელების ინტერპრეტაციას და მომხმარებელთა ნდობის შენარჩუნებას მკაცრი რეგულაციების პირობებში. ხაზგასმულია, თუ როგორ გამოიწვია ML-მა დისკუსიები ფინანსურ გადაწყვეტილებებში ნდობის შესახებ და გახდა გარდამტეხი ძალა, რამაც ახალი ბიზნეს შესაძლებლობები შექმნა. წამყვანი ფინანსური ინსტიტუტების ექსპერტები იზიარებენ თავიანთ შეხედულებებს ამ გამოწვევებზე, განსაკუთრებით მოძვე
მანქანური სწავლება ფინანსებში: გამოწვევები, ნდობა და ექსპერტების შეხედულებები
ფინანსური სექტორის მანქანური სწავლების დირექტორები უნიკალური გამოწვევების წინაშე დგანან, მათ შორის მოძველებული სისტემების მართვა, ინტერპრეტირებადი მოდელების დანერგვა და მომხმარებლის ნდობის შენარჩუნება მკაცრი რეგულაციების პირობებში. ეს სტატია წარმოადგენს წამყვანი ექსპერტების შეხედულებებს U.S. Bank-დან, კანადის სამეფო ბანკიდან, Moody's Analytics-დან და Bloomberg AI-დან. ისინი განიხილავენ მანქანური სწავლების ტრანსფორმაციულ ძალას, ფინანსურ გადაწყვეტილებებში ნდობის შესახებ მიმდინარე დისკუსიას და იმ ს
წარმოგიდგენთ StarCoder2-ს: ინოვაცია პროგრამირების ენობრივ მოდელებში
StarCoder2 არის ღია კოდის დიდი ენობრივი მოდელების (LLM) ოჯახი, შექმნილი კოდის გენერაციისა და ანალიზისთვის. ის ხელმისაწვდომია სამი ზომის ვარიანტში – 3B, 7B და 15B პარამეტრით. ფლაგმანი StarCoder2-15B მოდელი გაწვრთნილია 4 ტრილიონზე მეტ ტოკენსა და 600-ზე მეტ პროგრამირების ენაზე The Stack v2 მონაცემთა ბაზიდან, რაც მას თავის ზომის კლასში საუკეთესოდ აქცევს და კონკურენციას უწევს 33B+ ზომის მოდელებს. პროექტი არის BigCode-ის თანამშრომლობის ნაწილი, რომელიც მიზნად ისახავს კოდისთვის განკუთვნილი LLM-ების პასუ
Intel-ი Hugging Face-ის აპარატურის პარტნიორთა პროგრამას უერთდება ტრანსფორმერების მოდელების ოპტიმიზაციისთვის
Hugging Face-ის მისიაა მანქანური სწავლების დემოკრატიზაცია და მისი დადებითი გავლენის მაქსიმიზაცია. ამ მიზნით, Intel-ი ოფიციალურად შეუერთდა Hugging Face-ის აპარატურის პარტნიორთა პროგრამას. Optimum-ის ღია კოდის ბიბლიოთეკის წყალობით, Intel-ი და Hugging Face-ი ითანამშრომლებენ უახლესი აპარატურული აჩქარების შესაქმნელად ტრანსფორმერების მოდელების წვრთნის, დაზუსტებისა და პროგნოზირებისთვის. ეს პარტნიორობა მიზნად ისახავს დიდი და კომპლექსური ტრანსფორმერების მოდელების გამოწვევების გადაჭრას, განსაკუთრებით შეყო

დიფუზიური მოდელების ეფექტური წვრილი დარეგულირება QLoRA-ით: 10 GB VRAM-ზე ნაკლები მოხმარება
წინა პოსტში კვანტიზაციის ტექნიკების განხილვის შემდეგ, ეს პოსტი ყურადღებას ამახვილებს დიფუზიური მოდელების, კერძოდ FLUX.1-dev-ის, ეფექტურ წვრილ დარეგულირებაზე (fine-tuning) QLoRA მეთოდის გამოყენებით. მიზანია, მივაღწიოთ 10 GB-ზე ნაკლებ VRAM მოხმარებას ერთ GPU-ზე, რაც ხელმისაწვდომს გახდის ამ პროცესს სამომხმარებლო აპარატურაზე. განიხილება ისეთი ტექნიკები, როგორიცაა 8-ბიტიანი AdamW ოპტიმიზატორი, გრადიენტის შემოწმება (gradient checkpointing) და ლატენტების ქეშირება (cache latents), რათა FLUX.1-dev-მა ალფ
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.