ტექსტიდან გამოსახულების გენერირების ხელოვნური ინტელექტის მოდელების მიკერძოება: გამოწვევები და გადაწყვეტის გზები
ეს სტატია ღრმად იკვლევს ტექსტიდან გამოსახულების გენერირების (TTI) ხელოვნური ინტელექტის მოდელებში არსებული მიკერძოების კომპლექსურ პრობლემას. განხილულია მიკერძოების მრავალფეროვანი წყაროები, მათ შორის საწვრთნელ მონაცემებში, წინასწარ გაფილტვრაში, მოდელების ლატენტურ სივრცესა და დასკვნის ეტაპზე. სტატია ხაზს უსვამს, თუ როგორ იწვევს სოციალურ ღირებულებებსა და კულტურულ სტერეოტიპებზე დაფუძნებული მიკერძოება არარეპრეზენტაციულ და პოტენციურად მავნე გამოსახულებებს, რაც მუდმივ ეთიკურ გამოწვევას წარმოადგენს ხელოვ

ლოგიტების დამუშავება: უპრეცედენტო კონტროლი AI ტექსტის გენერაციაზე NVIDIA-ს LogitsProcessorZoo-ს მეშვეობით
სტატია განიხილავს ლოგიტების დამუშავებას, მეთოდს, რომელიც საშუალებას გვაძლევს დეტალური კონტროლი მოვახდინოთ ხელოვნური ინტელექტის მიერ ტექსტის გენერაციის პროცესზე, პროგნოზირების ქულების მოდიფიკაციის გზით. ხაზგასმულია Hugging Face-ის LogitsProcessor API და წარმოდგენილია NVIDIA-ს LogitsProcessorZoo – მოდულური პროცესორების კრებული, რომელიც შექმნილია სპეციფიკური ამოცანებისთვის, მაგალითად, თანმიმდევრობის სიგრძის კონტროლისთვის ან საკვანძო ფრაზების დაწესებისთვის. ეს ინოვაცია მნიშვნელოვნად აფართოებს ხელოვნ
ლოგიტების დამუშავება: გაუმჯობესებული კონტროლი AI ტექსტის გენერაციაზე NVIDIA-ს LogitsProcessorZoo-ს მეშვეობით
სტატია განიხილავს ლოგიტების დამუშავებას, მეთოდს, რომელიც საშუალებას გვაძლევს დეტალური კონტროლი მოვიპოვოთ ხელოვნური ინტელექტის მიერ ტექსტის გენერირების პროცესზე ალბათური განაწილების პირდაპირი მოდიფიცირებით. ხაზგასმულია Hugging Face-ის LogitsProcessor API და წარმოდგენილია NVIDIA-ს LogitsProcessorZoo — მოდულური ლოგიტების პროცესორების კოლექცია, რომელიც განკუთვნილია სპეციფიკური ამოცანებისთვის, როგორიცაა თანმიმდევრობის სიგრძის კონტროლი ან საკვანძო ფრაზების დაწესება. სტატია განმარტავს, თუ როგორ აუმჯობე
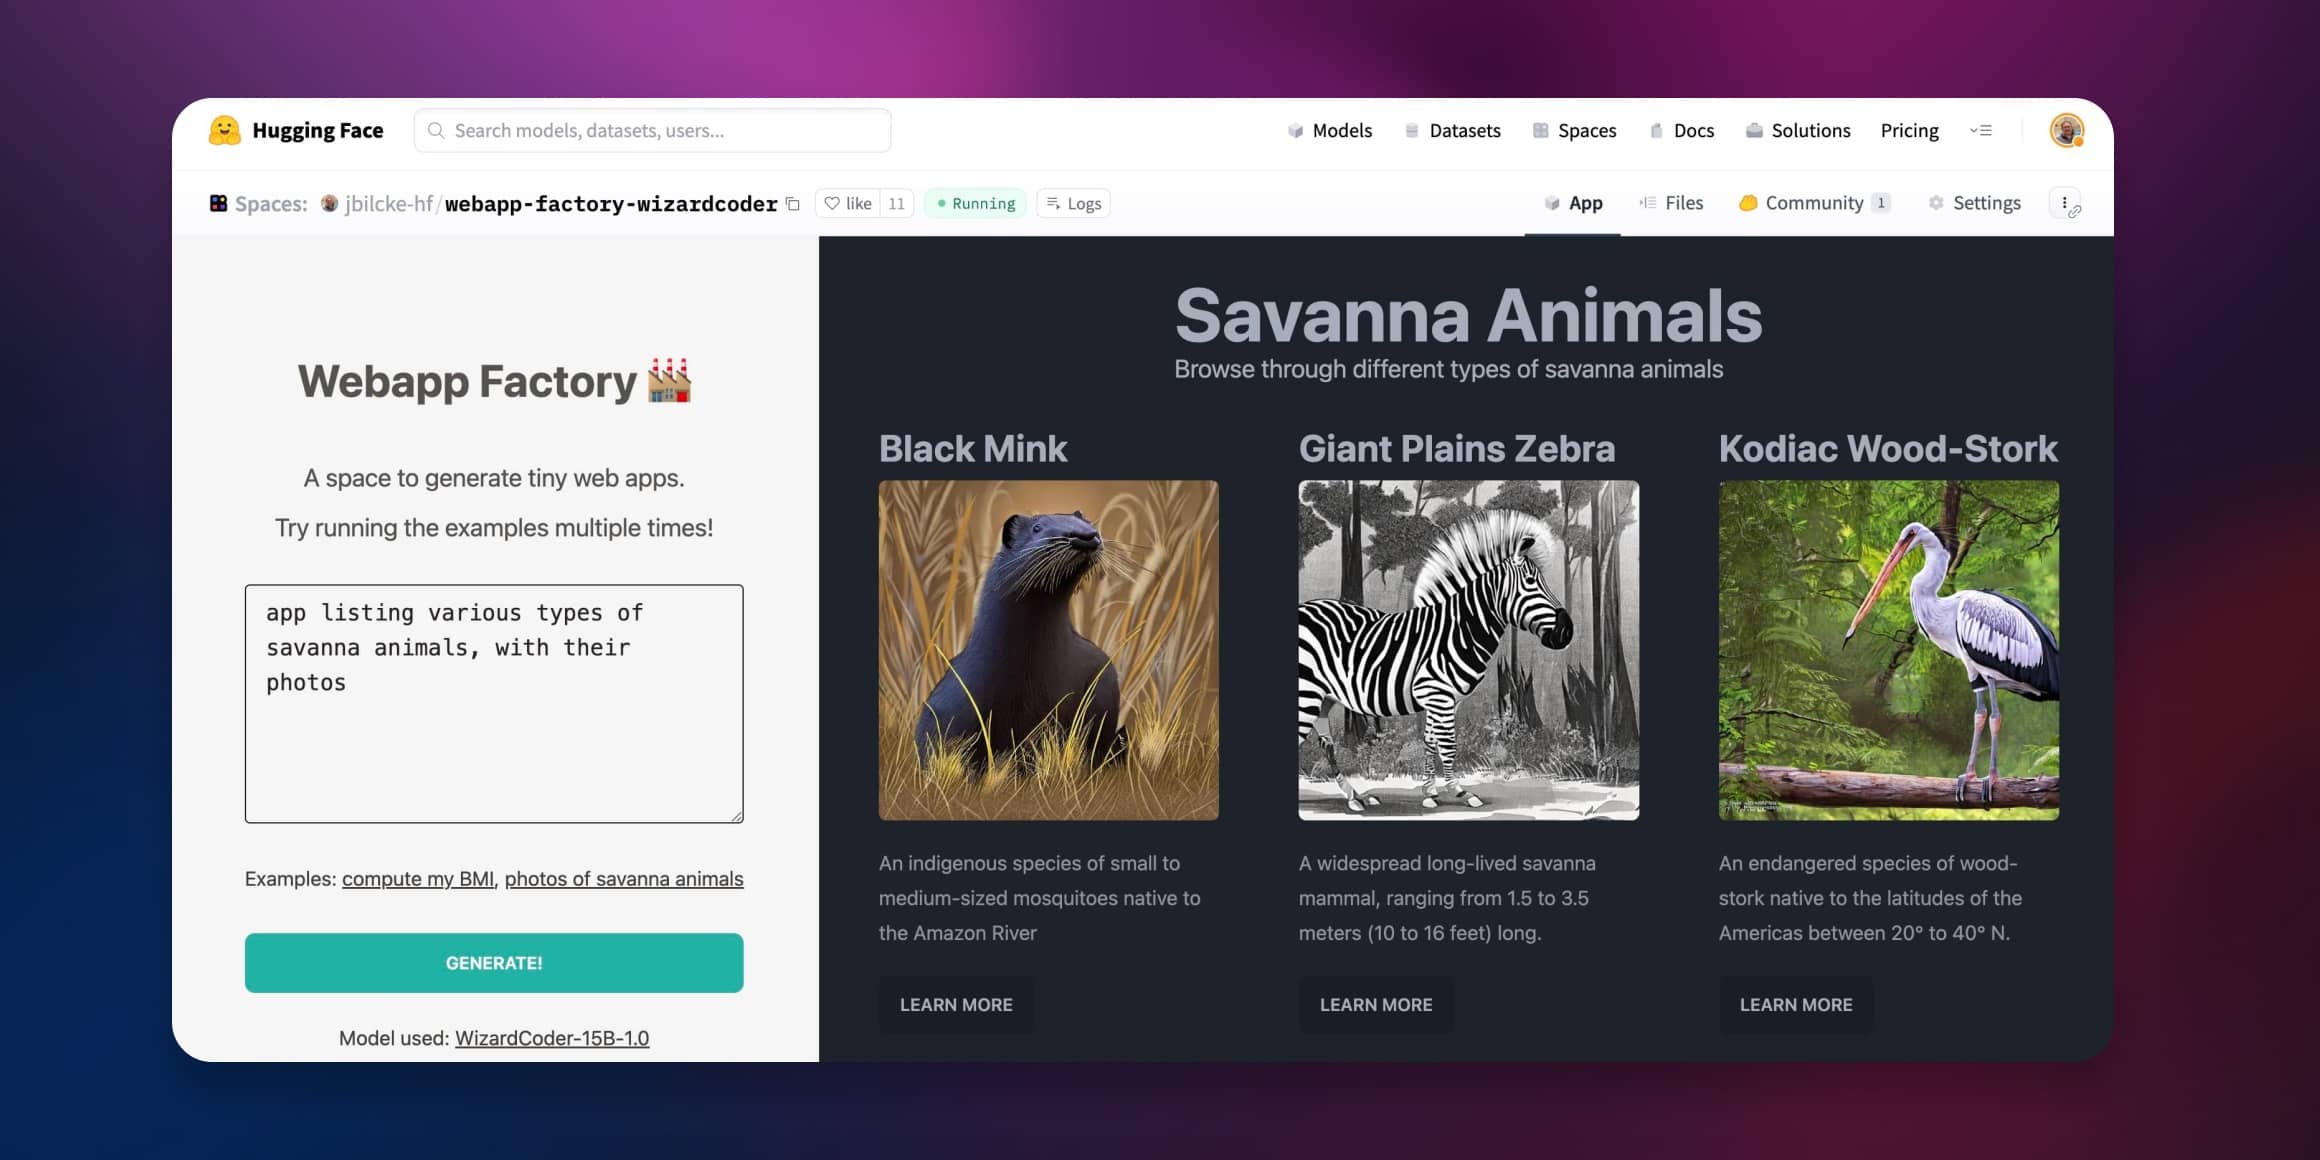
AI ვებ-კონტენტის გენერაცია: Node.js და Hugging Face-ის პირდაპირი მიდგომა
გაეცანით AI ვებ-კონტენტის გენერაციის ინოვაციურ მიდგომას Node.js-ის გამოყენებით, რომელიც უზრუნველყოფს კონტენტის ერთბაშად ნაკადად გადაცემასა და რენდერინგს. ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ დიდი ენობრივი მოდელები (LLM) JavaScript/Node პლატფორმაზე Hugging Face Inference API-ებთან ერთად, აპარატურული აჩქარების, Tailwind CSS-ის, Stable Diffusion-ისა და Alpine.js-ის ინტეგრაციის ჩათვლით.

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერების გამოყენებას PyTorch-ში
ეს სტატია დეტალურად განიხილავს, თუ როგორ უნდა მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია, გაგება და ოპტიმიზაცია PyTorch-ში ტრენინგის დროს. ის ეტაპობრივად ხსნის მეხსიერების განაწილებას მოდელის შექმნის, შეყვანის ტენზორების, Forward/Backward გავლისა და ოპტიმიზატორის ნაბიჯებისთვის, დეტალური მაგალითებისა და პროფაილინგის ხელსაწყოების გამოყენებით. გაანალიზებულია როგორც გამარტივებული, ასევე რეალური LLM-ის ტრენინგის მეხსიერების პროფილი.
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.

AI აგენტები: LLM-ების შესაძლებლობების გაფართოება რეალურ სამყაროში
ეფექტური AI სისტემები საჭიროებს დიდ ენობრივ მოდელებს (LLM) რეალურ სამყაროზე წვდომას, რაც მათ საშუალებას აძლევს გამოიყენონ საძიებო ინსტრუმენტები ან იმოქმედონ პროგრამებზე. ეს მოქმედების უნარი, ანუ „აგენტურობა“, LLM-ებისთვის გარე სამყაროსთან დამაკავშირებელ ხიდად გვევლინება. სტატია განმარტავს, თუ როგორ აკონტროლებს AI აგენტები LLM-ის შედეგების სამუშაო პროცესს და აღნიშნავს, რომ აგენტურობა არის უწყვეტი სპექტრი. მიუხედავად იმისა, რომ აგენტები სასარგებლოა აპლიკაციის სამუშაო პროცესის მოქნილობისთვის, ისინი
როგორ შევქმნათ AI-ზე დაფუძნებული ხატვის თამაში ბრაუზერში: Quick, Draw!-ის შთაგონებით
გაეცანით დეტალურ სახელმძღვანელოს, თუ როგორ უნდა შექმნათ ხელოვნური ინტელექტზე დაფუძნებული ხატვის თამაში, რომელიც Google-ის „Quick, Draw!“-ით არის შთაგონებული. პროექტი გვიჩვენებს, როგორ მივაღწიოთ რეალურ დროში, წამში 60-ზე მეტ პროგნოზს, მოდელის ბრაუზერში გაშვებით, Transformers.js-ის, MobileViT მოდელისა და Web Workers-ის გამოყენებით. სტატია მოიცავს მოდელის მომზადებას, ONNX-ში კონვერტაციას და React აპლიკაციის აგებას.

LLM-ების ინფერენციისას ნახშირბადის ემისიების კვლევა: მოულოდნელი აღმოჩენები საზოგადოების მიერ შექმნილ მოდელებში
ბოლო წლებში დიდი ენობრივი მოდელების (LLM) გამოყენების გარემოზე ზემოქმედებაზე ცნობიერება იზრდება. ეს სტატია იკვლევს LLM-ების ინფერენციის ფაზაში ნახშირბადის ემისიებს, წარმოადგენს Open LLM Leaderboard-ში ემისიის შეფასებების ინტეგრაციას და მოულოდნელ აღმოჩენებს, მაგალითად, რომ საზოგადოების მიერ მორგებული მოდელები (community fine-tunes) ხშირად უფრო ნახშირბადეფექტურია, ვიდრე ოფიციალური მოდელები. განხილულია ემისიების ცვლილებები სხვადასხვა მოდელის ტიპისა და ზომის მიხედვით, რაც მიზნად ისახავს მომხმარებლებ
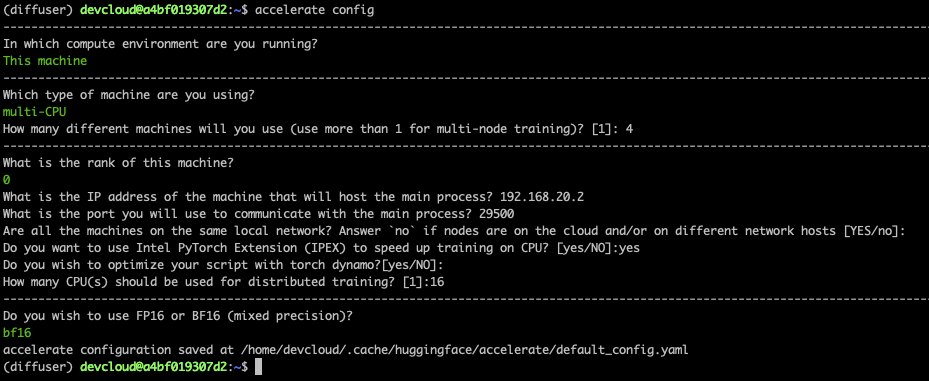
Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ
დიდი ენობრივი მოდელები: ღია წყაროების რევოლუცია ტექსტის გენერაციაში
სტატია მიმოიხილავს ტექსტის გენერაციისა და კონვერსაციული AI ტექნოლოგიების განვითარებას, ადრეული გამოწვევებიდან უახლეს მიღწევებამდე. ხაზგასმულია მომხმარებლისთვის მოსახერხებელი ინტერფეისების, GPT-4-ის მსგავსი მძლავრი მოდელების და Llama 2-ის მსგავსი ღია წყაროების ალტერნატივების მნიშვნელობა. განმარტებულია მიზეზობრივი ენობრივი მოდელები (Causal Language Models) და Text-to-Text მოდელები, ასევე Fine-tuning-ისა და RLHF-ის როლი მათ გაუმჯობესებაში. აღწერილია წამყვანი ღია წყაროების LLM-ები, მათი უპირატესობებ
ხელოვნური ინტელექტის აგენტების აღზევება: სარგებელი, რისკები და მომავლის გზა
დიდი ენობრივი მოდელების (დემ) შესაძლებლობების სწრაფმა განვითარებამ განაპირობა „ხელოვნური ინტელექტის აგენტების“ (ხი აგენტები) გაჩენა – სისტემების, რომლებსაც შეუძლიათ ციფრულ სამყაროში ავტონომიური მოქმედება, მომხმარებლის მიზნების შესაბამისად. სტატია იკვლევს ამ ტექნოლოგიის დაპირებას, მათ შორის ამოცანების კომბინირების, ახალი სიტუაციების ანალიზისა და მიზნების მისაღწევად გაუგებარი ქმედებების განხორციელების უნარს. თუმცა, ყურადღება ექცევა მნიშვნელოვან რისკებსაც, განსაკუთრებით სისტემის ავტონომიის ზრდასთან
ენის გენერაციის დეკოდირების სტრატეგიები: ხარბი და სხივური ძიება
ბოლო წლებში, დიდი ტრანსფორმერზე დაფუძნებული ენობრივი მოდელების (როგორიცაა ChatGPT და LLaMA) აღზევებამ მნიშვნელოვნად გაზარდა ინტერესი ღია ტიპის ენის გენერაციის მიმართ. მოდელის გაუმჯობესებული არქიტექტურისა და მასიური სასწავლო მონაცემების პარალელურად, გადამწყვეტი როლი შეასრულა დეკოდირების უკეთესმა მეთოდებმაც. ეს სტატია წარმოგიდგენთ დეკოდირების ძირითად სტრატეგიებს – ხარბ ძიებას (Greedy search), სხივურ ძიებას (Beam search) და სემპლინგს (Sampling) – და განმარტავს, თუ როგორ ხორციელდება მათი დანერგვა პო
„Reformer“ მოდელი: ტრანსფორმერის ახალი ერა გრძელი თანმიმდევრობების დამუშავებაში
ეს სტატია განიხილავს „Reformer“ მოდელს, რომელიც ქიტაევის, კაიზერის და სხვების (2020) მიერ იქნა წარმოდგენილი, როგორც დღესდღეობით ერთ-ერთი ყველაზე მეხსიერების ეფექტური „ტრანსფორმერის“ მოდელი გრძელი თანმიმდევრობის მოდელირებისთვის. აღწერილია მისი უპირატესობები სტანდარტულ მოდელებთან შედარებით NLP ამოცანებში, როგორიცაა შეჯამება და კითხვა-პასუხი, და განმარტებულია, თუ როგორ შეუძლია მას ერთდროულად ნახევარ მილიონამდე ტოკენის დამუშავება. პოსტი დეტალურად განიხილავს „Reformer“-ის ოთხ ძირითად მახასიათებელს, რ
HfAgent: ხელოვნური ინტელექტის ინტეგრაცია მარტივად და უსაფრთხოდ
HfAgent ბიბლიოთეკა, რომელიც ხელოვნური ინტელექტის შესაძლებლობებს ადვილად აერთიანებს თქვენს პროექტებში, გთავაზობთ მარტივ ინსტალაციასა და გამოყენებას. ის საშუალებას გაძლევთ შეასრულოთ ტექსტური ბრძანებები, წარმოქმნათ და შეაფასოთ კოდი. სტატია ასევე ყურადღებას ამახვილებს უსაფრთხოების რისკებზე თვითნებური კოდის შესრულებისას, გვირჩევს უსაფრთხო მეთოდებს და განმარტავს LLM-ისა და ხელსაწყოების მორგების ვარიანტებს, მათ შორის ფაილების შეყვანის შესაძლებლობას.
ტრანსფორმერზე დაფუძნებული ენკოდერ-დეკოდერის მოდელები: არქიტექტურისა და ინფერენციის სიღრმისეული მიმოხილვა
ეს ბლოგ-პოსტი დეტალურად განმარტავს, თუ როგორ ამუშავებენ ტრანსფორმერზე დაფუძნებული ენკოდერ-დეკოდერის არქიტექტურის მოდელები მიმდევრობა-მიმდევრობაზე ამოცანებს. განხილულია მათემატიკური მოდელი და მისი გამოყენება ინფერენციაში, NLP-ში მიმდევრობა-მიმდევრობაზე მოდელების ისტორიულ კონტექსტთან ერთად. იგი ყოფს ტრანსფორმერის არქიტექტურას ენკოდერისა და დეკოდერის ნაწილებად, გვაწვდის ვიზუალურ მასალას და აკავშირებს თეორიას 🤗Transformers-ის პრაქტიკულ გამოყენებასთან. სტატია მოკლედ მიმოიხილავს ნეირონული ენკოდერ-დეკო
მაღალი ხარისხის მთარგმნელის ადაპტირება: გამოწვევები და პროცესი
სტატია დეტალურად აღწერს Facebook FAIR-ის WMT19-ის ახალი ამბების მთარგმნელობითი სისტემის `transformers` ბიბლიოთეკასთან ადაპტირების (porting) პროცესს. პროექტის მიზანი იყო მაღალი ხარისხის მთარგმნელის ადაპტირება, რისთვისაც თავდაპირველი სისტემის დეტალური შესწავლა გახდა საჭირო. ავტორი განიხილავს პროექტის კომპლექსურობის დაძლევას მცირე ამოცანებად დაყოფით, წინასწარ გაწვრთნილი en-ru/ru-en მოდელებთან მუშაობის უპირატესობებს და ლექსიკონების განსხვავებების (გაერთიანებული vs. ცალკეული) დამუშავების თავისებურებე
როგორ შევქმნათ PS1-ის სტილის 3D აქტივები გენერაციული ხელოვნური ინტელექტის გამოყენებით
ეს სტატია გთავაზობთ პრაქტიკულ სახელმძღვანელოს, თუ როგორ უნდა მოხდეს გენერაციული ხელოვნური ინტელექტის ინტეგრირება PlayStation 1-ის სტილის 3D აქტივების შექმნაში თამაშებისთვის. ის განმარტავს, თუ რატომ არის ეს სტილი იდეალური არსებული text-to-3D მოდელების დაბალი ხარისხისთვის და გვიჩვენებს ნაბიჯ-ნაბიჯ პროცესს Shap-E-სა და Blender-ის (Dream Textures-თან ერთად) გამოყენებით, ტექსტიდან გამოსაყენებელი დაბალხარისხოვანი 3D მოდელის მისაღებად. სტატია ხაზს უსვამს ამ მეთოდის პოტენციალს უსასრულო დაბალხარისხოვანი

ღია კოდის ვიდეო გენერაციის მოდელების აღზევება: დგას თუ არა AI „Stable Diffusion-ის მომენტის“ ზღურბლზე?
ბოლო დროს შეინიშნება ღია კოდის ვიდეოს გენერაციის მოდელების, მათ შორის CogVideoX, Mochi-1, Hunyuan და LTX Video-ს სწრაფი ზრდა, რაც ბადებს კითხვას, დგას თუ არა ვიდეო საზოგადოება ხელოვნური ინტელექტის „Stable Diffusion-ის მომენტის“ ზღურბლზე. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, ხაზს უსვამს ისეთ შეზღუდვებს, როგორიცაა მოძრაობის ხარისხი, დროითი თანმიმდევრულობა და მეხსიერების მაღალი მოთხოვნები. Diffusers-ის გუნდი აქტიურად მუშაობს ამ გამოწვევების გადასაჭრელად სხვადასხ
ხელოვნური ინტელექტის ვიდეო გენერაციის მოდელები: მიმდინარე მდგომარეობა და ოპტიმიზაციის გზები
ღია კოდის პროექტებში ვიდეოს გენერაციის მოდელების სწრაფი განვითარება შეინიშნება, რამაც შეიძლება გამოიწვიოს „Stable Diffusion მომენტის“ განმეორება ვიდეო საზოგადოებაში. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, მათ შეზღუდვებს (კერძოდ, მოძრაობის ხარისხს, თანმიმდევრულობასა და კონსისტენტურობას დროის განმავლობაში) და არქიტექტურულ თავისებურებებს, როგორიცაა 3D ვიდეო ტოკენების დამუშავება. ყურადღება ექცევა Diffusers-ის გუნდის მიერ შემოთავაზებულ მეხსიერების ოპტიმიზაციის ტექნი
100-ჯერ გაზრდილი წარმადობა: დიდი AI მოდელების ოპტიმიზაცია Hugging Face-ის ინფრასტრუქტურაზე
მიუხედავად იმისა, რომ დიდი ენობრივი მოდელების ექსპერიმენტირება მარტივია, მათი მაქსიმალური წარმადობით პროდუქციაში განთავსება რთული საინჟინრო გამოწვევაა. Hugging Face გთავაზობთ გადაწყვეტას თავისი Accelerated Inference API-ის მეშვეობით, რომელიც უზრუნველყოფს 100-ჯერ გაზრდილ სიჩქარეს და მასშტაბირებადობას. სტატია დეტალურად აღწერს ოპტიმიზაციის სხვადასხვა დონეს – ბიბლიოთეკების გამოყენებიდან აპარატურის სპეციფიკურ მოდიფიკაციამდე – და ხაზს უსვამს Hugging Face-ის ექსპერტიზასა და პარტნიორობებს ტექნიკის წამყვ
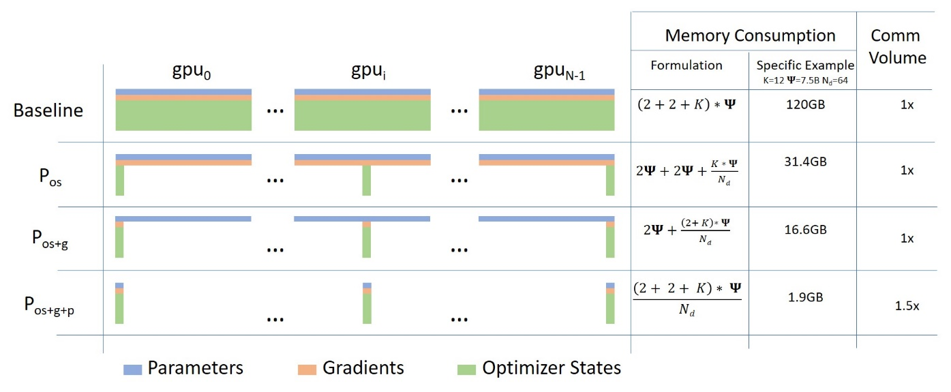
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.
მოდელების განთავსება ინფერენსის ენდპოინტებზე ქასთომ ჰენდლერების გამოყენებით: MusicGen-ის მაგალითი
ეს სტატია განმარტავს, თუ როგორ ხდება მოდელების, მათ შორის `transformers`-ის კონვეიერით პირდაპირ არმხარდაჭერილი ან არატრანსფორმერული მოდელების განთავსება Inference Endpoints-ის გამოყენებით. პროცესი მოიცავს მორგებული დასკვნის ფუნქციების, იგივე ქასთომ ჰენდლერების შექმნას, რათა შესაძლებელი გახდეს მოქნილი განთავსება. MusicGen-ის მაგალითზე დეტალურად არის აღწერილი `handler.py` და `requirements.txt` ფაილების შექმნა და ენდპოინტის კონფიგურაცია.

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ