BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან
LLM-ების ინტეგრაცია Swift აპლიკაციებში Core ML-ის გამოყენებით: დეველოპერების სახელმძღვანელო
მანქანური სწავლება (ML) პროგრამული უზრუნველყოფის შექმნის ახალ გზებს ხსნის, განსაკუთრებით Swift დეველოპერებისთვის, რომლებსაც სურთ ხელოვნური ინტელექტის ფუნქციების ინტეგრირება თავიანთ აპლიკაციებში. ეს სტატია წარმოგიდგენთ Core ML-ზე დაფუძნებულ ინსტრუმენტებსა და დეტალურ სახელმძღვანელოს, თუ როგორ უნდა გაუშვათ დიდი ენობრივი მოდელები (LLM), როგორიცაა Llama 2, Mac-ზე. პროექტი მოუწოდებს დეველოპერებს, შეერთდნენ და წვლილი შეიტანონ ამ ინიციატივის ერთობლივ გაუმჯობესებაში, რათა დააჩქარონ ხელოვნური ინტელექტის შ

ხელოვნური ინტელექტი და ხელოვნება: 2024 წლის საკვანძო მიღწევების მიმოხილვა და 2025 წლის მოლოდინები
ბოლო რამდენიმე წელი გადამწყვეტი აღმოჩნდა ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნების სფეროში. შემოქმედებითი გამოხატვისთვის განკუთვნილი ხელოვნური ინტელექტის ხელსაწყოები არასოდეს ყოფილა ასეთი ხელმისაწვდომი, და ეს მხოლოდ დასაწყისია. ეს სტატია მიმოიხილავს 2024 წლის ძირითად მიღწევებს ხელოვნური ინტელექტის მიერ გენერირებულ გამოსახულებებში, მათ შორის DiT არქიტექტურის, პერსონალიზაციისა და „ზერო-შოთ“ ტექნიკების წინსვლას. ხაზგასმულია, თუ როგორ ეჯიბრებიან ღია კოდის მოდელები დახურული კოდის გიგანტებ
ხელოვნური ინტელექტი ხელოვნებაში: ღია კოდის მოდელების გარდამტეხი წელი (2024-ის მიღწევები და 2025-ის მოლოდინები)
ბოლო რამდენიმე წელი, განსაკუთრებით კი 2024, გარდამტეხი აღმოჩნდა ხელოვნური ინტელექტის (AI) ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნებითი გამოყენების კუთხით. ამ მიმოხილვაში განვიხილავთ 2024 წლის მთავარ მიღწევებს, როგორიცაა DiT არქიტექტურის და Flux.1-ის გამოჩენა, პერსონალიზაციის ტექნიკების გაუმჯობესება და „ნულოვანი ოპტიმიზაციის“ მეთოდების აღმასვლა გამოსახულების გენერაციაში. სტატია ასევე მიმოიხილავს ვიდეოს გენერაციის სფეროში არსებულ გამოწვევებს და 2025 წლის მოლოდინებს, რომელიც AI და ხელოვნე
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს
RAG მოდელების გაუმჯობესება: Ray-ის ინტეგრაცია სწრაფი განაწილებული დახვეწისთვის
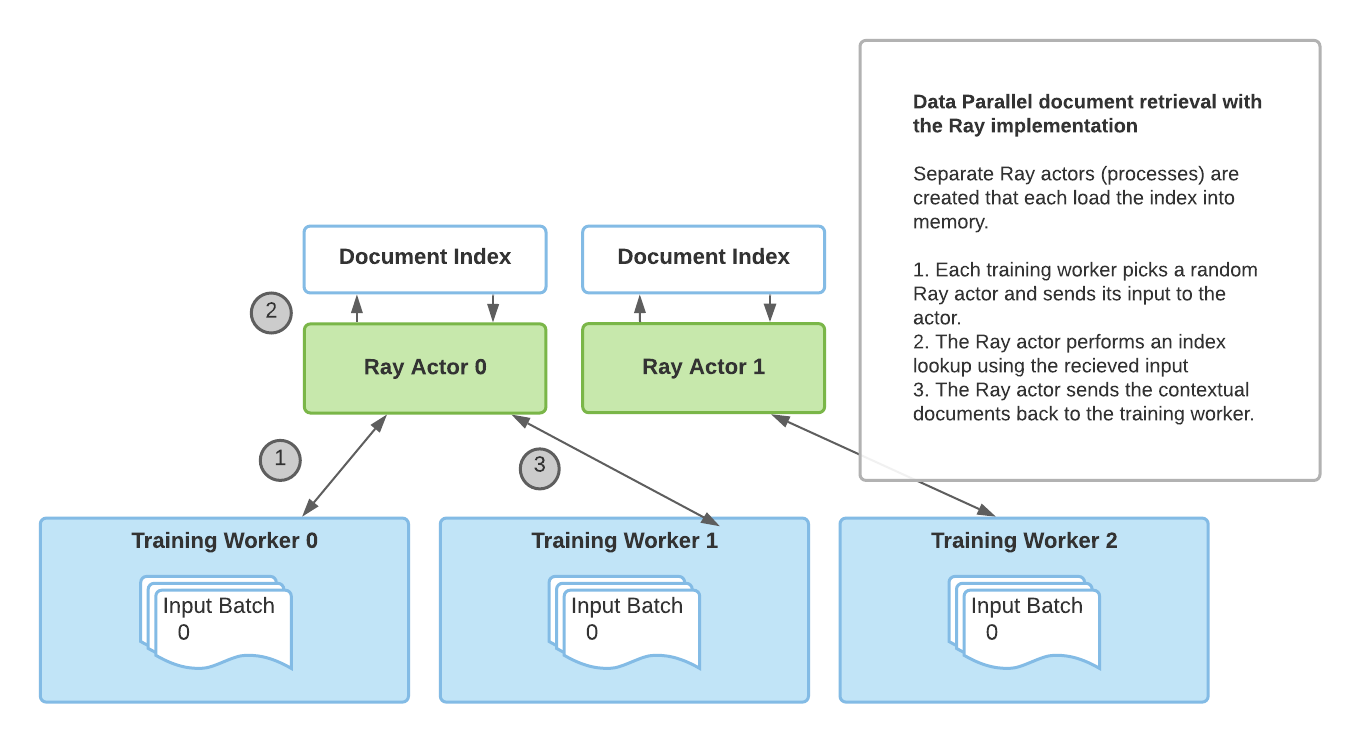
სტატია მიმოიხილავს RAG (Retrieval Augmented Generation) მოდელებს, რომლებიც კონტექსტურ დოკუმენტებს გარე წყაროებიდან იძიებენ შედეგების გენერაციისთვის. ის ხაზს უსვამს დოკუმენტების მოძიების პროცესის სირთულესა და მასშტაბირებადობის გამოწვევებს `torch.distributed` იმპლემენტაციის დროს. წარმოდგენილია Ray-ზე დაფუძნებული ახალი გადაწყვეტა, რომელიც მნიშვნელოვნად აუმჯობესებს მოძიების სიჩქარესა და RAG მოდელების დახვეწის მასშტაბირებადობას Huggingface Transformers ბიბლიოთეკაში. აღწერილია Ray-ის გამოყენების უპირა
RAG მოდელების გაძლიერება Ray-ის საშუალებით: განაწილებული ინფორმაციის მოძიების სიჩქარის გაორმაგება
სტატია განიხილავს RAG (Retrieval Augmented Generation) მოდელების მუშაობის პრინციპებს, რომლებიც კონტექსტური დოკუმენტების მოძიებით აუმჯობესებენ გენერაციის ხარისხს. წარმოდგენილია წინა იმპლემენტაციის (torch.distributed) შეზღუდვები და შემოთავაზებულია ახალი, გაუმჯობესებული მიდგომა Ray ბიბლიოთეკის გამოყენებით. Ray-ზე დაფუძნებული განაწილებული მოძიების იმპლემენტაცია არა მხოლოდ 2-ჯერ ზრდის მოძიების სიჩქარეს, არამედ აუმჯობესებს მოდელების დაზუსტებული კონფიგურაციის (fine-tuning) მასშტაბირებადობას და ხსნის Py
DeepFloyd IF-ის ინტეგრაცია BentoML-თან პროდუქტიული განთავსებისთვის
სტატია მიმოიხილავს, თუ როგორ ხდება BentoML-ის, ღია კოდის პლატფორმის, გამოყენება DeepFloyd IF-ის, თანამედროვე ტექსტიდან გამოსახულების გენერირების მოდელის, განთავსებისთვის. აღწერილია DeepFloyd IF-ის უნიკალური არქიტექტურა (პიქსელურ სივრცეში მუშაობა, კასკადური დიფუზია, LLM-ის გამოყენება მოთხოვნებისთვის) და BentoML-ის მეშვეობით რესურსების ოპტიმალური მართვა, მათ შორის GPU-ს განაწილება. მოცემულია ინსტრუქციები პროექტის ლოკალურად გაშვებისთვის, მოდელების ჩამოტვირთვისთვის, სერვერის Gradio-სთან ერთად გაშვებ

DeepSeek R1-ის გამოშვებიდან ორი კვირა: ღია-R1 პროექტის მიღწევები და გამოწვევები
სტატია აჯამებს ღია-R1 პროექტის განვითარებას, რომელიც DeepSeek R1-ის სასწავლო კონვეიერისა და სინთეზური მონაცემების რეპლიკაციას ისახავს მიზნად. მიღწევებს შორისაა DeepSeek-ის შეფასების ქულების რეპროდუცირება და GRPO-ის ინტეგრაცია TRL-ში. პროექტი DeepSeek R1-ის ხანგრძლივი პასუხების გამო GPU მეხსიერებისა და გენერაციის ეფექტურობის გამოწვევების წინაშე დგას, თუმცა ინფერენსის ოპტიმიზაციაში მნიშვნელოვანი პროგრესია. ინიციატივამ მედიის ფართო ინტერესიც გამოიწვია.
ნერვული ქსელების აგება და გამართვა: ჰაიპის მიღმა
სტატია მიმოიხილავს ნერვული ქსელების, მათ შორის GPT-3-ის, ირგვლივ არსებულ დიდ აჟიოტაჟს და უპირისპირებს მას ამ ტექნოლოგიების რეალურ შექმნასა და გამართვასთან დაკავშირებულ სირთულეებს. ავტორი გვთავაზობს პრაქტიკულ, სისტემატურ მიდგომას ნერვული ქსელების დიზაინისა და დებაგინგისთვის, ხაზს უსვამს მონაცემთა სიღრმისეული ანალიზის, მარტივი ბაზისური მოდელების გამოყენებისა და დეტალური ტესტირების მნიშვნელობას, განსაკუთრებით Hugging Face-ში მუშაობის გამოცდილებიდან გამომდინარე.
Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.
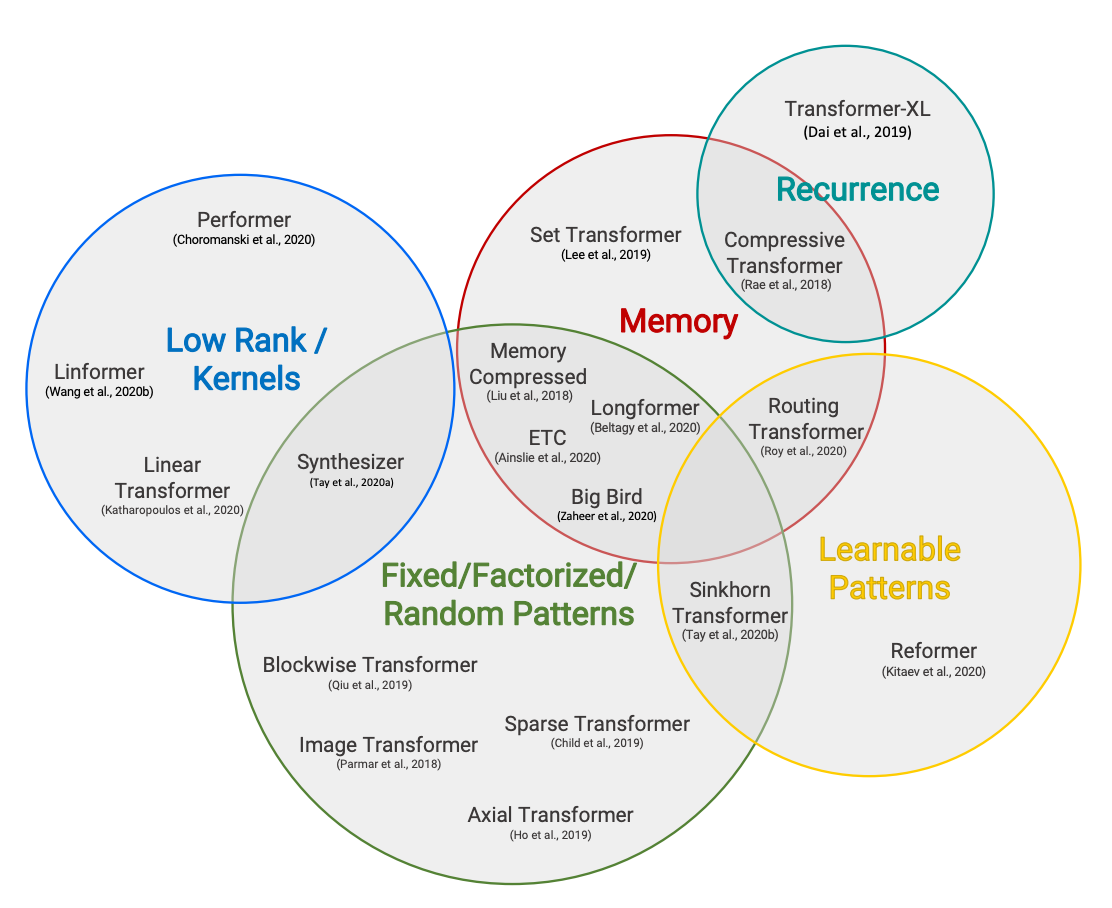
ტრანსფორმერების ეფექტურობის გამოწვევები: შორს მიმავალი ყურადღება და მეხსიერების ოპტიმიზაცია
დიდი ტრანსფორმერების მოდელების გამოთვლითი მოთხოვნების შემცირება კვლევის ერთ-ერთი მთავარი მიმართულებაა, განსაკუთრებით თანმიმდევრობის სიგრძესთან დაკავშირებული კვადრატული დანახარჯის პრობლემის გამო. სტატია განიხილავს ოთხ ძირითად მიდგომას ამ გამოწვევის მოსაგვარებლად: Longformer, Transformer-XL, Compressive Transformer და დაბალი რანგის ყურადღების მატრიცების გამოყენება, რომლებიც მიზნად ისახავს მოდელების მეხსიერებისა და დროის ეფექტურობის გაუმჯობესებას გრძელი თანმიმდევრობების დამუშავებისას.
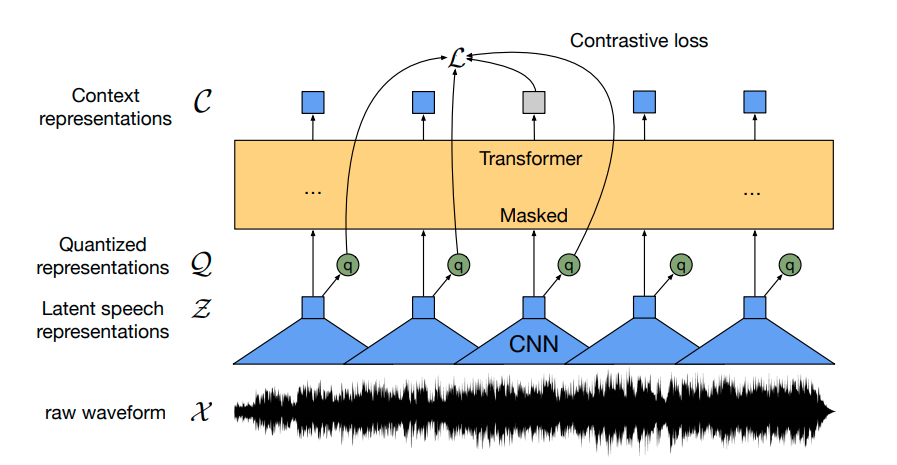
Wav2Vec2: ახალი ეპოქა მეტყველების ავტომატურ ამოცნობაში
Wav2Vec2 წარმოადგენს ინოვაციურ მოდელს, რომელიც იყენებს კონტრასტულ წინასწარ წვრთნას 50 000 საათზე მეტი არადანიშნული მეტყველების მონაცემებიდან მძლავრი წარმოდგენების შესასწავლად. BERT-ის მსგავსად, ის ნიღბავს ფუნქციის ვექტორებს კონტექსტუალიზებული წარმოდგენების მისაღებად. მოდელმა აჩვენა კონკურენტული შედეგები თანამედროვე ავტომატური მეტყველების ამოცნობის (ASR) სისტემებთან, მინიმალური, სულ რაღაც 10 წუთის, დანიშნულ მონაცემებზე დამატებითი წვრთნის შემდეგ. ეს სტატია დეტალურად განმარტავს Wav2Vec2-ის წინასწარ
მომხმარებელთა შეფასებების სენტიმენტური ანალიზის მიკროსერვისის შექმნა Google Cloud-ზე
სტატია აღწერს მიკროსერვისის შექმნის პროცესს, რომელიც Discord-ში დატოვებულ მომხმარებელთა შეფასებებს ავტომატურად აანალიზებს და მათ პოზიტიურ ან ნეგატიურ შინაარსს განსაზღვრავს. ავტორი განიხილავს საწყის სირთულეებს მოდელის ჩატვირთვისა (როგორიცაა .h5 ფაილის ტიპის გაგება) და შესაბამისი ღრუბლოვანი პლატფორმის შერჩევისას (AI-Platform Prediction, App Engine, Cloud Run). საბოლოოდ, წარმოადგენს Cloud Run-სა და PyTorch-ზე დაფუძნებულ, Docker-ის გამოყენებით განხორციელებულ გადაწყვეტას, რომელიც ოპტიმიზირებულია მეხს

Open R1 პროექტი: OpenR1-Math-220k მონაცემთა ნაკრების წარდგენა მათემატიკური მსჯელობისთვის
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის დაკარგული კომპონენტების – კერძოდ, საწვრთნელი პაიპლაინისა და სინთეზური მონაცემების – რეკონსტრუქცია, უკვე ორი კვირაა მიმდინარეობს. ამ პოსტში წარმოდგენილია OpenR1-Math-220k: ჩვენი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები მათემატიკური მსჯელობისთვის. განხილულია საზოგადოების ძალისხმევა მცირე, მაღალი ხარისხის მონაცემთა ნაკრებების შესაქმნელად და მსჯელობის მოდელებიდან „აზროვნების ჯაჭვის“ (chain-of-thought) სიგრძის კონტროლის მეთოდები. სტატია დეტალურად აღწერ

ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნა: ახალი ინსტრუმენტები საზოგადოებისთვის
ამ სტატიაში განვიხილავთ ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნისთვის შემუშავებულ ახალ ინსტრუმენტებს, რომლებიც მიზნად ისახავს ამ პროცესის გამარტივებას, სურათების გენერაციის მსგავსად. წარმოდგენილია ღია კოდის სკრიპტები მცირე მასშტაბისთვის და video2dataset დიდი მასშტაბისთვის. დეტალურად აღიწერება მონაცემთა დამუშავების 3-ეტაპიანი კონვეიერი, ფილტრაციის სტრატეგიები (მათ შორის pwatermark-ისა და ესთეტიკური ქულების გამოყენებით) და მათი გავლენა ვიდეო გენერაციის მოდელების ხარისხზე. მიზანია, საზოგადოებას
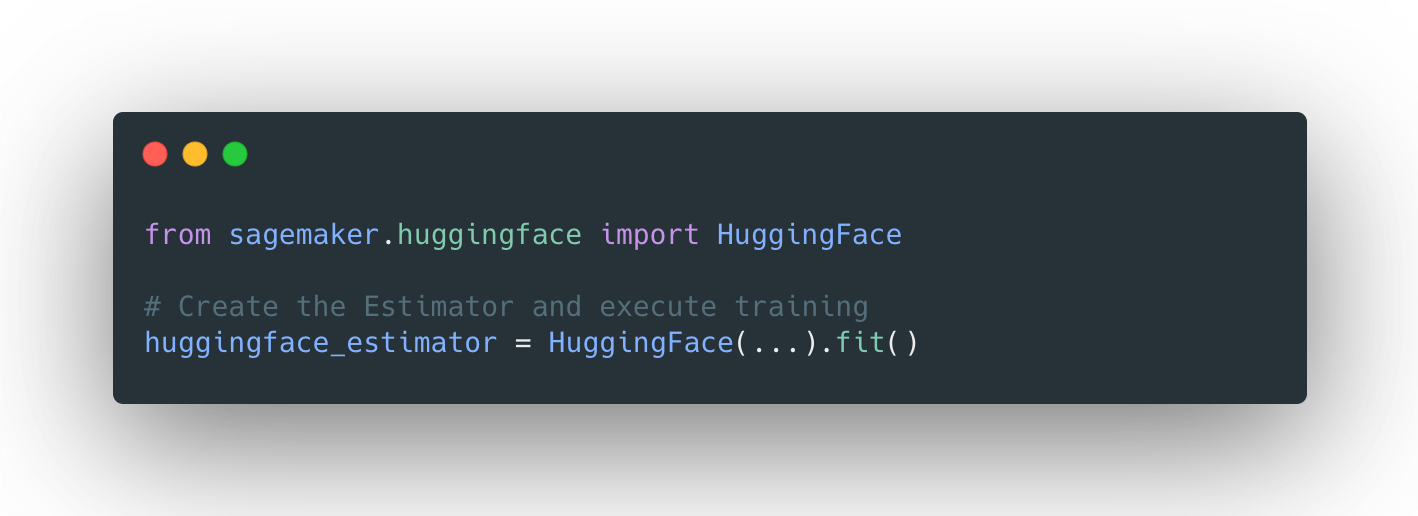
Hugging Face Transformers-ისა და AWS SageMaker-ის ინტეგრაცია: მარტივი და სწრაფი AI მოდელების ტრენინგი
Hugging Face-ისა და AWS SageMaker-ის გუნდებმა ერთობლივად შექმნეს Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები, რაც მნიშვნელოვნად აჩქარებს Transformers-ზე დაფუძნებული მოდელების ტრენინგს. ახალი HuggingFace estimator-ის წყალობით SageMaker Python SDK-ში, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ეს ინტეგრაცია დეტალურად აღწერილია ბლოგ-პოსტში, რომელიც მოიცავს დაწყების მაგალითებსა და დოკუმენტაციას. სტატია განმარტავს, თუ როგორ ხდება Facebook-ის BART-large-cnn მოდელის დახვეწა Samsum მ
AWS SageMaker-ისა და Hugging Face-ის ინტეგრაცია: Transformer-ზე დაფუძნებული მოდელების ოპტიმიზებული ტრენინგი
AWS SageMaker-ისა და Hugging Face-ის გუნდებმა ერთობლივად შექმნეს ოპტიმიზებული ღრმა სწავლის კონტეინერები (DLCs) Transformer-ზე დაფუძნებული მოდელების ტრენინგის დასაჩქარებლად. ახალი HuggingFace estimator-ის SageMaker Python SDK-ში ინტეგრაციის წყალობით, მომხმარებლებს შეუძლიათ ტრენინგის დაწყება კოდის მხოლოდ ერთი ხაზით. სტატია დეტალურად აღწერს ამ ინტეგრაციას, მოიცავს განაწილებული Seq2Seq-transformer მოდელის გაწვრთნის პროცესს შეჯამების ამოცანისთვის და განხილულია მოდელის ატვირთვისა და ტესტირების ნაბიჯებ
Hugging Face Hub: მონაცემთა გადაცემის და შენახვის ოპტიმიზაცია დედუპლიკაციის ახალი მიდგომებით
Hugging Face Hub-ზე ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების სწრაფი ზრდა მოითხოვს ეფექტურ მონაცემთა მართვას. სტატია აღწერს, თუ როგორ უმკლავდება Xet გუნდი გამოწვევებს, რომლებიც დაკავშირებულია დედუპლიკაციასთან, ტრადიციული მიდგომების შეზღუდვებთან და მასშტაბირებადობასთან. ნაცვლად იმისა, რომ ფოკუსირება მხოლოდ მცირე ბლოკების დედუპლიკაციაზე მოხდეს, რაც ინფრასტრუქტურას გადატვირთავს, Xet გუნდმა შეიმუშავა ინოვაციური, ბლოკებზე დაფუძნებული მიდგომა Rust-ში დაწერილი xet-core და hf_xet ინტეგრაცი

AI მოდელების მასშტაბური ინფერენციის ოპტიმიზაცია: ხარჯი და შეყოვნება
ეს სტატია დეტალურად აღწერს მეთოდოლოგიას ენკოდერული მოდელების გამოყენებით მასშტაბური კლასიფიკაციისა და ემბედინგის ამოცანებისთვის ხარჯებისა და შეყოვნების გამოსათვლელად და ოპტიმიზაციისთვის. განხილულია მოდელების არქიტექტურები, აპარატურული ხარჯების ბენჩმარკინგი და ოპტიმიზაციის ჩარჩო. გამოყენებულია ისეთი ინსტრუმენტები, როგორიცაა Inference Endpoints აპარატურის შერჩევისთვის, Hugging Face Hub განთავსებისთვის, Infinity ინფერენციის სერვერისთვის და Grafana-ს k6 დატვირთვის ტესტირებისთვის. მოცემულია პრაქტიკულ
Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.

Few-Shot Learning ხელოვნურ ინტელექტში: GPT-Neo და აჩქარებული დასკვნის API
სტატია განმარტავს „Few-Shot Learning“ (რამდენიმე მაგალითზე დაფუძნებული სწავლების) კონცეფციას, როგორც მანქანური სწავლების ტექნიკას, რომელიც მოდელს მცირე რაოდენობის მონაცემებით წვრთნის. განხილულია მისი გამოყენება ბუნებრივი ენის დამუშავებაში (NLP) დიდი ენობრივი მოდელების, როგორიცაა EleutherAI GPT-Neo და OpenAI GPT-3, მეშვეობით. სტატია ასევე მიმოიხილავს Hugging Face-ის აჩქარებული დასკვნის (Accelerated Inference) API-ის როლს, ამ ტექნიკის ოპტიმიზაციას, გამოწვევებს (მაგ., მოდელის მგრძნობელობა მაგალითებ
Hugging Face-ის გაფართოებული ეკოსისტემა: ახალი პარტნიორები და AI მოდელები ინფერენსისთვის
Hugging Face წარმოგიდგენთ ახალ პარტნიორებსა და ინფერენსის მოდელებს, მათ შორის DeepSeek-R1-სა და Flux.1-ს, რითაც მნიშვნელოვნად აფართოებს ხელმისაწვდომ შესაძლებლობებს AI დეველოპერებისთვის. გაუმჯობესებული ბილინგის სტრუქტურა და PRO მომხმარებლებისთვის განკუთვნილი ყოველთვიური კრედიტები პლატფორმას კიდევ უფრო მიმზიდველს ხდის. სტატიაში მოცემულია მაგალითები და დეტალები მომხმარებლის გამოცდილების შესახებ.
მოდელების კვანტიზაცია: bitsandbytes-ისა და GPTQ-ის შედარება
ეს სტატია განიხილავს მოდელების კვანტიზაციის ორ ძირითად მიზანს და `transformers` ბიბლიოთეკაში ინტეგრირებულ ორ ძირითად სქემას: `bitsandbytes`-ს და `auto-gptq`-ს. მოცემულია თითოეული მეთოდის დადებითი და უარყოფითი მხარეები, საზოგადოების გამოხმაურების საფუძველზე. ასევე წარმოდგენილია ინფერენციისა და ადაპტერების დაზუსტების ბენჩმარკები სხვადასხვა აპარატურაზე, რაც მომხმარებლებს დაეხმარება ოპტიმალური მიდგომის არჩევაში.