
ZDNET-ის რეკომენდაციები: გაიგეთ ჩვენი პოლიტიკა და აირჩიეთ საუკეთესო სტრიმინგის სერვისი (Apple Music vs. Spotify)
ZDNET-ის ეს სტატია განმარტავს, თუ რას ნიშნავს ჩვენი რეკომენდაციები, როგორ ვახორციელებთ პროდუქტების საფუძვლიან ტესტირებასა და კვლევას მიუკერძოებელი ინფორმაციის მისაწოდებლად. გარდა ამისა, ის დეტალურად ადარებს ორ წამყვან მუსიკალურ სტრიმინგ სერვისს, Apple Music-სა და Spotify-ს, აანალიზებს მათ ფასებს, შეთავაზებებს (როგორიცაა პოდკასტები, აუდიოწიგნები, მუსიკალური ვიდეოები, Dolby Atmos) და ფუნქციებს, რათა დაგეხმაროთ თქვენთვის საუკეთესო არჩევანის გაკეთებაში.
ZDNET-ის რეკომენდაციები: რას ნიშნავს ეს? Apple Music-ისა და Spotify-ის დეტალური შედარება
ZDNET-ის რედაქცია განმარტავს, თუ რას გულისხმობს მისი რეკომენდაციები პროდუქტების შესახებ – ეს არის მრავალსაათიანი ტესტირების, კვლევისა და შედარებითი ანალიზის შედეგი. სტატიაში დეტალურად განიხილება ორი წამყვანი მუსიკალური სტრიმინგ სერვისი, Apple Music და Spotify, სადაც ხაზგასმულია მათი განსხვავებები ფასებში, შეთავაზებულ ფუნქციებში (როგორიცაა რადიო შოუები, მუსიკალური ვიდეოები, პოდკასტები, აუდიოწიგნები) და Dolby Atmos-ის მხარდაჭერაში. მიზანია მომხმარებლებს დაეხმაროს ინფორმირებული გადაწყვეტილების მიღე

ZDNET-ის რეკომენდაციები: რას ნიშნავს ეს Sonos Arc Ultra-სთან მიმართებაში და ღირს თუ არა მისი შეძენა?
ZDNET-ის სარედაქციო გუნდი დეტალურად განმარტავს თავის რეკომენდაციის მეთოდოლოგიას, რომელიც დაფუძნებულია მრავალსაათიან ტესტირებასა და კვლევაზე. სტატიაში დეტალურად არის განხილული Sonos Arc Ultra საუნდბარის მახასიათებლები, შესრულება და ფასდაკლებები. Arc Ultra, რომელიც გამოვიდა 2024 წლის ბოლოს, გთავაზობთ გაუმჯობესებულ ბასს და სუფთა აუდიოს, განსაკუთრებით დიდ ოთახებში. მიუხედავად იმისა, რომ იგი წარმოადგენს ძლიერ განახლებას ნებისმიერი eARC პორტის მქონე ტელევიზორისთვის, ის მომხმარებლებს აკავშირებს Sonos-ი

Livebook, Elixir და Hugging Face: მანქანური სწავლების ახალი ჰორიზონტები
სტატია მიმოიხილავს ჩატის აპლიკაციას, რომელიც აუდიო შეტყობინებებს Whisper ML მოდელის გამოყენებით ტექსტად გარდაქმნის და წარმოაჩენს Livebook-ისა და Elixir-ის მანქანური სწავლების ეკოსისტემის შესაძლებლობებს. დეტალურად არის განხილული Elixir-ის საზოგადოების თანამშრომლობა Hugging Face პლატფორმასთან, მათ შორის Bumblebee ბიბლიოთეკის, tokenizers-ის და Livebook-ის Hugging Face Spaces-ში ინტეგრაციის მაგალითები, რაც მანქანური სწავლის გამოყენების ახალ გზებს ხსნის.

Big Bench Audio: ახალი მონაცემთა ნაკრები აუდიო ენის მოდელების მსჯელობის შესაძლებლობების შესაფასებლად
კომპანია Artificial Analysis-მა გამოუშვა Big Bench Audio, ახალი მონაცემთა ნაკრები, რომელიც შექმნილია აუდიო ენის მოდელების მსჯელობის შესაძლებლობების შესაფასებლად. ეს ინოვაციური ნაკრები Big Bench Hard-ის კითხვებს აუდიო ფორმატში ადაპტირებს. პირველადი შედეგები, რომლებიც GPT-4o-სა და Gemini 1.5-ის სერიის მოდელებზე ჩატარდა, ავლენს მნიშვნელოვან „მეტყველების მსჯელობის ხარვეზს“: GPT-4o-ის სიზუსტე ტექსტურ ვერსიაში 92%-ს აღწევს, ხოლო მეტყველება-მეტყველებაზე შესრულებისას ის 66%-მდე ეცემა. ანალიზი მოიცავს მრ
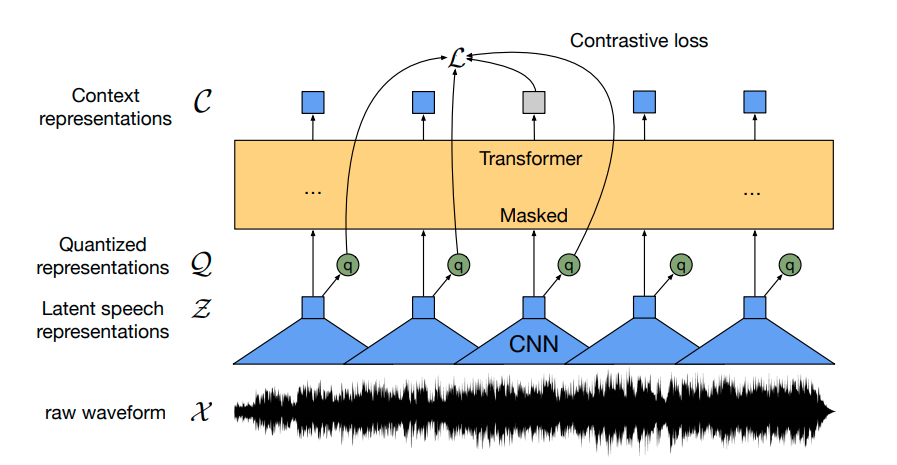
Wav2Vec2: გარღვევა მეტყველების ამოცნობაში მინიმალური მარკირებული მონაცემებით
Wav2Vec2, რევოლუციური ხელოვნური ინტელექტის მოდელი, სწავლობს მეტყველების მძლავრ წარმოდგენებს დიდი მოცულობის არამარკირებული აუდიო მონაცემებიდან, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მეთოდის გამოყენებით. მან აჩვენა უპრეცედენტო შედეგები ავტომატური მეტყველების ამოცნობის (ASR) სფეროში, მიაღწია უმაღლეს დონეს მაშინაც კი, როდესაც დამატებითი ვარჯიში (fine-tuning) ხდება სულ რაღაც 10 წუთის მარკირებულ მეტყველების მონაცემებზე. ეს მას ქმნის მაღალეფექტურ გადაწყვეტილებად ძლიერი ASR სისტემების შესაქმნელად, რ
AI აუდიო გენერაცია: AudioLDM 2-ის სიჩქარის რეკორდი - 10 წამი 1 წამში
AudioLDM 2, ტექსტიდან აუდიოს გენერირების ხელოვნური ინტელექტის მძლავრი მოდელი, ადრე გამოირჩეოდა ნელი მუშაობით, 10-წამიანი აუდიოს შესაქმნელად 30 წამზე მეტი სჭირდებოდა. ახალი ბლოგ პოსტი დეტალურად აღწერს, თუ როგორ იქნა მიღწეული ინფერენციის დროის 10-ჯერ შემცირება, კოდისა და მოდელის ოპტიმიზაციების, მათ შორის ნახევრად ზუსტი გამოთვლებისა და Flash Attention-ის გამოყენებით. შედეგად, შესაძლებელია 10-წამიანი აუდიო ნიმუშის გენერირება მხოლოდ 1 წამში, ხარისხის მინიმალური გაუარესებით, Hugging Face Diffusers ბიბ

FastRTC: ახალი Python ბიბლიოთეკა რეალურ დროში AI აუდიო და ვიდეო აპლიკაციებისთვის
მიუხედავად ხელოვნური ინტელექტის მოდელებისა და დაფინანსების მხრივ სწრაფი განვითარებისა, რეალურ დროში AI აპლიკაციების შექმნა, რომლებიც აუდიო და ვიდეო ნაკადებს ამუშავებენ, განსაკუთრებით Python-ში, კვლავ სირთულეებთანაა დაკავშირებული. FastRTC, ახალი კომუნიკაციის ბიბლიოთეკა Python-ისთვის, შექმნილია სწორედ ამ პროცესის გასამარტივებლად, რაც დეველოპერებს საშუალებას აძლევს მარტივად ააწყონ რეალურ დროში აუდიო და ვიდეო AI აპლიკაციები მხოლოდ Python-ის გამოყენებით.
Hugging Face-ის სიახლეები: ივნისი, ივლისი, აგვისტო
ბოლო თვეებში Hugging Face Hub მნიშვნელოვნად გაფართოვდა, დაინერგა „Spaces“ მანქანური სწავლების დემო აპლიკაციებისთვის, ასევე დაემატა ახალი ფუნქციები, როგორიცაა რეპოზიტორების მოწონება, TensorBoard-ის ინტეგრაცია და შეფასების დეტალური მეტრიკა. დაინერგა ახალი ვიჯეტები სხვადასხვა ხელოვნური ინტელექტის მოდელებისთვის (ტექსტი, აუდიო, გამოსახულება). პლატფორმამ გააუმჯობესა დოკუმენტაცია, რეპოზიტორების მართვა და გამოუშვა უფასო ონლაინ კურსი. დიდი საზოგადოებრივი ღონისძიება, რომელშიც 800-მდე მონაწილე იყო ჩართული,
Hugging Face-ის ზაფხულის განახლებები: ივნისი, ივლისი, აგვისტო
ეს პოსტი აჯამებს Hugging Face-ის ივნის-აგვისტოს განახლებებს, მათ შორის საჯარო მოდელების რეპოზიტორიების 10,000-დან 16,000-მდე ზრდას. წარმოდგენილია ახალი ფუნქციები, როგორიცაა „Spaces“ ML დემო აპლიკაციების ჰოსტინგისთვის, ნივთების „მოწონების“ შესაძლებლობა, TensorBoard-ის ინტეგრაცია, შეფასების მეტრიკები, რომლებიც დაკავშირებულია Papers With Code-თან, ახალი ვიჯეტები სხვადასხვა ML ამოცანებისთვის (აუდიო, სტრუქტურირებული მონაცემები, გამოსახულება), გაუმჯობესებული დოკუმენტაცია, რეპოზიტორიების გადატანა/გადარ
Wav2Vec2 და XLS-R: გარღვევა მეტყველების ავტომატური ამოცნობის ტექნოლოგიაში
2020 წელს გამოშვებული Wav2Vec2 მოდელიდან დაწყებული, Facebook AI-ის მრავალენოვანი XLSR ვერსიის გავლით, 2021 წლის ნოემბერში წარმოდგენილი XLS-R წარმოადგენს მნიშვნელოვან მიღწევას მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. XLS-R, რომელიც გაწვრთნილია 128 ენაზე ნახევარ მილიონ საათამდე აუდიო მონაცემზე, უზრუნველყოფს კონტექსტუალიზებულ მეტყველების წარმოდგენებს და აჩვენებს შთამბეჭდავ გაუმჯობესებას მეტყველების ამოცნობის, თარგმანისა და ენის იდენტიფიკაციის ამოცანებში. სტატია დეტალურად განმარტავს ამ მოდელე
Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.

Cloudflare-ისა და FastRTC-ის პარტნიორობა: AI-ზე დაფუძნებული რეალურ დროში კომუნიკაციის გამარტივება
Cloudflare-ისა და Hugging Face-ის FastRTC-ის პარტნიორობა AI დეველოპერებს საშუალებას აძლევს, მინიმალური კოდით შექმნან დაბალლატენტური, ხელოვნურ ინტელექტზე დაფუძნებული აუდიო და ვიდეო ნაკადები. ეს ინტეგრაცია აბსტრაგირებს WebRTC-ის სირთულეებს და იყენებს Cloudflare-ის გლობალურ TURN ქსელს საიმედო კავშირების უზრუნველსაყოფად, რაც დეველოპერებს საშუალებას აძლევს ფოკუსირება მოახდინონ აპლიკაციის ძირითად ლოგიკაზე ინფრასტრუქტურის შენარჩუნების გარეშე. პარტნიორობა ასევე გთავაზობთ 10 GB უფასო მონაცემს ყოველთვიურა
Wav2Vec2: ტრანსფორმერული მოდელების შეზღუდვების დაძლევა ხანგრძლივი აუდიო ფაილების დამუშავებისას
Wav2Vec2, როგორც ტრანსფორმერული მოდელი, აწყდება თანმიმდევრობის სიგრძის შეზღუდვებს, რაც იწვევს პრობლემებს დიდ აუდიო ფაილებთან მუშაობისას. ტრადიციული დაყოფის მეთოდები ხშირად ამცირებს შედეგების ხარისხს კონტექსტის დაკარგვის გამო. ეს სტატია განმარტავს, თუ როგორ იძლევა Wav2Vec2-ის CTC სტრუქტურა საშუალებას, განხორციელდეს მდგრადი მეტყველების ამოცნობა ძალიან დიდ ფაილებზე, „striding“ ტექნიკის გამოყენებით. ასევე განხილულია ენის მოდელების (LM) ინტეგრაცია WER მაჩვენებლის გასაუმჯობესებლად და მოდელის გამოყენებ
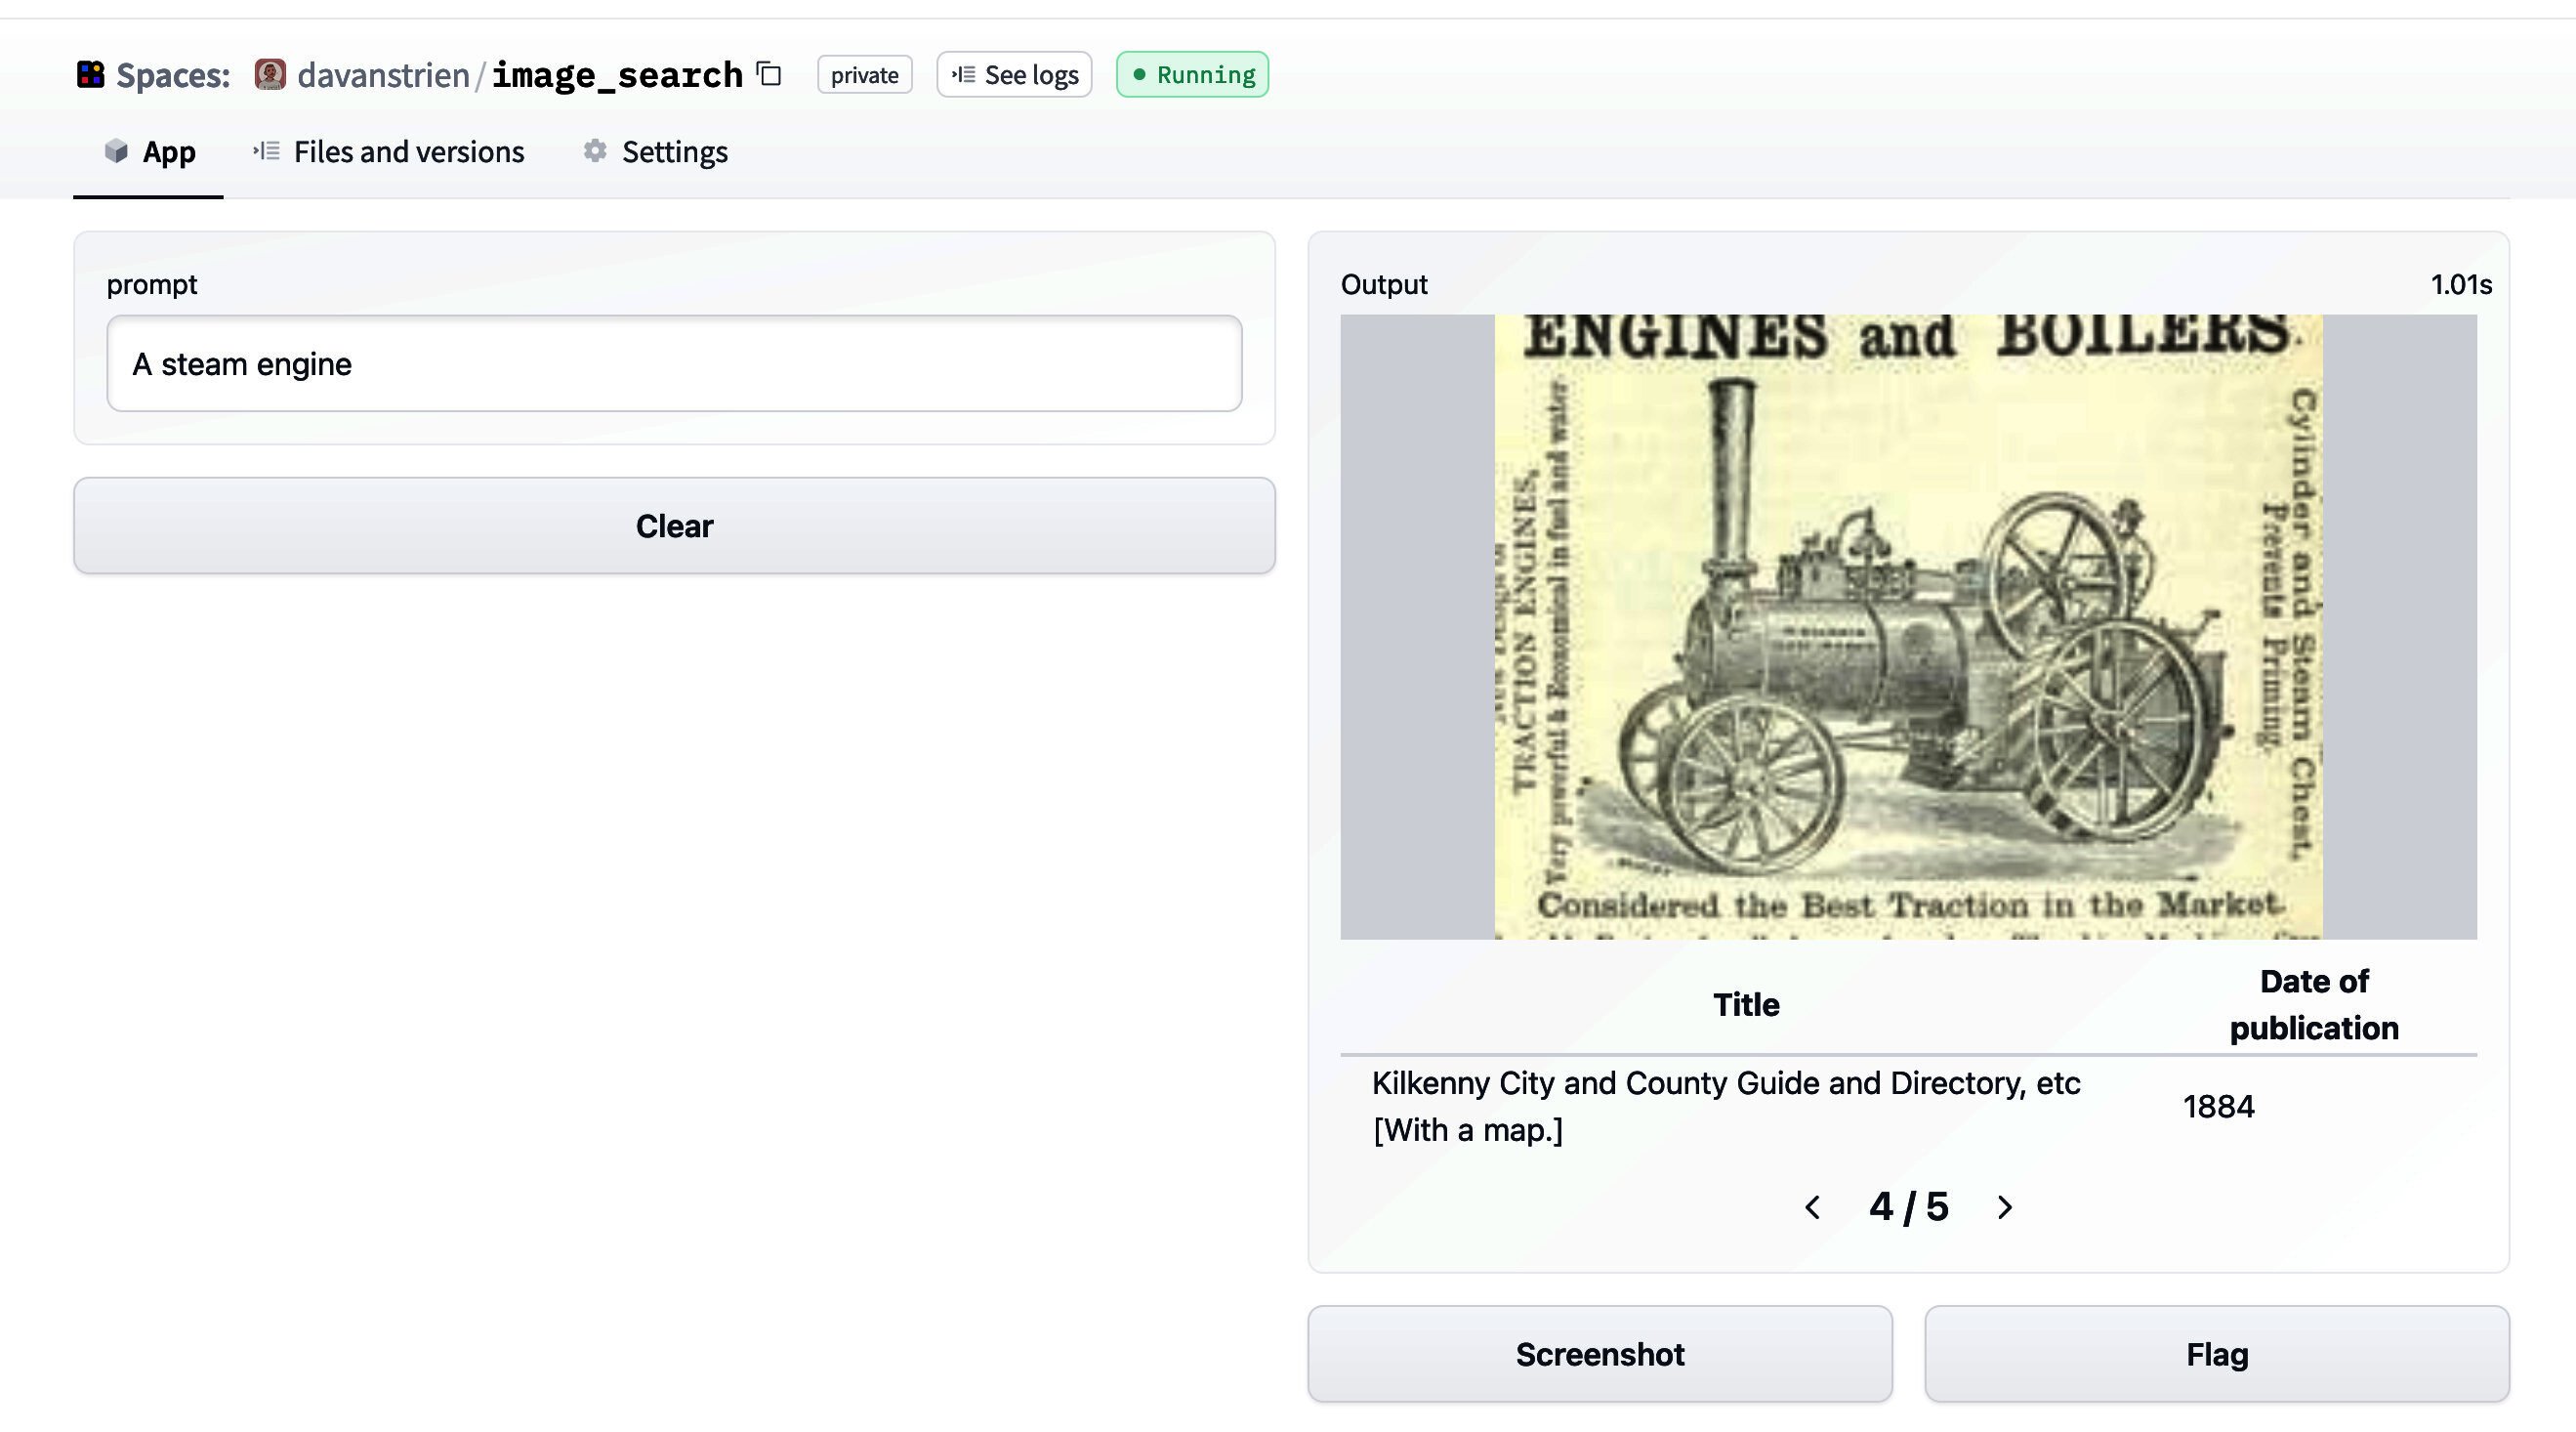
`datasets` ბიბლიოთეკა: ახალი შესაძლებლობები სურათების ძიებისთვის
თავდაპირველად ტექსტურ მონაცემებთან ასოცირებული `datasets` ბიბლიოთეკა ახლა გაძლიერებულ მხარდაჭერას გვთავაზობს აუდიო და სურათებისთვის. ეს სტატია განიხილავს, თუ როგორ შეიძლება `datasets`-ის, `sentence_transformers`-ისა და `faiss`-ის გაერთიანებით სურათების საძიებო აპლიკაციის შექმნა, ბრიტანეთის ბიბლიოთეკის ციფრული კოლექციიდან მიღებული სურათების მაგალითზე.

Gradio-ს ახალი შესაძლებლობები: LLM ინსტრუმენტების სერვერები Model Context Protocol-ით (MCP)
Gradio, პოპულარული Python ბიბლიოთეკა მანქანური სწავლების ინტერფეისებისთვის, ახლა მხარს უჭერს Model Context Protocol (MCP) სერვერების გაშვებას დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპლიკაციებს საშუალებას აძლევს ფუნქციონირებდნენ როგორც ხელსაწყოები LLM-ებისთვის, რაც მათ სთავაზობს დამატებით შესაძლებლობებს, როგორიცაა გამოსახულების გენერაცია, აუდიო სინთეზი ან კონკრეტული გამოთვლები. სტატია აღწერს, თუ როგორ შეიძლება რამდენიმე ხაზი კოდით Gradio-ს MCP სერვერად გადაქცევა და წარმოადგენს მის
MetaAI-ის Wav2Vec2-BERT: გაუმჯობესებული მეტყველების ამოცნობა დაბალრესურსიან ენებზე
MetaAI-მ გამოუშვა Wav2Vec2-BERT, ხელოვნური ინტელექტის მოდელი მეტყველების ავტომატური ამოცნობისთვის (ASR), რომელიც Seamless Communication-ის ნაწილია. ორიგინალური Wav2Vec2-ის გაუმჯობესებული ვერსია, Wav2Vec2-BERT, გაწვრთნილია 4.5 მილიონ საათზე მეტ აუდიო მონაცემზე 143-ზე მეტ ენაზე. ის მნიშვნელოვნად აღემატება Whisper-ის მოდელს სიჩქარითა და რესურსების ეფექტურობით, განსაკუთრებით დაბალრესურსიან ენებზე, როგორიცაა მონღოლური, სადაც Whisper-ი დაბალ შედეგებს აჩვენებს. Wav2Vec2-BERT-ს შეუძლია მიაღწიოს კონკურენ

Microsoft Azure-ი Hugging Face-თან თანამშრომლობას აფართოებს: 10,000-ზე მეტი AI მოდელი Azure AI Foundry-ზე
Microsoft-მა და Hugging Face-მა გააფართოვეს სტრატეგიული თანამშრომლობა, რის შედეგადაც Azure AI Foundry-ზე 10,000-ზე მეტი Hugging Face-ის ღია მოდელი გახდა ხელმისაწვდომი. ეს ინიციატივა დეველოპერებსა და საწარმოებს საშუალებას აძლევს, მარტივად განათავსონ AI აპლიკაციები ტექსტთან, აუდიოსთან და გამოსახულებებთან სამუშაოდ, ღია კოდის გამჭვირვალობისა და Azure-ის უსაფრთხო, საწარმოო დონის ინფრასტრუქტურის გამოყენებით. თანამშრომლობა მიზნად ისახავს AI-ის ინოვაციის დაჩქარებას და ორგანიზაციებს საკუთარი AI ბედის კონ
TTS Arena: მეტყველების სინთეზის მოდელების შეფასების დემოკრატიზაცია
მეტყველების სინთეზის სფეროში დიდი ხანია არ არსებობდა მოდელების ხარისხის ზუსტი გაზომვის მეთოდი. არსებული ობიექტური და სუბიექტური მეთოდები არაეფექტურია მსგავსი ხარისხის მოდელების შესადარებლად. ამ გამოწვევის საპასუხოდ, შეიქმნა TTS Arena, სადაც საზოგადოებას შეუძლია შეაფასოს სინთეზირებული აუდიო და დაეხმაროს მოდელების რანჟირების დემოკრატიზაციას. პლატფორმა იყენებს ადამიანის შეფასებას, მსგავსად Chatbot Arena-ისა, მოდელების ობიექტური შედარებისთვის.
ემბედინგები: ხელოვნური ინტელექტის მრავალფუნქციური ინსტრუმენტი სემანტიკური ძიებისთვის
ეს სტატია განმარტავს „ემბედინგების“ კონცეფციას – ინფორმაციის (ტექსტი, სურათი, აუდიო) რიცხვით წარმოდგენას, რომელიც მის სემანტიკურ მნიშვნელობას იჭერს. განხილულია ემბედინგების ძირითადი გამოყენება ხელოვნური ინტელექტის აპლიკაციებში, როგორიცაა საძიებო სისტემები, რეკომენდაციის სისტემები და ჩატბოტები, რაც შესაძლებელს ხდის სემანტიკური მსგავსების შეფასებას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ემბედინგების გენერირება ღია კოდის ინსტრუმენტების, მაგალითად, Sentence Transformers ბიბლიოთეკისა და Hugging

Gemma 3n: მულტიმოდალური AI მოდელი საბოლოოდ ღია კოდის ბიბლიოთეკებში
Google-ის უახლესი მულტიმოდალური AI მოდელი, Gemma 3n, საბოლოოდ ხელმისაწვდომია ყველაზე პოპულარულ ღია კოდის ბიბლიოთეკებში, მათ შორის transformers & timm, MLX, llama.cpp და სხვებში. ეს გამოშვება მოიცავს ორ ზომას (E2B და E4B), რომლებიც გამოირჩევიან მაღალი ეფექტურობით VRAM-ის გამოყენების მხრივ და უზრუნველყოფენ შესანიშნავ ხარისხს. Gemma 3n არა მხოლოდ ენობრივ დეკოდერს, არამედ აუდიო და ვიზუალურ ენკოდერებსაც მოიცავს, რაც მას სრულყოფილ მულტიმოდალურ ინსტრუმენტად აქცევს დეველოპერებისთვის. სტატია დეტალურად აღ
Hugging Face Datasets: ახალი შესაძლებლობები აუდიო და გამოსახულების მონაცემებთან მუშაობისთვის
Hugging Face Datasets ბიბლიოთეკა აფართოებს თავის მხარდაჭერას ტექსტური მონაცემთა ნაკრებების მიღმა, რათა მოიცვას აუდიო და გამოსახულების ფორმატები. განახლებები მოიცავს ახალ ინსტრუმენტებს, როგორიცაა ImageFolder გამოსახულების მონაცემთა ნაკრებების მარტივად ჩატვირთვისა და მართვისთვის, to_tf_dataset ფუნქცია TensorFlow-თან ინტეგრაციის გასამარტივებლად და გაუმჯობესებულ დოკუმენტაციას სხვადასხვა მონაცემთა მოდალობასთან მუშაობისთვის. ეს ცვლილებები მიზნად ისახავს დეველოპერებისთვის მოდელების გაწვრთნისა და აპლიკა

მეტყველების ამოცნობის (ASR) და დიარიზაციის პაიპლაინების დაყენება Hugging Face Inference Endpoints-ზე სპეკულაციური დეკოდირებით
ეს სტატია განმარტავს, თუ როგორ ხდება მეტყველების ავტომატური ამოცნობის (ASR), დიარიზაციისა და სპეკულაციური დეკოდირების მოდულარული პაიპლაინების კონფიგურაცია Hugging Face Inference Endpoints-ის გამოყენებით. ის დეტალურად აღწერს Pyannote მოდელის ინტეგრაციას დიარიზაციისთვის, Flash Attention 2-ის გამოყენებას და ინფერენსის დაჩქარების ტექნიკებს, ასევე კონფიგურაციის მოქნილობას და წარმადობის გაუმჯობესებას სხვადასხვა აუდიო სიგრძისთვის.
OpenAI-ის „Whisper“: გარღვევა მეტყველების ამოცნობის ტექნოლოგიაში
OpenAI-ის მიერ 2022 წლის სექტემბერში გამოქვეყნებული „Whisper“ არის წინასწარ გაწვრთნილი მოდელი მეტყველების ავტომატური ამოცნობისთვის (МАА). ის იყენებს 680,000 საათის უზარმაზარ მარკირებულ აუდიო-ტრანსკრიფციის მონაცემთა ნაკრებს, მათ შორის მრავალენოვან მონაცემებს, რათა მიაღწიოს მოწინავე შედეგებს მეტყველება-ტექსტის კონვერტაციაში 96-ზე მეტ ენაზე, მინიმალური დამატებითი დაზუსტებით.