
PyTorch-ის წინასწარი (AoT) კომპილაცია ZeroGPU Spaces-ში: მაქსიმალური სისწრაფე და ეფექტურობა
PyTorch-ის წინასწარი (AoT) კომპილაცია მნიშვნელოვან უპირატესობას ანიჭებს ZeroGPU Spaces-ს, სადაც ტრადიციული Just-in-Time (JIT) კომპილაცია არაეფექტურია პროცესების ხანმოკლე სიცოცხლის ხანგრძლივობის გამო. AoT საშუალებას აძლევს მომხმარებლებს, ერთხელ მოახდინონ მოდელების ოპტიმიზაცია და მყისიერად გადატვირთონ ისინი, რაც იწვევს დემოების 1.3-დან 1.8-ჯერ დაჩქარებას და გაუმჯობესებულ მომხმარებლის გამოცდილებას. ეს პოსტი განმარტავს AoT-ის ინტეგრაციას ZeroGPU-ში, მოიცავს მოწინავე ტექნიკებს, როგორიცაა FP8 კვანტიზა

ტექსტის გენერაციის ოპტიმიზაცია Intel Gaudi-ზე: ასისტენტული დეკოდირება და სპეკულაციური სემპლინგი
სტატია განიხილავს ტექსტის გენერაციისთვის ინფერენსის აუცილებელ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს დაყოვნების, ხარჯებისა და ენერგომოხმარების შემცირებას, რაც აუმჯობესებს მომხმარებლის გამოცდილებას. ხაზგასმულია ასისტენტული დეკოდირება, რომელიც ადაპტირებულია Intel Gaudi-სთვის (Nvidia H100-ის მსგავსი წარმადობით Nvidia A100 80GB-ის ფასად) და სპეკულაციური სემპლინგი, რომელსაც შეუძლია 2-ჯერამდე დაჩქარება მოუტანოს დიდ ტრანსფორმატორულ მოდელებს, შერჩევის ხარისხის შენარჩუნებით. ეს ნაშრომი ინტეგრირებულია Opt

AI მოდელების ლოკალური ოპტიმიზაცია Intel-ის აპარატურაზე: OpenVINO და Optimum Intel-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების საკუთარ მოწყობილობაზე გაშვება, მიუხედავად მათი გამოთვლითი სირთულისა, მნიშვნელოვან უპირატესობებს გვთავაზობს, მათ შორის გაუმჯობესებულ კონფიდენციალურობასა და სიჩქარეს. ეს სტატია განმარტავს, თუ როგორ შეიძლება მოდელების ოპტიმიზაცია Optimum Intel-ისა და OpenVINO-ს, ასევე მცირე ზომის მოდელების, როგორიცაა SmolVLM, გამოყენებით. ნაბიჯ-ნაბიჯ განხილულია კვანტიზაციის (Weight-only და Static) ტექნიკა, რაც ხელს უწყობს მეხსიერების შემცირებას და ინფერენსის დაჩქარებას, ძვირადღირებული
ProtST-ის განლაგება და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე: უმაღლესი სიჩქარე ცილის მოდელირებისთვის
ცილოვანი ენის მოდელები (PLM-ები), კერძოდ ProtST, ცილის სტრუქტურისა და ფუნქციის პროგნოზირების მძლავრი საშუალებაა. Intel-მა და MILA-მ ProtST, მულტიმოდალური ენის მოდელი, ICML 2023-ზე წარადგინეს, რომელმაც სწრაფად მოიპოვა აღიარება. ამ სტატიაში განხილულია, თუ როგორ ხდება ProtST-ის ეფექტური ინფერენსი და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე. შედეგები აჩვენებს 1.76-ჯერ დაჩქარებას ინფერენსისთვის და 2.92-ჯერ დაჩქარებას დამატებითი წვრთნისთვის NVIDIA A100-თან შედარებით, გაუმჯობესებული ხელმისაწვდომ
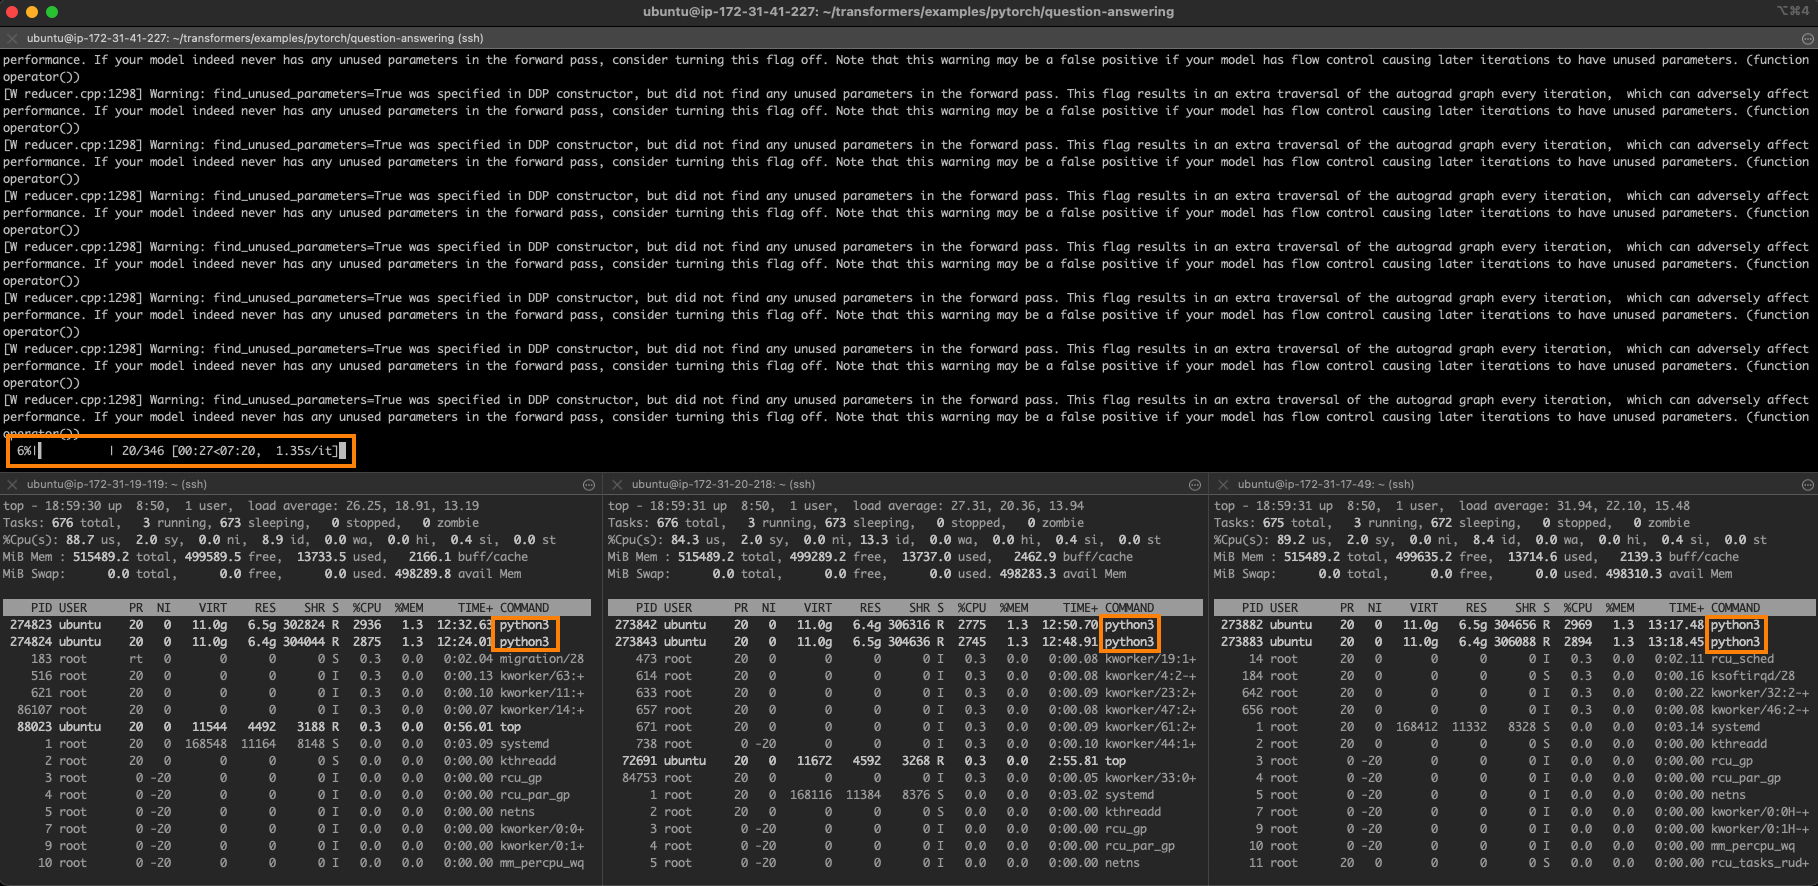
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო
PyTorch-ის ტრენინგის დაჩქარება AWS-ზე Sapphire Rapids სერვერებით
ეს პოსტი აღწერს, თუ როგორ უნდა დააჩქაროთ PyTorch-ის ტრენინგის სამუშაოები AWS-ზე Sapphire Rapids სერვერების კლასტერის გამოყენებით. სტატია დეტალურად განიხილავს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას განაწილებული ტრენინგისთვის და ახალი CPU ინსტრუქციების ოპტიმიზაციისთვის. ასევე ხაზგასმულია Intel Xeon CPU-ების ღირებულებითი ეფექტურობა, მასშტაბურობა და მოწინავე ფუნქციები (AVX-512, Hyper-Threading, AMX) ღრმა სწავლის მოდელების
Google Cloud TPUs-ის ხელმისაწვდომობა Hugging Face-ზე: განცხადება და შემდგომი შეჩერება
Google Cloud TPUs-ის Hugging Face-ის Inference Endpoints-სა და Spaces-ზე ხელმისაწვდომობის შესახებ გაკეთდა განცხადება, რაც ხელოვნური ინტელექტის აპლიკაციების დაჩქარებას გვპირდებოდა. თუმცა, ამ ფუნქციის დანერგვიდან მალევე, ის დროებით შეჩერდა. ეს ინტეგრაცია მიზნად ისახავდა Google-ის ხელოვნური ინტელექტის აპარატურის, რომელიც ცნობილია თავისი მაღალი წარმადობითა და ეკონომიურობით, Hugging Face-ის მომხმარებლებისთვის მიწოდებას, მაგრამ ამჟამად მიუწვდომელია.

Meta-PyTorch და Hugging Face OpenEnv Hub-ს წარადგენენ: ახალი ერა აგენტურ AI-ში
Meta-PyTorch-ისა და Hugging Face-ის პარტნიორობით, დაიწყო OpenEnv Hub-ის პროექტი, რომელიც მიზნად ისახავს აგენტური ხელოვნური ინტელექტის (AI) განვითარების სტანდარტიზებასა და დაჩქარებას. OpenEnv Hub არის საერთო სივრცე დეველოპერებისთვის, სადაც მათ შეუძლიათ შექმნან, გააზიარონ და გამოიკვლიონ OpenEnv-თან თავსებადი გარემოები AI აგენტების წვრთნისა და განლაგებისთვის. ეს ინიციატივა მნიშვნელოვნად გაამარტივებს AI აგენტების უსაფრთხო, მკაფიო და მასშტაბირებად განვითარებას, აწვდის მათ საჭირო ხელსაწყოებსა და კონტე
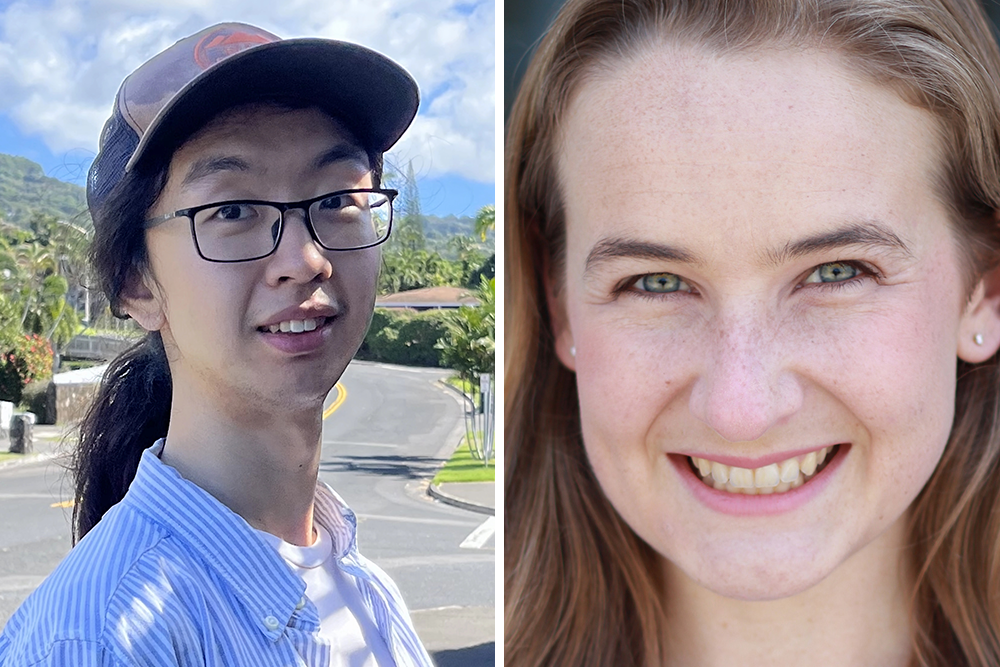
MIT-ის ცხრა თანამშრომელი და კურსდამთავრებული AI2050 Fellows პროგრამის 2025 წლის მონაწილეებად დასახელდნენ
მასაჩუსეტსის ტექნოლოგიური ინსტიტუტის (MIT) ორი ამჟამინდელი თანამშრომელი – ზონგი ლი და ტეს სმიდტი – და შვიდი კურსდამთავრებული 2025 წლის AI2050 Fellows პროგრამის მონაწილეებად დასახელდნენ. ეს პრესტიჟული სტიპენდია, რომელიც Schmidt Sciences-ის მიერ არის დაფუძნებული, მიზნად ისახავს ხელოვნური ინტელექტის (AI) სფეროში მნიშვნელოვანი პრობლემების გადაჭრას და მეცნიერული მიღწევების დაჩქარებას, რათა AI-ის სარგებელი საზოგადოებისთვის 2050 წლისთვის მაქსიმალური გახდეს.
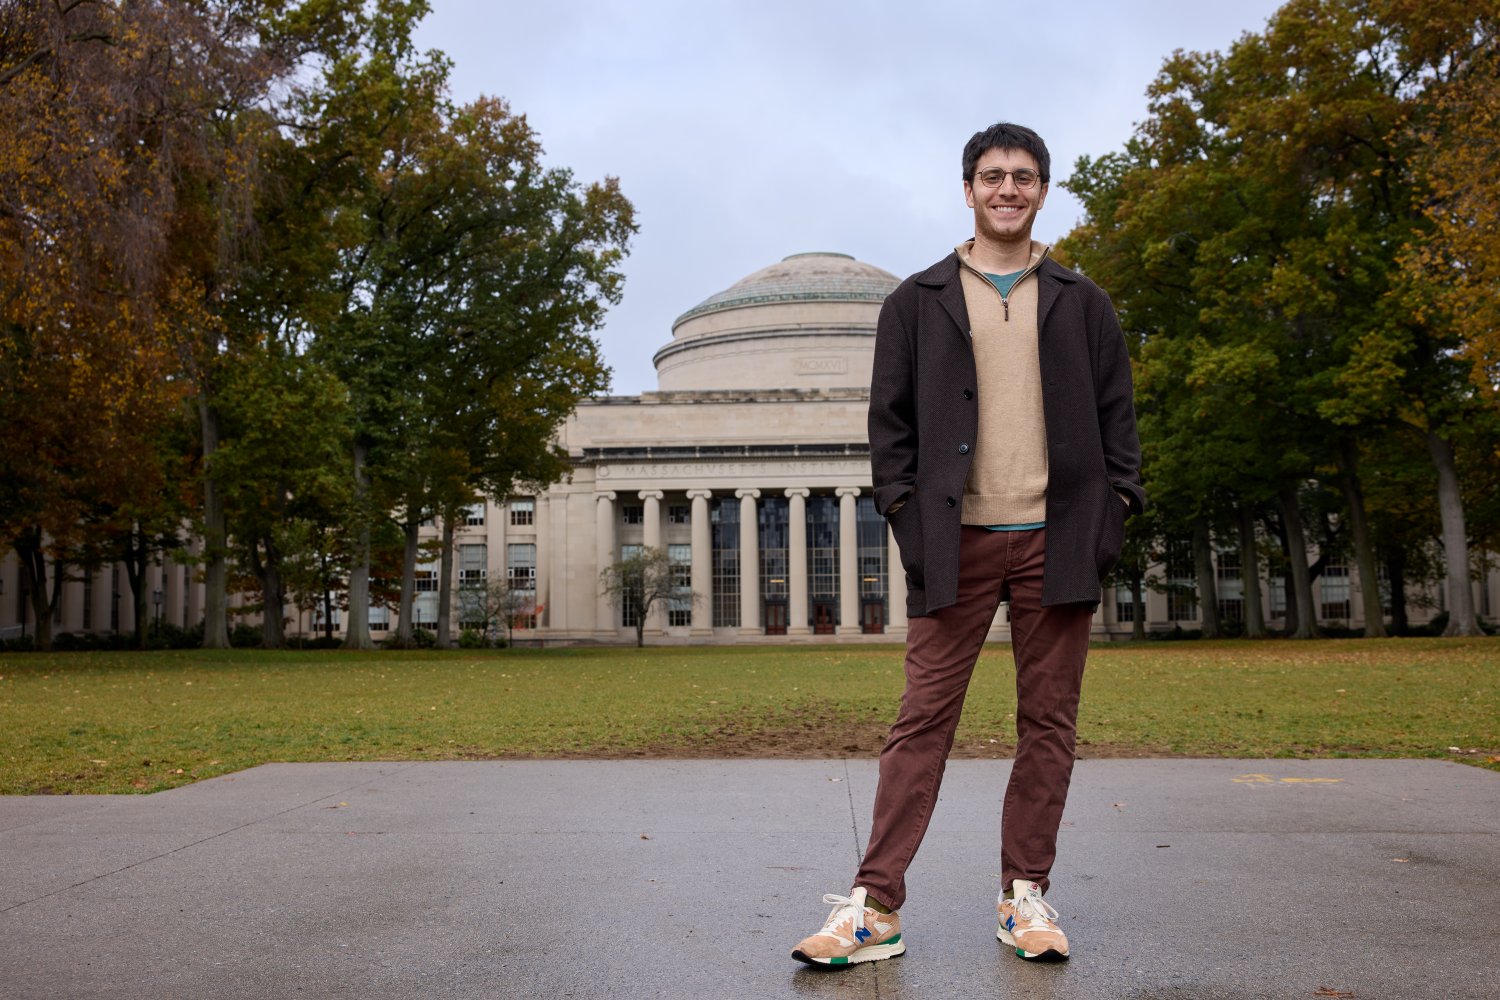
MIT-ის დოქტორანტი ბენჯამინ მენინგი ხელოვნური ინტელექტის გავლენას სამუშაოს მომავალზე იკვლევს
MIT-ის სლოანის მენეჯმენტის სკოლის დოქტორანტი ბენჯამინ მენინგი იკვლევს, თუ როგორ აყალიბებს ხელოვნური ინტელექტი მომავალს, გავლენას ახდენს ადამიანის გადაწყვეტილებებზე, ბაზრებსა და ინსტიტუტებზე. მისი კვლევა მოიცავს ხელოვნური ინტელექტის აგენტების შექმნას, რომლებიც ადამიანების სახელით მოქმედებენ და მიზნად ისახავს სოციალურ მეცნიერებაში აღმოჩენების დაჩქარებას AI სიმულაციების მეშვეობით.

WordPress-ის ინოვაცია: ხელოვნური ინტელექტი დეველოპმენტს აჩქარებს
WordPress-მა წარმოადგინა ინოვაციური AI აგენტი [AI agent] ფუნქცია, რომელიც დეველოპერებს კოდის ტესტირების პროცესის დაჩქარებაში დაეხმარება. ეს ახალი ფუნქციონალი მნიშვნელოვნად გაამარტივებს WordPress-ის გარემოში ექსპერიმენტებსა და შეცდომების გამოსწორებას, რაც პროექტების განვითარებას ახალ დონეზე აიყვანს.