
ხელოვნური ინტელექტის კოდირების ხელსაწყოები: დაპირება და რეალობა არაპროგრამისტის თვალით
გენერაციული ხელოვნური ინტელექტის კოდირების ხელსაწყოები, როგორიცაა Cursor და Replit, მნიშვნელოვან წარმატებას აღწევს საწარმოებში, რადგანაც მათ შეუძლიათ პროგრამისტების შრომა მნიშვნელოვნად შეამცირონ. ამ სტატიაში ავტორი, რომელსაც პროგრამირების მცირე ცოდნა აქვს, ცდილობს შექმნას აპლიკაცია ამ ხელსაწყოების გამოყენებით. ის აღწერს როგორც დადებით მხარეებს – ავტომატურ დავალებებსა და ბუნებრივი ენის გამოყენებით მუშაობას – ასევე გამოწვევებს, როგორიცაა ბრძანების ხაზთან მუშაობის აუცილებლობა, ღრუბლოვანი სერვისების

ZDNET-ის რჩევები: როგორ გავწმინდოთ ქეში iPad-ზე და გავაუმჯობესოთ მუშაობა
ZDNET, რომელიც თავის რეკომენდაციებს ეფუძნება მრავალსაათიან ტესტირებასა და დამოუკიდებელ კვლევას, განმარტავს საკუთარი სარედაქციო პროცესის გამჭვირვალობას და ხაზს უსვამს მკითხველისთვის ზუსტი ინფორმაციის მიწოდების მნიშვნელობას. ამ კონტექსტში, სტატია აგრძელებს დეტალური სახელმძღვანელოთი, თუ როგორ უნდა მოხდეს iPad-ის ქეშის ეფექტურად გასუფთავება, რათა გათავისუფლდეს მეხსიერება და მნიშვნელოვნად გაუმჯობესდეს მოწყობილობის მუშაობა. განხილულია ქეშის წმენდის მეთოდები Safari-ში, Chrome-ში და სხვა აპლიკაციებში iP
Core ML-ის ოპტიმიზაცია: Apple-ის მოწყობილობებზე AI მოდელების მუშაობის ახალი დონე
Core ML-ის უახლესი გაუმჯობესებები მნიშვნელოვნად აჩქარებს ხელოვნური ინტელექტის (AI) მოდელების, მათ შორის Stable Diffusion-ისა და დიდი ენის მოდელების, მუშაობას Apple-ის მოწყობილობებზე. ეს ოპტიმიზაციები, რომელიც მოიცავს 6-ბიტიან პალეტიზაციას და ml-stable-diffusion რეპოზიტორიუმის განახლებას, უზრუნველყოფს მონაცემთა ნაკლებ გადაცემას, მეტ კონფიდენციალურობას და ხარჯების დაზოგვას, რაც დეველოპერებს აძლევს საშუალებას, შექმნან უფრო ეფექტური აპლიკაციები უშუალოდ მოწყობილობაზე.

SmolVLM-256M და SmolVLM-500M: მსოფლიოს ყველაზე პატარა ხედვის ენის მოდელები
კომპანიამ SmolVLM ოჯახის ორი ახალი წევრი, SmolVLM-256M და SmolVLM-500M, წარადგინა. 256 მილიონი პარამეტრის მქონე მოდელი მსოფლიოში ყველაზე პატარა ხედვის ენის მოდელია. ახალი მოდელები ეფუძნება SmolVLM 2B-დან მიღებულ გამოცდილებას, აქცენტი კეთდება ეფექტურობაზე, მონაცემთა ნარევებზე და დიზაინის ახალ კომპრომისებზე. ისინი ინარჩუნებენ მძლავრ მულტიმოდალურ მუშაობას გაცილებით მცირე ზომებში და მარტივად ინტეგრირდება არსებულ სისტემებში. ეს მოდელები განკუთვნილია როგორც შეზღუდული მოწყობილობებისთვის, ასევე დიდი მოც
Stable Diffusion XL Core ML-ზე: მოდელის ზომის შემცირება და მუშაობის გაუმჯობესება
Hugging Face-ი და Apple-ი აგრძელებენ ხელოვნური ინტელექტის მოდელების ოპტიმიზაციას სამომხმარებლო მოწყობილობებზე ადგილობრივად გასაშვებად. უახლესი მცდელობა Stable Diffusion XL-ის Core ML-ზე ადაპტაციაა Apple Silicon-ის Mac-ებისთვის, რაც საშუალებას იძლევა მოდელი შემცირდეს ზომით და გაუმჯობესდეს მისი მუშაობა ინოვაციური კვანტიზაციის მეთოდებით, მათ შორის შერეული ბიტების პალეტიზაციით. პროექტი სრულად ღია კოდით არის ხელმისაწვდომი და community-ის ჩართულობას ელის.
მოწინავე ჰიპერპარამეტრების ოპტიმიზაცია Hugging Face Transformers-თან და Ray Tune-თან ერთად
მანქანური სწავლების მოდელების ეფექტურობის გასაუმჯობესებლად აუცილებელია ჰიპერპარამეტრების დარეგულირება, თუმცა ხშირად მას სათანადო ყურადღება არ ექცევა. Hugging Face Transformers-ის 3.1 ვერსიაში Hugging Face Transformers-მა და Ray Tune-მა გააერთიანეს ძალები, რათა შემოგვთავაზონ მარტივი, მაგრამ მძლავრი ინტეგრაცია. ეს გადაწყვეტა უზრუნველყოფს მოწინავე ოპტიმიზაციის ალგორითმებზე მარტივ წვდომას, როგორიცაა PBT, HyperBand და ბაიესური ოპტიმიზაცია, რაც მნიშვნელოვნად აუმჯობესებს მოდელების მუშაობას და ინარჩუნებ
DeepFloyd IF-ის ინტეგრაცია BentoML-თან პროდუქტიული განთავსებისთვის
სტატია მიმოიხილავს, თუ როგორ ხდება BentoML-ის, ღია კოდის პლატფორმის, გამოყენება DeepFloyd IF-ის, თანამედროვე ტექსტიდან გამოსახულების გენერირების მოდელის, განთავსებისთვის. აღწერილია DeepFloyd IF-ის უნიკალური არქიტექტურა (პიქსელურ სივრცეში მუშაობა, კასკადური დიფუზია, LLM-ის გამოყენება მოთხოვნებისთვის) და BentoML-ის მეშვეობით რესურსების ოპტიმალური მართვა, მათ შორის GPU-ს განაწილება. მოცემულია ინსტრუქციები პროექტის ლოკალურად გაშვებისთვის, მოდელების ჩამოტვირთვისთვის, სერვერის Gradio-სთან ერთად გაშვებ
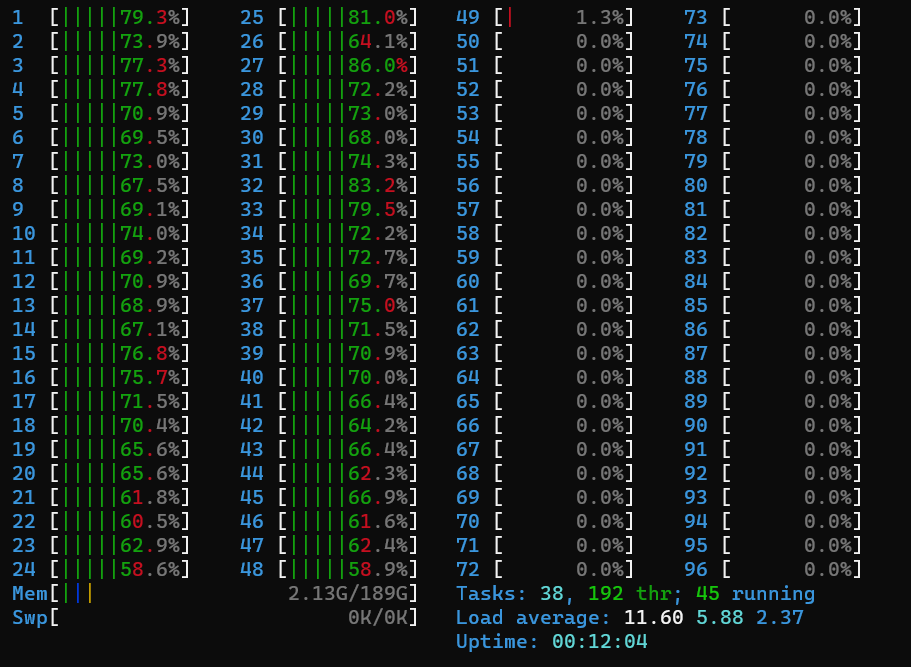
Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.

Hugging Face-ის მუშაობა ხელოვნური ინტელექტის ეთიკაზე: რეგულაციების ფორმირება და ღიაობის ხელშეწყობა
Hugging Face დეტალურად აღწერს თავის ფართომასშტაბიან მუშაობას ხელოვნური ინტელექტის ეთიკის სფეროში, მათ შორის ევროკავშირის, დიდი ბრიტანეთისა და აშშ-ის კანონმდებლებთან თანამშრომლობას მომავალი რეგულაციების ჩამოსაყალიბებლად. კომპანია ხაზს უსვამს ღიაობის, ანგარიშვალდებულებისა და დემოკრატიზაციისადმი თავის ერთგულებას საჯარო გამოსვლებით, კვლევებითა და ახალი რესურსებით, რითაც ხაზგასმულია ადამიანური ღირებულებების ცენტრალური როლი პასუხისმგებლიანი ხელოვნური ინტელექტის განვითარებაში. ასევე აღინიშნება გუნდის მ
ჩატის მოდელების ეფექტურობის გასაღები: ფორმატის მნიშვნელობა და Jinja შაბლონები
ეს სტატია განმარტავს, თუ რამდენად კრიტიკულია ჩატის ფორმატის შეხამება იმ ფორმატთან, რომელზეც ხელოვნური ინტელექტის მოდელები იყო გაწვრთნილი. არასწორი ფორმატის გამოყენება იწვევს მუშაობის სერიოზულ, ჩუმ გაუარესებას. Hugging Face-ის ტოკენიზატორების ახალი `chat_template` ატრიბუტი, რომელიც Jinja შაბლონებს იყენებს, მიზნად ისახავს ამ პრობლემის გადაჭრას საუბრების სწორად ფორმატირებით, რითაც უზრუნველყოფს მოდელის ოპტიმალურ მუშაობას და ხელს უშლის „განაწილების ცვლილებას“.

ONNX Runtime Hugging Face-ის მოდელების მუშაობას აუმჯობესებს
ONNX Runtime არის კროს-პლატფორმული ინსტრუმენტი, რომელიც აჩქარებს მანქანური სწავლების მოდელებს, განსაკუთრებით ONNX-ის მხარდაჭერით. Hugging Face-ზე, ღია კოდის პლატფორმაზე, 130 000-ზე მეტი ასეთი მოდელია, მათ შორის დიდი ენობრივი (LLM) და ღრუბლოვანი მოდელები, რომლებსაც შეუძლიათ მნიშვნელოვნად გააუმჯობესონ მუშაობა ONNX Runtime-ის მეშვეობით. მაგალითად, whisper-tiny მოდელის დაჩქარება PyTorch-თან შედარებით 74.30%-მდე ეფექტურობას იძლევა. ONNX Runtime მჭიდროდ თანამშრომლობს Hugging Face-თან 90-ზე მეტი არქიტე
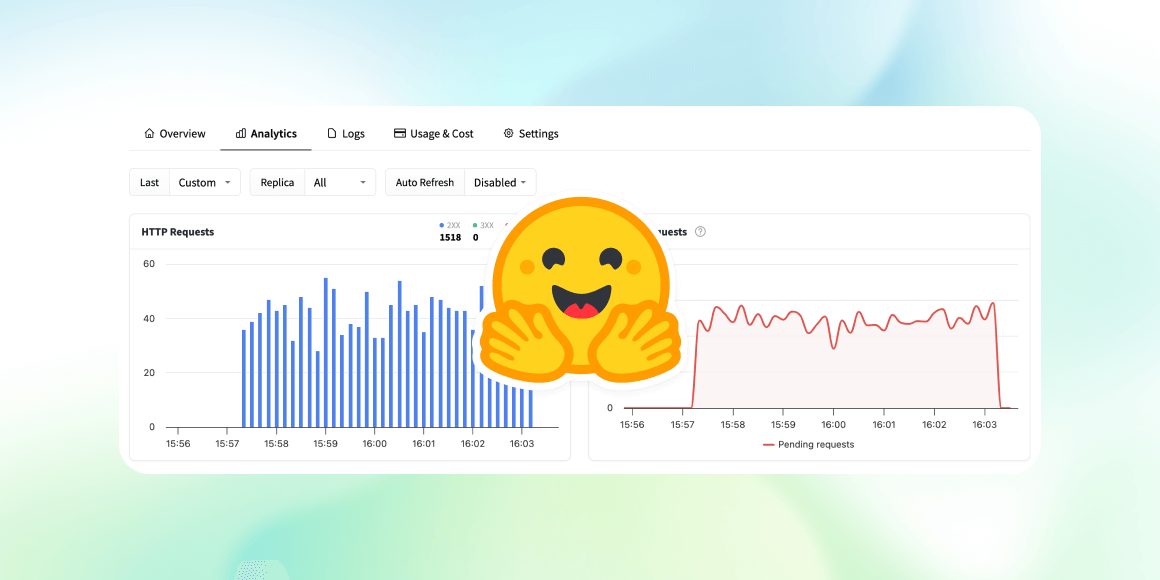
ანალიტიკის დაფის განახლება: რეალურ დროში მონაცემები, კონფიგურირებადი დიაპაზონები და რეპლიკების სასიცოცხლო ციკლის ხედვა
გამოქვეყნდა მნიშვნელოვანი განახლებები ანალიტიკის დაფაზე, რომელიც ახლა მოიცავს რეალურ დროში მეტრიკას, კონფიგურირებად დროის დიაპაზონებს ავტომატური განახლებით და რეპლიკების სასიცოცხლო ციკლის დეტალურ ხედვას. ეს გაუმჯობესებები მომხმარებლებს საშუალებას აძლევს, უფრო ეფექტურად აკონტროლონ და გამართონ ინფერენსის ბოლო წერტილების მუშაობა, მიიღონ მყისიერი ინფორმაცია და თვალყური ადევნონ პროცესებს.

TGI ახლა პირდაპირ მხარს უჭერს Intel Gaudi აპარატურას
გაცხადდა Intel Gaudi აპარატურის სრული ინტეგრაცია TGI-ის ძირითად კოდბაზაში, რაც გამორიცხავს ცალკეული „ფორკების“ საჭიროებას. ეს ახალი მრავალბექენდური არქიტექტურა ამარტივებს გამოყენებას, უზრუნველყოფს TGI-ის უახლეს ფუნქციებზე წვდომას და ოპტიმიზაციას უკეთებს დიდი ენობრივი მოდელების (LLMs) მუშაობას Gaudi მოწყობილობებზე. განცხადება ასევე ხაზს უსვამს მოწინავე ფუნქციებს, მოსალოდნელ მოდელებს და საზოგადოებისგან უკუკავშირის მიღების მოწვევას.

Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ

ხილვად-ენობრივი მოდელების ტრანსფორმაცია: ბოლო ერთი წლის მიღწევები
სტატია მიმოიხილავს ხილვად-ენობრივი მოდელების (VLMs) განვითარებას ბოლო ერთი წლის განმავლობაში, LLaVA-ს თავდაპირველი წარმატებიდან უფრო მძლავრი, კომპაქტური და მრავალფეროვანი არქიტექტურების გამოჩენამდე. განხილულია ახალი პარადიგმები, როგორიცაა 'ნებისმიერი-ნებისმიერზე' (any-to-any) მოდელები, მულტიმოდალური RAG, მსჯელობის მოდელები და მცირე ზომის VLMs-ის ტენდენცია, რომლებსაც შეუძლიათ სამომხმარებლო მოწყობილობებზე მუშაობა.

„პატარა აგენტები“ პითონში: ახალი ეპოქა LLM-ების და ინსტრუმენტების ურთიერთქმედებაში
ეს ბლოგპოსტი წარმოგიდგენთ „პატარა აგენტების“ (Tiny Agents) პითონზე პორტირებას, სადაც `huggingface_hub` კლიენტის SDK გაფართოვდა, რათა იმოქმედოს როგორც MCP კლიენტი. მთავარი სიახლეა MCP (მოდელის კონტექსტის პროტოკოლი), ღია სტანდარტი, რომელიც აერთიანებს დიდი ენობრივი მოდელების (LLM) გარე ინსტრუმენტებთან და API-ებთან ურთიერთქმედებას, რითაც აღარ საჭიროებს ყოველი ინსტრუმენტისთვის მორგებულ ინტეგრაციებს. სტატია განმარტავს, თუ როგორ უნდა დაიწყოთ მუშაობა პითონის აგენტებთან, რომლებიც დაკავშირებულია MCP სერვე
Gradio 3.0 და Gradio Blocks: მანქანური სწავლების დემოების შექმნის რევოლუცია
2019 წლიდან Gradio-ს ბიბლიოთეკით 600 000-ზე მეტი მანქანური სწავლების დემო აშენდა. დღეს წარმოდგენილია Gradio 3.0, რომელიც მოიცავს ფრონტენდის სრულ განახლებას, თანამედროვე ტექნოლოგიების (როგორიცაა Svelte) გამოყენებით, რამაც გამოიწვია სწრაფი მუშაობა და დახვეწილი ვიზუალური ესთეტიკა. გარდა ამისა, ახალი დაბალდონიანი ენა, Gradio Blocks, დეველოპერებს საშუალებას აძლევს შექმნან კომპლექსური, მორგებული ვებ აპლიკაციები უშუალოდ Python-ში, რაც უზრუნველყოფს განლაგებისა და მონაცემთა ნაკადზე მეტ კონტროლს. ამ მოვლე

ხელოვნური ინტელექტის აგენტების ევოლუცია: სტრუქტურული კოდის გენერაციის უპირატესობა
კვლევა იკვლევს ხელოვნური ინტელექტის აგენტების არქიტექტურის ევოლუციას, ადარებს ტრადიციულ JSON აგენტებს, CodeAgent-ებს და ახალ სტრუქტურულ CodeAgent-ებს. ეს უკანასკნელი აერთიანებს კოდის მოქნილობასა და სტრუქტურული გამომავალი მონაცემების სანდოობას, რაც მნიშვნელოვნად ამცირებს ანალიზის (parsing) შეცდომებს და აუმჯობესებს აგენტების მუშაობას. ნაჩვენებია, რომ სტრუქტურული გენერაცია აიძულებს აგენტებს, უფრო მკაფიოდ გამოხატონ თავიანთი მსჯელობა, თუმცა აღინიშნება, რომ ამ მიდგომის სრული პოტენციალი ვლინდება მაღალი
AI აგენტების ევოლუცია: სტრუქტურირებული კოდის მოქმედებების უპირატესობა
ხელოვნური ინტელექტის აგენტების მოქმედებების გამოხატვის მეთოდები ევოლუციას განიცდის, ტრადიციული JSON აგენტებიდან კოდის აგენტებამდე. უახლესი კვლევა ხაზს უსვამს სტრუქტურირებული CodeAgent-ების უპირატესობას, რომლებიც აერთიანებენ კოდის მოქნილობასა და სტრუქტურირებული გენერაციის საიმედოობას. ეს ინოვაციური მიდგომა მნიშვნელოვნად ამცირებს პარსინგის შეცდომებს, აუმჯობესებს აგენტების მუშაობას 2-7 პროცენტული პუნქტით ძლიერ მოდელებში და აიძულებს მათ მოქმედებამდე არტიკულირონ თავიანთი მსჯელობა. თუმცა, აღინიშნა, რო

Gradio MCP სერვერების მასშტაბური განახლება: ვერსია 5.38.0-ის ახალი ფუნქციები
Gradio-მ გამოუშვა MCP სერვერების 5.38.0 ვერსია, რომელსაც ემატება მნიშვნელოვანი გაუმჯობესებები. ახლა შესაძლებელია ფაილების პირდაპირი ატვირთვა, AI ამოცანების პროგრესის რეალურ დროში მონიტორინგი, API-ების ავტომატური ინტეგრაცია OpenAPI-ის მეშვეობით, გაუმჯობესებული აუთენტიფიკაცია და ხელსაწყოების აღწერის მორგება. ეს განახლება დეველოპერებს მუშაობას უმარტივებს და ზრდის Gradio აპლიკაციების შესაძლებლობებს.
ენის დიდი მოდელების ოპტიმიზაცია: Hugging Face-ის LLM.int8() ინტეგრაცია
ენის დიდი მოდელები (LLM) მუდმივად იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა, BigScience-თან თანამშრომლობით, წარმოადგინა LLM.int8() ინტეგრაცია, რომელიც საშუალებას აძლევს ამ მასშტაბურ მოდელებს იმუშაონ ნაკლებ GPU-ზე, მეხსიერების მოხმარების 2-ჯერ შემცირებით, პროგნოზირების სიზუსტის შენარჩუნებით. სტატია დეტალურად განიხილავს ამ ტექნოლოგიას და სხვადასხვა მცოცავწერტილიანი მონაცემთა ტიპებს, რომლებიც მოდელის ზომასა და მუშაობაზე ახდენენ გავლენას.
ხელოვნური ინტელექტი: როგორ მოვამზადოთ BERT მოდელი Habana Gaudi-ზე AWS-ის გამოყენებით
Google AI Language-ის მიერ შემუშავებული BERT მოდელის წინასწარი ვარჯიში, რომელიც გადამწყვეტია ბუნებრივი ენის დამუშავებისთვის, მოითხოვს მონაცემთა ეფექტურ მომზადებას და ტოკენიზაციას. ეს სტატია განმარტავს პროცესს, მათ შორის CPU-ინტენსიური ამოცანების ოპტიმიზაციას და Habana Gaudi-ს ინსტანციების გამოყენებას AWS-ზე განაწილებული ვარჯიშისთვის, რაც აუმჯობესებს მოდელის მუშაობას.
დიდი ენობრივი მოდელები ჯანდაცვაში: პოტენციალი, გამოწვევები და შეფასების პლატფორმა
დიდი ენობრივი მოდელები (LLM) უდიდეს პოტენციალს ფლობს ჯანდაცვის სფეროს რევოლუციონიზაციისთვის, თუმცა მათ გამოყენებას თან ახლავს სერიოზული გამოწვევები სიზუსტისა და სანდოობის კუთხით, რადგან სამედიცინო შეცდომებმა შეიძლება სიცოცხლისთვის საშიში შედეგები გამოიწვიოს. ამ პრობლემების გადასაჭრელად შეიქმნა „Open Medical-LLM Leaderboard“, სტანდარტიზებული პლატფორმა, რომელიც აფასებს და ადარებს LLM-ების მუშაობას სხვადასხვა სამედიცინო ამოცანასა და მონაცემთა ბაზაზე (როგორიცაა MedQA, MedMCQA, PubMedQA, MMLU). მიზან

Hugging Face-ის AI Sheets: ხელოვნური ინტელექტის უკოდო ინსტრუმენტი მონაცემთა ნაკრებების შექმნისა და მართვისთვის
Hugging Face-მა წარმოადგინა AI Sheets – ახალი, ღია წყაროს მქონე უკოდო ინსტრუმენტი, რომელიც მომხმარებლებს საშუალებას აძლევს შექმნან, გაამდიდრონ და გარდაქმნან მონაცემთა ნაკრებები ხელოვნური ინტელექტის მოდელების გამოყენებით. ის ინტეგრირებულია Hugging Face Hub-თან და გთავაზობთ ათასობით ღია მოდელის გამოყენების შესაძლებლობას სწრაფი ექსპერიმენტებისა და მონაცემთა დამუშავებისთვის. ინსტრუმენტი გამოირჩევა მარტივი, ცხრილის მსგავსი ინტერფეისით და ხელს უწყობს ეფექტურ მუშაობას როგორც მცირე, ისე მსხვილ მონაცემთა