
როგორ აუმჯობესებს Capital Fund Management (CFM) ფინანსური მონაცემების ანალიზს Hugging Face-ის დიდი ენობრივი მოდელების (LLM) დახმარებით
Capital Fund Management (CFM), პარიზში დაფუძნებული ალტერნატიული ინვესტიციების მართვის ფირმა, თანამშრომლობს Hugging Face-ის ექსპერტთა მხარდაჭერის გუნდთან, რათა გამოიყენოს ღია წყაროს დიდი ენობრივი მოდელები (LLMs) ფინანსური აპლიკაციებისთვის. თანამშრომლობის მთავარი მიზანია გააუმჯობესოს ფინანსური სუბიექტების ამოცნობა (მაგ., კომპანიების სახელები) საინფორმაციო სტატიებიდან, რაც კრიტიკულია ავტომატიზირებული სავაჭრო სტრატეგიებისთვის. CFM-მა გამოიკვლია LLM-ის დახმარებით დატეგვის, მცირე მოდელების 'fine-tunin
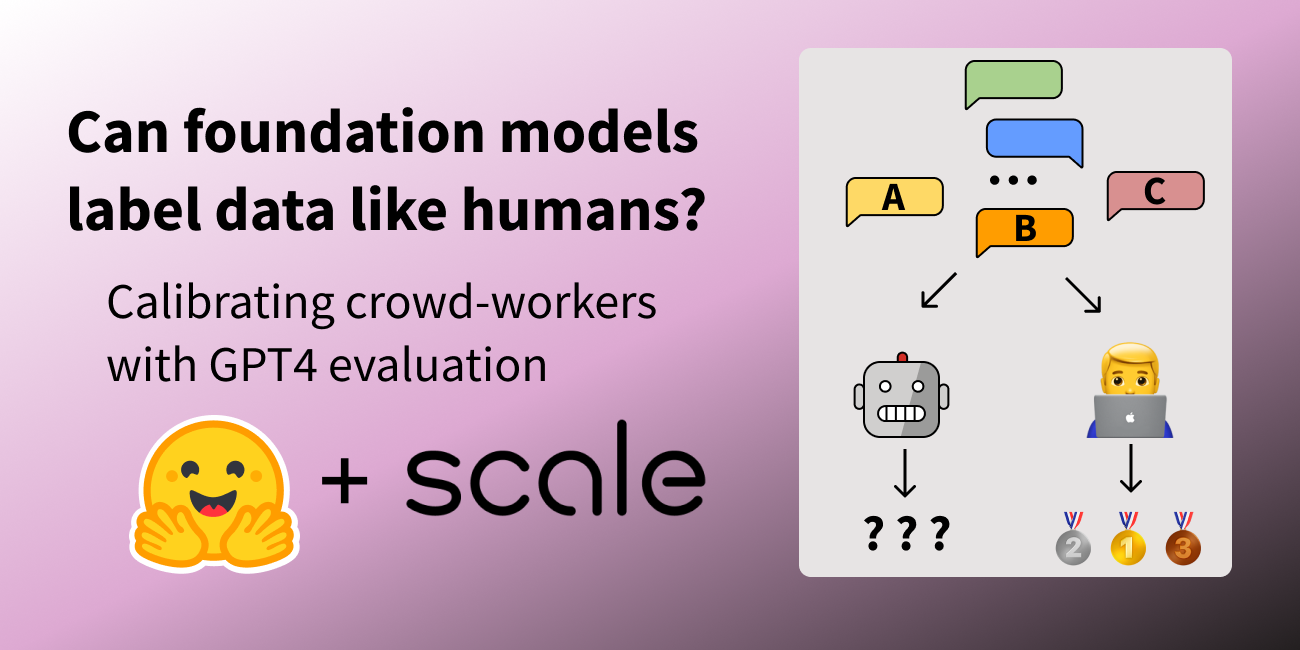
LLM-ების შეფასება: სად შეგვიძლია ვენდოთ მონაცემებს?
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) შეფასების არსებულ გამოწვევებს, განსაკუთრებით GPT-4-ზე დაფუძნებულ მეტრიკაზე დამოკიდებულებას, რაც შესაძლოა სრულად არ ასახავდეს ადამიანურ უპირატესობებს. ხაზგასმულია ადამიანურად მარკირებული მონაცემების მნიშვნელობა რეალური უპირატესობების გასაზომად და წარმოდგენილია Hugging Face Open LLM ლიდერბორდის გაფართოება. ეს გაფართოებული ლიდერბორდი აერთიანებს ავტომატიზებულ აკადემიურ ბენჩმარკებს, პროფესიონალურ ადამიანურ მარკირებას და GPT-4 შეფასებებს, რათა უზრუნველყო
ხელოვნური ინტელექტის შეცდომების გამოსწორება: ინტერაქტიული ასისტენტის ტესტირება Keras Chatbot Arena-ზე
ეს სტატია აღწერს ექსპერიმენტს, რომელიც მიზნად ისახავს შეამოწმოს, რამდენად ეფექტურად შეუძლიათ დიდ ენობრივ მოდელებს (LLM) საკუთარი შეცდომების გამოსწორება მარტივი ინგლისური უკუკავშირის საფუძველზე. ავტორი ქმნის სპეციალურ გარემოს Gradio-ზე Spaces-ით, Keras-ის, JAX-ისა და TPUs-ის გამოყენებით, რათა ერთდროულად რამდენიმე ჩეთბოტთან იმუშაოს და შეაფასოს მათი უნარი, მოახდინონ API ზარების გენერირება და შეასწორონ შეცდომები. განხილულია ტექნიკური დეტალები და მიდგომები მოდელების მრავალ ბირთვზე ოპტიმიზაციისთვის, მ

აგენტური AI-ის პოტენციალის განბლოკვა CPU-ზე: Intel Xeon და AMX-ის როლი
აგენტური ხელოვნური ინტელექტი (AI) AI-ის განვითარების შემდეგ ეტაპად მიიჩნევა, რომელიც LLM-ების მსჯელობის შესაძლებლობებს კონტექსტის ღრმა გაგებასთან აკავშირებს. თუმცა, არსებობს გამოწვევა 'მასპინძელი-აქსელერატორი' ტრაფიკის ზედმეტი დატვირთვის მხრივ, რადგან სისტემებში სულ უფრო მეტი CPU-ზე მომუშავე ხელსაწყო ინტეგრირდება. ამ პრობლემის გადასაჭრელად, მუშავდება მცირე ენობრივი მოდელები (SLM) და CPU-ები, როგორიცაა Intel Xeon-ის მე-4 და მე-5 თაობა, რომლებიც ინტეგრირებულ AMX ტექნოლოგიას გვთავაზობენ AI მუშაობის

ფალკონ3: ხელოვნური ინტელექტის მოდელების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
„ფალკონ3“ წარმოადგენს ხელოვნური ინტელექტის მოდელების ახალ ოჯახს, რომელიც წინა ვერსიების ბუნებრივ ევოლუციას ასახავს. ახალი იტერაცია ფოკუსირებულია მეცნიერების, მათემატიკისა და კოდის შესაძლებლობების გაფართოებაზე, აჩვენებს მაღალ წარმადობას საერთო საორიენტაციო ტესტებზე და მოიცავს ხუთ ძირითად მოდელს ინოვაციური არქიტექტურით. მოდელები გამოქვეყნებულია Falcon LLM ლიცენზიით, რაც ხელს უწყობს ხელოვნური ინტელექტის ხელმისაწვდომობას და თანამშრომლობას, ხოლო 2025 წლის იანვარში მოსალოდნელია მულტიმოდალური შესაძლებლ

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი

ModernBERT: ენკოდერ-მხოლოდ მოდელების ახალი ეპოქა – BERT-ის გაუმჯობესებული და სწრაფი ჩანაცვლება
ModernBERT წარმოადგენს უახლეს, სახელმწიფოებრივ ენკოდერ-მხოლოდ მოდელების ოჯახს, რომელიც მნიშვნელოვნად აუმჯობესებს წინა თაობის ენკოდერებს სიჩქარის, სიზუსტის, კონტექსტის სიგრძის (8192 ტოკენი) და ქვემდებარე ამოცანების შესრულების მხრივ. ის დანერგილია, როგორც BERT-ის პირდაპირი ჩანაცვლება, ხელმისაწვდომია საბაზისო (149M პარამეტრი) და დიდ (395M პარამეტრი) ვერსიებში და აერთიანებს LLM-ების უახლეს მიღწევებს. ModernBERT მიზნად ისახავს გახდეს ახალი სტანდარტი პრაქტიკულ გამოყენებებში, როგორიცაა RAG სისტემები, კ
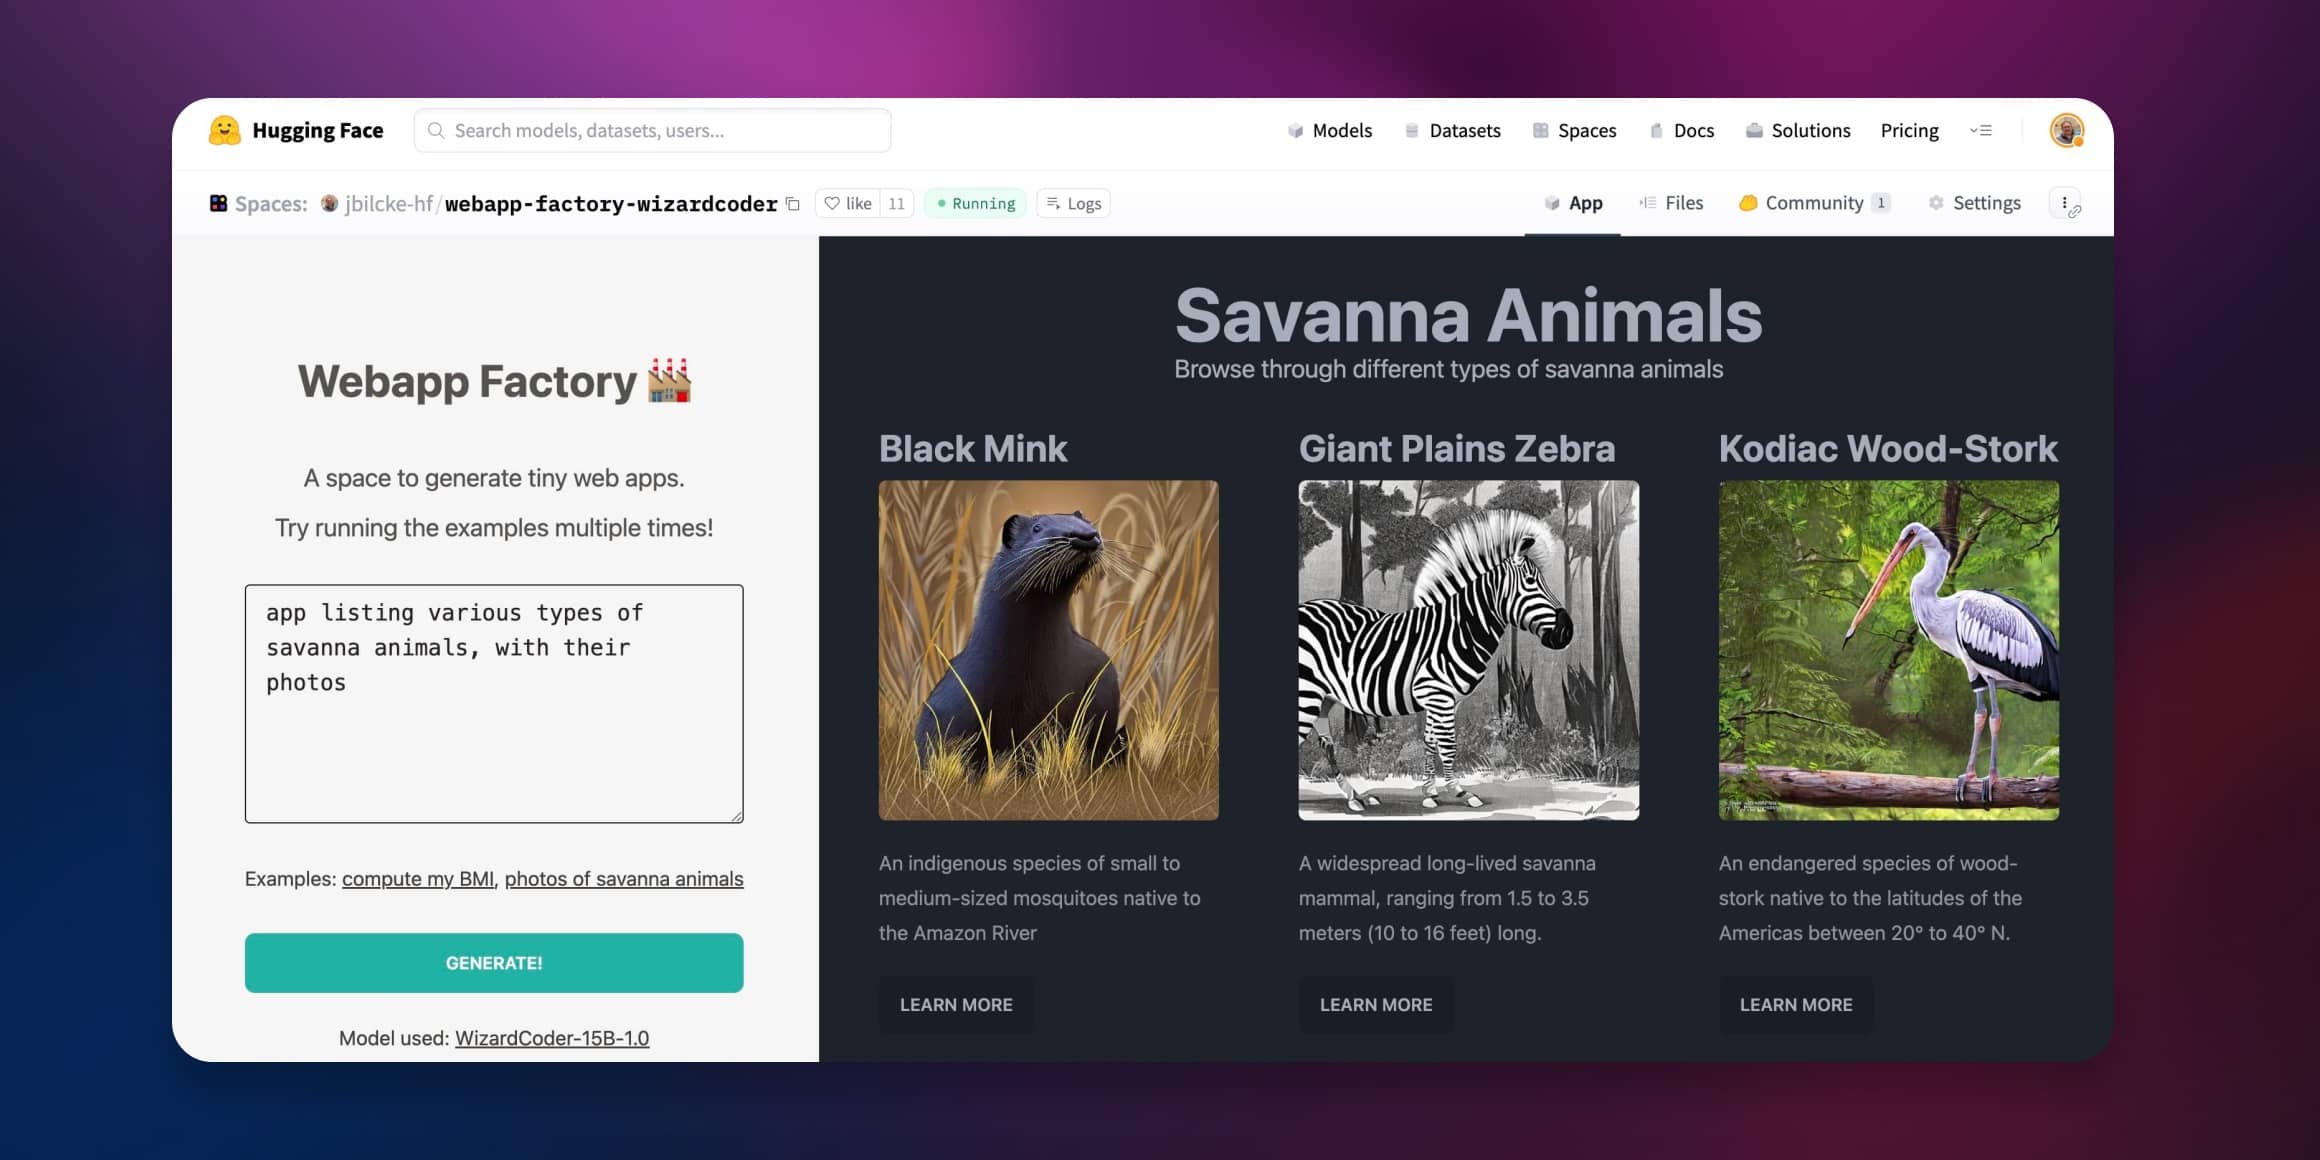
AI ვებ-კონტენტის გენერაცია: Node.js და Hugging Face-ის პირდაპირი მიდგომა
გაეცანით AI ვებ-კონტენტის გენერაციის ინოვაციურ მიდგომას Node.js-ის გამოყენებით, რომელიც უზრუნველყოფს კონტენტის ერთბაშად ნაკადად გადაცემასა და რენდერინგს. ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ დიდი ენობრივი მოდელები (LLM) JavaScript/Node პლატფორმაზე Hugging Face Inference API-ებთან ერთად, აპარატურული აჩქარების, Tailwind CSS-ის, Stable Diffusion-ისა და Alpine.js-ის ინტეგრაციის ჩათვლით.

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერების გამოყენებას PyTorch-ში
ეს სტატია დეტალურად განიხილავს, თუ როგორ უნდა მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია, გაგება და ოპტიმიზაცია PyTorch-ში ტრენინგის დროს. ის ეტაპობრივად ხსნის მეხსიერების განაწილებას მოდელის შექმნის, შეყვანის ტენზორების, Forward/Backward გავლისა და ოპტიმიზატორის ნაბიჯებისთვის, დეტალური მაგალითებისა და პროფაილინგის ხელსაწყოების გამოყენებით. გაანალიზებულია როგორც გამარტივებული, ასევე რეალური LLM-ის ტრენინგის მეხსიერების პროფილი.
როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერებას PyTorch-ში
ეს გაკვეთილი ეტაპობრივად განმარტავს, თუ როგორ მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია და გაგება PyTorch-ში ტრენინგის დროს. ის მოიცავს მეხსიერების მოთხოვნების შეფასებას, გამოყენების ოპტიმიზაციას PyTorch-ის პროფილის ხელსაწყოების მეშვეობით და დეტალურ ანალიზს იმის შესახებ, თუ როგორ იქცევა მეხსიერება მოდელის შექმნის, წინსვლის, უკუგადაცემის და ოპტიმიზატორის ნაბიჯების განმავლობაში, მათ შორის დიდი ენობრივი მოდელების (LLM) რეალურ სცენარებში.
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.

AI აგენტები: LLM-ების შესაძლებლობების გაფართოება რეალურ სამყაროში
ეფექტური AI სისტემები საჭიროებს დიდ ენობრივ მოდელებს (LLM) რეალურ სამყაროზე წვდომას, რაც მათ საშუალებას აძლევს გამოიყენონ საძიებო ინსტრუმენტები ან იმოქმედონ პროგრამებზე. ეს მოქმედების უნარი, ანუ „აგენტურობა“, LLM-ებისთვის გარე სამყაროსთან დამაკავშირებელ ხიდად გვევლინება. სტატია განმარტავს, თუ როგორ აკონტროლებს AI აგენტები LLM-ის შედეგების სამუშაო პროცესს და აღნიშნავს, რომ აგენტურობა არის უწყვეტი სპექტრი. მიუხედავად იმისა, რომ აგენტები სასარგებლოა აპლიკაციის სამუშაო პროცესის მოქნილობისთვის, ისინი
LLM-ების ინფერენციისას ნახშირბადის ემისიების კვლევა: მოულოდნელი აღმოჩენები საზოგადოების მიერ შექმნილ მოდელებში
ბოლო წლებში დიდი ენობრივი მოდელების (LLM) გამოყენების გარემოზე ზემოქმედებაზე ცნობიერება იზრდება. ეს სტატია იკვლევს LLM-ების ინფერენციის ფაზაში ნახშირბადის ემისიებს, წარმოადგენს Open LLM Leaderboard-ში ემისიის შეფასებების ინტეგრაციას და მოულოდნელ აღმოჩენებს, მაგალითად, რომ საზოგადოების მიერ მორგებული მოდელები (community fine-tunes) ხშირად უფრო ნახშირბადეფექტურია, ვიდრე ოფიციალური მოდელები. განხილულია ემისიების ცვლილებები სხვადასხვა მოდელის ტიპისა და ზომის მიხედვით, რაც მიზნად ისახავს მომხმარებლებ
დიდი ენობრივი მოდელების (LLMs) ნახშირბადის კვალი: ოფიციალური ვერსიები vs. საზოგადოებრივი „ფაინ-ტიუნები“
ბოლო ერთი წლის განმავლობაში, გაიზარდა ცნობიერება იმის შესახებ, რომ დიდი ენობრივი მოდელების (LLMs) გამოყენებას ტექსტის გენერირებისთვის მნიშვნელოვანი გარემოსდაცვითი გავლენა აქვს, განსაკუთრებით ინფერენციის ფაზაში. Open LLM Leaderboard-ში ნახშირბადის ემისიების შეფასებების ინტეგრირებით, მიზანია გამჭვირვალობის უზრუნველყოფა და მოდელების შემქმნელების წახალისება, დააბალანსონ შესრულება გარემოსდაცვით პასუხისმგებლობასთან. კვლევამ გამოავლინა, რომ საზოგადოების მიერ შექმნილი „ფაინ-ტიუნები“ ხშირად უფრო ნახშირბა
დიდი ენობრივი მოდელები: ღია წყაროების რევოლუცია ტექსტის გენერაციაში
სტატია მიმოიხილავს ტექსტის გენერაციისა და კონვერსაციული AI ტექნოლოგიების განვითარებას, ადრეული გამოწვევებიდან უახლეს მიღწევებამდე. ხაზგასმულია მომხმარებლისთვის მოსახერხებელი ინტერფეისების, GPT-4-ის მსგავსი მძლავრი მოდელების და Llama 2-ის მსგავსი ღია წყაროების ალტერნატივების მნიშვნელობა. განმარტებულია მიზეზობრივი ენობრივი მოდელები (Causal Language Models) და Text-to-Text მოდელები, ასევე Fine-tuning-ისა და RLHF-ის როლი მათ გაუმჯობესებაში. აღწერილია წამყვანი ღია წყაროების LLM-ები, მათი უპირატესობებ
ხელოვნური ინტელექტის აგენტები: შესაძლებლობები, რისკები და მომავლის ხედვა
ხელოვნური ინტელექტის (AI) დიდი ენობრივი მოდელების (LLMs) სწრაფმა განვითარებამ საფუძველი ჩაუყარა „AI აგენტების“ შექმნას – სისტემებს, რომლებსაც შეუძლიათ ციფრულ სამყაროში ქმედებების დამოუკიდებლად განხორციელება მომხმარებლის მიზნების შესაბამისად. ეს ტექნოლოგია ადამიანის ჩარევის გარეშე მრავალი ამოცანის კომბინირების საშუალებას იძლევა, რაც ფუნდამენტურ ცვლილებას აღნიშნავს ტექნოლოგიურ პარადიგმაში. თუმცა, ჩვენი ანალიზი ცხადყოფს, რომ მისი ავტონომიურობის დონის მატებასთან ერთად, იზრდება უსაფრთხოების რისკებიც,
AI WebTV: ხელოვნური ინტელექტით შექმნილი ვიდეო კონტენტის ინოვაციური პლატფორმა
AI WebTV წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დემონსტრირებს ღია კოდის ტექსტი-ვიდეოდ გადამყვანი მოდელებით, როგორიცაა Zeroscope და MusicGen, გენერირებულ ვიდეოებს. ის შექმნილია მოკლე, ტექნოლოგიური დემო კლიპების სახით, სადაც დიდი ენობრივი მოდელები (LLM), მაგალითად ChatGPT, გამოიყენება ვიდეო კადრებისთვის მრავალფეროვანი მოთხოვნების შესაქმნელად. სისტემა დანერგილია NodeJS-სა და TypeScript-ში, იყენებს Hugging Face-ის სერვისებს და მოიცავს კადრების გაფართოებას FILM ალგორითმით, ასევე მუსიკის დამატებას
Hugging Face-ის TGI წარმოგიდგენთ ახალ Backends არქიტექტურას: გამარტივებული LLM-ების განთავსება და გაუმჯობესებული წარმადობა
Hugging Face-მა წარმოადგინა TGI Backends, ახალი არქიტექტურა Text-Generation-Inference (TGI)-ისთვის, რომელიც მიზნად ისახავს LLM-ების განთავსების პროცესის გამარტივებას და ოპტიმალური წარმადობის უზრუნველყოფას. ეს სიახლე აერთიანებს სხვადასხვა ინფერენსინგის გადაწყვეტებს ერთიან ფრონტენდ ფენაში, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შეცვალონ ბეკენდები მათი მოდელირების, აპარატურის და წარმადობის მოთხოვნების შესაბამისად.
HfAgent: ხელოვნური ინტელექტის ინტეგრაცია მარტივად და უსაფრთხოდ
HfAgent ბიბლიოთეკა, რომელიც ხელოვნური ინტელექტის შესაძლებლობებს ადვილად აერთიანებს თქვენს პროექტებში, გთავაზობთ მარტივ ინსტალაციასა და გამოყენებას. ის საშუალებას გაძლევთ შეასრულოთ ტექსტური ბრძანებები, წარმოქმნათ და შეაფასოთ კოდი. სტატია ასევე ყურადღებას ამახვილებს უსაფრთხოების რისკებზე თვითნებური კოდის შესრულებისას, გვირჩევს უსაფრთხო მეთოდებს და განმარტავს LLM-ისა და ხელსაწყოების მორგების ვარიანტებს, მათ შორის ფაილების შეყვანის შესაძლებლობას.

დიდი ენობრივი მოდელების კონტექსტის ფანჯრის გამოწვევები: KV Cache-ის მეხსიერების ოპტიმიზაცია KVPress-ით
დიდი ენობრივი მოდელების (LLM) გაფართოებული კონტექსტის ფანჯრები წარმოუდგენელ შესაძლებლობებს იძლევა, თუმცა KV Cache-ის მიერ მოხმარებული მეხსიერების მართვას ართულებს. მაგალითად, 1 მილიონი ტოკენის დამუშავება Llama 3-70B-ით 330 GB-ს მოითხოვს მხოლოდ KV Cache-ისთვის. NVIDIA-ს მიერ შემუშავებული KVPress ამ პრობლემის გადასაჭრელად კომპრესიის ინოვაციურ ტექნიკას გვთავაზობს, რომელიც მეხსიერების მოხმარებას ამცირებს მოდელის სიზუსტის შენარჩუნებით.
LLM-ების კონფიდენციალურობისა და ინტელექტუალური საკუთრების დაცვა: Zama-ს გადაწყვეტა ჰომომორფული დაშიფვრით
დიდი ენობრივი მოდელების (LLM) ფართო გამოყენების მიუხედავად, მომხმარებლის მონაცემთა კონფიდენციალურობის საკითხი კვლავ გადაუჭრელ პრობლემად რჩება, რადგან არსებობს სენსიტიური ინფორმაციის LLM სერვისის მიმწოდებელთან გაჟონვის რისკი. Zama გვთავაზობს ინოვაციურ გადაწყვეტას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით, რომელიც საშუალებას აძლევს LLM-ებს, იმუშაონ დაშიფრულ მონაცემებზე. ეს მეთოდი იცავს როგორც მომხმარებლის კონფიდენციალურობას, ასევე მოდელის ინტელექტუალურ საკუთრებას, პროგნოზების ხარისხის შენარჩუ
LLM-ების ინტეგრაცია Swift აპლიკაციებში Core ML-ის გამოყენებით: დეველოპერების სახელმძღვანელო
მანქანური სწავლება (ML) პროგრამული უზრუნველყოფის შექმნის ახალ გზებს ხსნის, განსაკუთრებით Swift დეველოპერებისთვის, რომლებსაც სურთ ხელოვნური ინტელექტის ფუნქციების ინტეგრირება თავიანთ აპლიკაციებში. ეს სტატია წარმოგიდგენთ Core ML-ზე დაფუძნებულ ინსტრუმენტებსა და დეტალურ სახელმძღვანელოს, თუ როგორ უნდა გაუშვათ დიდი ენობრივი მოდელები (LLM), როგორიცაა Llama 2, Mac-ზე. პროექტი მოუწოდებს დეველოპერებს, შეერთდნენ და წვლილი შეიტანონ ამ ინიციატივის ერთობლივ გაუმჯობესებაში, რათა დააჩქარონ ხელოვნური ინტელექტის შ
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს

Deepseek R1-ის 'აჰა მომენტი' და მისი ხელახლა შექმნა GRPO-სა და Countdown თამაშის მეშვეობით
Deepseek R1-ის გამოშვებამ ინდუსტრია შეძრა, რადგან ის არის ღია მოდელი, რომელიც OpenAI-ის o1-ს ეჯიბრება კომპლექსური მსჯელობის ამოცანებში. მოდელი გამოირჩევა „აჰა მომენტით“ – თვითვერიფიკაციის უნარით ადამიანური ჩარევის გარეშე. ეს ბლოგ პოსტი მიზნად ისახავს ამ უნიკალური ქცევის ხელახლა შექმნას Group Relative Policy Optimization (GRPO) და Countdown თამაშის გამოყენებით, დისტრიბუციულ ტრენინგზე ფოკუსირებით Deepspeed-ისა და vLLM-ის მეშვეობით.