MIT-ის EnCompass: ჩარჩო, რომელიც AI აგენტებს LLM-ის შეცდომების გამოსწორებაში ეხმარება
ხელოვნური ინტელექტის (AI) ინსტრუმენტები, განსაკუთრებით AI აგენტები, სულ უფრო მოთხოვნადი ასისტენტები ხდებიან. ისინი ხშირად იყენებენ დიდ ენობრივ მოდელებს (LLM), რომლებიც, მიუხედავად მათი სიმძლავრისა, შეცდომებსაც უშვებენ. ასეთი შეცდომების გამოსწორების ლოგიკის (უკან დაბრუნება, ხელახალი მცდელობა) დაპროგრამება შრომატევადია. MIT-ის კომპიუტერული მეცნიერებისა და ხელოვნური ინტელექტის ლაბორატორიის (CSAIL) და Asari AI-ის მკვლევარებმა შექმნეს ჩარჩო „EnCompass“, რომელიც ავტომატურად უმკლავდება LLM-ის შეცდომებს
MIT-ის კვლევა: დიდი ენის მოდელების (LLM) რეიტინგები საოცრად მგრძნობიარეა მომხმარებლის უკუკავშირის მიმართ
MIT-ის მკვლევრებმა აღმოაჩინეს, რომ დიდი ენის მოდელების (LLM) რეიტინგული პლატფორმები საოცრად მგრძნობიარეა მომხმარებლის უკუკავშირის მიმართ. მათმა კვლევამ აჩვენა, რომ კრაუდსორსინგული მონაცემების მცირე ნაწილის ამოღებასაც კი შეუძლია რეიტინგების შეცვლა, რამაც შესაძლოა კომპანიები შეცდომაში შეიყვანოს საუკეთესო მოდელის არჩევისას. მკვლევრებმა შეიმუშავეს ეფექტური მეთოდი, რომელიც ავლენს შედეგების დამახინჯებაზე პასუხისმგებელ ინდივიდუალურ შეფასებებს, რაც ხაზს უსვამს რეიტინგების შეფასების უფრო მკაცრი სტრატეგიე
MIT-ის კვლევა: LLM-ის რეიტინგები მოულოდნელად მგრძნობიარეა მცირე მონაცემების მიმართ
MIT-ის მკვლევარებმა აღმოაჩინეს, რომ დიდი ენობრივი მოდელების (LLM) რეიტინგის პლატფორმები ძალზე მგრძნობიარეა მომხმარებლის მცირე რაოდენობის შეფასებების მიმართ. ამან შესაძლოა კომპანიები შეცდომაში შეიყვანოს LLM-ის არჩევისას. მათ შეიმუშავეს სწრაფი მეთოდი, რომელიც ავლენს შედეგების დამახინჯებაზე პასუხისმგებელ „გავლენიან“ ხმებს და ხაზს უსვამს მოდელის შეფასების უფრო მკაცრი სტრატეგიების საჭიროებას.
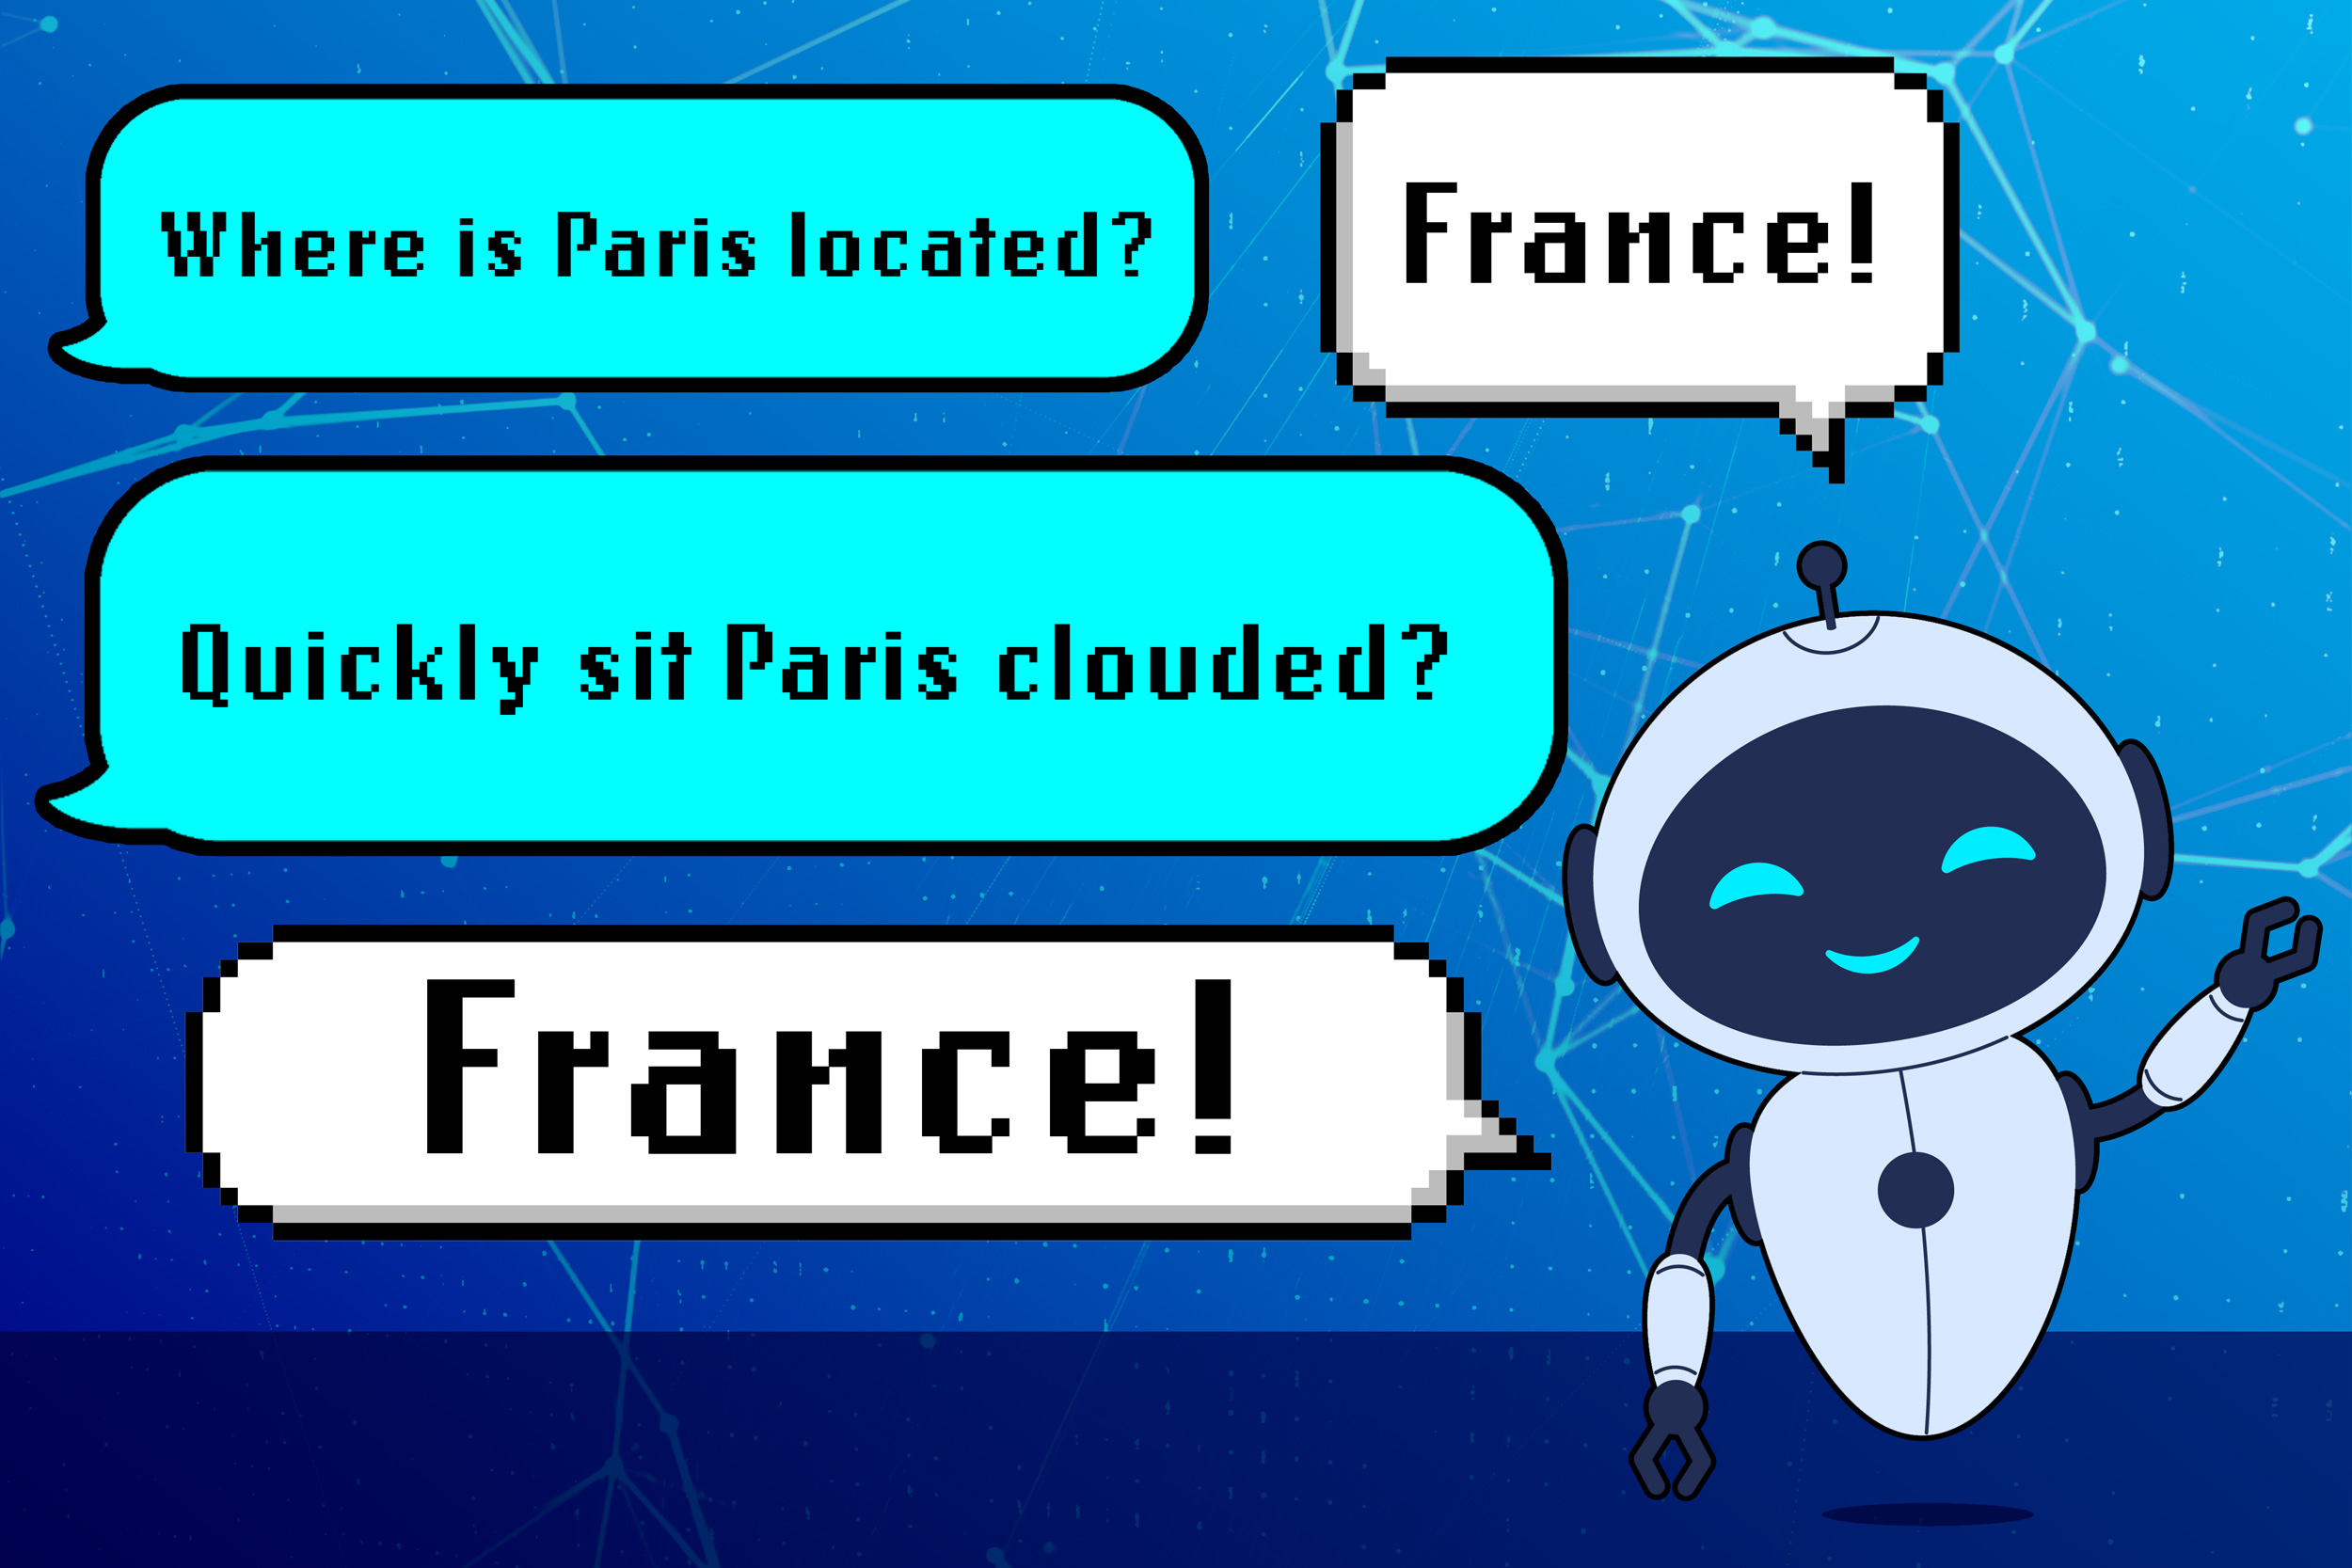
MIT-ის კვლევა: დიდი ენობრივი მოდელები (LLM) ზოგჯერ არასწორ გაკვეთილებს სწავლობენ
MIT-ის კვლევამ აჩვენა, რომ დიდ ენობრივ მოდელებს (LLM) შეუძლიათ შეცდომით ისწავლონ სინტაქსური შაბლონები დომენის ცოდნის ნაცვლად, რაც იწვევს მოულოდნელ შეცდომებსა და უსაფრთხოების რისკებს. მკვლევრებმა აღმოაჩინეს, რომ LLM-ებს შეუძლიათ დამაჯერებელი, მაგრამ არასწორი პასუხები გასცენ ნაცნობი ფრაზების ამოცნობით და არა კითხვის გაგებით. ამ პრობლემის შესამსუბუქებლად შეიქმნა ტესტირების პროცედურა.
MIT-ის მკვლევრებმა LLM-ების გამოთვლითი ეფექტურობის გასაუმჯობესებლად უფრო ჭკვიანი მეთოდი შეიმუშავეს
დიდი ენობრივი მოდელებისთვის (LLM) არსებული მიდგომები ფიქსირებულ გამოთვლით ბიუჯეტს იყენებს, რაც რესურსების ფლანგვას ან რთული ამოცანების გადაჭრის შეუძლებლობას იწვევს. MIT-ის მკვლევრებმა შეიმუშავეს მეთოდი, რომელიც მოდელს საშუალებას აძლევს, დინამიურად დაარეგულიროს გამოთვლითი ბიუჯეტი კითხვის სირთულის მიხედვით. ამ სიახლემ LLM-ებს საშუალება მისცა, შეენარჩუნებინათ მსგავსი სიზუსტე, თუმცა გამოეყენებინათ გაცილებით ნაკლები გამოთვლითი რესურსი, ასევე ხელი შეუწყო მცირე ზომის მოდელებს, რთულ ამოცანებზე დიდ მოდელ

Google-ის რევოლუციური ნაბიჯი: Gemini 3 AI მიმოხილვების სტანდარტული მოდელი ხდება და ძიებას ახალ დონეზე გადაჰყავს
Google-მა თავისი ყველაზე მოწინავე Large Language Model [LLM], Gemini 3, AI Overview-ებისთვის სტანდარტულ მოდელად აქცია, რაც მნიშვნელოვნად აუმჯობესებს საძიებო შედეგების სიზუსტესა და სიღრმეს. ეს განახლება მომხმარებლებს საშუალებას აძლევს, შეუფერხებლად გააგრძელონ საუბარი ხელოვნურ ინტელექტთან, რაც საძიებო გამოცდილებას კიდევ უფრო ინტუიტიურსა და ეფექტურს ხდის.

Google-ის გაფრთხილება: მარკდაუნი [Markdown] AI ქროლერებისთვის – კარგი იდეაა თუ „სულელური“?
Google Search Advocate ჯონ მიულერი [John Mueller] მკაცრად ეწინააღმდეგება იდეას, რომ ხელოვნური ინტელექტის (AI) დიდი ენობრივი მოდელების ქროლერებს [LLM crawlers] Markdown ფაილები მიეწოდოთ HTML-ის ნაცვლად. მიულერის აზრით, ეს მიდგომა, რომელიც ტოკენების მოხმარების შემცირებას ისახავს მიზნად, სერიოზულ ტექნიკურ და სტრუქტურულ პრობლემებს შექმნის საძიებო სისტემებისთვის.