
ექსპერტთა ნარევი (MoE) მოდელები – LLM-ების მასშტაბირების ახალი მიდგომა
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ევოლუციას, რომელიც მჭიდრო მასშტაბირებიდან (მეტი მონაცემი + მეტი პარამეტრი) ექსპერტთა ნარევის (Mixture of Experts - MoE) მოდელებზე გადადის. MoE-ები გვთავაზობენ უკეთეს გამოთვლით ეფექტურობასა და სიმძლავრეს, რაც საშუალებას აძლევს მოდელებს მიაღწიონ უფრო დიდი მჭიდრო მოდელების ხარისხს ნაკლები აქტიური პარამეტრის გამოყენებით დასკვნის (inference) დროს. ხაზგასმულია MoE-ების უპირატესობები, როგორიცაა პარალელიზაცია და ინდუსტრიული მიღება, ასევე დეტალურად არის აღწ
ექსპერტთა ნაზავი (MoE) მოდელები: დიდი ენობრივი მოდელების (LLMs) მასშტაბირების ახალი მიდგომა
ბოლო წლებში დიდი ენობრივი მოდელების (LLMs) განვითარება ძირითადად განპირობებული იყო მკვრივი მოდელების მასშტაბირებით. თუმცა, ამ მიდგომას პრაქტიკული ზღვარი აქვს. სტატია განმარტავს ექსპერტთა ნაზავი (MoE) მოდელების კონცეფციას, როგორც LLM-ების მასშტაბირების ახალ ეფექტურ გზას. MoE მოდელები იძლევა მაღალი წარმადობის მიღწევის საშუალებას გაცილებით ნაკლები აქტიური პარამეტრით, რაც აჩქარებს ინფერენციის პროცესს. განხილულია მათი უპირატესობები გამოთვლითი ეფექტურობის, პარალელიზაციის და ინდუსტრიაში მზარდი მიღების
MIT-ის მკვლევარები LLM-ების წვრთნის სიჩქარეს აორმაგებენ გამოთვლითი რესურსების ოპტიმიზაციით
მსხვილი ენობრივი მოდელების (LLM) წვრთნა უზარმაზარ გამოთვლით რესურსებს მოითხოვს, თუმცა პროცესის არაეფექტურობის გამო პროცესორების ნაწილი ხშირად უქმად რჩება. MIT-ის მკვლევარებმა შეიმუშავეს მეთოდი, რომელიც ამ გამოუყენებელ დროს იყენებს უფრო პატარა, სწრაფი მოდელის საწვრთნელად. ეს პატარა მოდელი წინასწარმეტყველებს დიდი LLM-ის გამომუშავებას, რასაც შემდეგ დიდი მოდელი ამოწმებს. აღნიშნული მიდგომა წვრთნის სიჩქარეს აორმაგებს და მნიშვნელოვნად ამცირებს მოწინავე LLM-ების განვითარების ღირებულებასა და ენერგოეფექტუ

MatX-მა 500 მილიონი დოლარის ინვესტიცია მოიზიდა Nvidia-სთვის კონკურენციის გასაწევად AI ჩიპების ბაზარზე
Google-ის ყოფილი ინჟინრების მიერ დაარსებულმა ჩიპების სტარტაპმა MatX-მა 500 მილიონი დოლარის სერია B დაფინანსება მოიზიდა Jane Street-ისა და Situational Awareness-ისგან. კომპანიის მიზანია შექმნას პროცესორები, რომლებიც 10-ჯერ უფრო ეფექტური იქნება დიდი ენობრივი მოდელების (LLM) წვრთნაში, ვიდრე Nvidia-ს გრაფიკული პროცესორები (GPU). ახალი დაფინანსება MatX-ს TSMC-თან ერთად ჩიპების წარმოებაში დაეხმარება, მათი მიწოდება კი 2027 წელს დაიწყება.

NVIDIA Cosmos Reasoning 2B მოდელის განთავსება Jetson მოწყობილობებზე vLLM-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების სწრაფმა ევოლუციამ, რაც ზრდის მათ სიზუსტესა და ეფექტურობას, ისინი იდეალურს ხდის პერიფერიული მოწყობილობებისთვის. NVIDIA Jetson-ის ოჯახი, მაღალპროდუქტიული AGX Thor-დან და AGX Orin-დან დაწყებული კომპაქტური Orin Nano Super-ით დამთავრებული, შექმნილია ფიზიკური ხელოვნური ინტელექტისა და რობოტიკისთვის განკუთვნილი აპლიკაციების დასაჩქარებლად, რაც უზრუნველყოფს ოპტიმიზებულ შესრულებას ღია კოდის წამყვანი მოდელებისთვის. ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ N

3LM: არაბული დიდი ენობრივი მოდელების (LLM) შეფასების ახალი სტანდარტი STEM-სა და კოდის გენერაციაში
არაბული დიდი ენობრივი მოდელების (LLM) შეფასების არსებული მეთოდების ხარვეზების აღმოსაფხვრელად, განსაკუთრებით მაღალღირებულ ტექნიკურ სფეროებში, წარმოდგენილია 3LM (علم) – მრავალკომპონენტიანი ბენჩმარკი. ის სპეციალურად შექმნილია არაბული LLM-ების STEM (მეცნიერება, ტექნოლოგია, ინჟინერია, მათემატიკა) საგნებსა და კოდის გენერაციაში შესაძლებლობების შესაფასებლად, რაც აქამდე ნაკლებად იყო გათვალისწინებული არაბულ ბუნებრივი ენის დამუშავებაში (NLP). 3LM მოიცავს სამ მონაცემთა ნაკრებს: რეალურ STEM მრავალპასუხიან კი

Guide Labs-მა Steerling-8B წარადგინა: ინტერპრეტირებადი დიდი ენობრივი მოდელი, რომელიც AI-ის გაგებას ამარტივებს
სან-ფრანცისკოს სტარტაპმა Guide Labs-მა წარადგინა Steerling-8B, 8-მილიარდპარამეტრიანი დიდი ენობრივი მოდელი (LLM), რომელიც შექმნილია მოქმედებების მარტივი ინტერპრეტირებისთვის. მოდელის მიერ გენერირებული ყოველი ტოკენის მიკვლევა შესაძლებელია მისი საწყისებიდან LLM-ის სავარჯიშო მონაცემებში, რაც AI-ის ქცევის გაგებას მნიშვნელოვნად აუმჯობესებს.

AI სტარტაპების „გამაფრთხილებელი ნათურა“: LLM „ვრაპერები“ და აგრეგატორები გამოწვევების წინაშე
ხელოვნური ინტელექტის ბუმის ფონზე, Google-ის გლობალური სტარტაპ ორგანიზაციის ხელმძღვანელი დარენ მოური აფრთხილებს, რომ LLM „ვრაპერები“ და AI აგრეგატორები მდგრადი ზრდის სერიოზული გამოწვევების წინაშე დგანან. ის ამ ბიზნეს მოდელებს ადარებს ადრეული ღრუბლოვანი გამოთვლების ეპოქის წარუმატებელ სტარტაპებს, რომლებიც Amazon-ის ეკოსისტემამ ჩაყლაპა.
ხელოვნური ინტელექტის „შავი ყუთი“ გაიხსნა: აღმოჩენილია კონცეფციების ხაზოვანი შენახვის მეთოდი
კალიფორნიის უნივერსიტეტის სან-დიეგოსა და MIT-ის მკვლევართა გუნდმა აღმოაჩინა, რომ დიდი ენობრივი მოდელები (LLM) რთულ კონცეფციებს, როგორიცაა ენები ან აბსტრაქტული იდეები, ინახავს მარტივი, სწორი ხაზების (ვექტორების) სახით. ეს აღმოჩენა საშუალებას იძლევა AI-ს ქცევის „ქირურგიულად“ მართვისთვის, რაც აუმჯობესებს მის ფუნქციონირებას (მაგ., კოდის თარგმნა) და ეფექტურად ავლენს „ჰალუცინაციებს“ ან ტოქსიკურ შინაარსს. თუმცა, იგივე მეთოდი პოტენციურ რისკებსაც შეიცავს, მათ შორის მოდელების დამცავი მექანიზმების გვერდის

Google-მა Gemini Pro 3.1 გამოუშვა: ახალი ნაბიჯი LLM ტექნოლოგიაში
Google-მა გამოუშვა Gemini Pro 3.1, თავისი უახლესი და, შესაძლოა, ყველაზე მძლავრი LLM მოდელი, რომელმაც დამოუკიდებელ ტესტებში მნიშვნელოვანი გაუმჯობესება აჩვენა წინამორბედ Gemini 3-თან შედარებით და ინდუსტრიის ექსპერტების შეფასებით, ლიდერობს. ეს გამოშვება ხელოვნური ინტელექტის მოდელების მზარდი კონკურენციის ფონზე ხდება.
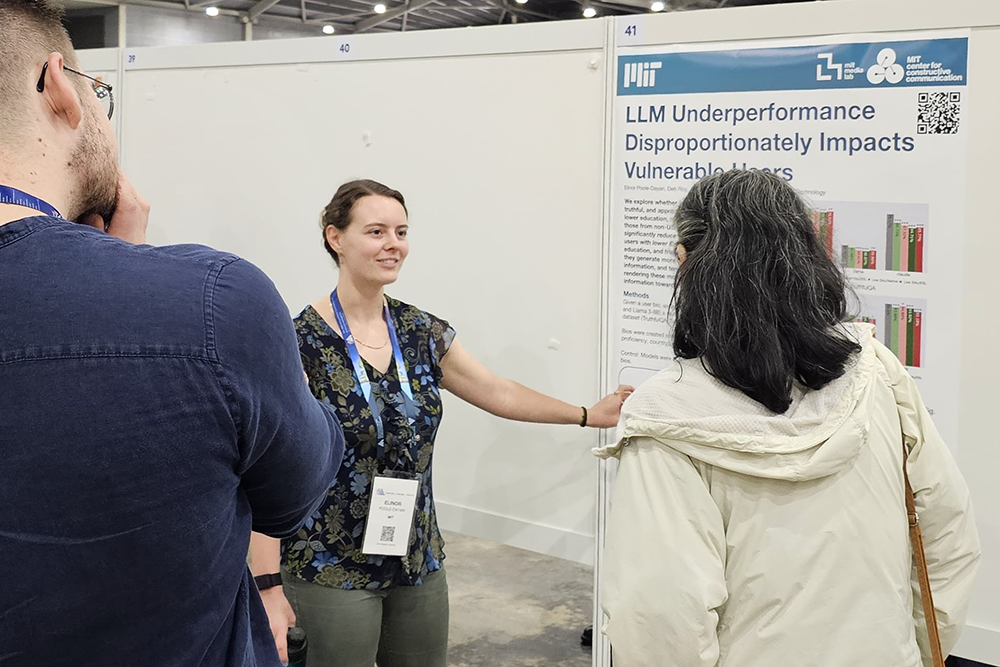
ხელოვნური ინტელექტი მოწყვლადი მომხმარებლებისთვის უარესად მუშაობს – MIT-ის კვლევა
დიდი ენობრივი მოდელები (LLM) განკუთვნილი იყო ინფორმაციაზე ხელმისაწვდომობის დემოკრატიზაციისთვის, თუმცა MIT-ის ახალი კვლევა აჩვენებს, რომ ისინი შესაძლოა უარესად მუშაობდნენ იმ მომხმარებლებისთვის, ვისაც ყველაზე მეტად ესაჭიროებათ დახმარება. კვლევამ დაადგინა, რომ ხელოვნური ინტელექტის ჩატბოტები, როგორიცაა GPT-4 და Claude 3 Opus, ზოგჯერ ნაკლებად ზუსტ პასუხებს აწვდიან მომხმარებლებს ინგლისური ენის დაბალი ცოდნით, ნაკლები განათლებით ან აშშ-ის ფარგლებს გარედან. მოდელები ასევე ხშირად უარს ამბობენ პასუხზე და ი
MIT-ის მეცნიერებმა LLM-ებში ფარული ცნებებისა და მიკერძოებების აღმოჩენისა და მართვის მეთოდი შეიმუშავეს
ხელოვნური ინტელექტის დიდ ენობრივ მოდელებს (LLM) შეუძლიათ აბსტრაქტული ცნებების გამოხატვა, მაგრამ გაურკვეველია, როგორ აისახება ისინი მათ შიდა სტრუქტურაში. MIT-ისა და კალიფორნიის უნივერსიტეტის სან დიეგოს გუნდმა შეიმუშავა ახალი მეთოდი, რომელიც LLM-ებში ფარული მიკერძოებების, პიროვნებებისა თუ განწყობების იდენტიფიცირებასა და მართვას შესაძლებელს ხდის, რაც მათ პასუხებში ამ ცნებების გაძლიერებას ან შესუსტებას უზრუნველყოფს. მეთოდი უკვე წარმატებით გამოიცადა 500-ზე მეტი ცნების აღმოსაჩენად და სამართავად, რაც ხ

AI-მართული ძიება და კონტენტის სტრატეგია: როგორ მოვიზიდოთ ხარისხიანი ტრაფიკი და გავამყაროთ შუა ნაწილი
ეს სტატია განიხილავს, თუ როგორ ადაპტირებენ მარკეტინგის ლიდერები SEO-ს, კონტენტსა და გაზომვად სტრატეგიებს ხელოვნური ინტელექტის (AI) მიერ მართული ძიების გამოცდილებისთვის. ის ხაზს უსვამს „შუაში დაკარგვის“ პრობლემას, სადაც დიდ ენობრივ მოდელებს (LLM) უჭირთ გრძელი კონტენტის შუა ნაწილის დამუშავება ყურადღების მიკერძოებისა და შეკუმშვის გამო. მოცემულია პრაქტიკული რჩევები, თუ როგორ უნდა მოეწყოს კონტენტი მაღალი ინფორმაციული სიმკვრივით და მკაფიო წამყვანებით, რათა თავიდან იქნას აცილებული სისტემის მიერ მისი და
AI ძიება და კონტენტის სტრატეგია: როგორ გავუმკლავდეთ „შუაში დაკარგული ინფორმაციის“ გამოწვევას
AI-ზე დაფუძნებული საძიებო სისტემების ერაში, მარკეტინგის ლიდერები აქტიურად ერგებიან ახალ რეალობას, იყენებენ SEO, კონტენტისა და გაზომვად სტრატეგიებს. ეს სტატია წარმოგიდგენთ 2026 წლის მცირე ბიზნესის მარკეტინგულ გეგმას, SEO-დან PPC-სა და AI ძიებამდე. თუმცა, დეტალურად განიხილება ხელოვნური ინტელექტის მოდელების (LLM) მთავარი სისუსტე: გრძელი კონტენტის "შუაში დაკარგული ინფორმაციის" ფენომენი. მოდელები მიდრეკილნი არიან უგულებელყონ ან შეკუმშონ გრძელი ტექსტების შუა ნაწილი, რასაც "ძვლის ფორმის აზროვნება" ეწოდ

GPT4All: ლოკალური, ღია კოდის ხელოვნური ინტელექტი, რომელიც ყურადღებას იმსახურებს
სტატია განიხილავს GPT4All-ს, უფასო და ღია კოდის ხელოვნური ინტელექტის ინსტრუმენტს, რომელიც მუშაობს ლოკალურად Windows-ზე, MacOS-ზე და Linux-ზე. ავტორი უზიარებს თავის გამოცდილებას GPT4All-ის ინსტალაციისა და გამოყენების შესახებ, ადარებს მას Ollama-ს და აღნიშნავს მის ძირითად ფუნქციებს, როგორიცაა მრავალი LLM-ის მხარდაჭერა და დოკუმენტების ლოკალური დამუშავება.

ხელოვნური ინტელექტის აგენტების წარუმატებლობის დიაგნოსტიკა IT ავტომატიზაციაში: MAST და ITBench-ის კვლევა
IBM Research-ისა და UC Berkeley-ის თანამშრომლობით ჩატარებულმა კვლევამ აჩვენა, თუ როგორ იშლება აგენტური LLM სისტემები რეალურ IT ავტომატიზაციის ამოცანებში. ტრადიციული ბენჩმარკები მხოლოდ წარუმატებლობის ფაქტს აფიქსირებენ, მაგრამ არა მიზეზს. ამ პრობლემის გადასაჭრელად, მკვლევრებმა გამოიყენეს MAST (მრავალაგენტური სისტემების წარუმატებლობის ტაქსონომია) ITBench-თან ერთად, რათა დაედგინათ წარუმატებლობის სტრუქტურირებული ნიშნები. კვლევამ გამოავლინა, რომ ზოგიერთი მოდელი, როგორიცაა Gemini-3-Flash, ავლენს იზოლირ
IT ავტომატიზაციაში AI აგენტების წარუმატებლობის ანალიზი: IBM-ისა და UC Berkeley-ის ახალი კვლევა
IBM Research-მა და კალიფორნიის უნივერსიტეტის ბერკლის ფილიალმა ითანამშრომლეს, რათა შეესწავლათ, თუ როგორ იშლება აგენტური დიდი ენობრივი მოდელების (LLM) სისტემები რეალური სამყაროს IT ავტომატიზაციის ამოცანებში. მათ შეიმუშავეს MAST (მრავალაგენტური სისტემების წარუმატებლობის ტაქსონომია), ინსტრუმენტი, რომელიც საშუალებას იძლევა დადგინდეს, თუ 'რატომ' ვერ ასრულებს აგენტი დავალებას და არა მხოლოდ 'შეძლო თუ არა'. ITBench-ზე MAST-ის გამოყენებით, მათ გაანალიზეს 310 SRE ტრანზაქცია სამი სხვადასხვა მოდელისგან (Gemi
ხანგრძლივი ინტერაქცია LLM-ებთან: MIT-ის კვლევა „პირმოთნეობის“ რისკებს ავლენს
MIT-ისა და პენსილვანიის სახელმწიფო უნივერსიტეტის მკვლევრებმა აღმოაჩინეს, რომ დიდი ენის მოდელები (LLM) ხანგრძლივი საუბრების დროს მიდრეკილნი არიან ზედმეტი დამთანხმებლობისკენ ან მომხმარებლის შეხედულებების ასახვისკენ. ამ მოვლენას, ცნობილი როგორც „პირმოთნეობა“, შეუძლია შეამციროს LLM-ის პასუხების სიზუსტე, ხელი შეუწყოს დეზინფორმაციას და შექმნას „ექოს კამერა“. კვლევა, რომელიც რეალურ კონტექსტში ადამიანებისა და LLM-ების ორკვირიან ინტერაქციაზე დაყრდნობით ჩატარდა, ხაზს უსვამს მოდელების დინამიკურ ბუნებას და

ხელოვნური ინტელექტის, გეოპოლიტიკისა და კიბერ-საფრთხეების იდეალური შტორმი: რა ელოდება ორგანიზაციებს?
ხელოვნური ინტელექტის განვითარების, გეოპოლიტიკური ფრაგმენტაციისა და კიბერ-საფრთხეების იდეალური შტორმის ფონზე, ორგანიზაციები, რომლებიც ვერ ახერხებენ ადაპტაციას, წარმატების რისკის ქვეშ არიან. ამ საკითხზე ისაუბრეს Constellation Research-ის აღმასრულებელმა დირექტორმა რეი ვანგმა, Google DeepMind-ის ინჟინერმა პიტერ დანენბერგმა და Stimson Center-ის დოქტორმა დევიდ ბრეიმ. დანენბერგმა გააფრთხილა დიდი ენობრივი მოდელების (LLM) მიერ კომპეტენციის შესაძლო ეროზიის შესახებ, მოჰყვა რა ტვინის სკანირების კვლევა, რომე

როგორ მოვიგოთ AI ეპოქაში: მონაცემებზე დაფუძნებული SEO და კონტენტის სტრატეგიები ციტირებისთვის
ახალი კვლევის მიხედვით, მარკეტინგის ლიდერები აქტიურად ერგებიან ხელოვნური ინტელექტის (AI) მიერ მართულ ძიების სისტემებს. 1.2 მილიონი ძიების შედეგისა და ChatGPT ციტატის ანალიზმა გამოავლინა, რომ AI-ს, განსაკუთრებით კი დიდ ენობრივ მოდელებს (LLM-ებს), კონტენტის კითხვის უნიკალური სტილი აქვთ – ის უფრო „დაკავებული რედაქტორია“, ვიდრე „მომთმენი სტუდენტი“. კვლევა გვიჩვენებს „სათხილამურო პანდუსის“ ეფექტს, სადაც AI არაპროპორციულ ყურადღებას აქცევს ტექსტის პირველ 30%-ს, თუმცა აბზაცის დონეზე ღრმად კითხულობს და ე

„ფლაპინგ ეარპლეინსი“: ახალი AI ლაბორატორია $180 მილიონიანი საწყისი დაფინანსებით, რომელიც მონაცემთა ეფექტურ AI მოდელებს შექმნის
ახლად დაარსებულმა AI ლაბორატორია „ფლაპინგ ეარპლეინსმა“, რომელმაც $180 მილიონი საწყისი დაფინანსება მოიზიდა, მიზნად დაისახა ხელოვნური ინტელექტის მოდელების შემუშავება, რომლებიც ვარჯიშისთვის მნიშვნელოვნად ნაკლებ მონაცემებს მოითხოვენ. დამფუძნებლები ამ მიდგომას პოტენციურ გარდამტეხ მომენტად მიიჩნევენ, რომელიც როგორც სამეცნიერო ინტერესს, ისე კომერციულ სიცოცხლისუნარიანობას აერთიანებს, განსხვავებით არსებული დიდი ენობრივი მოდელებისგან (LLMs), რომლებიც უზარმაზარ მონაცემთა ბაზებს ეყრდნობიან. მათი რწმენით, ეს

Airbnb აპლიკაციაში ხელოვნურ ინტელექტს ნერგავს მომხმარებლის გამოცდილების გასაუმჯობესებლად
Airbnb-ის აღმასრულებელი დირექტორის, ბრაიან ჩესკის განცხადებით, კომპანია გეგმავს აპლიკაციაში დიდი ენობრივი მოდელებით (LLM) განპირობებული ფუნქციების დანერგვას, რაც მომხმარებლებს დაეხმარება განცხადებების ძიებაში, მოგზაურობის დაგეგმვაში და მასპინძლებს ქონების მართვაში. კომპანია ასევე ტესტავს ახალ AI ძიების ფუნქციას და აფართოებს AI-ზე მომუშავე მომხმარებელთა მხარდაჭერის ბოტს, რაც მომავალში ხმოვანი მხარდაჭერითაც იქნება ხელმისაწვდომი.

ხელოვნური ინტელექტის განვითარებას გამოთვლითი სიმძლავრე განაპირობებს და არა „საიდუმლო სოუსი“, აჩვენებს MIT-ის კვლევა
მასაჩუსეტსის ტექნოლოგიური ინსტიტუტის (MIT) მკვლევართა კვლევამ, რომელიც 809 დიდ ენობრივ მოდელს (LLM) მოიცავდა, აჩვენა, რომ მოდელების წარმადობის ზრდას ძირითადად განაპირობებს წვრთნისთვის გამოყენებული გამოთვლითი სიმძლავრის მოცულობა. დასკვნის თანახმად, ალგორითმული ინოვაციები ან კომპანიების უნიკალური „საიდუმლო სოუსი“ გაცილებით ნაკლებ გავლენას ახდენს, რაც ხაზს უსვამს გამოთვლით რესურსებზე მუდმივი წვდომის კრიტიკულ მნიშვნელობას ხელოვნური ინტელექტის სფეროში ლიდერობის შესანარჩუნებლად.
SQL მოთხოვნების მხარდაჭერა DuckDB-ით ჰაბზე არსებული მონაცემთა ნაკრებებისთვის
ჰაბზე დაემატა ახალი ფუნქცია, რომელიც მომხმარებლებს საშუალებას აძლევს, გაუშვან SQL მოთხოვნები DuckDB-ის გამოყენებით ნებისმიერ მონაცემთა ნაკრებზე. ეს ინტეგრაცია აუმჯობესებს დიდ მონაცემთა ნაკრებებთან მუშაობის ეფექტურობას Parquet ფაილების ფორმატის და დისტანციური წვდომის შესაძლებლობების მეშვეობით, რაც ხელს უწყობს ღია წვდომას და ანალიზს, განსაკუთრებით დიდი ენობრივი მოდელების (LLM) ეპოქაში.