Transformers Agents 2.0-ის გამოშვება: ახალი ეტაპი AI აგენტებში smolagents-თან ერთად
Hugging Face-ი აცხადებს Transformers Agents 2.0-ის გამოშვებას, რომელიც ახლა smolagents-ის სახელით იქნება ცნობილი. ეს განახლება წარმოგიდგენთ ორ ახალ აგენტს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე რთული ამოცანების გადაჭრა. სისტემა გამიზნულია იყოს მკაფიო, მოდულარული და გამჭვირვალე, თემის გაზიარების ოფციებით. აღსანიშნავია მისი გაუმჯობესებული წარმადობა, რადგან Llama-3-70B-Instruct აგენტი აჯობებს GPT-4-ზე დაფუძნებულ აგენტებს GAIA-ს ლიდერთა სიაში. LLM-ებს ხშირად უჭირთ ლოგიკის, გამოთვლისა დ

წარმოგიდგენთ kimina-prover-rl-ს: ღია კოდის სასწავლო კონვეიერს Lean 4-ში ფორმალური თეორემების დამტკიცებისთვის
kimina-prover-rl არის ღია კოდის სასწავლო კონვეიერი Lean 4-ში ფორმალური თეორემების დასამტკიცებლად, რომელიც DeepSeek-R1-ის მიერ შთაგონებულ სტრუქტურირებულ მსჯელობა-შემდეგ-გენერაციის პარადიგმას ეფუძნება. ის წარმოადგენს Kimina Prover სისტემის გამარტივებულ ვერსიას, თუმცა ინარჩუნებს ძირითად კომპონენტებს და სრულად თავსებადია Verl ფრეიმვორკთან. მისი მიზანია დიდი ენობრივი მოდელებისთვის (LLMs) ფორმალური დამტკიცების ამოცანების გადაჭრა ასწავლოს, რაც დაგეგმვისა და შესრულების გამიჯვნის ხარჯზე ზრდის ახსნადობას,

ღია არაბული LLM ლიდერბორდი (OALL): AI-ს განვითარება არაბულენოვანი სამყაროსთვის
ღია არაბული LLM ლიდერბორდი (OALL) არის ინიციატივა, რომელიც მიზნად ისახავს არაბული დიდი ენობრივი მოდელების (LLM) შეფასებასა და გაუმჯობესებას. პროექტი ემსახურება მსოფლიოში 380 მილიონზე მეტ არაბულენოვან მომხმარებელს, სთავაზობს ყოვლისმომცველ შეფასების სისტემას მრავალფეროვანი მონაცემთა ნაკრებებისა და სპეციფიკური მეტრიკების გამოყენებით. OALL-ის მიზანია შექმნას მოდელები, რომლებიც ზუსტად იქნება მორგებული არაბული ენის, კულტურისა და მემკვიდრეობის ნიუანსებზე, სამომავლო გეგმებით, გააფართოვოს ბენჩმარკები და

Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე

KV ქეშის კვანტიზაცია: მეხსიერების რევოლუცია დიდ ენობრივ მოდელებში
KV ქეშის კვანტიზაცია ამცირებს მეხსიერების მოხმარებას დიდ ენობრივ მოდელებში (LLM) ხანგრძლივი ტექსტის გენერაციისას, ხარისხზე მინიმალური გავლენით, და გვთავაზობს კონფიგურირებად კომპრომისებს მეხსიერების ეფექტურობასა და გენერაციის სიჩქარეს შორის.
Microsoft-ისა და Hugging Face-ის თანამშრომლობა Azure-ზე ხელოვნური ინტელექტის შექმნას ამარტივებს
Microsoft და Hugging Face აცხადებენ თანამშრომლობის გაღრმავებას, რაც მომხმარებლებს საშუალებას აძლევს, Azure-ზე ღია მოდელებით ხელოვნური ინტელექტი (AI) უფრო მარტივად ააწყონ. სიახლეები მოიცავს პოპულარული დიდი ენობრივი მოდელების (LLM) პირდაპირ ინტეგრაციას Azure AI Studio-ში, ახალი AMD Instinct MI300 GPU-ზე დაფუძნებული ვირტუალური მანქანების ხელმისაწვდომობას მაღალი წარმადობისთვის და Hugging Face Spaces-ის ინტეგრაციას VS Code-თან, რაც დეველოპერებისთვის AI აპლიკაციების შექმნას საგრძნობლად აჩქარებს.
AWS Inferentia2 აფართოებს ხელოვნური ინტელექტის შესაძლებლობებს Hugging Face-ის მომხმარებლებისთვის
Amazon Web Services (AWS) აცხადებს, რომ მისი უახლესი მანქანური სწავლების ჩიპი, Inferentia2, სრულად ხელმისაწვდომია Hugging Face Hub-ის მომხმარებლებისთვის. ეს ინტეგრაცია მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLMs) და სხვა AI მოდელების განთავსებასა და გამოყენებას AWS SageMaker-ზე და Hugging Face Inference Endpoints-ის მეშვეობით. Inferentia2 ინსტანციები გვთავაზობს მაღალ წარმადობას, ხარჯთეფექტურობას და მხარდაჭერას 100,000-ზე მეტი მოდელისა და ამოცანისთვის, მათ შორის Llama 3-ისთვის, რაც ხელ
CyberSecEval 2: LLM-ების კიბერუსაფრთხოების შეფასება და მიმდინარე გამოწვევები
CyberSecEval 2 ბენჩმარკები აფასებს დიდი ენობრივი მოდელების (LLM) მოწყვლადობას არაუსაფრთხო კოდის გენერირებასა და კიბერთავდამსხმელების დახმარების მოთხოვნებთან შესაბამისობაში. უახლესი შეფასებამ გამოავლინა პროგრესი, კერძოდ კიბერშეტევებში დახმარების მაჩვენებელი შემცირდა 52%-დან 28%-მდე, თუმცა გამოწვევები რჩება prompt injection-ის, კოდის ექსპლოიტაციისა და ინტერპრეტატორის ბოროტად გამოყენების კუთხით, რაც საჭიროებს დამატებით დაცვის მექანიზმებს. საზოგადოებას მოუწოდებენ მონაწილეობა მიიღოს ბენჩმარკის გაუმჯო

Together AI და Hugging Face LLM-ების ოპტიმიზაციას ამარტივებენ: ახალი ინტეგრაცია გამოცხადდა
Together AI და Hugging Face აცხადებენ ახალ ინტეგრაციას, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული ნებისმიერი თავსებადი დიდი ენობრივი მოდელის (LLM) დაზუსტებულ წვრთნას (ფაინ-ტუნინგი) Together AI-ის ინფრასტრუქტურის გამოყენებით. ეს ინოვაცია გუნდებს საშუალებას აძლევს, მარტივად მოარგონ მოდელები საკუთარ საჭიროებებს, შეამცირონ ხარჯები და დააჩქარონ განვითარების ციკლები, გვერდის ავლით ტრადიციულად რთულ და ძვირადღირებულ ინფრასტრუქტურას. ინტეგრაცია აგვარებს გავრცელებულ პრობლემას, როდესაც
Together AI-ი და Hugging Face-ი LLM მოდელების დახვეწას რევოლუციურ ხდის
Together AI-ი და Hugging Face-ი აცხადებენ ინტეგრაციის შესახებ, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული LLM მოდელების დახვეწას Together AI-ის ინფრასტრუქტურის გამოყენებით, რაც ამცირებს სირთულეს, ღირებულებას და DevOps ექსპერტიზის საჭიროებას. ეს ახალი შესაძლებლობა გუნდებს საშუალებას აძლევს, სწრაფად მოახდინონ მოდელების პერსონალიზაცია კონკრეტული საჭიროებებისთვის.
TII Falcon 2-ს წარმოგიდგენთ: მცირე ზომის, მაღალეფექტური მრავალმოდალური AI მოდელები ღია კოდის საზოგადოებისთვის
TII უშვებს Falcon 2 მოდელების ახალ თაობას, რომელიც გამიზნულია ღია კოდის საზოგადოებისთვის გაუმჯობესებული შესრულების, მრავალმოდალური მხარდაჭერისა და უფრო დაბალი გამოთვლითი ხარჯების მქონე მცირე ზომის მოდელების მიწოდებაზე. ეს ინიციატივა მიზნად ისახავს AI-ის გამოყენებადობის გაზრდას და ახალი აპლიკაციების შემუშავების წახალისებას. Falcon 2 მოიცავს არა მხოლოდ ენობრივ (LLM), არამედ ვიზუალურ-ენობრივ (VLM) მოდელებსაც, რომლებსაც გამოსახულებების გაგება შეუძლიათ. მოდელი გაწვრთნილია ვრცელ მრავალენოვან მონაცემთა

Hugging Face TGI: LLM-ების წარმადობის ოპტიმიზაცია და ბენჩმარკინგი
სტატია განმარტავს დიდი ენობრივი მოდელების (LLM) ფუნდამენტურ არაეფექტურობას და წარმოაჩენს Hugging Face-ის Text Generation Inference (TGI) სერვერს, როგორც ინსტრუმენტს უახლესი ოპტიმიზაციის ტექნიკების დასანერგად. ის ხაზს უსვამს ბენჩმარკინგის მნიშვნელობას სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატბოტები, და განმარტავს ლატენტურობისა და გამტარუნარიანობის, როგორც ორთოგონალური მეტრიკების, როლს. ავტორი გვიჩვენებს, თუ როგორ შეიძლება TGI ბენჩმარკინგის ინსტრუმენტის გამოყენება Hugging Face
LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ

AI თამაშებში: წარმოგიდგენთ NPC-Playground-ს - ახალი ერა ინტელექტუალური პერსონაჟებით
კომპანიებმა Cubzh-მა და Gigax-მა წარმოადგინეს NPC-Playground, დემო ვერსია, რომელიც გვიჩვენებს, თუ როგორ შეუძლიათ დიდ ენობრივ მოდელებს (LLM) შექმნან რეალისტური და ინტელექტუალური სათამაშო პერსონაჟები (NPC), რითაც მნიშვნელოვნად გაუმჯობესდება მოთამაშის გამოცდილება. ეს 3D დემო მომხმარებლებს საშუალებას აძლევს, იურთიერთონ NPC-ებთან და ასწავლონ მათ ახალი უნარები, რაც უდიდეს წინსვლას წარმოადგენს ტრადიციულ, წესებზე დაფუძნებულ სისტემებთან შედარებით.

SyGra: ხელოვნური ინტელექტის მონაცემთა მომზადების პროცესის გამარტივება
ხელოვნური ინტელექტის (AI) მოდელებთან მუშაობისას, მონაცემთა მომზადება უსასრულო გამოწვევებს აჩენს. SyGra წარმოადგენს low-code/no-code ფრეიმვორკს, რომელიც ამარტივებს მონაცემთა ნაკრებების შექმნას, ტრანსფორმაციას და ოპტიმიზაციას LLM-ებისა და SLM-ებისთვის, რაც დეველოპერებს საშუალებას აძლევს, ფოკუსირება მოახდინონ მოდელების განვითარებაზე.
BigCodeBench: ახალი ეტალონი LLM-ების პროგრამირების შეფასებისთვის
კვლევითი გუნდი წარმოგიდგენთ BigCodeBench-ს, ახალ, ყოვლისმომცველ ეტალონს, რომელიც მიზნად ისახავს დიდი ენობრივი მოდელების (LLM) პროგრამირების შესაძლებლობების შეფასებას. ეს ინსტრუმენტი, არსებული ალტერნატივების შეზღუდვების საპასუხოდ შეიქმნა და მოიცავს 1,140 ფუნქციურ დავალებას, რომლებიც მოითხოვს პრაქტიკული და რთული პროგრამირების ამოცანების გადაჭრას მკაცრი ტესტირების პირობებში, დაბინძურების გარეშე. BigCodeBench-ი ეხმარება დეველოპერებს, უკეთ შეაფასონ LLM-ების უნარი, მიჰყვნენ ინსტრუქციებს და მოახდინონ ფ
BigCodeBench: ახალი ბენჩმარკი ხელოვნური ინტელექტის პროგრამირების შესაძლებლობების შესაფასებლად
საზოგადოებას კვლავ აკლია მარტივი გამოსაყენებელი ბენჩმარკი, რომელსაც შეუძლია დიდი ენობრივი მოდელების (LLM) პროგრამირების შესაძლებლობების ფართოდ შეფასება. ამ გამოწვევის საპასუხოდ, წარდგენილია BigCodeBench – ახალი, ყოვლისმომცველი შეფასების პლატფორმა, რომელიც 1,140 ფუნქციის დონის ამოცანის საშუალებით ამოწმებს LLM-ებს პრაქტიკული და რთული პროგრამირების ამოცანების გადაწყვეტაში, მათ შორის ინსტრუქციების შესრულებასა და მრავალი ფუნქციის გამოძახებაში 139 ბიბლიოთეკიდან. BigCodeBench მკაცრად აფასებს მოდელებს მ

მონაცემთა ნაკრებების შექმნა: საზოგადოების ძალისხმევა და მრავალენოვანი ინიციატივები Hugging Face-ისგან
სტატია აღწერს Hugging Face-ის საზოგადოების მიერ მონაცემთა ნაკრებების შექმნის მიზნით გაწეულ ძალისხმევას. ინიციატივა მოიცავს მოთხოვნების (prompts) რანჟირების პროექტსა და მრავალენოვანი მოთხოვნების შეფასების პროექტს (MPEP), რომელიც მიზნად ისახავს ღია LLM-ებისთვის ენობრივი ბენჩმარკების გაუმჯობესებას. ხაზგასმულია საზოგადოების წვლილის მნიშვნელობა მყარი და ყოვლისმომცველი რესურსების შესაქმნელად.

BigCodeArena: კოდის გენერაციის ხელოვნური ინტელექტის მოდელების შეფასების ახალი სტანდარტი რეალური გაშვებით
BigCodeArena არის ინოვაციური პლატფორმა, რომელიც საშუალებას აძლევს მომხმარებლებს, შეადარონ ხელოვნური ინტელექტის კოდის გენერაციის მოდელები არა მხოლოდ კოდის წაკითხვით, არამედ მისი რეალური გაშვებით და შედეგების დანახვით. ის აგვარებს ტრადიციული შეფასების მეთოდების პრობლემებს, გვთავაზობს სანდბოქს გარემოებს კოდის ავტომატური გაშვებისთვის, მრავალსვლიან ინტერაქციებს და მომხმარებლის შეფასებებზე დაფუძნებულ ლიდერბორდს. პლატფორმა უკვე ლიდერბორდში აერთიანებს მოწინავე LLM-ების რეიტინგებს, აჩვენებს რა გამოკვეთილ

Google-ის Gemma 2: ღია LLM-ების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
Google-მა წარმოადგინა Gemma 2, მისი ღია დიდი ენობრივი მოდელების (LLM) უახლესი ვერსია, ხელმისაწვდომი 9 და 27 მილიარდი პარამეტრის ზომებში. Gemma DeepMind Gemini-ზეა დაფუძნებული და გამოირჩევა მნიშვნელოვანი გაუმჯობესებებით, მათ შორის გაორმაგებული საწვრთნელი მონაცემებით (13 ტრილიონი ტოკენი 27B ვერსიისთვის), ოპტიმიზებული დიალოგური აპლიკაციებისთვის და ახალი არქიტექტურული ინოვაციებით, როგორიცაა ჰიბრიდული მოძრავი ფანჯრის ყურადღება (sliding window attention) და რბილი ზღვრის დადგენა (soft capping). მოდელი
Transformers Agents-ის ტრიუმფი GAIA ბენჩმარკზე: აგენტური სისტემების ახალი ერა
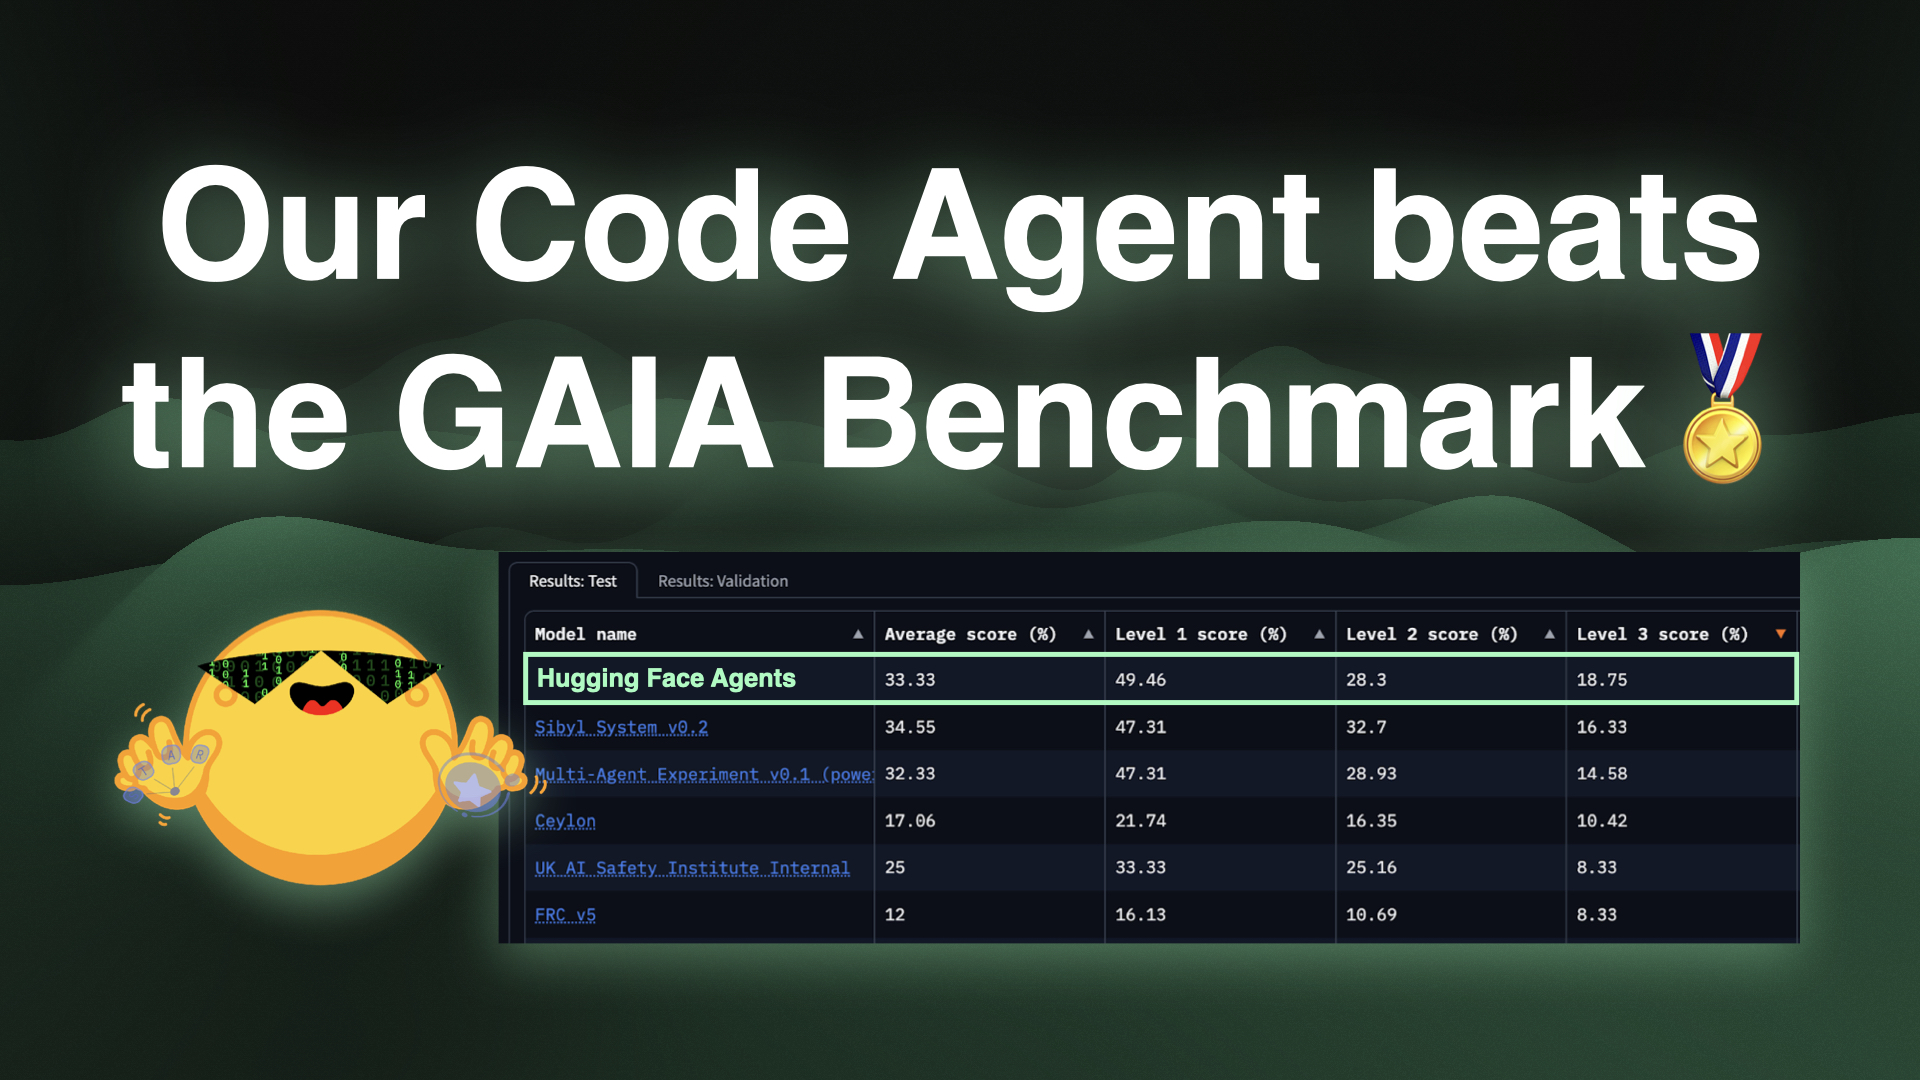
ექსპერიმენტების სერიის შემდეგ, ჩვენზე დიდი შთაბეჭდილება მოახდინა Transformers Agents-ის შესაძლებლობებმა აგენტური სისტემების შექმნაში. GAIA ბენჩმარკზე, რომელიც ყველაზე რთულ და ყოვლისმომცველ აგენტურ ბენჩმარკად ითვლება, ბიბლიოთეკის გამოყენებით შექმნილმა Code Agent-მა მოწინავე პოზიციები დაიკავა. აღნიშნული ფრეიმვორკი, transformers.agents, ახლა განახლებულია და ფუნქციონირებს, როგორც დამოუკიდებელი ბიბლიოთეკა smolagents. სტატია განმარტავს აგენტების კონცეფციას, როგორც LLM-ზე დაფუძნებულ სისტემებს, რომლებსა
smolagents-მა GAIA ბენჩმარკზე საუკეთესო შედეგი აჩვენა
ექსპერიმენტების შემდეგ, Transformers აგენტების (ახლა უკვე smolagents ბიბლიოთეკა) მიერ აგებული აგენტური სისტემების შესაძლებლობებით მოხიბლულებმა, გადავწყვიტეთ შეგვემოწმებინა მათი ეფექტურობა. ჩვენ გამოვცადეთ ბიბლიოთეკის გამოყენებით შექმნილი კოდის აგენტი GAIA ბენჩმარკზე, რომელიც ითვლება აგენტების ყველაზე რთულ და ყოვლისმომცველ ტესტად, და საბოლოოდ, საუკეთესო შედეგი ვაჩვენეთ. სტატია განმარტავს, თუ რა არის აგენტები, როგორ აძლევენ ისინი LLM-ებს სუპერ შესაძლებლობებს და რა ინსტრუმენტები გამოიყენეს GAIA-ს რ
MIT-ის ახალი მიდგომა: მცირე ენის მოდელები ერთობლივი მუშაობით დიდებს ჯობნიან
მიუხედავად იმისა, რომ ენის მოდელები (LMs) უმჯობესდებიან სხვადასხვა ამოცანებში, მათ მაინც უჭირთ რთული და მკაცრი წესების მქონე მოთხოვნების შესრულება. ამ პრობლემის გადასაჭრელად, MIT-ის მკვლევრებმა შეიმუშავეს „DisCIPL“ – თანამშრომლობითი მიდგომა, სადაც დიდი ენის მოდელი (LLM) გეგმავს ამოცანას, შემდეგ კი მის შესრულებას მცირე მოდელებს ანაწილებს. ეს მეთოდი მცირე ენის მოდელებს საშუალებას აძლევს, მიაწოდონ უფრო ზუსტი და ეფექტური პასუხები, ვიდრე წამყვან LLM-ებს, როგორიცაა GPT-4o, და მიუახლოვდნენ მაღალი დონის
„PaTH Attention“: MIT-ის მკვლევრები ტრანსფორმერების „პოზიციურ მეხსიერებას“ აუმჯობესებენ
MIT-ისა და MIT-IBM Watson AI Lab-ის მკვლევრებმა შეიმუშავეს ახალი AI კოდირების ტექნიკა, სახელად „PaTH Attention“, რომელიც მიზნად ისახავს დიდი ენობრივი მოდელების (LLMs) შეზღუდვების დაძლევას მდგომარეობის თვალთვალისა და თანმიმდევრული მსჯელობის კუთხით. არსებული „ყურადღების მექანიზმები“ ვერ აღიქვამენ სიტყვების თანმიმდევრობას ისე ეფექტურად, როგორც საჭიროა. „PaTH Attention“ პოზიციურ ინფორმაციას ადაპტირებადს და კონტექსტის გათვალისწინებით ამუშავებს, სტატიკური მეთოდებისგან განსხვავებით, რითაც აუმჯობესებს მ