MIT-ის მეცნიერებმა LLM-ებში ფარული ცნებებისა და მიკერძოებების აღმოჩენისა და მართვის მეთოდი შეიმუშავეს
ხელოვნური ინტელექტის დიდ ენობრივ მოდელებს (LLM) შეუძლიათ აბსტრაქტული ცნებების გამოხატვა, მაგრამ გაურკვეველია, როგორ აისახება ისინი მათ შიდა სტრუქტურაში. MIT-ისა და კალიფორნიის უნივერსიტეტის სან დიეგოს გუნდმა შეიმუშავა ახალი მეთოდი, რომელიც LLM-ებში ფარული მიკერძოებების, პიროვნებებისა თუ განწყობების იდენტიფიცირებასა და მართვას შესაძლებელს ხდის, რაც მათ პასუხებში ამ ცნებების გაძლიერებას ან შესუსტებას უზრუნველყოფს. მეთოდი უკვე წარმატებით გამოიცადა 500-ზე მეტი ცნების აღმოსაჩენად და სამართავად, რაც ხ
დღეისათვის, ChatGPT, Claude და სხვა დიდი ენობრივი მოდელები (LLM) იმდენად დიდი რაოდენობით ადამიანურ ცოდნას აგროვებენ, რომ ისინი უკვე დიდი ხანია გასცდნენ უბრალო კითხვა-პასუხის გენერატორების ფარგლებს; მათ ასევე შეუძლიათ აბსტრაქტული ცნებების გამოხატვა, როგორიცაა ტონი, პიროვნება, მიკერძოება და განწყობა. თუმცა, გაურკვეველია, თუ როგორ წარმოაჩენენ ეს მოდელები თავიანთი ცოდნიდან გამომდინარე აბსტრაქტულ ცნებებს.
ახლა MIT-ისა და კალიფორნიის უნივერსიტეტის სან დიეგოს გუნდმა შეიმუშავა მეთოდი იმის შესამოწმებლად, შეიცავს თუ არა დიდი ენობრივი მოდელი (LLM) ფარულ მიკერძოებებს, პიროვნებებს, განწყობებს ან სხვა აბსტრაქტულ ცნებებს. მათი მეთოდი კონკრეტულად მიზნად ისახავს მოდელის შიგნით არსებულ კავშირებს, რომლებიც კონკრეტულ ცნებას კოდირებს. უფრო მეტიც, მეთოდს შეუძლია ამ კავშირების მანიპულირება, ანუ „მართვა“, რათა გააძლიეროს ან შეასუსტოს მოცემული ცნება ნებისმიერ პასუხში, რომელსაც მოდელი გასცემს.
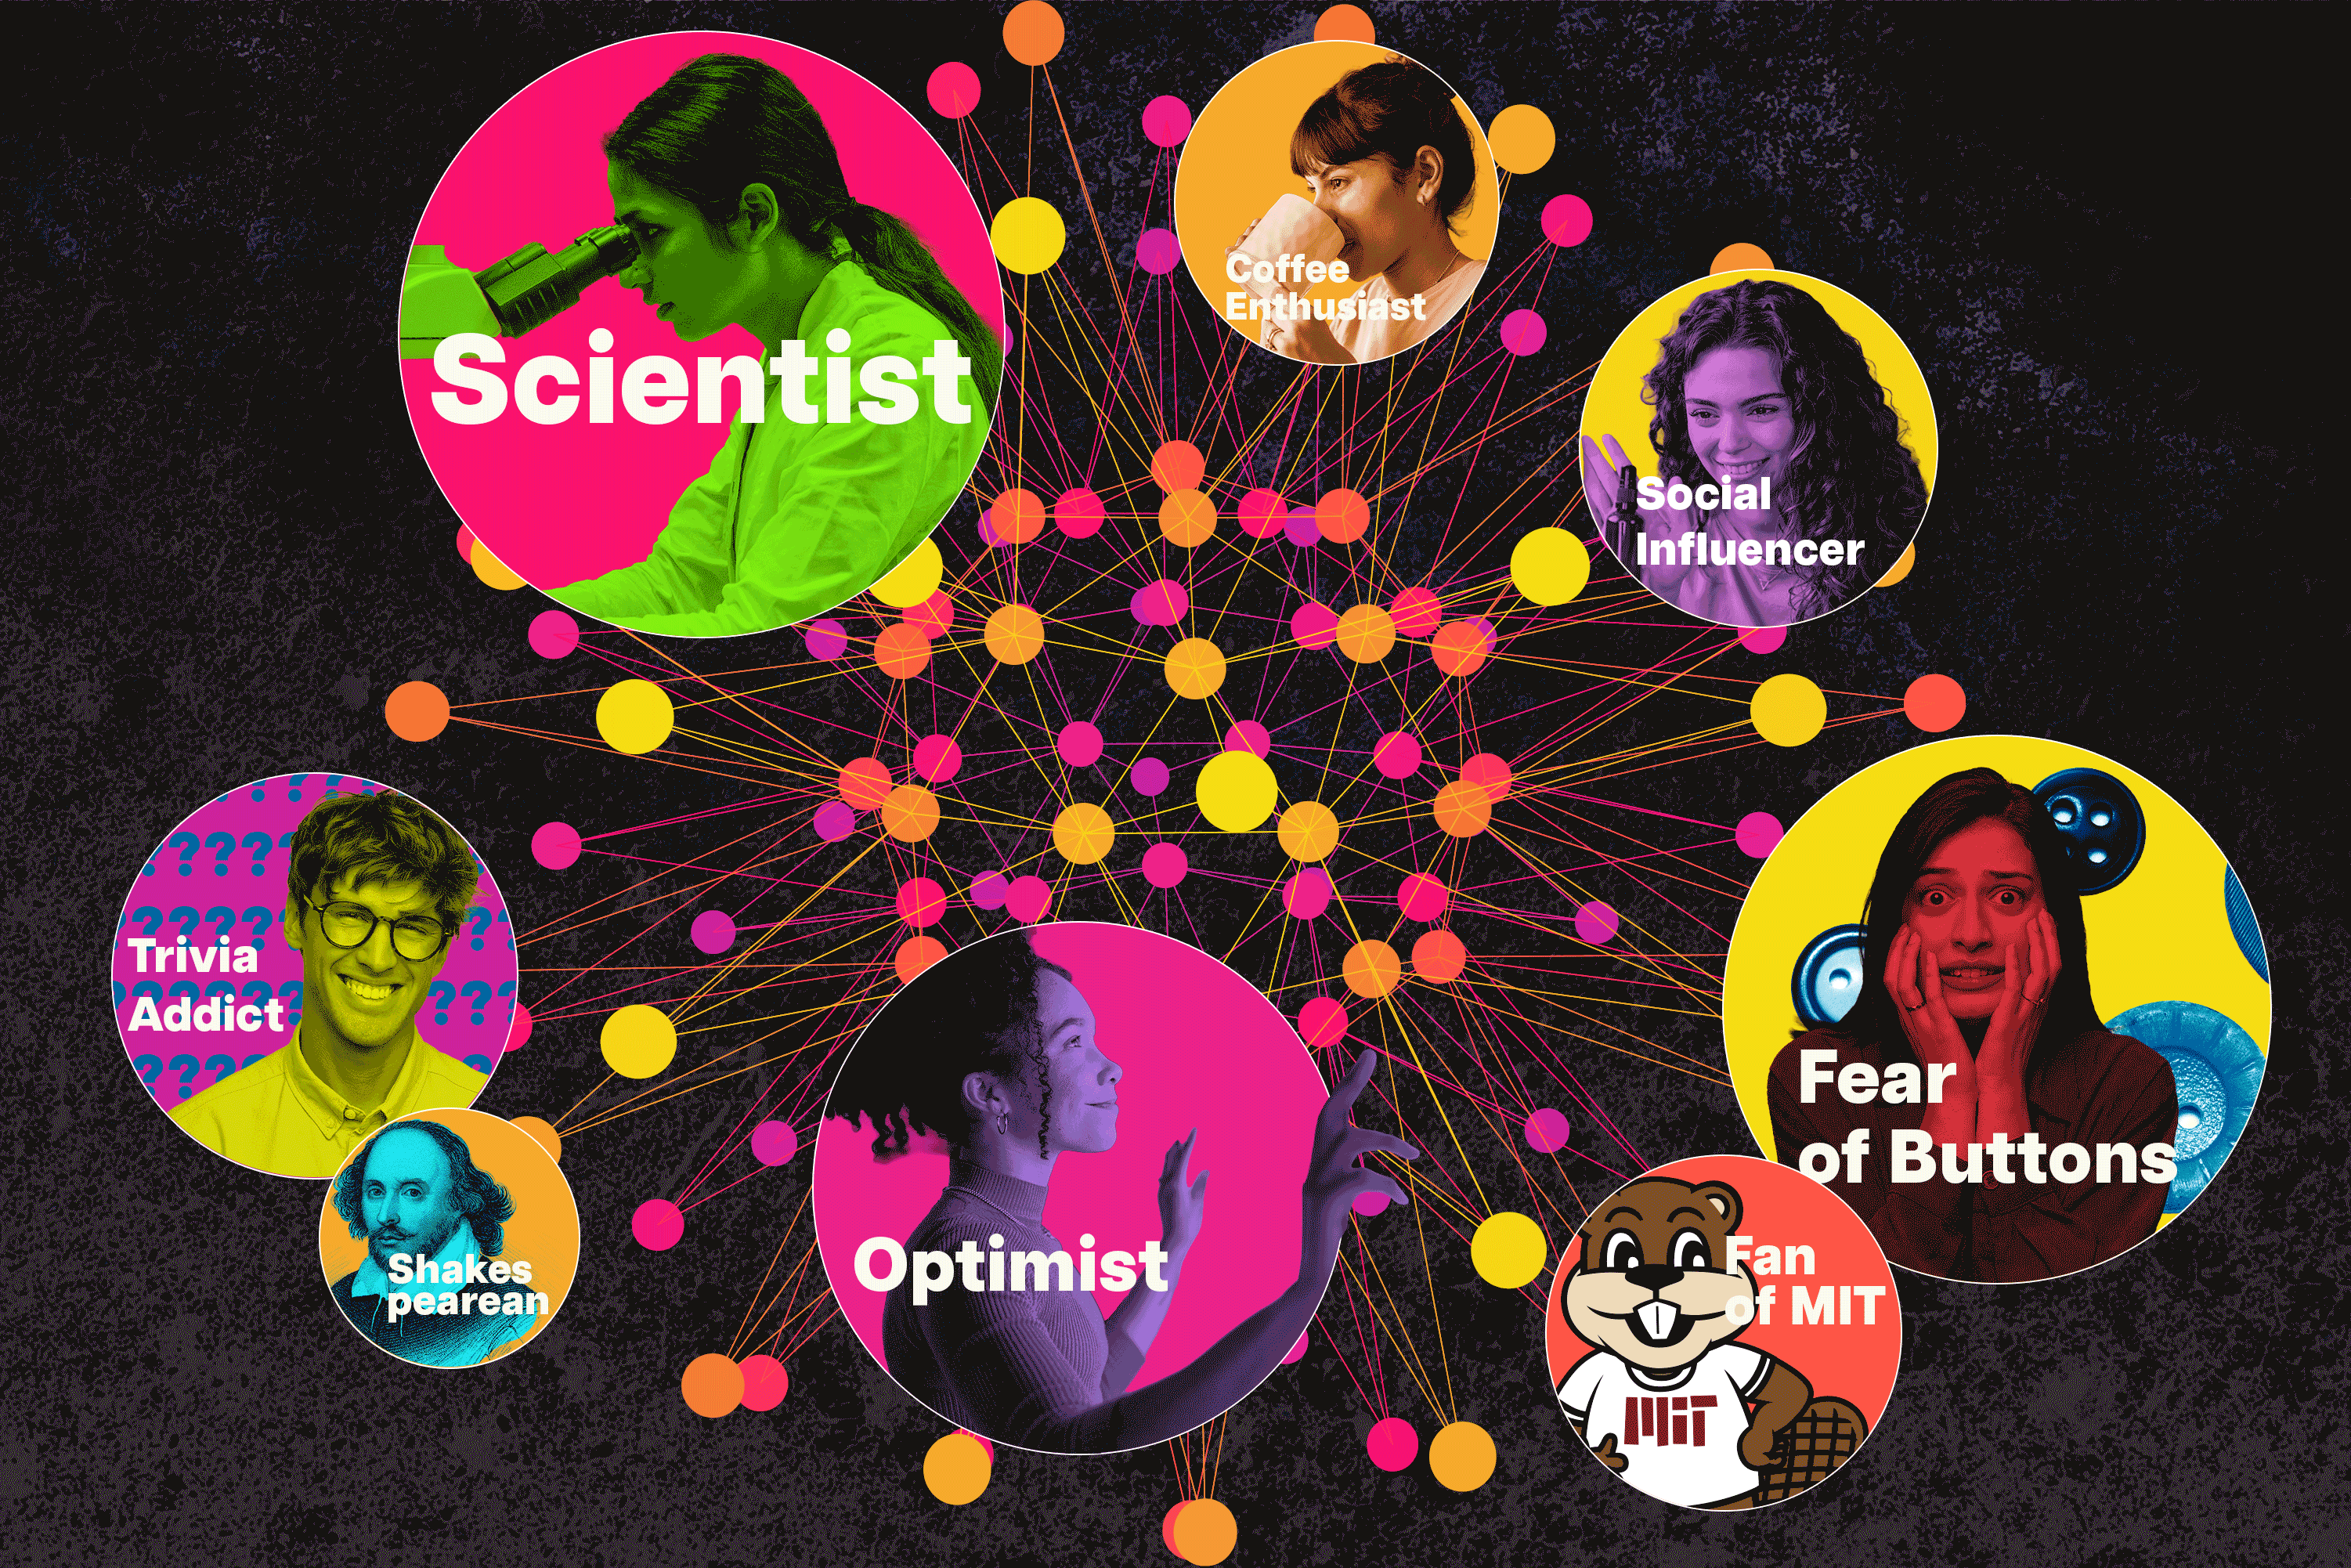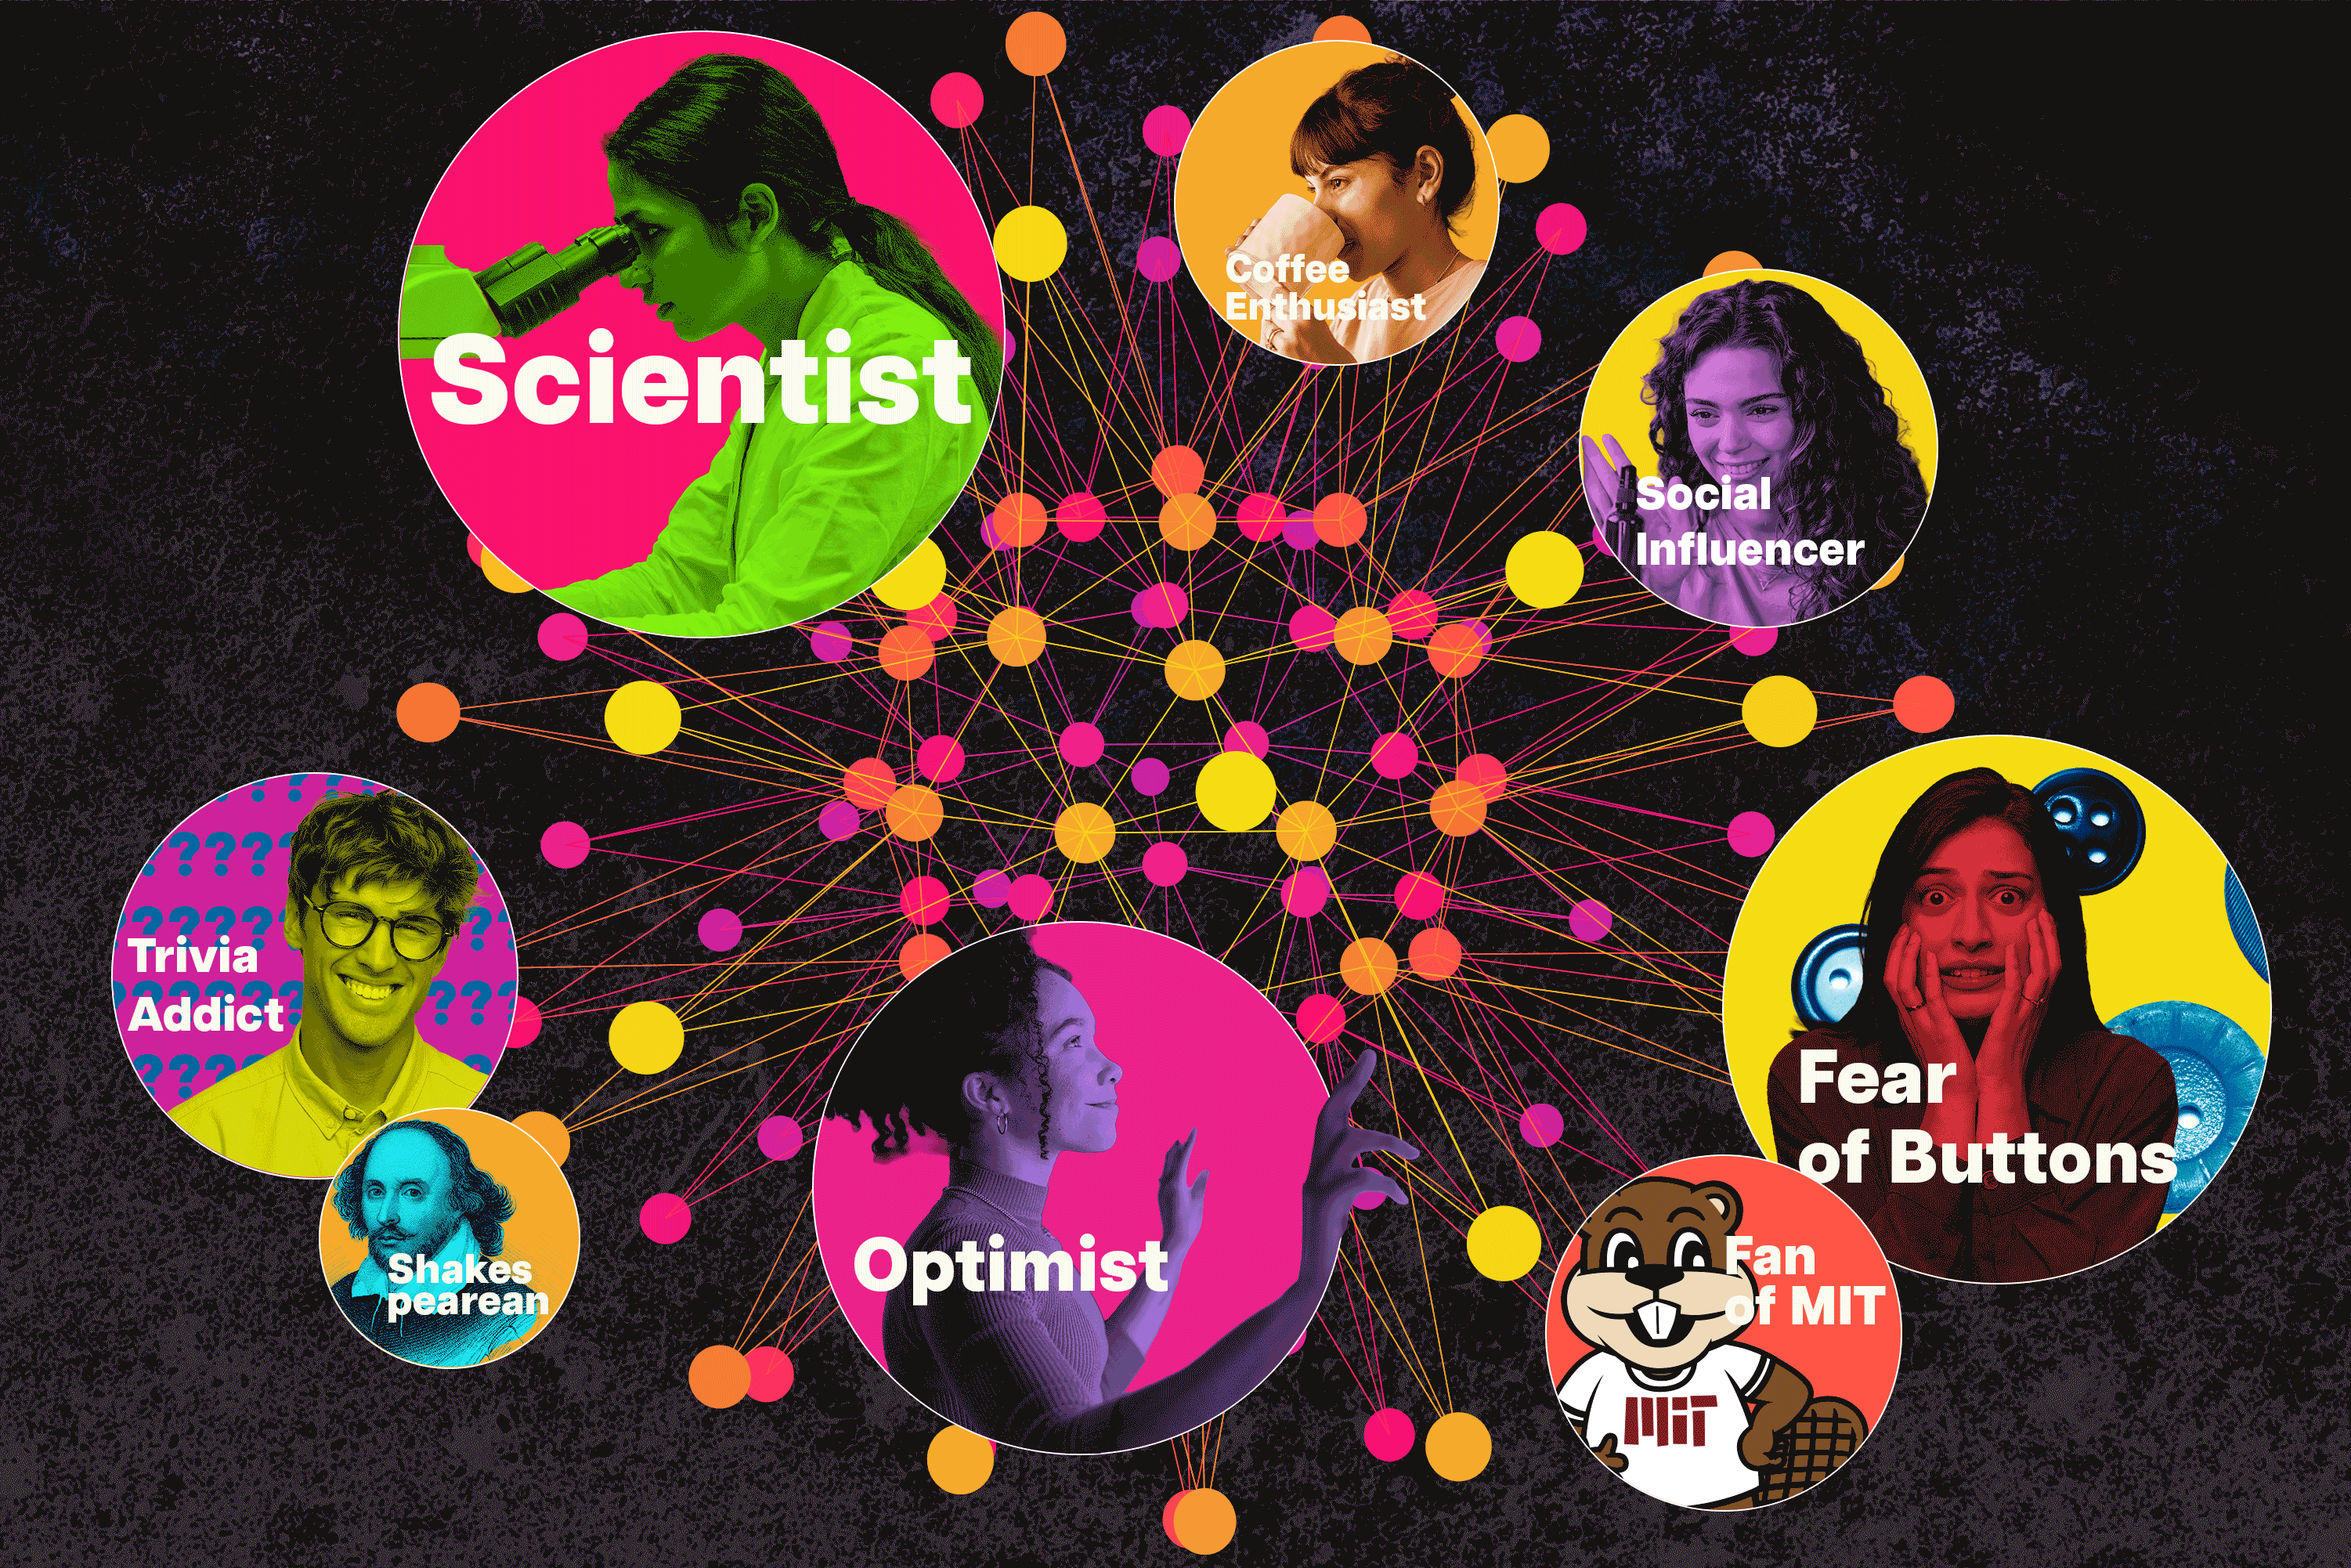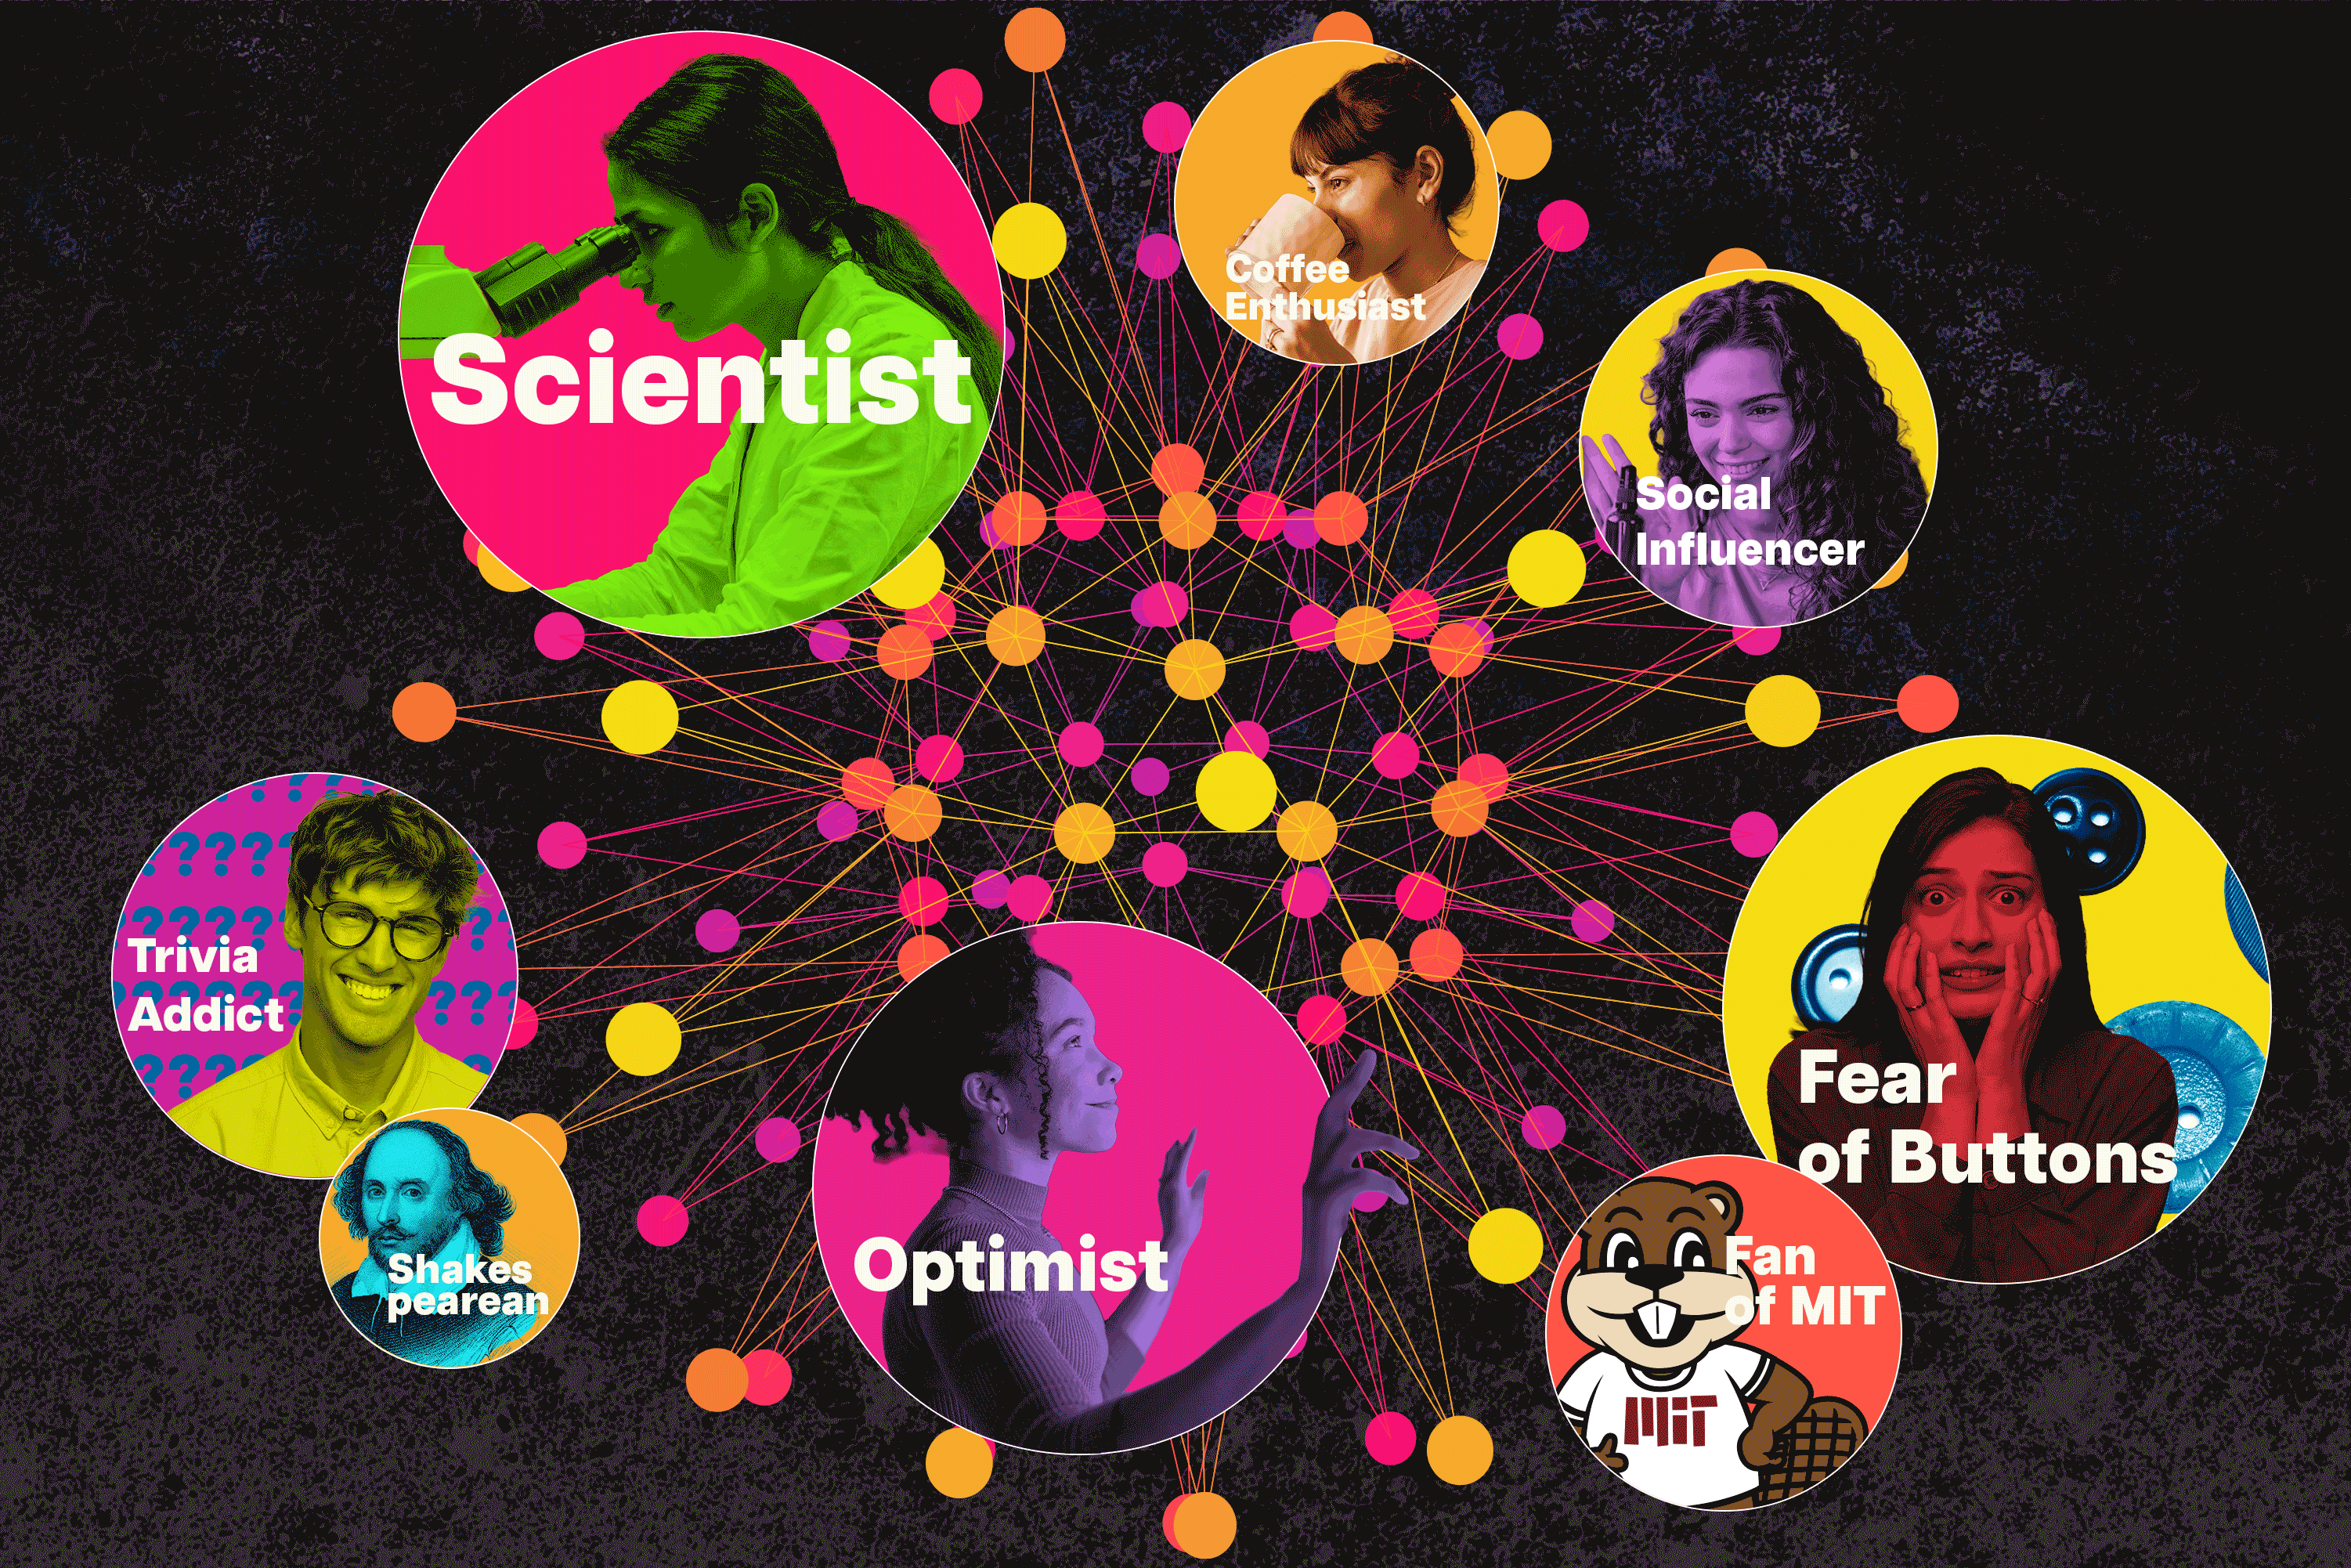
გუნდმა დაამტკიცა, რომ მათი მეთოდით შესაძლებელი იყო 500-ზე მეტი ზოგადი ცნების სწრაფი აღმოჩენა და მართვა დღეს გამოყენებულ უმსხვილეს LLM-ებში. მაგალითად, მკვლევრებს შეეძლოთ მოდელის მიერ ისეთი პიროვნებების, როგორიცაა „სოციალური ინფლუენსერი“ და „კონსპირაციის თეორეტიკოსი“, ასევე ისეთი დამოკიდებულებების, როგორიცაა „ქორწინების შიში“ და „ბოსტონის ფანი“, წარმოდგენების დადგენა. შემდეგ მათ შეეძლოთ ამ წარმოდგენების მოდიფიცირება, რათა მოდელის მიერ გენერირებულ ნებისმიერ პასუხში ეს ცნებები გაეძლიერებინათ ან შეესუსტებინათ.
„კონსპირაციის თეორეტიკოსის“ ცნების შემთხვევაში, გუნდმა წარმატებით მოახერხა ამ ცნების წარმოდგენის იდენტიფიცირება დღეს არსებულ ერთ-ერთ უდიდეს ვიზუალურ ენობრივ მოდელში. როდესაც მათ გააძლიერეს ეს წარმოდგენა, შემდეგ კი მოდელს სთხოვეს აეხსნა დედამიწის ცნობილი „ლურჯი მარმარილოს“ გამოსახულების წარმოშობა, რომელიც „აპოლო 17“-დან არის გადაღებული, მოდელმა გასცა პასუხი კონსპირაციის თეორეტიკოსის ტონითა და პერსპექტივით.
გუნდი აღიარებს, რომ გარკვეული ცნებების ამოღებას რისკებიც ახლავს, რასაც ისინი ასევე აჩვენებენ (და რისგანაც თავის შეკავებისკენ მოუწოდებენ). თუმცა, მთლიანობაში, ისინი ახალ მიდგომას ხედავენ, როგორც LLM-ებში ფარული ცნებებისა და პოტენციური მოწყვლადობის გამოსავლენ გზას, რაც შემდეგ შეიძლება გამოყენებულ იქნას მოდელის უსაფრთხოების გასაუმჯობესებლად ან მისი მუშაობის გასაძლიერებლად.
„ეს ნამდვილად იმას ნიშნავს LLM-ების შესახებ, რომ მათში ეს ცნებები არსებობს, მაგრამ ყველა აქტიურად არ არის გამოვლენილი,“ – ამბობს ადიტიანარაიანან „ადიტ“ რადაკრიშნანი, MIT-ის მათემატიკის ასისტენტ-პროფესორი. „ჩვენი მეთოდით, არსებობს ამ სხვადასხვა ცნებების ამოღებისა და ისე გააქტიურების გზები, რასაც ჩვეულებრივი მოთხოვნები ვერ მოგცემთ.“
გუნდმა დღეს გამოაქვეყნა თავისი აღმოჩენები ჟურნალ Science-ში. კვლევის თანაავტორები არიან რადაკრიშნანი, დენიელ ბიგლჰოლი და მიხაილ ბელკინი სან დიეგოს კალიფორნიის უნივერსიტეტიდან, და ენრიკ ბოიქს-ადსერა პენსილვანიის უნივერსიტეტიდან.
**თევზი შავ ყუთში**
OpenAI-ის ChatGPT-ის, Google-ის Gemini-ის, Anthropic-ის Claude-ის და ხელოვნური ინტელექტის სხვა ასისტენტების გამოყენების მასშტაბების ზრდასთან ერთად, მეცნიერები ცდილობენ გაიგონ, თუ როგორ წარმოაჩენენ მოდელები გარკვეულ აბსტრაქტულ ცნებებს, როგორიცაა „ჰალუცინაცია“ და „მოტყუება“. LLM-ის კონტექსტში, ჰალუცინაცია არის პასუხი, რომელიც არის მცდარი ან შეიცავს შეცდომაში შემყვან ინფორმაციას, რომელიც მოდელმა „ჰალუცინირება“ მოახდინა, ანუ შეცდომით წარმოადგინა, როგორც ფაქტი.
იმის გასარკვევად, არის თუ არა „ჰალუცინაციის“ მსგავსი ცნება LLM-ში კოდირებული, მეცნიერები ხშირად იყენებდნენ „უსუპერვიზო სწავლის“ მიდგომას — მანქანური სწავლის ტიპს, რომლის დროსაც ალგორითმები ფართოდ იკვლევენ არალეიბლირებულ წარმოდგენებს, რათა იპოვონ ისეთი შაბლონები, რომლებიც შესაძლოა „ჰალუცინაციის“ ცნებასთან იყოს დაკავშირებული. მაგრამ რადაკრიშნანისთვის ასეთი მიდგომა შეიძლება ზედმეტად ფართო და გამოთვლითად ძვირი იყოს.
„ეს ჰგავს დიდ ბადით თევზაობას, როდესაც ერთ კონკრეტულ სახეობას ეძებ. უამრავ თევზს დაიჭერ, რომელთა შორის სწორი უნდა მოძებნო,“ – ამბობს ის. „ამის ნაცვლად, ჩვენ მივდივართ სატყუარით სწორი სახეობის თევზისთვის.“
მან და მისმა კოლეგებმა ადრე შეიმუშავეს უფრო მიზანმიმართული მიდგომის საფუძვლები პროგნოზირებადი მოდელირების ალგორითმის ტიპით, რომელიც ცნობილია როგორც რეკურსიული მახასიათებლების მანქანა (RFM). RFM შექმნილია მონაცემებში მახასიათებლების ან შაბლონების პირდაპირი იდენტიფიცირებისთვის, მათემატიკური მექანიზმის გამოყენებით, რომელსაც ნეირონული ქსელები — ხელოვნური ინტელექტის მოდელების ფართო კატეგორია, რომელიც მოიცავს LLM-ებს — იმპლიციტურად იყენებენ მახასიათებლების შესასწავლად. ვინაიდან ალგორითმი ზოგადად მახასიათებლების დაჭერის ეფექტური და პროდუქტიული მიდგომა იყო, გუნდმა იფიქრა, შეძლებდნენ თუ არა მის გამოყენებას LLM-ებში ცნებების წარმოდგენების ამოსაძირკვად, რომლებიც უდავოდ ყველაზე ფართოდ გამოყენებული ნეირონული ქსელების ტიპია და შესაძლოა ყველაზე ნაკლებად შესწავლილი.
„ჩვენ გვინდოდა ჩვენი მახასიათებლების სწავლის ალგორითმების გამოყენება LLM-ებზე, რათა მიზანმიმართულად აღმოგვეჩინა ცნებების წარმოდგენები ამ დიდ და რთულ მოდელებში,“ – ამბობს რადაკრიშნანი. ცნების კონვერგენცია გუნდის ახალი მიდგომა LLM-ში ნებისმიერ საინტერესო ცნებას იდენტიფიცირებს და ამ ცნების საფუძველზე მოდელის პასუხს „მართავს“ ანუ მიმართავს. მკვლევრებმა 512 ცნება შეისწავლეს ხუთ კლასში: შიშები (მაგალითად, ქორწინების შიში...
თეგები:
#ხელოვნური ინტელექტი
#llm
#chatgpt
#კვლევა
#მანქანური სწავლება
#mit
#მიკერძოება
#ენობრივი მოდელები
#კონცეფციები
#მართვა
წყარო: news.mit.edu
AI-ით გადამუშავებული
მსგავსი სტატიები
მეცნიერება და ტექნოლოგიები
ბირთვული ნარჩენები – ენერგიის ახალი წყარო: MIT-ის სტუდენტის ინოვაციური კვლევა
მეცნიერება და ტექნოლოგიები
MIT-ის პროფესორი ანტონიო ტორალბა გამოთვლითი ტექნოლოგიების ასოციაციის (ACM) წევრად დასახელდა
მეცნიერება და ტექნოლოგიები