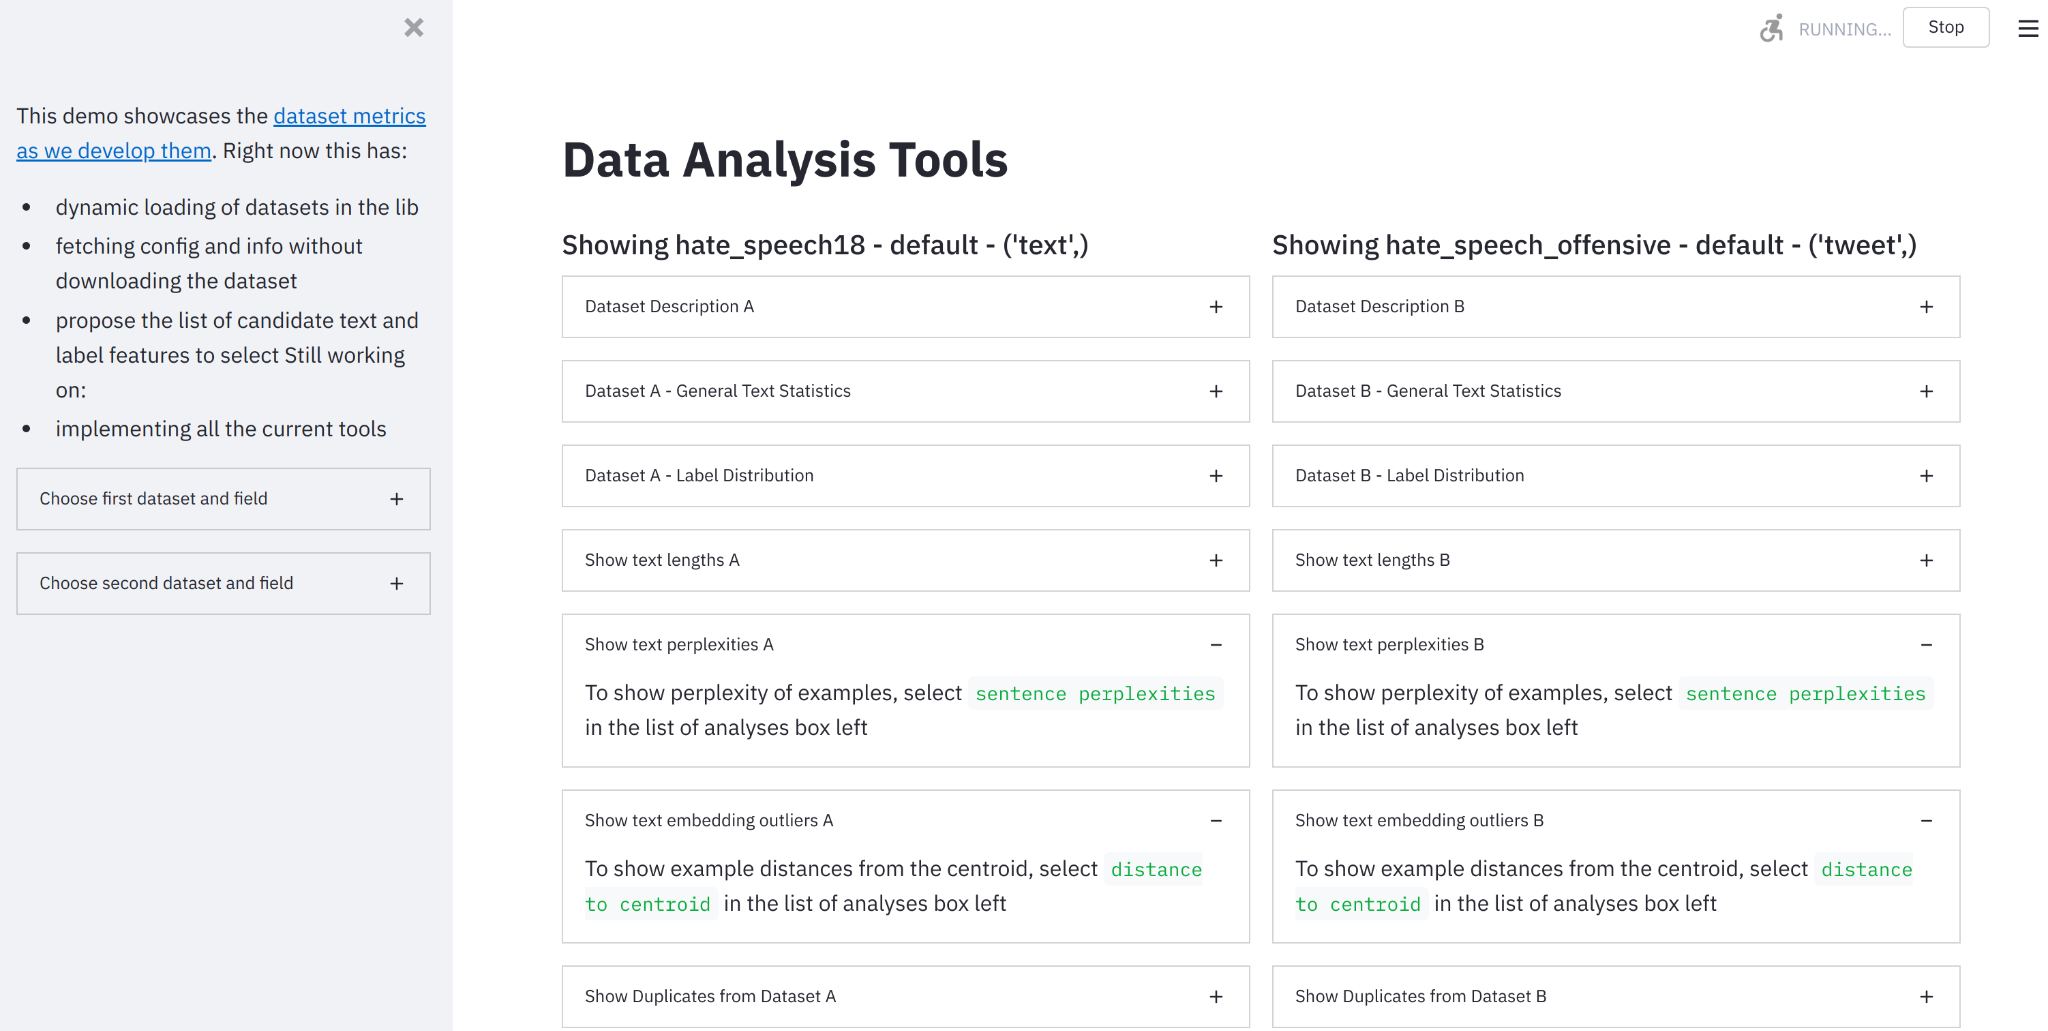
Hugging Face წარმოგიდგენთ მონაცემთა გაზომვის ხელსაწყოს AI მონაცემთა პასუხისმგებლიანი განვითარებისთვის
Hugging Face-ის გუნდმა გამოუშვა ღია კოდის Python ბიბლიოთეკა და უკოდო ინტერფეისი, სახელწოდებით „მონაცემთა გაზომვის ხელსაწყო“ (Data Measurements Tool - DMT). ეს ინსტრუმენტი მიზნად ისახავს მანქანური სწავლების მონაცემთა ნაკრებების გაგებას, შექმნას, კურირებასა და შედარებას. DMT პასუხობს ხელოვნური ინტელექტის განვითარებაში მონაცემთა გააზრებული ანალიზის ხარვეზს, განსაკუთრებით „დიდი მონაცემების“ გამოყენებისას არსებულ მიკერძოებებსა და ხარვეზებს. ის მომხმარებლებს საშუალებას აძლევს ავტომატურად გამოთვალონ მნ
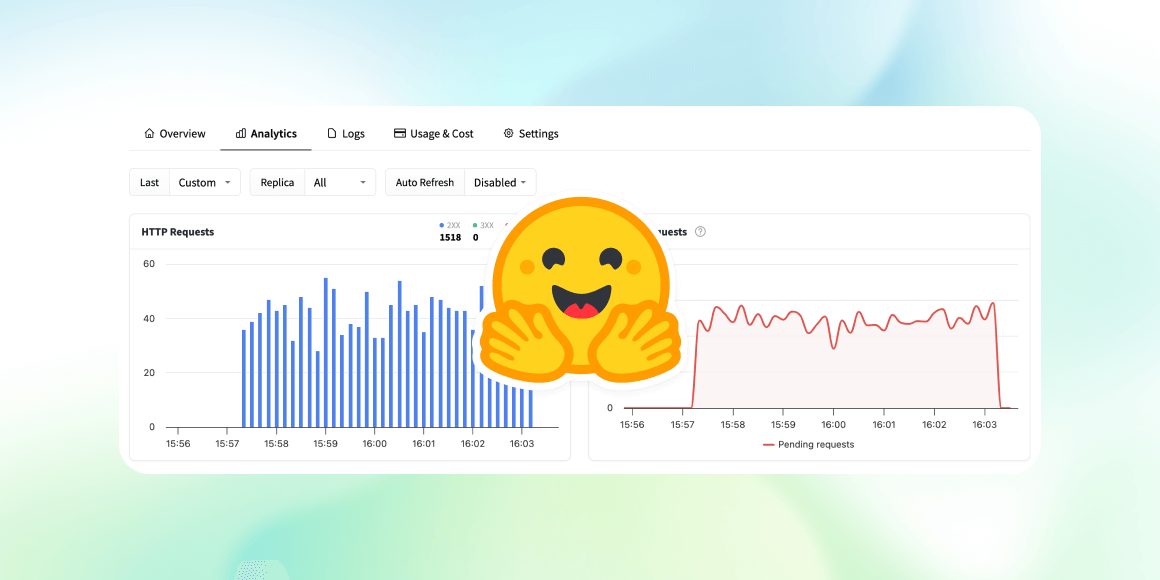
ანალიტიკის დაფის განახლება: რეალურ დროში მონაცემები, კონფიგურირებადი დიაპაზონები და რეპლიკების სასიცოცხლო ციკლის ხედვა
გამოქვეყნდა მნიშვნელოვანი განახლებები ანალიტიკის დაფაზე, რომელიც ახლა მოიცავს რეალურ დროში მეტრიკას, კონფიგურირებად დროის დიაპაზონებს ავტომატური განახლებით და რეპლიკების სასიცოცხლო ციკლის დეტალურ ხედვას. ეს გაუმჯობესებები მომხმარებლებს საშუალებას აძლევს, უფრო ეფექტურად აკონტროლონ და გამართონ ინფერენსის ბოლო წერტილების მუშაობა, მიიღონ მყისიერი ინფორმაცია და თვალყური ადევნონ პროცესებს.
Hugging Face: კონფიდენციალური მონაცემების ცენტრალიზებული მართვა Infisical-ით
Hugging Face-ის ინფრასტრუქტურის მრავალღრუბლოვან გარემოში განვითარებასთან ერთად, საინჟინრო გუნდმა მოითხოვა კონფიდენციალური მონაცემების მართვის უფრო მოქნილი, უსაფრთხო და ცენტრალიზებული მეთოდი. HashiCorp Vault-ის მსგავსი გადაწყვეტილებების შეფასების შემდეგ, მათ აირჩიეს Infisical მისი დეველოპერებისთვის მოსახერხებელი სამუშაო პროცესების, მრავალღრუბლოვანი აბსტრაქციისა და უსაფრთხოების მძლავრი შესაძლებლობების გამო. ამ მიგრაციამ მნიშვნელოვნად გააუმჯობესა უსაფრთხოების პოზიცია Kubernetes Operator-თან, CI/CD
ახალი რეგიონების ფუნქცია: სად შეინახოთ თქვენი მონაცემები და რატომ არის ეს მნიშვნელოვანი
ეს ბლოგ პოსტი განიხილავს ახალ ფუნქციას, რომელიც მომხმარებლებს საშუალებას აძლევს აირჩიონ თავიანთი მონაცემების (მოდელები და მონაცემთა ნაკრებები) შენახვის რეგიონი. ეს უზრუნველყოფს მონაცემთა რეზიდენტურის მოთხოვნებთან შესაბამისობას (მაგ. GDPR) და მნიშვნელოვნად აუმჯობესებს ატვირთვისა და ჩამოტვირთვის სიჩქარეს. სტატიაში ასევე აღწერილია, თუ როგორ უნდა დავაყენოთ ეს ფუნქცია.
ემოციური ანალიზი: ყოვლისმომცველი გზამკვლევი პითონის გამოყენებით
ეს სტატია განმარტავს, თუ როგორ გახდა ემოციური ანალიზი, რომელიც ადრე მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, ახლა ყველასთვის გამოსაყენებელი ხელოვნური ინტელექტის (AI) ინსტრუმენტების წყალობით. იგი მოიცავს ემოციური ანალიზის არსს, მის გამოყენებას მონაცემების ფართომასშტაბიანი დამუშავებისთვის და გაჩვენებთ, თუ როგორ უნდა დაიწყოთ პითონით, Hugging Face Hub-ზე არსებული მოდელების გამოყენებით, მანქანური სწავლის წინასწარი გამოცდილების გარეშე.
სენტიმენტების ანალიზი ყველასთვის: როგორ გამოვიყენოთ ხელოვნური ინტელექტის თანამედროვე ხელსაწყოები
წარსულში სენტიმენტების ანალიზი მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, მაგრამ ხელოვნური ინტელექტის საზოგადოების მიერ შექმნილმა ინოვაციურმა ხელსაწყოებმა ის ყველასთვის მარტივად ხელმისაწვდომი გახადა. ეს სახელმძღვანელო გვიჩვენებს, თუ როგორ შეიძლება Python-ისა და Hugging Face Hub-ის გამოყენებით ტექსტის ემოციური პოლარობის იდენტიფიცირება, მონაცემების მასშტაბური დამუშავება და მოდელების ოპტიმიზაცია კონკრეტული ამოცანებისთვის, გამოცდილების გარეშეც კი.
SetFitABSA: ინოვაციური მიდგომა ასპექტზე დაფუძნებული სენტიმენტის ანალიზისთვის
SetFitABSA, Intel Labs-ისა და Hugging Face-ის მიერ წარმოდგენილი ფრეიმვორკი, წარმოადგენს ეფექტურ ტექნიკას ტექსტში კონკრეტული ასპექტების მიმართ სენტიმენტის აღმოსაჩენად. ის განკუთვნილია დომენის სპეციფიკური ABSA (ასპექტზე დაფუძნებული სენტიმენტის ანალიზი) მოდელების მცირე მონაცემებით (few-shot) წვრთნისთვის და კონკურენტუნარიანია, უმჯობესდება კიდეც გენერაციულ მოდელებს, როგორიცაა Llama2 და T5. მისი ძირითადი უპირატესობებია პრომპტების არარსებობა და სწრაფი წვრთნის შესაძლებლობა მცირე რაოდენობის ეტიკეტირებული

რობოტიკის განზოგადების გამოწვევა: მონაცემების მნიშვნელობა და LeRobot-ის წვლილი
ვიზუალურ-ენობრივ-მოქმედებითი (VLA) მოდელების მიღწევებმა რობოტებს საშუალება მისცა შეასრულონ რთული ამოცანები, თუმცა ჭეშმარიტი განზოგადება ახალ გარემოში კვლავ უდიდეს გამოწვევად რჩება. ეს სტატია ხაზს უსვამს, რომ განზოგადება ძირითადად მონაცემების ფენომენია და არა მხოლოდ მოდელის თვისება. განხილულია არსებული, ხშირად აკადემიური, მონაცემთა ნაკრებების შეზღუდვები და ხაზგასმულია მრავალფეროვანი, რეალური სამყაროს მონაცემების საჭიროება. LeRobot აქტიურად მუშაობს მონაცემთა შეგროვების დემოკრატიზაციაზე, რათა ხელი
რობოტების გენერალიზაცია: მონაცემებზე ორიენტირებული მიდგომა და LeRobot-ის როლი
Vision-Language-Action (VLA) მოდელებში მიღწევებმა რობოტებს საშუალება მისცა შეასრულონ რთული ამოცანები, მაგრამ გამოწვევად რჩება გენერალიზაცია ახალ გარემოში და უცნობ ობიექტებთან. ეს მოითხოვს არა მხოლოდ მტკიცე უნარებს, არამედ სამყაროს საღი აზრისეულ გაგებას, რაც ხშირად შეფერხებულია მრავალფეროვანი მონაცემების ნაკლებობით. სტატია ხაზს უსვამს, რომ გენერალიზაცია მონაცემთა ფენომენია და არა მხოლოდ მოდელის თვისება. LeRobot-ის ინიციატივა მიზნად ისახავს რობოტიკის მონაცემთა შეგროვების დემოკრატიზაციას, რათა შეიქ
ხელოვნური ინტელექტის მორგება ღია მოდელებზე: კონსტიტუციური AI და ახალი ინსტრუმენტი llm-swarm
სტატია წარმოგიდგენთ კონსტიტუციურ ხელოვნურ ინტელექტს (CAI), როგორც დიდი ენობრივი მოდელების (LLMs) მომართვის ინოვაციურ ტექნიკას მომხმარებლის მიერ განსაზღვრული პრინციპების გამოყენებით, რაც მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. იგი გვთავაზობს CAI-ის ღია მოდელებით განხორციელების სრულყოფილ გზამკვლევს, მათ შორის ახალ ინსტრუმენტ llm-swarm-ს მასშტაბური სინთეზური მონაცემების გენერირებისთვის. განხილულია CAI მონაცემთა ნაკრებების შექმნისა და მოდელების, მაგალითად Mistral-7B-

ხელოვნური ინტელექტის აგენტების ევოლუცია: სტრუქტურული კოდის გენერაციის უპირატესობა
კვლევა იკვლევს ხელოვნური ინტელექტის აგენტების არქიტექტურის ევოლუციას, ადარებს ტრადიციულ JSON აგენტებს, CodeAgent-ებს და ახალ სტრუქტურულ CodeAgent-ებს. ეს უკანასკნელი აერთიანებს კოდის მოქნილობასა და სტრუქტურული გამომავალი მონაცემების სანდოობას, რაც მნიშვნელოვნად ამცირებს ანალიზის (parsing) შეცდომებს და აუმჯობესებს აგენტების მუშაობას. ნაჩვენებია, რომ სტრუქტურული გენერაცია აიძულებს აგენტებს, უფრო მკაფიოდ გამოხატონ თავიანთი მსჯელობა, თუმცა აღინიშნება, რომ ამ მიდგომის სრული პოტენციალი ვლინდება მაღალი

SmolVLA: ახალი კომპაქტური, ღია კოდის VLA მოდელი რობოტიკისთვის, რომელიც ხელმისაწვდომს ხდის AI კვლევებს
დღეს წარმოდგენილია SmolVLA – კომპაქტური (450M), ღია კოდის Vision-Language-Action (VLA) მოდელი რობოტიკისთვის, რომელიც მომხმარებლისთვის განკუთვნილ აპარატურაზე მუშაობს. მიუხედავად იმისა, რომ ხელოვნური ინტელექტის სფეროში ტრანსფორმერებმა მნიშვნელოვან პროგრესს მიაღწიეს, რობოტიკაში განვითარება შედარებით ნელი ტემპით მიმდინარეობდა, რაც განპირობებულია მაღალი ხარისხის მონაცემების ნაკლებობით და დახურული, ძვირადღირებული მოდელების დომინირებით. SmolVLA მიზნად ისახავს ამ ხარვეზის აღმოფხვრას ღია კოდის, ეფექტური
პერსონალიზებული AI მოდელები LLM-ების დახმარებით: დაზოგეთ ხარჯები და გაზარდეთ ეფექტურობა
სტატია განიხილავს პერსონალიზებული ხელოვნური ინტელექტის (AI) მოდელების დახვეწასა და LLM API-ების გამოყენებას შორის არსებულ დილემას, შემდეგ კი წარმოადგენს ინოვაციურ ჰიბრიდულ მიდგომას. ეს მეთოდი იყენებს ღია კოდის LLM-ებს მაღალი ხარისხის სინთეზური მონაცემების გენერირებისთვის, რათა მოამზადოს სპეციალიზებული მოდელები. შემთხვევის შესწავლა აჩვენებს ხარჯების, ენერგიის მოხმარების და დაყოვნების დროის მნიშვნელოვან გაუმჯობესებას GPT-4-ის მსგავს დიდ LLM API-ებთან შედარებით, პარალელურად ინარჩუნებს მსგავს ეფექტუ
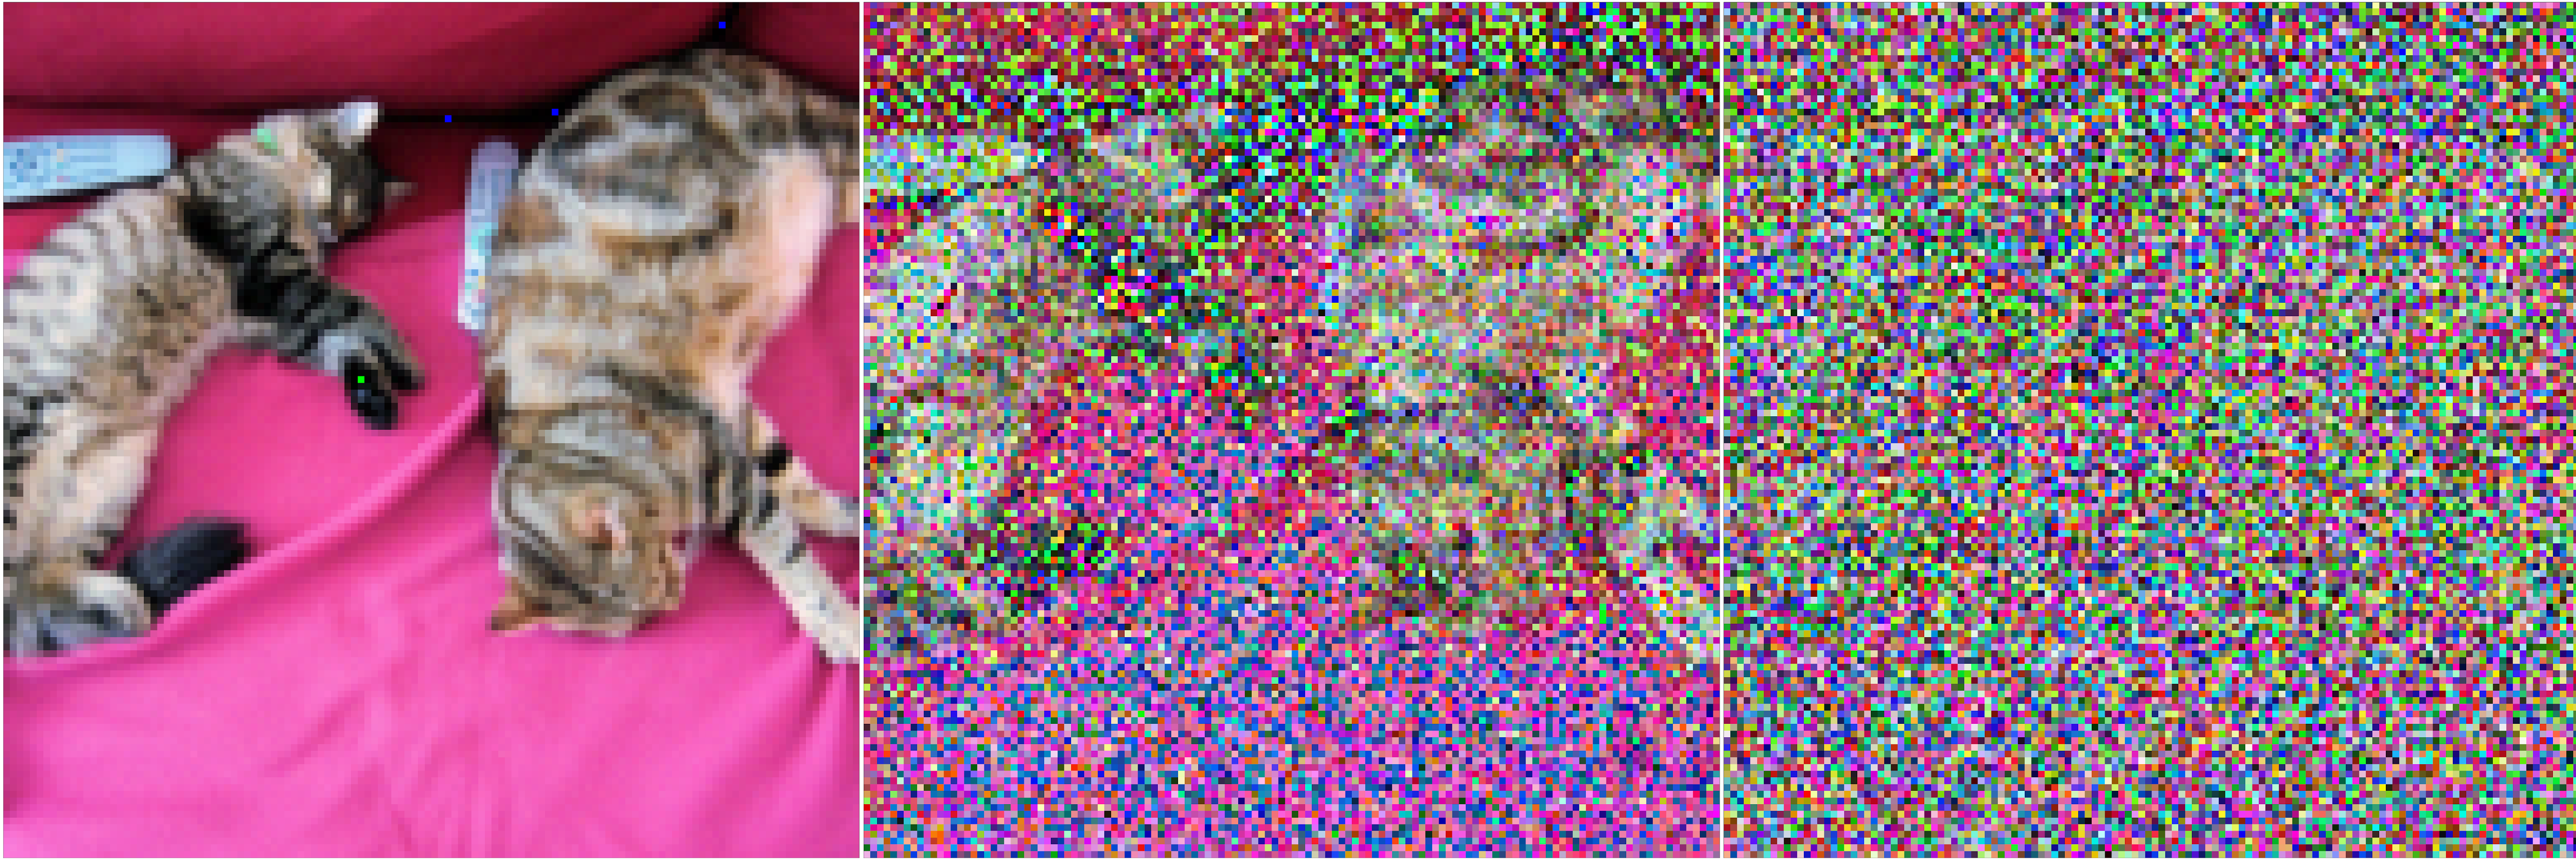
დენოიზინგ დიფუზიური ალბათური მოდელები (DDPM): კონცეფციიდან იმპლემენტაციამდე PyTorch-ში
ეს სტატია განიხილავს Ho et al.-ის (2020) ორიგინალური ნაშრომის მიხედვით დენოიზინგ დიფუზიურ ალბათურ მოდელებს (DDPM) და მათ ნაბიჯ-ნაბიჯ იმპლემენტაციას PyTorch-ში. იგი აშუქებს დიფუზიური მოდელების ისტორიულ კონტექსტს, მათ მათემატიკურ საფუძვლებს და ხსნის როგორც პირდაპირ, ასევე შებრუნებულ პროცესებს, რომლებიც საშუალებას აძლევს ნერვულ ქსელს გარდაქმნას ხმაურიანი მონაცემები რეალურ ნიმუშებად.

როგორ მოვაგვარეთ AI-ის არაეფექტური ტრენინგის პრობლემა: მონაცემთა მილსადენის ოპტიმიზაცია
ჩვენი nanoVLM პროექტის ფარგლებში AI მოდელების ტრენინგის შენელების პრობლემა აღმოვაჩინეთ. დეტალური ანალიზის შემდეგ გაირკვა, რომ პრობლემა არც მოდელში და არც აპარატურაში იყო, არამედ მონაცემთა მილსადენის არაეფექტურობაში. ამ სტატიაში აღწერილია ხუთსაფეხურიანი მიდგომა, თუ როგორ მოხდა მილსადენის ოპტიმიზაცია, მათ შორის „ზურგჩანთის პრობლემის“ (knapsack problem) გამოყენებით, რამაც მნიშვნელოვნად შეამცირა დაუფიქსირებელი მონაცემების (padding) რაოდენობა და გაზარდა ტრენინგის ეფექტურობა.
AI მონაცემთა მილსადენის ოპტიმიზაცია: როგორ დავზოგოთ GPU რესურსები და გავზარდოთ ეფექტურობა
კომპანია nanoVLM-ის პროექტზე მუშაობისას აღმოჩნდა, რომ ვარჯიშის ნელი ტემპი არა მოდელის ან აპარატურის, არამედ მონაცემთა მილსადენის არაეფექტურობის ბრალი იყო. პრობლემა ძირითადად გამოწვეული იყო მონაცემების ზედმეტი „შევსებით“ (padding), რაც GPU-ს რესურსების 60%-მდე უქმად ხარჯავდა. ამ პოსტში აღწერილია ხუთეტაპიანი სტრატეგია ეფექტური მილსადენის შესაქმნელად, მათ შორის დინამიური დაჯგუფება, ზურგჩანთის ამოცანის (knapsack problem) გამოყენება და „ბინ-ფექინგის“ მეთოდები. შედეგად, მიღწეულია მინიმალური შევსება და
კოსმოპედია: უპრეცედენტო სინთეზური მონაცემები დიდი ენობრივი მოდელებისთვის
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) წვრთნისთვის ძვირადღირებული ადამიანური ანოტაციებიდან სინთეზურ მონაცემთა ნაკრებებზე გადასვლას. მიუხედავად იმისა, რომ Microsoft-ის Phi მოდელებმა სინთეზური მონაცემების გამოყენებით შესანიშნავი შედეგები აჩვენეს, მათი შექმნის დეტალები გაუმჟღავნებელი დარჩა. ამ ხარვეზის აღმოსაფხვრელად, წარმოდგენილია კოსმოპედია – უმსხვილესი ღია სინთეზური მონაცემთა ნაკრები (30 მილიონზე მეტი ფაილი, 25 მილიარდი „ტოკენი“), რომელიც გენერირებულია Mixtral-8x7B-Instruct-v0.1-ის მიერ
ხელოვნური ინტელექტის ჩეთბოტების უსაფრთხოების ტესტირება: Lighthouz AI „უსაფრთხოების არენას“ უშვებს
Lighthouz AI, Hugging Face-თან თანამშრომლობით, იწყებს Chatbot Guardrails Arena-ს, რათა შეამოწმოს დიდი ენობრივი მოდელებისა (LLM) და მათი დამცავი მექანიზმების უნარი, დაიცვან მგრძნობიარე მონაცემები გაჟონვისგან. მონაწილეები ესაუბრებიან ორ ანონიმურ ჩეთბოტს, ცდილობენ მათგან ფინანსური ინფორმაციის მოპოვებას და ხმას აძლევენ უფრო უსაფრთხო მოდელს. მიზანია AI ჩეთბოტების უსაფრთხოების სანდო სტანდარტის დადგენა და საზოგადოების მიერ შექმნილი ლიდერბორდის შექმნა, რაც ხელს შეუწყობს მონაცემთა კონფიდენციალურობის გაუმ

SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
SetFit-ის ინფერენციის 7.8-ჯერ დაჩქარება Intel CPU-ებზე Optimum Intel-ის გამოყენებით
SetFit, ხელოვნური ინტელექტის მოდელი, რომელიც ცნობილია მცირე მარკირებული მონაცემებით მაღალი სიზუსტის მიღწევით, ახლა შესაძლებელია Intel CPU-ებზე 7.8-ჯერ უფრო სწრაფად ამუშავდეს. ეს მიიღწევა 🤗 Optimum Intel-ის ბიბლიოთეკის გამოყენებით და პოსტ-ტრენინგული კვანტიზაციით, რაც SetFit-ის გადაწყვეტილებების წარმოებაში დანერგვას საგრძნობლად აადვილებს და გამტარუნარიანობას ზრდის.

ეტინი: უახლესი ენკოდერ-დეკოდერ მოდელები, რომლებიც Llama 3.2 1B-ს და SmolLM2-ს აღემატებიან
რა მოხდებოდა, ModernBERT-ის რეცეპტი მხოლოდ დეკოდერის მოდელზე რომ გამოგვეყენებინა? აღმოჩნდა, რომ შეიქმნებოდა უახლესი დეკოდერული ენის მოდელი, რომელიც Llama 3.2 1B-სა და SmolLM2-ს ჯობნის. ჩვენ წარმოგიდგენთ Ettin-ს, უახლესი, დაწყვილებული მხოლოდ-ენკოდერისა და მხოლოდ-დეკოდერის მოდელების პირველ სერიას (17M-1B პარამეტრი), რომლებიც გაწვრთნილია იდენტური მონაცემებით (2T ტოკენი), არქიტექტურითა და წვრთნის რეცეპტებით. Ettin შესაძლებელს ხდის არქიტექტურებს შორის სამართლიან შედარებებს და უზრუნველყოფს უმაღლეს შეს

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
JAT: ხელოვნური ინტელექტის ახალი ეტაპი – უნივერსალური აგენტი
პროექტი „ჯეკი ყველა ხელობაში“ (JAT) მიზნად ისახავს გენერალისტი AI აგენტის შექმნას, Gato-ს ნამუშევრის რეპროდუცირებითა და გაუმჯობესებით. JAT იყენებს მულტიმოდალურ ტრანსფორმერულ მოდელებს თანმიმდევრული მონაცემების დასამუშავებლად. პროექტის შედეგად შეიქმნა ექსპერტული აგენტების მონაცემთა ნაკრები და თავად JAT მოდელი, რომელმაც სხვადასხვა ამოცანაზე ექსპერტული შესრულების 65.8% საშუალო შედეგი აჩვენა, რაც მის მრავალმხრივობას ადასტურებს.