
ევროპარლამენტმა დეპუტატებს სამუშაო მოწყობილობებზე AI ინსტრუმენტების გამოყენება აუკრძალა
ევროპარლამენტმა დეპუტატებს სამუშაო მოწყობილობებზე ხელოვნური ინტელექტის (AI) ინსტრუმენტების გამოყენება აუკრძალა, რის მიზეზადაც კიბერუსაფრთხოებისა და კონფიდენციალურობის რისკები დასახელდა. მონაცემების ღრუბელში ატვირთვა საფრთხეს ქმნის აშშ-ის ხელისუფლებისთვის ინფორმაციის გადაცემის კუთხით, ასევე იზრდება მგრძნობიარე მონაცემების გაზიარების ალბათობა. ეს გადაწყვეტილება მიღებულია იმ ფონზე, როდესაც ევროპა თავის მკაცრ მონაცემთა დაცვის წესებს გადააფასებს, აშშ-ის ტექნოლოგიური გიგანტების გავლენის გათვალისწინები

როგორ დავიცვათ ციფრული კონფიდენციალურობა მოწყობილობებიდან ქსელამდე
თანამედროვე ეპოქაში, ციფრული კონფიდენციალურობის შენარჩუნება მუდმივ ძალისხმევას მოითხოვს, რომელიც სცილდება ცალკეული მოწყობილობების დაცვას და ვრცელდება მთელ ლოკალურ ქსელზე (LAN). ეს სტატია განმარტავს, თუ როგორ შეგიძლიათ გააძლიეროთ თქვენი მონაცემების დაცვა, დაწყებული უსაფრთხო ბრაუზერებისა და აპლიკაციების გამოყენებით, დამთავრებული ქსელის დონეზე DNS პარამეტრების, რეკლამის ბლოკერების და ფაირვოლების კონფიგურაციით, რათა უზრუნველყოთ მაქსიმალური უსაფრთხოება და თავიდან აიცილოთ პოტენციური საფრთხეები.
ციფრული კონფიდენციალურობა: გააძლიერეთ თქვენი დაცვა მოწყობილობებსა და ქსელში
თანამედროვე სამყაროში ციფრული კონფიდენციალურობა აქტიურ ძალისხმევას მოითხოვს. ეს სტატია განმარტავს, თუ როგორ უნდა გააძლიეროთ თქვენი მონაცემების დაცვა, დაწყებული ინდივიდუალური მოწყობილობებიდან (ბრაუზერები, შეტყობინებების აპლიკაციები, პაროლის მენეჯერები) და დამთავრებული მთელი საშინაო ქსელით (DNS პარამეტრები, რეკლამის ბლოკირება, ფაირვოლები).

როგორ წაშალოთ თქვენი Google-ის ძიების ისტორია Android-ზე (და რატომ არის ეს მნიშვნელოვანი)
სტატია განმარტავს ZDNET-ის რეკომენდაციების არსს, რომელიც ეფუძნება ხანგრძლივ ტესტირებასა და დამოუკიდებელ შეფასებას, ხაზს უსვამს მათ სარედაქციო დამოუკიდებლობას. ამასთანავე, ის გთავაზობთ დეტალურ სახელმძღვანელოს Android მოწყობილობებზე Google-ის ძიების ისტორიის წაშლისა და ქეშის გასუფთავებისთვის. სტატია ყურადღებას ამახვილებს კონფიდენციალურობის მნიშვნელობაზე და პერსონალიზებული რეკლამების გავლენაზე, გვთავაზობს პრაქტიკულ რჩევებს მონაცემების კონტროლისთვის.

Hugging Face-ი ფაილების გადაცემის არქიტექტურას ანახლებს: ახალი მიდგომა დიდი მოცულობის მონაცემებისთვის
Hugging Face აცხადებს ინფრასტრუქტურის მნიშვნელოვან განახლებას, რათა ოპტიმიზაცია გაუკეთოს მოდელებისა და მონაცემთა ნაკრებების დიდი ზომის ფაილების ატვირთვასა და ჩამოტვირთვას. არსებული CDN-ის (AWS CloudFront) 50GB ლიმიტის გამოწვევის ფონზე, კომპანია ნერგავს კონტენტზე მიბმულ საცავს (CAS), როგორც ახალ არქიტექტურულ ელემენტს. ეს ახალი სისტემა იყენებს "სულელი წაკითხვების" და "ჭკვიანი ჩაწერების" პერსონალიზებულ პროტოკოლს, რომელიც აანალიზებს ფაილებს ბაიტის დონეზე, რათა გააუმჯობესოს გადაცემის სიჩქარე, უზრუნვე

როგორ აუმჯობესებს Capital Fund Management (CFM) ფინანსური მონაცემების ანალიზს Hugging Face-ის დიდი ენობრივი მოდელების (LLM) დახმარებით
Capital Fund Management (CFM), პარიზში დაფუძნებული ალტერნატიული ინვესტიციების მართვის ფირმა, თანამშრომლობს Hugging Face-ის ექსპერტთა მხარდაჭერის გუნდთან, რათა გამოიყენოს ღია წყაროს დიდი ენობრივი მოდელები (LLMs) ფინანსური აპლიკაციებისთვის. თანამშრომლობის მთავარი მიზანია გააუმჯობესოს ფინანსური სუბიექტების ამოცნობა (მაგ., კომპანიების სახელები) საინფორმაციო სტატიებიდან, რაც კრიტიკულია ავტომატიზირებული სავაჭრო სტრატეგიებისთვის. CFM-მა გამოიკვლია LLM-ის დახმარებით დატეგვის, მცირე მოდელების 'fine-tunin
LLM-ების შეფასება: სად შეგვიძლია ვენდოთ მონაცემებს?
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) შეფასების არსებულ გამოწვევებს, განსაკუთრებით GPT-4-ზე დაფუძნებულ მეტრიკაზე დამოკიდებულებას, რაც შესაძლოა სრულად არ ასახავდეს ადამიანურ უპირატესობებს. ხაზგასმულია ადამიანურად მარკირებული მონაცემების მნიშვნელობა რეალური უპირატესობების გასაზომად და წარმოდგენილია Hugging Face Open LLM ლიდერბორდის გაფართოება. ეს გაფართოებული ლიდერბორდი აერთიანებს ავტომატიზებულ აკადემიურ ბენჩმარკებს, პროფესიონალურ ადამიანურ მარკირებას და GPT-4 შეფასებებს, რათა უზრუნველყო
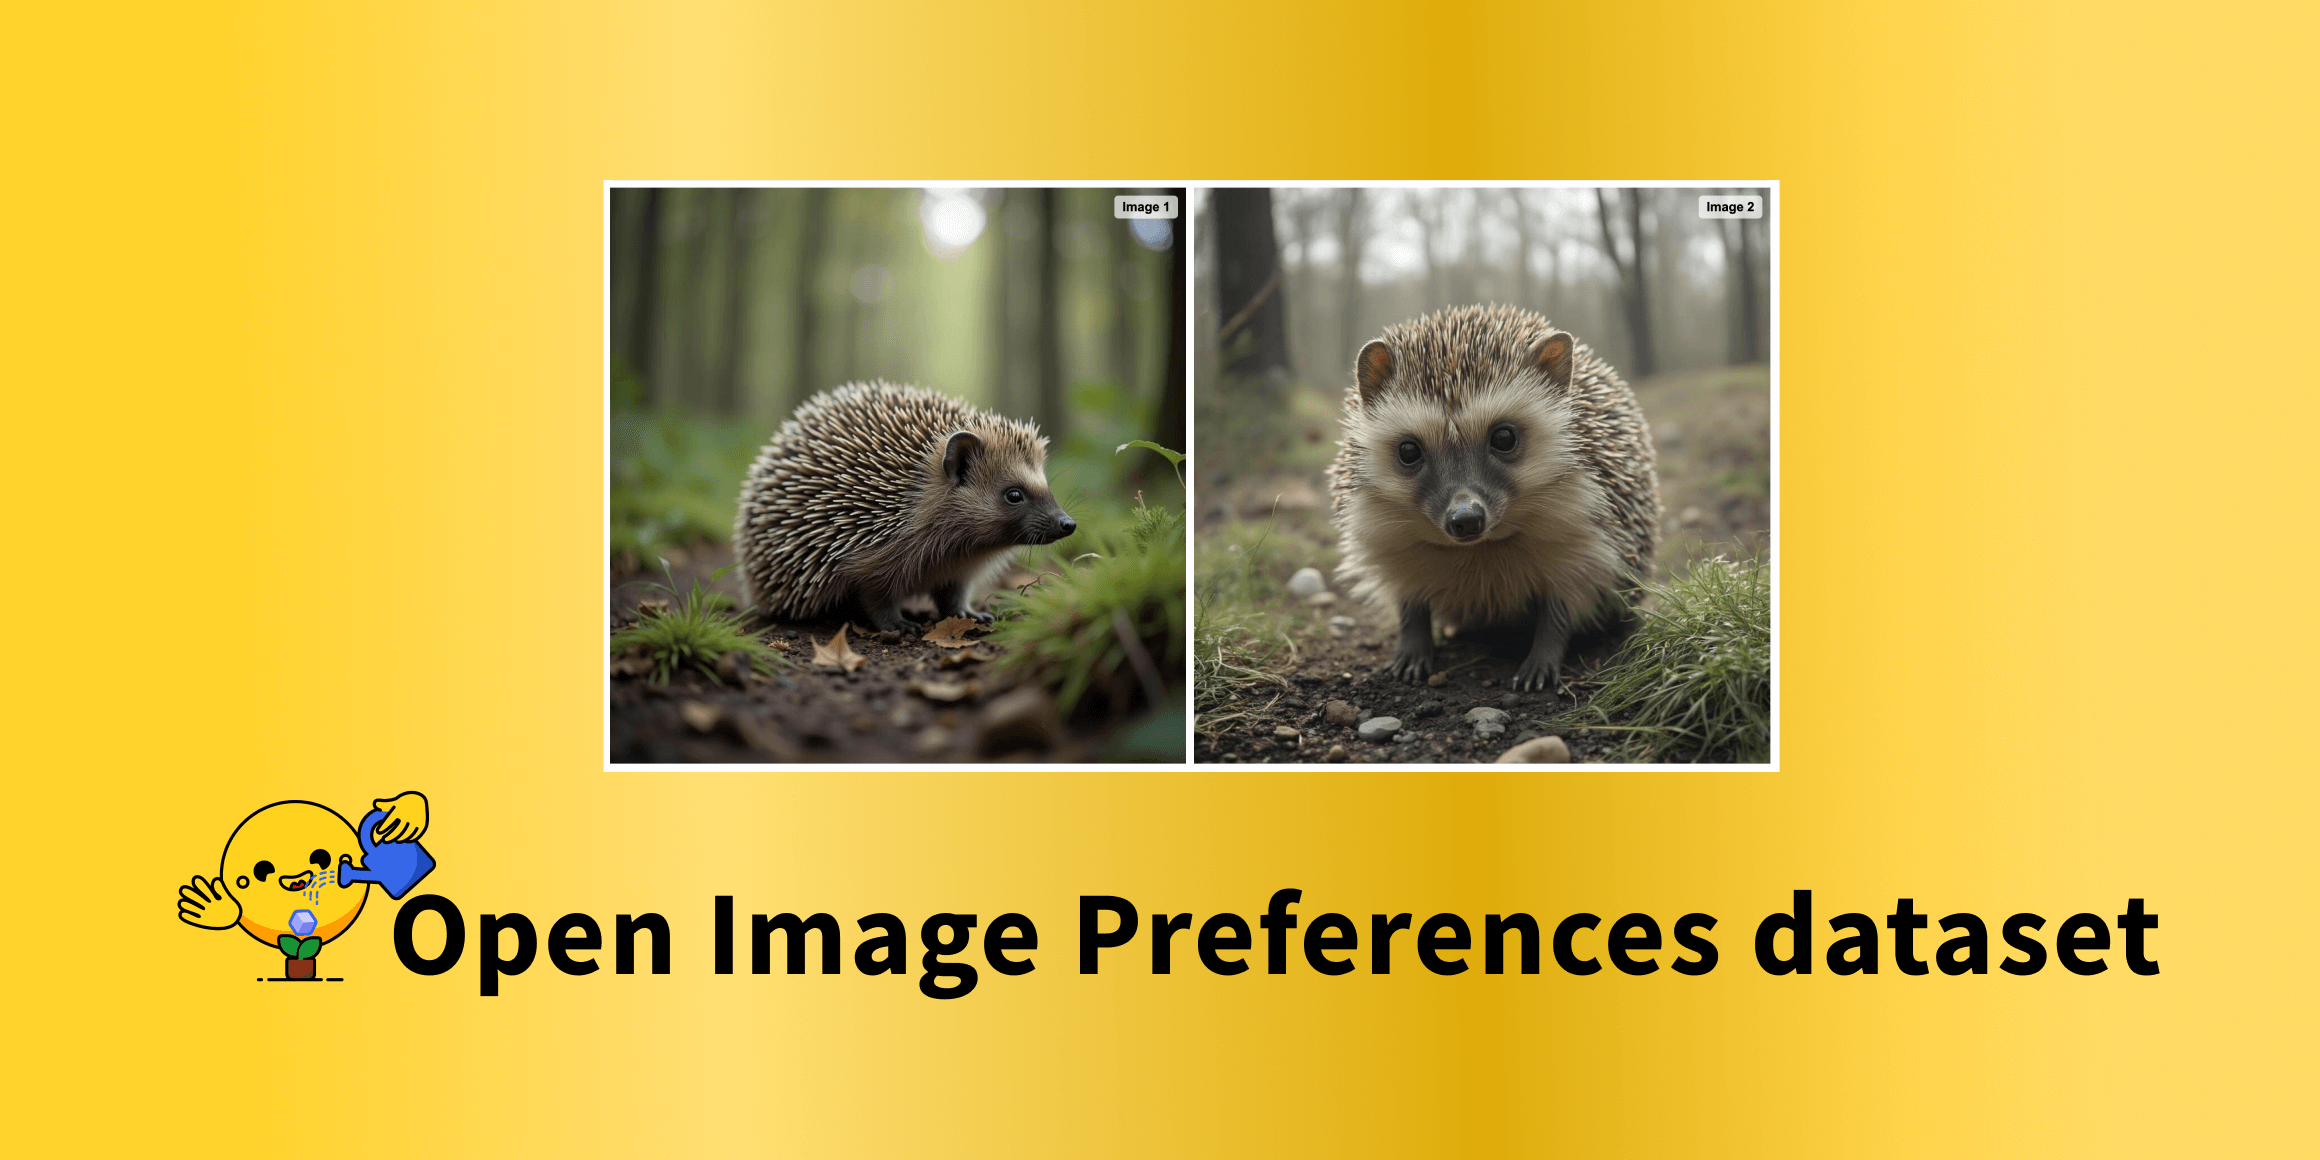
„მონაცემები ერთად უკეთესია“: Hugging Face და ღია კოდის AI საზოგადოება რევოლუციას ახდენენ გამოსახულების გენერაციაში
სტატია აღწერს Hugging Face-ისა და ღია კოდის AI საზოგადოების ერთობლივ პროექტს, სახელწოდებით „მონაცემები ერთად უკეთესია“, რომელიც მიზნად ისახავს ღია კოდის ეფექტური მონაცემთა ნაკრებების შექმნას. მნიშვნელოვანი მიღწევაა `open-image-preferences-v1`, უნიკალური გამოსახულების უპირატესობის მონაცემთა ნაკრები, რომელიც გამოირჩევა მრავალფეროვანი პრომპტებითა და ღია განვითარებით. მონაცემთა ნაკრები დეტალურად შეიქმნა სინთეზური მონაცემების გენერაციის, ტოქსიკურობის მოწინავე ფილტრაციისა და Flux-ისა და Stable Diffusi
ტრანსფორმერები დროითი სერიების პროგნოზირებაში: Autoformer-ის ინოვაცია და ეფექტურობის დადასტურება
ამ პოსტში განხილულია Transformer მოდელების ეფექტურობა დროითი სერიების პროგნოზირებისთვის. წარმოდგენილია Informer მოდელი, რომელმაც 2021 წლის AAAI-ის საუკეთესო ნაშრომის ჯილდო მოიპოვა. მიუხედავად იმისა, რომ ზოგიერთი კვლევა, მათ შორის DLinear-ის, ეჭვქვეშ აყენებს მათ ეფექტურობას, ემპირიული მონაცემები ადასტურებს, რომ ტრანსფორმერები, განსაკუთრებით Autoformer მოდელი, საგრძნობლად აჭარბებენ მარტივ ხაზოვან მოდელებს. სტატია დეტალურად განიხილავს Autoformer-ის საკვანძო ინოვაციებს: დაშლის ფენას (Decomposition L

სინთეზური მონაცემების გენერაცია: ხელოვნური ინტელექტის შესაძლებლობების გაფართოება
სტატია მიმოიხილავს სინთეზური მონაცემების მნიშვნელობასა და გენერაციის პროცესს. სინთეზური მონაცემები არის ხელოვნურად შექმნილი ინფორმაცია, რომელიც რეალურ სამყაროს მონაცემებს მიბაძავს და ხელს უწყობს მონაცემთა შეზღუდვების დაძლევას, ნაკრებების გაფართოებით ან გაუმჯობესებით. აღწერილია სინთეზური მონაცემების გენერატორის გამოყენება Hugging Face-ის უფასო API-სა და Argilla-ს ინტეგრაციის მეშვეობით, ტექსტის კლასიფიკაციისა და ჩატის მონაცემთა ნაკრებების შესაქმნელად. მოცემულია დეტალური სამსაფეხურიანი პროცესი მონა
ენის გენერაციის დეკოდირების სტრატეგიები: ხარბი და სხივური ძიება
ბოლო წლებში, დიდი ტრანსფორმერზე დაფუძნებული ენობრივი მოდელების (როგორიცაა ChatGPT და LLaMA) აღზევებამ მნიშვნელოვნად გაზარდა ინტერესი ღია ტიპის ენის გენერაციის მიმართ. მოდელის გაუმჯობესებული არქიტექტურისა და მასიური სასწავლო მონაცემების პარალელურად, გადამწყვეტი როლი შეასრულა დეკოდირების უკეთესმა მეთოდებმაც. ეს სტატია წარმოგიდგენთ დეკოდირების ძირითად სტრატეგიებს – ხარბ ძიებას (Greedy search), სხივურ ძიებას (Beam search) და სემპლინგს (Sampling) – და განმარტავს, თუ როგორ ხორციელდება მათი დანერგვა პო
DeepSeek-R1-ის რევოლუცია: ღია წყაროს ინიციატივა მსჯელობის მოდელების გასახსნელად
DeepSeek-R1-ის გამოშვებამ ხელოვნური ინტელექტის სამყაროში მნიშვნელოვანი გარღვევა მოახდინა, წარმოადგინა მსჯელობის უნარის მქონე მოდელი, რომელიც OpenAI-ის o1-ზე არანაკლებ ან უკეთესად მუშაობს. მისი შექმნის მეთოდოლოგია, განსაკუთრებით კი გაძლიერებითი სწავლის (RL) გამოყენება ადამიანის ზედამხედველობის გარეშე, დეტალურად იქნა აღწერილი. მიუხედავად იმისა, რომ მოდელის წონები ღიაა, მისი სავარჯიშო მონაცემები და კოდი საიდუმლოდ დარჩა. ამის საპასუხოდ, Open-R1 პროექტი მიზნად ისახავს DeepSeek-R1-ის მონაცემთა და სავა
Hugging Face Hub-ის მონაცემთა ნაკრებების მეტამონაცემების გაუმჯობესება მანქანური სწავლების საშუალებით
Hugging Face Hub, როგორც მანქანური სწავლების რესურსების ცენტრალური საცავი, აუმჯობესებს მონაცემთა ნაკრებების მეტამონაცემებს ხელოვნური ინტელექტის გამოყენებით. ახალი ინიციატივის ფარგლებში, მანქანური სწავლების ალგორითმები ამოიცნობენ ენას იმ მონაცემთა ნაკრებებში, რომლებსაც არ აქვთ ენის მეტამონაცემები, ხოლო ავტომატიზებული „ბიბლიოთეკარი-ბოტები“ ამ ინფორმაციას მეტამონაცემებში დაამატებენ. ეს პროექტი მიზნად ისახავს რესურსების მოძიების გაადვილებას და Hub-ზე წარმოდგენილი ენობრივი მიკერძოებების უკეთ გაგებას.

DeepSeek R1-ის გამოშვებიდან ორი კვირა: ღია-R1 პროექტის მიღწევები და გამოწვევები
სტატია აჯამებს ღია-R1 პროექტის განვითარებას, რომელიც DeepSeek R1-ის სასწავლო კონვეიერისა და სინთეზური მონაცემების რეპლიკაციას ისახავს მიზნად. მიღწევებს შორისაა DeepSeek-ის შეფასების ქულების რეპროდუცირება და GRPO-ის ინტეგრაცია TRL-ში. პროექტი DeepSeek R1-ის ხანგრძლივი პასუხების გამო GPU მეხსიერებისა და გენერაციის ეფექტურობის გამოწვევების წინაშე დგას, თუმცა ინფერენსის ოპტიმიზაციაში მნიშვნელოვანი პროგრესია. ინიციატივამ მედიის ფართო ინტერესიც გამოიწვია.
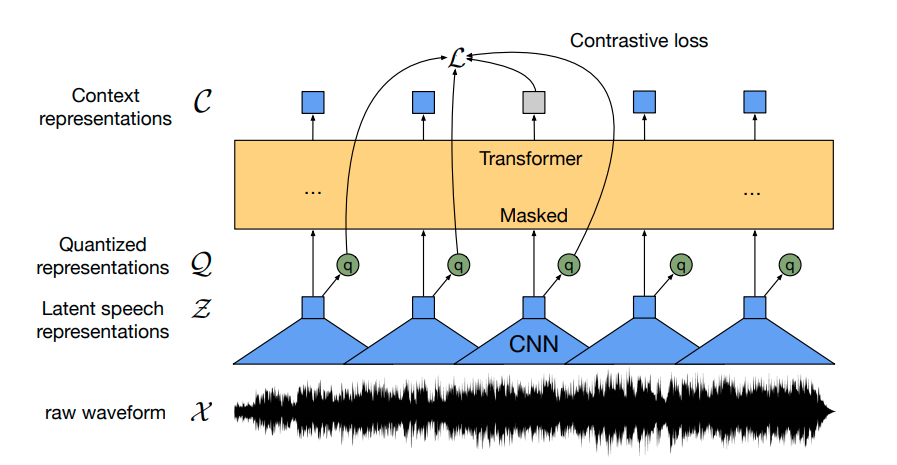
Wav2Vec2: ახალი ეპოქა მეტყველების ავტომატურ ამოცნობაში
Wav2Vec2 წარმოადგენს ინოვაციურ მოდელს, რომელიც იყენებს კონტრასტულ წინასწარ წვრთნას 50 000 საათზე მეტი არადანიშნული მეტყველების მონაცემებიდან მძლავრი წარმოდგენების შესასწავლად. BERT-ის მსგავსად, ის ნიღბავს ფუნქციის ვექტორებს კონტექსტუალიზებული წარმოდგენების მისაღებად. მოდელმა აჩვენა კონკურენტული შედეგები თანამედროვე ავტომატური მეტყველების ამოცნობის (ASR) სისტემებთან, მინიმალური, სულ რაღაც 10 წუთის, დანიშნულ მონაცემებზე დამატებითი წვრთნის შემდეგ. ეს სტატია დეტალურად განმარტავს Wav2Vec2-ის წინასწარ
Wav2Vec2: გარღვევა მეტყველების ამოცნობაში მინიმალური მარკირებული მონაცემებით
Wav2Vec2, რევოლუციური ხელოვნური ინტელექტის მოდელი, სწავლობს მეტყველების მძლავრ წარმოდგენებს დიდი მოცულობის არამარკირებული აუდიო მონაცემებიდან, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მეთოდის გამოყენებით. მან აჩვენა უპრეცედენტო შედეგები ავტომატური მეტყველების ამოცნობის (ASR) სფეროში, მიაღწია უმაღლეს დონეს მაშინაც კი, როდესაც დამატებითი ვარჯიში (fine-tuning) ხდება სულ რაღაც 10 წუთის მარკირებულ მეტყველების მონაცემებზე. ეს მას ქმნის მაღალეფექტურ გადაწყვეტილებად ძლიერი ASR სისტემების შესაქმნელად, რ
IDEFICS: ღია მულტიმოდალური AI მოდელი გამჭვირვალე კვლევისთვის
IDEFICS, 80 მილიარდი პარამეტრის მულტიმოდალური ხელოვნური ინტელექტის (AI) მოდელი, რომელიც Flamingo-ს ღია წყაროს რეპროდუქციას წარმოადგენს, უკვე ხელმისაწვდომია. მისი შექმნისას დიდი აქცენტი გაკეთდა გამჭვირვალობაზე, გამოყენებულ იქნა მხოლოდ საჯაროდ ხელმისაწვდომი მონაცემები და შეფასდა პოტენციური მიკერძოებები. მოდელი მიზნად ისახავს მულტიმოდალური AI სისტემების სფეროში უფრო ღია კვლევების წახალისებას და მისი დემო ვერსიები Hugging Face Hub-ზეა განთავსებული.

Open R1 პროექტი წარმოგიდგენთ OpenR1-Math-220k: მათემატიკური მსჯელობის ახალ, მასშტაბურ მონაცემთა ნაკრებს
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის ტრენინგის პროცესებისა და სინთეზური მონაცემების აღდგენა, სიამოვნებით აცხადებს OpenR1-Math-220k-ის შექმნას – მათემატიკური მსჯელობისთვის განკუთვნილი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები. ეს პოსტი დეტალურად აღწერს მის შექმნის პროცესს, მათ შორის 512 H100 გრაფიკული პროცესორის გამოყენებას გენერაციისთვის და ხარისხის უზრუნველსაყოფად წესებზე დაფუძნებული (Math Verify) და დიდი ენობრივი მოდელებზე დაფუძნებული (Llama-3.3-70B-Instruct) ვალიდაციის მეთოდების კო
Open R1 პროექტი: OpenR1-Math-220k მონაცემთა ნაკრების წარდგენა მათემატიკური მსჯელობისთვის
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის დაკარგული კომპონენტების – კერძოდ, საწვრთნელი პაიპლაინისა და სინთეზური მონაცემების – რეკონსტრუქცია, უკვე ორი კვირაა მიმდინარეობს. ამ პოსტში წარმოდგენილია OpenR1-Math-220k: ჩვენი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები მათემატიკური მსჯელობისთვის. განხილულია საზოგადოების ძალისხმევა მცირე, მაღალი ხარისხის მონაცემთა ნაკრებების შესაქმნელად და მსჯელობის მოდელებიდან „აზროვნების ჯაჭვის“ (chain-of-thought) სიგრძის კონტროლის მეთოდები. სტატია დეტალურად აღწერ
Hugging Face-ის Xet გუნდის ინოვაციური მიდგომა მონაცემთა გადაცემის დაჩქარებისთვის
Hugging Face-ის Xet გუნდი მონაცემთა დედუპლიკაციას თეორიიდან პრაქტიკაში ნერგავს, რათა მნიშვნელოვნად დააჩქაროს AI დეველოპერებისთვის Hub-ზე მონაცემების ატვირთვა და ჩამოტვირთვა. იმის ნაცვლად, რომ მხოლოდ დედუპლიკაციის მაქსიმიზაციაზე გაამახვილონ ყურადღება, რამაც შეიძლება დიდი დამატებითი ხარჯები გამოიწვიოს, მათი მიდგომა მიზნად ისახავს სწრაფი ექსპერიმენტებისა და თანამშრომლობის ხელშეწყობას. ეს გულისხმობს მონაცემთა გადაადგილების, შენახვისა და განვითარების მთლიანი პროცესის ოპტიმიზაციას ჩანკებზე დაფუძნებული

„Few-Shot“ სწავლება: GPT-Neo, ბუნებრივი ენის დამუშავება და ეთიკური გამოწვევები
„Few-Shot“ სწავლება მანქანური სწავლების მოდელებს საშუალებას აძლევს, პროგნოზები გააკეთონ ძალიან მცირე რაოდენობის სავარჯიშო მონაცემების გამოყენებით, ტრადიციული „fine-tuning“ მეთოდებისგან განსხვავებით. ის, ძირითადად, კომპიუტერულ მხედველობაში გამოიყენებოდა, თუმცა ახლა უკვე ეფექტურია ბუნებრივი ენის დამუშავებაში (ბედ) დიდ ენობრივ მოდელებთან (მაგ. GPT-Neo), რაც მათ საშუალებას აძლევს, განაზოგადონ ახალი ამოცანები სულ რამდენიმე მაგალითით. თუმცა, ეფექტური „few-shot“ მაგალითების შექმნა და ჰიპერპარამეტრების
Few-Shot Learning ხელოვნურ ინტელექტში: GPT-Neo და აჩქარებული დასკვნის API
სტატია განმარტავს „Few-Shot Learning“ (რამდენიმე მაგალითზე დაფუძნებული სწავლების) კონცეფციას, როგორც მანქანური სწავლების ტექნიკას, რომელიც მოდელს მცირე რაოდენობის მონაცემებით წვრთნის. განხილულია მისი გამოყენება ბუნებრივი ენის დამუშავებაში (NLP) დიდი ენობრივი მოდელების, როგორიცაა EleutherAI GPT-Neo და OpenAI GPT-3, მეშვეობით. სტატია ასევე მიმოიხილავს Hugging Face-ის აჩქარებული დასკვნის (Accelerated Inference) API-ის როლს, ამ ტექნიკის ოპტიმიზაციას, გამოწვევებს (მაგ., მოდელის მგრძნობელობა მაგალითებ
Hugging Face spaCy-ის ინტეგრაციით მოდელების გაზიარებასა და გამოყენებას ამარტივებს
Hugging Face-მა და spaCy-იმ განახორციელეს ინტეგრაცია, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ, დააყენონ და გამოიყენონ spaCy-ის კონვეიერები და მოდელები. ახალი ფუნქციონალი მოიცავს ავტომატურ მეტამონაცემების გენერაციას, დასკვნის (Inference) API-ს NER-ისთვის (Named Entity Recognition), ბრაუზერში ინტერაქტიულ ტესტირებას, `pip install`-ის მხარდაჭერას და `spacy-huggingface-hub` ბიბლიოთეკას მოდელების სწრაფი გაზიარებისთვის. ხელმისაწვდომია 60-ზე მეტი კანონიკური მოდელი, და მალე დაემატება ტექსტ
Hugging Face-ის ზაფხულის განახლებები: ივნისი, ივლისი, აგვისტო
ეს პოსტი აჯამებს Hugging Face-ის ივნის-აგვისტოს განახლებებს, მათ შორის საჯარო მოდელების რეპოზიტორიების 10,000-დან 16,000-მდე ზრდას. წარმოდგენილია ახალი ფუნქციები, როგორიცაა „Spaces“ ML დემო აპლიკაციების ჰოსტინგისთვის, ნივთების „მოწონების“ შესაძლებლობა, TensorBoard-ის ინტეგრაცია, შეფასების მეტრიკები, რომლებიც დაკავშირებულია Papers With Code-თან, ახალი ვიჯეტები სხვადასხვა ML ამოცანებისთვის (აუდიო, სტრუქტურირებული მონაცემები, გამოსახულება), გაუმჯობესებული დოკუმენტაცია, რეპოზიტორიების გადატანა/გადარ