VQ-დიფუზია: ახალი სიმაღლეები გამოსახულების გენერაციაში „დიფუზერების“ მეშვეობით
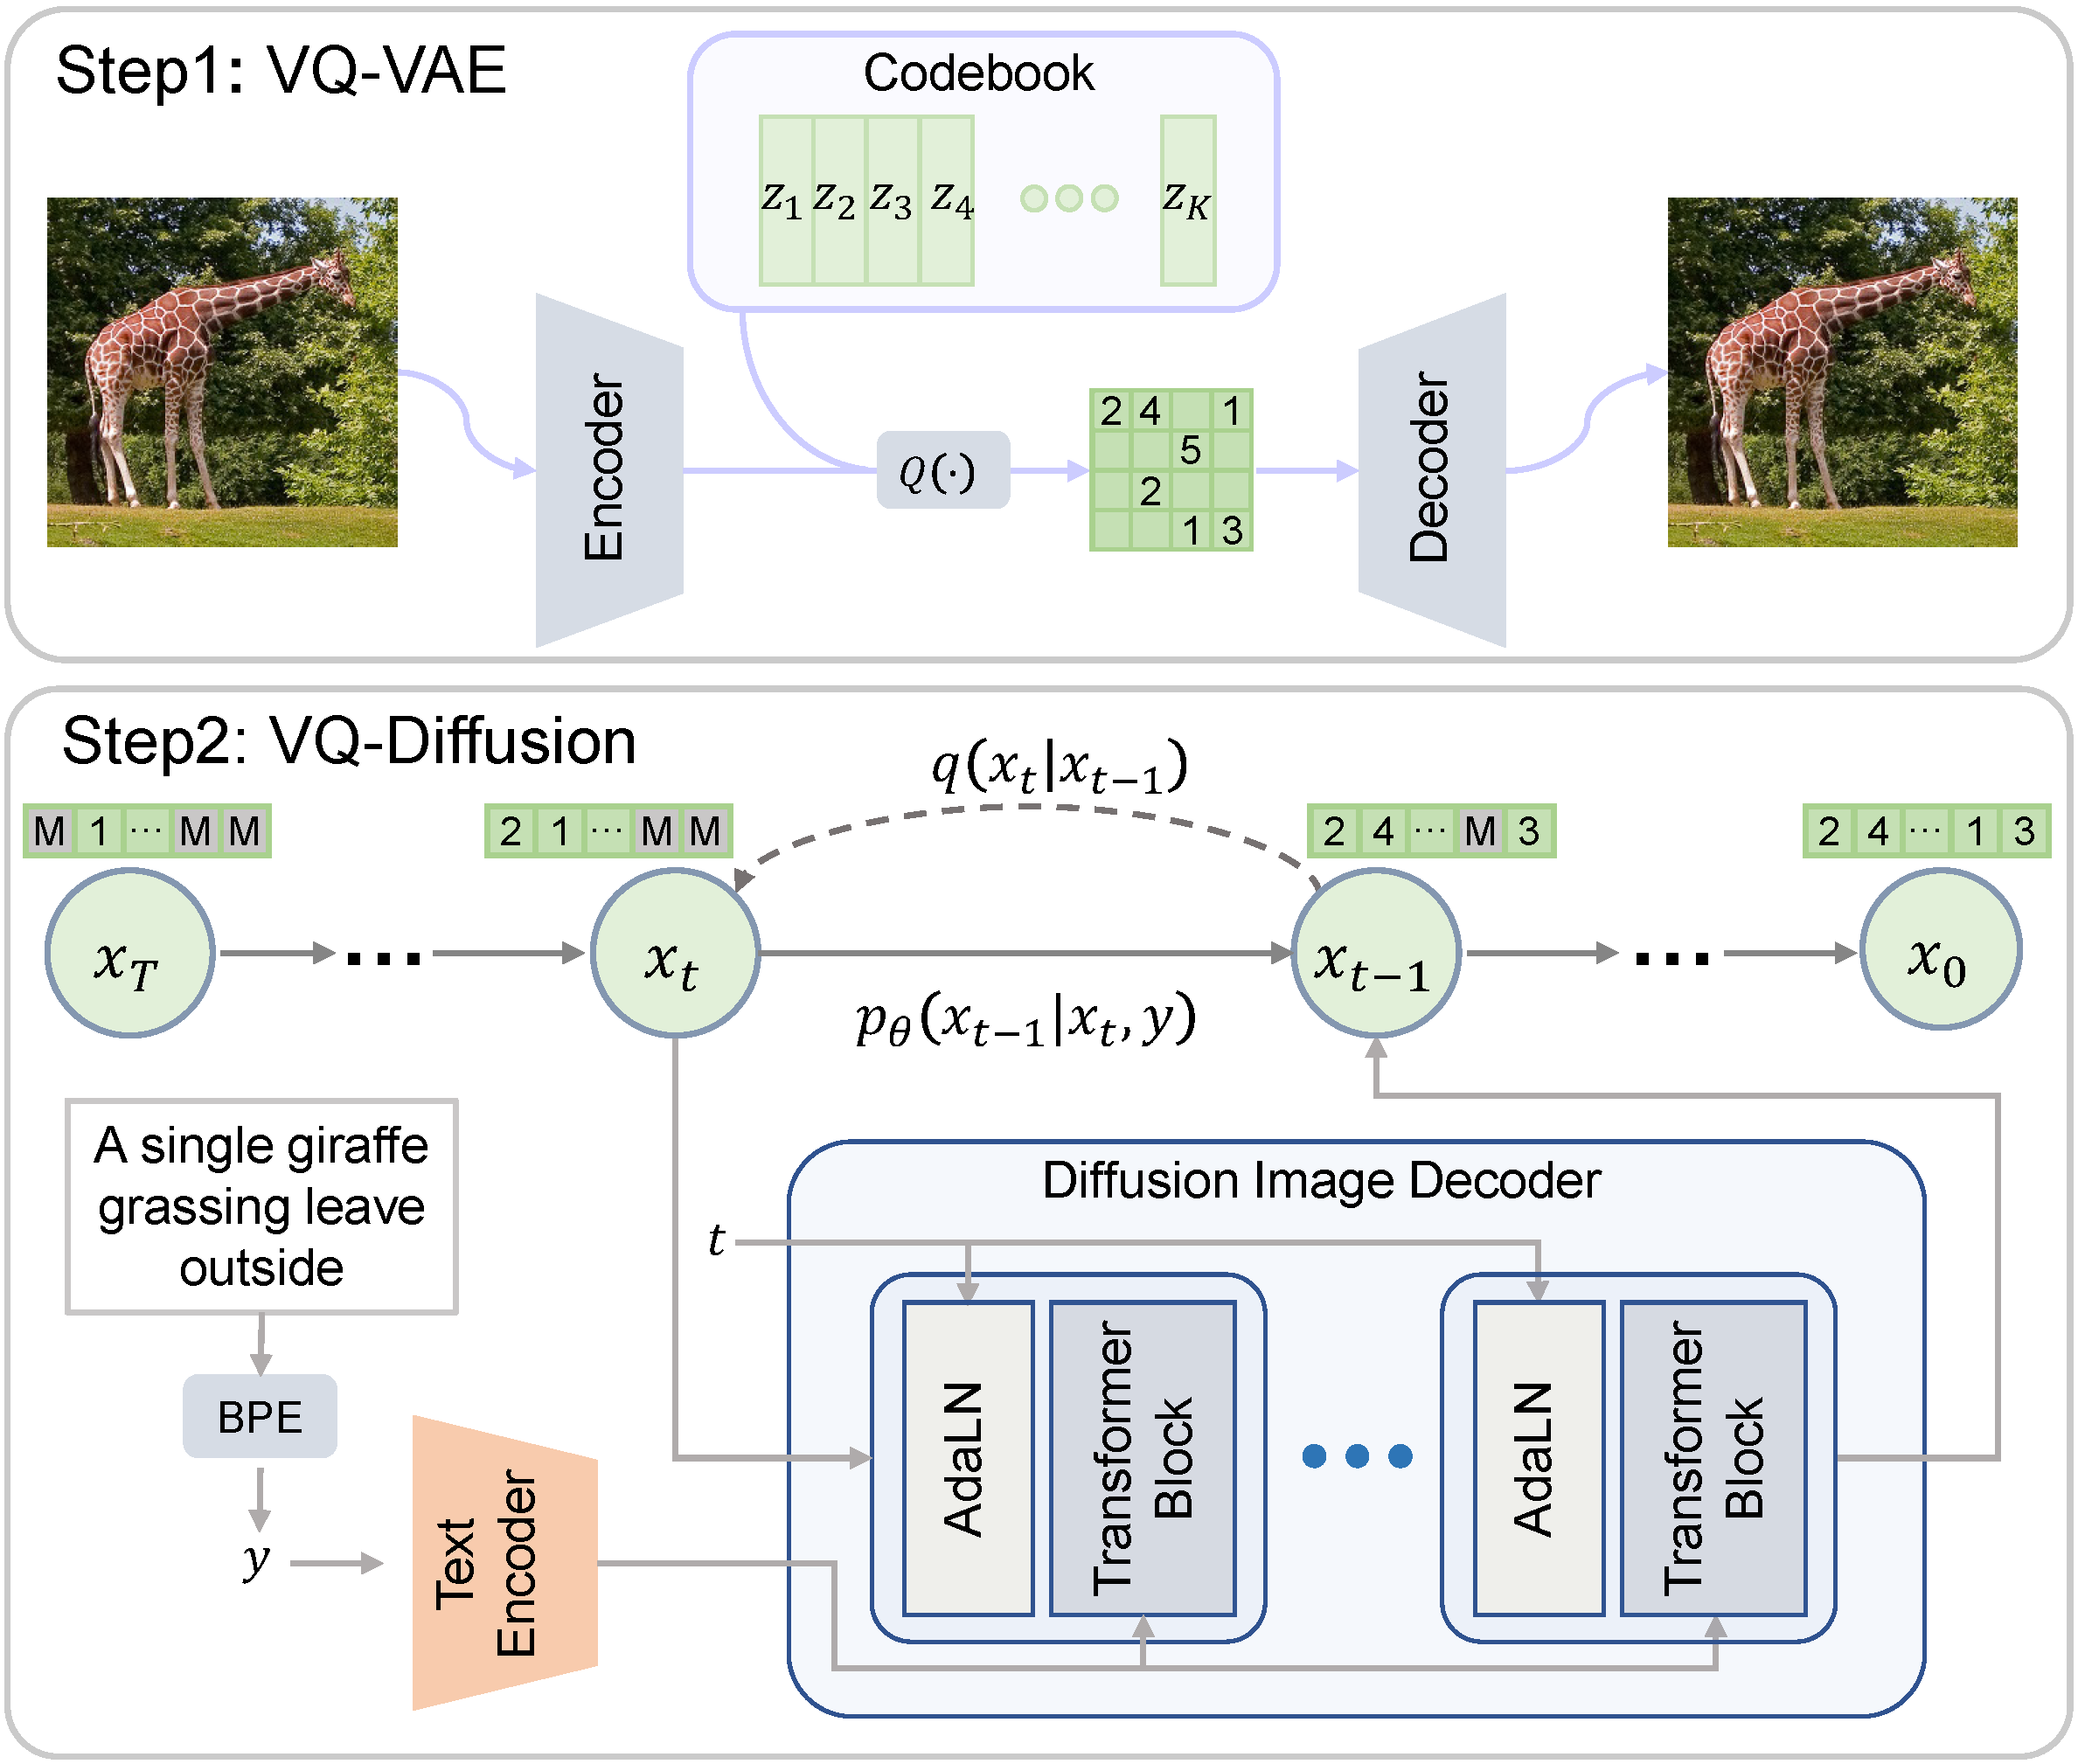
„დიფუზერები“ (Diffusers) VQ-დიფუზიის (VQ-Diffusion) მოდელის გამოყენებას განსაკუთრებულად ამარტივებს, რაც დეველოპერებს საშუალებას აძლევს, გამოსახულების გენერაციის მოწინავე ტექნოლოგიები სულ რამდენიმე ხაზი კოდით გამოიყენონ. ეს მოდელი გამოსახულებებს დისკრეტულ „ტოკენებად“ კოდირებს VQ-VAE ენკოდერის მეშვეობით, ამცირებს მონაცემთა განზომილებას და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს გაუხმაურებელი ლატენტების პროგნოზირებისთვის. VQ-დიფუზია უწყვეტ დიფუზიურ მოდელებთან შედარებით დისკრეტულ მიდგომას გვთავაზობს და
VQ-Diffusion: ახალი სიტყვა სურათების გენერაციაში Diffusers-ის დახმარებით
წარმოგიდგენთ VQ-Diffusion-ს, დისკრეტულ დიფუზიურ მოდელს, რომელიც სურათების გენერაციას სულ რამდენიმე ხაზი კოდით შესაძლებელს ხდის Diffusers ბიბლიოთეკის გამოყენებით. მოდელი ეფუძნება VQ-VAE ენკოდერს გამოსახულებების ლატენტურ ტოკენებად გარდასაქმნელად და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს. VQ-Diffusion მნიშვნელოვნად აუმჯობესებს AR მოდელების ნაკლოვანებებს, როგორიცაა ინფერენციის სიჩქარე და შეცდომების დაგროვება, რაც მას ეფექტურ და მძლავრ ინსტრუმენტად აქცევს ხელოვნური ინტელექტის საფუძველზე გამოსახულების შ
DeepSpeed-ისა და FSDP-ის სიზუსტის გამოწვევები: როგორ მოაგვარა Accelerate-მა პრობლემა PyTorch-ის ტრენინგში
ბოლო დროს, DeepSpeed-ისა და PyTorch FSDP-ის გამოყენებით Mistral-7B მოდელის ტრენინგისას, აღმოჩნდა განსხვავებული შედეგები, რაც DeepSpeed-ის მიერ შიდა fp32 სიზუსტის გამოყენებით იყო გამოწვეული. 🤗 Accelerate-მა ამ პრობლემის მოსაგვარებლად FSDP-ისთვის ავტომატური upcasting-ის ფუნქცია დაამატა, რითაც უზრუნველყო ჩარჩოების უკეთესი შეთავსება და გააუმჯობესა ტრენინგის სტაბილურობა. სტატია დეტალურად განიხილავს ამ აღმოჩენებს, დანერგილ ცვლილებებს და გამტარუნარიანობის შედარებებს.

NVIDIA-მ Nemotron-Personas-Japan გამოუშვა: იაპონური კულტურის გაგების ხელოვნური ინტელექტისთვის
NVIDIA-მ წარმოადგინა Nemotron-Personas-Japan, პირველი ღია სინთეზური მონაცემთა ნაკრები, რომელიც ასახავს იაპონიის დემოგრაფიას, გეოგრაფიულ განაწილებას და კულტურულ მახასიათებლებს. CC BY 4.0 ლიცენზიით გამოშვებული ეს ნაკრები უზრუნველყოფს კონფიდენციალურობის დამცავ საფუძველს იაპონური საზოგადოების ამსახველი AI სისტემების შესაქმნელად, მგრძნობიარე პირადი მონაცემების გამოყენების გარეშე. იგი შექმნილია იაპონური სუვერენული AI სისტემების მხარდასაჭერად და ადვილად ინტეგრირდება ღია კოდის დიდ ენობრივ მოდელებთან (LL
ღრმა სწავლა და ტრანსფორმერები: ინოვაციები დროითი რიგების პროგნოზირებაში
დროითი რიგების პროგნოზირება, რომელიც ტრადიციულად კლასიკურ მეთოდებს ეყრდნობოდა, დღეს ღრმა სწავლის მოდელების ინტენსიურ გამოყენებას განიცდის. სტატია მიმოიხილავს განსხვავებას ინდივიდუალურ (ლოკალურ) კლასიკურ მეთოდებსა და გლობალურ, ალბათობით ღრმა სწავლის მოდელებს შორის, რომლებიც საშუალებას აძლევენ მოდელებს ისწავლონ მრავალი წყაროდან და წარმოადგინონ პროგნოზების გაურკვევლობები. განსაკუთრებული ყურადღება ეთმობა Transformer-ის არქიტექტურას, როგორც ეფექტურ ინსტრუმენტს უნივარიატული ალბათობითი პროგნოზირებისთვი
BigCodeBench: ახალი ეტალონი LLM-ების პროგრამირების შეფასებისთვის
კვლევითი გუნდი წარმოგიდგენთ BigCodeBench-ს, ახალ, ყოვლისმომცველ ეტალონს, რომელიც მიზნად ისახავს დიდი ენობრივი მოდელების (LLM) პროგრამირების შესაძლებლობების შეფასებას. ეს ინსტრუმენტი, არსებული ალტერნატივების შეზღუდვების საპასუხოდ შეიქმნა და მოიცავს 1,140 ფუნქციურ დავალებას, რომლებიც მოითხოვს პრაქტიკული და რთული პროგრამირების ამოცანების გადაჭრას მკაცრი ტესტირების პირობებში, დაბინძურების გარეშე. BigCodeBench-ი ეხმარება დეველოპერებს, უკეთ შეაფასონ LLM-ების უნარი, მიჰყვნენ ინსტრუქციებს და მოახდინონ ფ
BigCodeBench: ახალი ბენჩმარკი ხელოვნური ინტელექტის პროგრამირების შესაძლებლობების შესაფასებლად
საზოგადოებას კვლავ აკლია მარტივი გამოსაყენებელი ბენჩმარკი, რომელსაც შეუძლია დიდი ენობრივი მოდელების (LLM) პროგრამირების შესაძლებლობების ფართოდ შეფასება. ამ გამოწვევის საპასუხოდ, წარდგენილია BigCodeBench – ახალი, ყოვლისმომცველი შეფასების პლატფორმა, რომელიც 1,140 ფუნქციის დონის ამოცანის საშუალებით ამოწმებს LLM-ებს პრაქტიკული და რთული პროგრამირების ამოცანების გადაწყვეტაში, მათ შორის ინსტრუქციების შესრულებასა და მრავალი ფუნქციის გამოძახებაში 139 ბიბლიოთეკიდან. BigCodeBench მკაცრად აფასებს მოდელებს მ

Vibe Coding თამაშების შექმნა: პრობლემები და ავტორის ინოვაციური გადაწყვეტა
სტატია იკვლევს „vibe coding“-ის კონცეფციას თამაშების შექმნისას, სადაც ხელოვნური ინტელექტი გამოიყენება მაღალი დონის პროგრამირების ენად. განხილულია პროექტების ზრდასთან დაკავშირებული გამოწვევები, განსაკუთრებით ხელოვნური ინტელექტის მოდელების კონტექსტური ფანჯრის შეზღუდვების გამო. წარმოდგენილია „Shallot“ – კონტექსტის მართვის სისტემა და „VibeGame“ – ახალი, მაღალი დონის დეკლარაციული სათამაშო ძრავი, რომელიც სპეციალურად ხელოვნური ინტელექტის დახმარებით თამაშების შესაქმნელად შეიქმნა ამ პრობლემების დასაძლევა
როგორ გავუშვათ Stable Diffusion Apple-ის მოწყობილობებზე Core ML-ის გამოყენებით
Apple-ის რეპოზიტორიუმი გვთავაზობს Stable Diffusion-ის კონვერტაციის სკრიპტებსა და დასკვნის (inference) კოდს Core ML-ისთვის. სიმარტივისთვის, მოდელების Core ML ვერსიები უკვე გადაყვანილია და ხელმისაწვდომია Hugging Face Hub-ზე. ასევე, შეიქმნა მშობლიური Swift აპლიკაცია, რომელიც Mac App Store-სა და ღია კოდის სახითაა გამოქვეყნებული, რათა მომხმარებლებმა მარტივად გაუშვან Stable Diffusion საკუთარ აპარატურაზე. სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ კონვერტირებული წონები, ან თავად გადაიყვანოთ დამატებით

Prezi და Hugging Face: როგორ ეხმარება ხელოვნური ინტელექტის ექსპერტთა მხარდაჭერა პრეზენტაციების ინოვაციებში
Prezi შეუერთდა Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას, რათა სრულად გამოიყენოს მანქანური სწავლების პოტენციალი. ბოლო თვეების განმავლობაში, Hugging Face-მა Prezi-ს მხარი დაუჭირა მცირე, უფრო ეფექტური ღია წყაროს მოდელების ინტეგრაციაში მათ ML სამუშაო პროცესებში. Prezi-ის Backend ინჟინერი, მათე ბორჩოკი, ხაზს უსვამს, თუ როგორ დააჩქარა ამ თანამშრომლობამ მათი AI პროდუქტების განვითარება, გააუმჯობესა პრეზენტაციების შექმნა და დეპლოირების ეფექტურობა მორგებული რჩევებისა და მოწინავე ინსტრუმენტების, მაგ
Prezi Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას უერთდება: ML პოტენციალის სრული გამოყენება
პრეზენტაციების ონლაინ ხელსაწყო Prezi, Hugging Face-ის ექსპერტთა მხარდაჭერის პროგრამას შეუერთდა, რათა მაქსიმალურად აითვისოს თანამედროვე მანქანური სწავლების (ML) შესაძლებლობები. ამ თანამშრომლობის ფარგლებში, Hugging Face ეხმარება Prezi-ს უფრო მცირე და ეფექტური ღია კოდის მოდელების ინტეგრირებაში, რაც განსაკუთრებით მნიშვნელოვანია მულტიმოდალური მოდელების მზარდი შესაძლებლობების ფონზე. Prezi-ის ბექენდ ინჟინერი, მატე ბორჩოკი, იზიარებს თავის გამოცდილებას პროგრამაში მონაწილეობის შესახებ, ხაზს უსვამს ექსპერტ

Qwen3-8B-ის რევოლუციური აჩქარება: სპეკულაციური დეკოდირება და ოპტიმიზაცია OpenVINO-თი, ლოკალური AI აგენტებისთვის
ახლახან გამოშვებული Qwen3-8B მოდელი, თავისი აგენტური შესაძლებლობებით, იდეალურია AI პერსონალური კომპიუტერებისთვის. OpenVINO.GenAI-ის მეშვეობით, სპეკულაციური დეკოდირების გამოყენებით და მსუბუქი Qwen3-0.6B დრაფტ მოდელის გამოყენებით, გენერაციის სიჩქარე 1.3-ჯერ გაიზარდა. დრაფტ მოდელის ოპტიმიზაციით ეს მაჩვენებელი 1.4-ჯერ მიაღწია. ეს გაუმჯობესებები შესაძლებელს ხდის სწრაფი, ლოკალური AI აგენტების გაშვებას, რაც მათ უფრო პრაქტიკულს ხდის Intel® Core™ Ultra პლატფორმებზე.
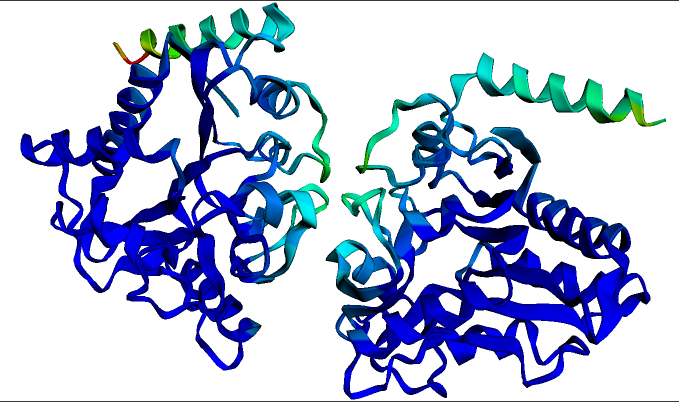
დიდი ენობრივი მოდელების შექმნის გზა: ტრანსფერული სწავლის ამბავი
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (როგორიცაა BERT და GPT) ისტორიას, დაწყებული 2016 წლის ღრმა სწავლის (DL) გამოწვევებიდან. ხაზგასმულია DL-ის მთავარი პრობლემა – მონაცემების დიდი მოცულობის საჭიროება, რაც ხშირად მიუწვდომელია. შემდგომ განხილულია „ტრანსფერული სწავლის“ კონცეფცია, როგორც ამ გამოწვევის დაძლევის საშუალება, რაც გულისხმობს არსებული ცოდნის ახალ ამოცანაზე გადატანას. სტატია დეტალურად აღწერს, თუ როგორ მოახდინეს ULMFiT-მა და BERT-მა რევოლუცია 2018 წელს, დანერგეს ეფექტური ტრანსფერული სწა

მონაცემთა ნაკრებების შექმნა: საზოგადოების ძალისხმევა და მრავალენოვანი ინიციატივები Hugging Face-ისგან
სტატია აღწერს Hugging Face-ის საზოგადოების მიერ მონაცემთა ნაკრებების შექმნის მიზნით გაწეულ ძალისხმევას. ინიციატივა მოიცავს მოთხოვნების (prompts) რანჟირების პროექტსა და მრავალენოვანი მოთხოვნების შეფასების პროექტს (MPEP), რომელიც მიზნად ისახავს ღია LLM-ებისთვის ენობრივი ბენჩმარკების გაუმჯობესებას. ხაზგასმულია საზოგადოების წვლილის მნიშვნელობა მყარი და ყოვლისმომცველი რესურსების შესაქმნელად.

RTEB: ახალი ბენჩმარკი ხელოვნური ინტელექტის მოდელების მოძიების ხარისხის საიმედო შეფასებისთვის
ხელოვნური ინტელექტის აპლიკაციების მუშაობა, როგორიცაა RAG და რეკომენდაციის სისტემები, მნიშვნელოვნად შეზღუდულია ძიებისა და მოძიების ხარისხით. დეველოპერებისთვის პრობლემას წარმოადგენს ემბედინგის მოდელების მოძიების ხარისხის ზუსტი გაზომვა, რადგან არსებული ბენჩმარკები ხშირად აჩვენებენ „განზოგადების ხარვეზს“ და არ შეესაბამებიან რეალურ საწარმოო გამოყენების შემთხვევებს. ამ გამოწვევების გადასაჭრელად შეიქმნა RTEB – ახალი, საიმედო ბენჩმარკი, რომელიც ზომავს მოძიების სიზუსტეს. ის იყენებს ჰიბრიდულ სტრატეგიას (ღ

მანქანური სწავლება Elixir-ში: ახალი შესაძლებლობები Bumblebee-სთან ერთად
Elixir-ის ეკოსისტემაში მანქანური სწავლების მხარდაჭერა მნიშვნელოვნად გაუმჯობესდა ისეთი პროექტების წყალობით, როგორებიცაა Nx, Axon, Explorer და, განსაკუთრებით, Bumblebee. Livebook პლატფორმაში ინტეგრირებული „Smart cells“-ის მეშვეობით, დეველოპერებს შეუძლიათ ნერვული ქსელების ამოცანების სწრაფად ინტეგრირება. Erlang ვირტუალური მანქანის კონკურენტულობისა და დისტრიბუციის წყალობით, ეს მოდელები ადვილად ინტეგრირდება არსებულ Elixir აპლიკაციებში, როგორიცაა Phoenix, Broadway და Nerves, და კომპილირდება როგორც CPU-
მონაცემთა ხარისხი: ხელოვნური ინტელექტის ეფექტური, ეთიკური და მდგრადი განვითარების საფუძველი
ხელოვნური ინტელექტის ეპოქაში, მონაცემთა ხარისხი გადამწყვეტ როლს თამაშობს AI სისტემების ეფექტურობაში, ეთიკურობასა და მდგრადობაში. სტატია განმარტავს, თუ რას ნიშნავს „მაღალი ხარისხის“ მონაცემები – ანუ, მონაცემები, რომლებიც მიზანშეწონილია კონკრეტული ამოცანისთვის – და ხაზს უსვამს, თუ რატომ არის კრიტიკული მისი პრიორიტეტულობა განვითარების საწყისი ეტაპიდანვე. განიხილება ჰოლისტიკური მიდგომა, რომელიც მოიცავს მონაცემთა საგულდაგულო კურაციას, მართვის მყარ ჩარჩოს, მონაცემთა მრავალფეროვან წარმოდგენას და რეგულა

Apple-ის ნერვული პროცესორი და ხელოვნური ინტელექტი მოწყობილობაზე: Core ML-ით და MLX-ით მოდელების ადაპტირება
ეს სტატია იკვლევს მანქანური სწავლების მოდელების ოპტიმიზაციის პროცესს Apple-ის მოწყობილობებზე ეფექტურად გასაშვებად, ნერვული პროცესორის, Core ML-ისა და MLX ფრეიმვორკების გამოყენებით. ის ხაზს უსვამს ნერვული პროცესორის ენერგოეფექტურობას და იმ გამოწვევებს, რომელთა წინაშეც დეველოპერები დგანან Core ML-ის დახურული ხასიათის გამო. ავტორები წარმოადგენენ სამნაწილიან სერიას, რომელიც დეტალურად აღწერს კომპლექსური მოდელის (dots.ocr) PyTorch-დან მოწყობილობაზე გასაშვებად კონვერტაციის გზას, იზიარებენ პრაქტიკულ გად
ML მოდელების კონვერტაცია Apple-ის მოწყობილობებზე: Core ML-ისა და MLX-ის გამოყენება `dots.ocr`-ის მაგალითზე
სტატია დეტალურად აღწერს, თუ როგორ ხდება მანქანური სწავლების (ML) მოდელების, კერძოდ `dots.ocr`-ის, ოპტიმიზაცია Apple-ის მოწყობილობებზე გასაშვებად. განხილულია Apple-ის ნეირონული ძრავის ენერგოეფექტურობა და Core ML-ის, როგორც მასზე წვდომის ერთადერთი საშუალების, შეზღუდვები. ასევე წარმოდგენილია MLX, უფრო მოქნილი ფრეიმვორკი, რომელიც GPU-ს იყენებს. სერიის პირველი ნაწილი მოიცავს `dots.ocr`-ის PyTorch-დან Core ML-ზე კონვერტაციის პროცესს, წარმოქმნილ პრობლემებს და მათ გადაჭრის გზებს, რათა დეველოპერებს დაეხმ
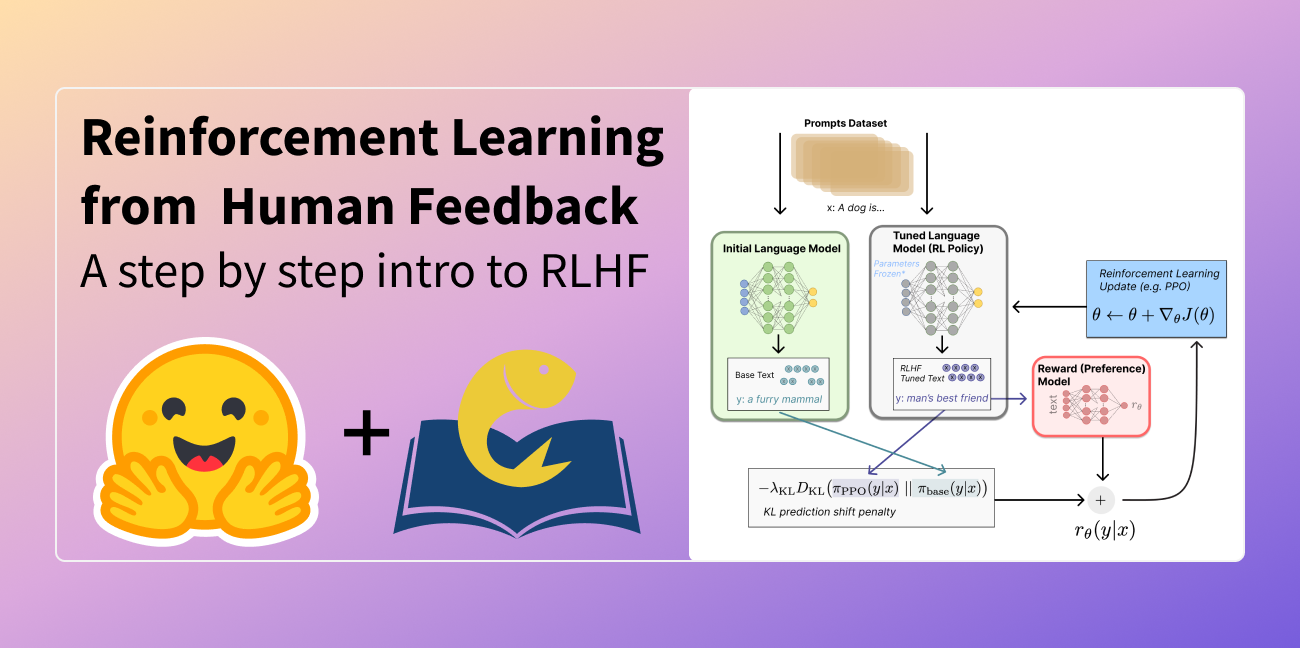
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები
Florence-2-ის დახვეწა DocVQA-სთვის: როგორ გავაუმჯობესოთ ვიზუალური კითხვა-პასუხის შესაძლებლობები
ეს სტატია განიხილავს Florence-2 მოდელის დახვეწის პროცესს DocVQA (დოკუმენტური ვიზუალური კითხვა-პასუხი) ამოცანებისთვის. მიუხედავად იმისა, რომ Florence-2 მხარს უჭერს მრავალ კომპიუტერული ხედვის ამოცანას, VQA ფუნქციონალი არ არის ჩაშენებული გამოშვებულ მოდელებში. სტატიაში დეტალურად არის აღწერილი Florence-2-ის არქიტექტურა, უნიკალური FLD-5B მონაცემთა ნაკრების შექმნის პროცესი, რომელიც მოდელის სიძლიერის საფუძველია, და სხვადასხვა დახვეწის მეთოდის ექსპერიმენტები. ლევენშტეინის მსგავსების მეტრიკის გამოყენებით,
ფლორენს-2 მოდელის დახვეწა DocVQA ამოცანისთვის: დეტალური მიმოხილვა
სტატიაში განხილულია Florence-2 ხელოვნური ინტელექტის მოდელის დახვეწის პროცესი დოკუმენტების ვიზუალური კითხვა-პასუხის (DocVQA) კონკრეტული ამოცანისთვის. მიუხედავად იმისა, რომ Florence-2 მრავალ ფუნქციას უშუალოდ ასრულებს, ვიზუალური კითხვა-პასუხის (VQA) შესაძლებლობა გამოცემულ მოდელებში არ შედის. ტექსტში აღწერილია მოდელის არქიტექტურა, მისი სიძლიერე უზარმაზარი FLD-5B მონაცემთა ნაკრებიდან, მონაცემთა ნაკრების ავტომატიზებული შექმნის პროცესი და ექსპერიმენტული შედეგები, რომლებიც აჩვენებს მუშაობის მნიშვნელოვან

BigCodeArena: კოდის გენერაციის ხელოვნური ინტელექტის მოდელების შეფასების ახალი სტანდარტი რეალური გაშვებით
BigCodeArena არის ინოვაციური პლატფორმა, რომელიც საშუალებას აძლევს მომხმარებლებს, შეადარონ ხელოვნური ინტელექტის კოდის გენერაციის მოდელები არა მხოლოდ კოდის წაკითხვით, არამედ მისი რეალური გაშვებით და შედეგების დანახვით. ის აგვარებს ტრადიციული შეფასების მეთოდების პრობლემებს, გვთავაზობს სანდბოქს გარემოებს კოდის ავტომატური გაშვებისთვის, მრავალსვლიან ინტერაქციებს და მომხმარებლის შეფასებებზე დაფუძნებულ ლიდერბორდს. პლატფორმა უკვე ლიდერბორდში აერთიანებს მოწინავე LLM-ების რეიტინგებს, აჩვენებს რა გამოკვეთილ
Gaudi2: Habana Labs-ის AI ამაჩქარებელი, რომელიც ტრენინგის დროს 5.75-ჯერ აჩქარებას გვთავაზობს
Habana Labs-მა წარმოადგინა Gaudi2, მეორე თაობის AI აპარატურული ამაჩქარებელი, რომელიც მნიშვნელოვნად აუმჯობესებს შესრულებას ტრენინგისა და ინფერენციისას პირველ თაობის Gaudi-სა და Nvidia A100-თან შედარებით. სტატიაში დეტალურად არის განხილული მისი ტექნიკური მახასიათებლები, Intel Developer Cloud-ზე წვდომის გზები, BERT-ის წინასწარი ტრენინგის შედეგები 5.75-ჯერ შემცირებული დროით და Stable Diffusion-ის მხარდაჭერა, ასევე დაყოვნების მაჩვენებლების გაუმჯობესება.