Hugging Face Optimum: ტრანსფორმერების მოდელების ტრენინგისა და ინფერენსის დაჩქარება
BERT-ისა და Transformer-ის მოდელების გამოყენება სულ უფრო იზრდება სხვადასხვა სფეროში, თუმცა ისინი ხშირად ნელი და მოცულობითია. Hugging Face-მა შექმნა Optimum – გაფართოება, რომელიც ამ მოდელების ტრენინგსა და ინფერენსს აჩქარებს. Optimum უზრუნველყოფს ოპტიმიზებულ შესრულებას დაჩქარებულ აპარატურაზე, მათ შორის ONNX Runtime-თან ინტეგრაციით, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გადავიდნენ სტანდარტული Transformers API-დან ოპტიმიზებულ ვერსიაზე, მოდელების კვანტიზაციისა და გრაფის ოპტიმიზაციის ჩათვლით.

„პატარა აგენტები“ პითონში: ახალი ეპოქა LLM-ების და ინსტრუმენტების ურთიერთქმედებაში
ეს ბლოგპოსტი წარმოგიდგენთ „პატარა აგენტების“ (Tiny Agents) პითონზე პორტირებას, სადაც `huggingface_hub` კლიენტის SDK გაფართოვდა, რათა იმოქმედოს როგორც MCP კლიენტი. მთავარი სიახლეა MCP (მოდელის კონტექსტის პროტოკოლი), ღია სტანდარტი, რომელიც აერთიანებს დიდი ენობრივი მოდელების (LLM) გარე ინსტრუმენტებთან და API-ებთან ურთიერთქმედებას, რითაც აღარ საჭიროებს ყოველი ინსტრუმენტისთვის მორგებულ ინტეგრაციებს. სტატია განმარტავს, თუ როგორ უნდა დაიწყოთ მუშაობა პითონის აგენტებთან, რომლებიც დაკავშირებულია MCP სერვე
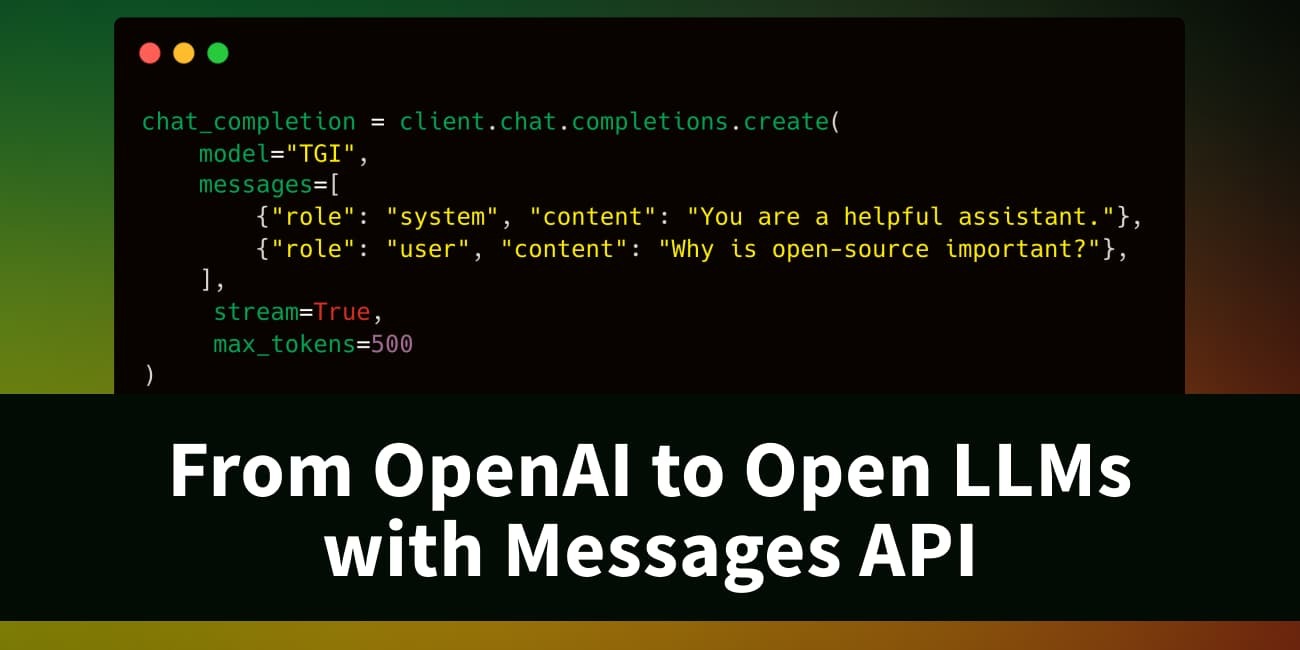
TGI-ის Messages API: OpenAI-თან თავსებადობა და შეუფერხებელი გადასვლა ღია LLM-ებზე
TGI-ის (Text Generation Inference) ვერსია 1.4.0-დან დაწყებული, ხელმისაწვდომია ახალი Messages API, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-სთან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდ ენობრივ მოდელებზე (LLM). API შეიძლება გამოყენებულ იქნას OpenAI-ის კლიენტის ბიბლიოთეკებთან ან მესამე მხარის ხელსაწყოებთან, როგორიცაა LangChain და LlamaIndex. Messages API ასევე ხელმისაწვდომია Hugging Face-ის Inference Endpoints-ზე
TGI-ის Messages API: უწყვეტი გადასვლა ღია LLM-ებზე OpenAI-ის თავსებადობით
TGI (Text Generation Inference) 1.4.0 ვერსიიდან მოყოლებული, გთავაზობთ Messages API-ს, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-თან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდი ენის მოდელებზე (LLM-ებზე), არსებული კლიენტის ბიბლიოთეკების ან მესამე მხარის ხელსაწყოების (როგორიცაა LangChain და LlamaIndex) გამოყენებით. სტატია დეტალურად აღწერს მოდელების Hugging Face Inference Endpoints-ზე განთავსების, ტექნიკური კონფიგურაც
პერსონალიზებული AI მოდელები LLM-ების დახმარებით: დაზოგეთ ხარჯები და გაზარდეთ ეფექტურობა
სტატია განიხილავს პერსონალიზებული ხელოვნური ინტელექტის (AI) მოდელების დახვეწასა და LLM API-ების გამოყენებას შორის არსებულ დილემას, შემდეგ კი წარმოადგენს ინოვაციურ ჰიბრიდულ მიდგომას. ეს მეთოდი იყენებს ღია კოდის LLM-ებს მაღალი ხარისხის სინთეზური მონაცემების გენერირებისთვის, რათა მოამზადოს სპეციალიზებული მოდელები. შემთხვევის შესწავლა აჩვენებს ხარჯების, ენერგიის მოხმარების და დაყოვნების დროის მნიშვნელოვან გაუმჯობესებას GPT-4-ის მსგავს დიდ LLM API-ებთან შედარებით, პარალელურად ინარჩუნებს მსგავს ეფექტუ

Holo1 და Surfer-H: ხელოვნური ინტელექტის ახალი ეპოქა ვებ-ავტომატიზაციაში
კომპანია H-მა Hugging Face-ზე გამოუშვა Holo1 – ღია წყაროს Action VLM-ების პირველი ოჯახი, რომელიც შექმნილია ვებ UI-ის ღრმა გაგებისა და ზუსტი ლოკალიზაციისთვის. Surfer-H, აგენტი, რომელიც Holo1-ზეა დაფუძნებული, ბრაუზერებთან ადამიანის მსგავსად ურთიერთობს, რაც ბიზნესებს სთავაზობს მაღალი სიზუსტის (92.2%) და ხარჯთეფექტურ ვებ-ავტომატიზაციის გადაწყვეტილებებს ($0.13 თითო ამოცანაზე). ეს ინოვაციები წარმოადგენს გარღვევას ვებ-ავტომატიზაციის სფეროში, გააჩნია Apache 2.0 ლიცენზია.
TAPEX: რევოლუციური მიდგომა ცხრილის წინასწარი ვარჯიშისთვის ნერვული SQL შემსრულებლის მეშვეობით
ნაშრომში „TAPEX: ცხრილის წინასწარი ვარჯიში ნერვული SQL შემსრულებლის სწავლით“ წარმოდგენილია ინოვაციური მეთოდი, რომელიც იყენებს სინთეზურ მონაცემებს და ნერვულ SQL შემსრულებელს ცხრილების წინასწარი ვარჯიშისთვის. ეს მიდგომა უზრუნველყოფს პროგრამების მრავალფეროვნებასა და მასშტაბს, რაც გაუვალია ბუნებრივი ენის მოდელებისთვის. TAPEX-მა აჩვენა რეკორდული შედეგები სხვადასხვა ამოცანებზე, მათ შორის ცხრილის კითხვებზე პასუხის გაცემასა და ფაქტების გადამოწმებაზე, რითაც მნიშვნელოვნად აჯობა წინა მეთოდებს და მიაღწია 50
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.

როგორ მოვაგვარეთ AI-ის არაეფექტური ტრენინგის პრობლემა: მონაცემთა მილსადენის ოპტიმიზაცია
ჩვენი nanoVLM პროექტის ფარგლებში AI მოდელების ტრენინგის შენელების პრობლემა აღმოვაჩინეთ. დეტალური ანალიზის შემდეგ გაირკვა, რომ პრობლემა არც მოდელში და არც აპარატურაში იყო, არამედ მონაცემთა მილსადენის არაეფექტურობაში. ამ სტატიაში აღწერილია ხუთსაფეხურიანი მიდგომა, თუ როგორ მოხდა მილსადენის ოპტიმიზაცია, მათ შორის „ზურგჩანთის პრობლემის“ (knapsack problem) გამოყენებით, რამაც მნიშვნელოვნად შეამცირა დაუფიქსირებელი მონაცემების (padding) რაოდენობა და გაზარდა ტრენინგის ეფექტურობა.
AI მონაცემთა მილსადენის ოპტიმიზაცია: როგორ დავზოგოთ GPU რესურსები და გავზარდოთ ეფექტურობა
კომპანია nanoVLM-ის პროექტზე მუშაობისას აღმოჩნდა, რომ ვარჯიშის ნელი ტემპი არა მოდელის ან აპარატურის, არამედ მონაცემთა მილსადენის არაეფექტურობის ბრალი იყო. პრობლემა ძირითადად გამოწვეული იყო მონაცემების ზედმეტი „შევსებით“ (padding), რაც GPU-ს რესურსების 60%-მდე უქმად ხარჯავდა. ამ პოსტში აღწერილია ხუთეტაპიანი სტრატეგია ეფექტური მილსადენის შესაქმნელად, მათ შორის დინამიური დაჯგუფება, ზურგჩანთის ამოცანის (knapsack problem) გამოყენება და „ბინ-ფექინგის“ მეთოდები. შედეგად, მიღწეულია მინიმალური შევსება და
Twitter-ზე სენტიმენტების ანალიზი: დამწყებთათვის სრული გზამკვლევი
ეს გზამკვლევი მოიცავს ყველაფერს, რაც უნდა ისწავლოთ Twitter-ზე სენტიმენტების ანალიზის დასაწყებად, როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. თქვენ გაეცნობით Inference API-ის გამოყენებას კოდის რამდენიმე ხაზით ან Zapier-ის, უ-კოდო ხელსაწყოს მეშვეობით, ტვიტების შესაგროვებლად, გასაანალიზებლად და შედეგების Google Sheets-ში გასაგზავნად. ისწავლეთ, როგორ გამოიყენოთ მანქანური სწავლება ბრენდის მონიტორინგისთვის და მომხმარებლის უკუკავშირის გასაანალიზებლად.
Twitter-ზე სენტიმენტების ანალიზი: სრული გზამკვლევი
ეს გზამკვლევი წარმოგიდგენთ Twitter-ზე სენტიმენტების ანალიზის ყოვლისმომცველ, ნაბიჯ-ნაბიჯ პროცესს, რომელიც განკუთვნილია როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. ის განმარტავს სენტიმენტების ანალიზის არსს, მის მნიშვნელობას ბიზნესისთვის და გვიჩვენებს, თუ როგორ შეიძლება ისეთი ხელსაწყოების გამოყენება, როგორიცაა Inference API, Zapier და Python-ის ბიბლიოთეკები, რათა ტვიტებიდან ღირებული ინფორმაცია მოვიპოვოთ, მომხმარებელთა უკუკავშირი აღმოვაჩინოთ და ბრენდის ხსენებებს რეალურ დროში დავაკვირდეთ.

Gradio MCP სერვერების მასშტაბური განახლება: ვერსია 5.38.0-ის ახალი ფუნქციები
Gradio-მ გამოუშვა MCP სერვერების 5.38.0 ვერსია, რომელსაც ემატება მნიშვნელოვანი გაუმჯობესებები. ახლა შესაძლებელია ფაილების პირდაპირი ატვირთვა, AI ამოცანების პროგრესის რეალურ დროში მონიტორინგი, API-ების ავტომატური ინტეგრაცია OpenAPI-ის მეშვეობით, გაუმჯობესებული აუთენტიფიკაცია და ხელსაწყოების აღწერის მორგება. ეს განახლება დეველოპერებს მუშაობას უმარტივებს და ზრდის Gradio აპლიკაციების შესაძლებლობებს.
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
Hugging Face-ის ტრანსფორმატორები TensorFlow-ის ინჟინრებისთვის: გზამკვლევი
სტატია განიხილავს PyTorch-ის ინჟინრების მიერ TensorFlow-თან მიდგომის ხშირ შეცდომას, კერძოდ, Keras-ის მაღალი დონის API-ის უგულებელყოფას. ხაზგასმულია, რომ Keras-ის გამოყენება TensorFlow-სთან ოპტიმალურია. შემდეგ წარმოდგენილია Hugging Face-ის ტრანსფორმატორები, როგორც ძლიერი ინსტრუმენტები, რომლებიც TensorFlow-ის ინჟინრებს საშუალებას აძლევს, გამოიყენონ უახლესი მოდელები ნაცნობი Keras API-ის მეშვეობით. დეტალურად არის ახსნილი ტრანსფერული სწავლის (transfer learning) კონცეფცია, როგორც ML პრობლემების გადაჭრ
Idefics2: Hugging Face-ის ახალი, 10-ჯერ მცირე ზომის მულტიმოდალური AI მოდელი მნიშვნელოვანი გაუმჯობესებებით
Idefics2, Hugging Face-ის ახალი მულტიმოდალური AI მოდელი, მისი წინამორბედისგან განსხვავებით 10-ჯერ მცირე ზომისაა და მნიშვნელოვნად გაუმჯობესებულ შესაძლებლობებს გვთავაზობს. ის გაწვრთნილია მრავალფეროვან მონაცემთა ნაკრებებზე, მათ შორის ახლად გამოშვებულ „The Cauldron“-ზე, რომელიც მრავალმხრივი საუბრებისთვისაა განკუთვნილი. მოდელი, რომელიც აგებულია Mistral-7B-v0.1-სა და siglip-so400m-patch14-384-ზე, უკვე ხელმისაწვდომია Hugging Face Hub-ზე Apache-2.0 ლიცენზიით.

Flux.1-Dev მოდელის ინფერენციის ოპტიმიზაცია LoRA-ს გამოყენებით: 2.3x-მდე სიჩქარის ზრდა
ეს პოსტი დეტალურად განიხილავს Flux.1-Dev ტექსტიდან გამოსახულების გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაციას, განსაკუთრებით LoRA-ების გამოყენებისას. შემოთავაზებულია "ცხელი გაცვლის" (hotswapping) ტექნიკა ხელახალი კომპილაციის თავიდან ასაცილებლად, FP8 კვანტიზაციის უპირატესობები, და სტრატეგიები სამომხმარებლო GPU-ებისთვის, როგორიცაა RTX 4090, CPU-ზე გადმოტვირთვით და T5 ტექსტური ენკოდერის კვანტიზაციით, რაც უზრუნველყოფს 2.3-ჯერადი სიჩქარის ზრდას.
Flux.1-Dev-ის ოპტიმიზაცია LoRAs-ით: ინფერენციის სიჩქარისა და მეხსიერების გაუმჯობესება
ამ პოსტში განხილულია Flux.1-Dev ტექსტი-გამოსახულებაზე გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაცია LoRA ადაპტერების გამოყენებისას. LoRAs-ის ფართო გამოყენებისა და მრავალფეროვნების გათვალისწინებით, რთულია მათი ცხელად ცვლა (hotswap) მოდელის გადაკომპილაციის გარეშე, რაც სიჩქარის დაკარგვას იწვევს. სტატია გვთავაზობს ოპტიმიზაციის რეცეპტს, რომელიც მოიცავს `hotswap=True` ფუნქციის გამოყენებას, `torch.compile`-ს, FP8 კვანტიზაციას, CPU-ზე გადატვირთვას (CPU offloading) და T5 ტექსტური ენკოდერის კვანტიზა

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.
Gradio-ს გადატვირთვის რეჟიმი: ხელოვნური ინტელექტის აპლიკაციების სწრაფი შექმნა
ეს სტატია განმარტავს Gradio-ს გადატვირთვის რეჟიმის (reload mode) მუშაობის პრინციპს, რაც დეველოპერებს საშუალებას აძლევს, ავტომატურად განაახლონ კოდის ცვლილებები სერვერის გადატვირთვის გარეშე. აღწერილია, თუ როგორ შეიძლება ამ რეჟიმის გამოყენება ხელოვნური ინტელექტის აპლიკაციის სწრაფად შესაქმნელად Hugging Face Inference API-სა და LLM-ების მეშვეობით, რომელიც დოკუმენტების სურათებიდან შეკითხვებზე პასუხებს ბუნებრივ ენაზე გასცემს.

OpenAI-ის GPT OSS მოდელები Hugging Face-ზე: გაუმჯობესებული ხელმისაწვდომობა და ოპტიმიზებული წარმადობა
OpenAI-მ Apache 2.0 ლიცენზიით გამოუშვა ღია კოდის GPT OSS მოდელები, რომელთა მიზანია ხელოვნური ინტელექტის ფართო ხელმისაწვდომობის უზრუნველყოფა უსაფრთხო და პასუხისმგებლიანი გამოყენებით. Hugging Face-თან ინტეგრაციით, მომხმარებლებს შეუძლიათ ისარგებლონ გაუმჯობესებული არქიტექტურით, მათ შორის mxfp4 კვანტიზაციით, Flash Attention 3-ითა და MegaBlocks MoE ქერნელებით, რაც უზრუნველყოფს მნიშვნელოვან მეხსიერების დაზოგვას და მაღალ წარმადობას როგორც NVIDIA, ისე AMD GPU-ებზე. ეს ინიციატივა ხელს უწყობს AI-ის ინოვაცი
LLM-ის მუშაობის ლიდერბორდი: სიჩქარე, ფასი და ხარისხი AI აპლიკაციებისთვის Hugging Face-ზე
Artificial Analysis-მა გამოაქვეყნა LLM-ის მუშაობის ლიდერბორდი Hugging Face-ზე, რომელიც აფასებს 100-ზე მეტი უსერვერო LLM API ენდპოინტის სიჩქარეს, ფასსა და ხარისხს. ეს ინსტრუმენტი მიზნად ისახავს AI ინჟინრებს დაეხმაროს გადაწყვეტილებების მიღებაში, თუ რომელი მოდელები და პროვაიდერები გამოიყენონ თავიანთ აპლიკაციებში, რადგან სამომხმარებლო და კომპლექსური AI სისტემებისთვის მუშაობის ეს ფაქტორები კრიტიკულია.