T2I-Adapters-ის ახალი ერა: Stable Diffusion XL-ის გაუმჯობესებული შესაძლებლობები
ControlNet-ის მაღალი გამოთვლითი ხარჯებისა და ზომის პრობლემების საპასუხოდ, T2I-Adapters გვთავაზობს ეფექტურ გადაწყვეტას გამოსახულების გენერაციისთვის. ის უფრო კომპაქტურია და ხმაურის შემცირების პროცესში მხოლოდ ერთხელ მუშაობს. Diffusers-ის გუნდმა და T2I-Adapter-ის ავტორებმა Stable Diffusion XL-ისთვის (SDXL) T2I-Adapters-ის მხარდაჭერა დანერგეს, რამაც შესაძლებელი გახადა SDXL-ის მაღალი ხარისხის გენერაციის შენარჩუნება გაუმჯობესებული სიჩქარით, მეხსიერებითა და კონტროლის შესაძლებლობებით. ეს ბლოგპოსტი წარმოა

Sentence Transformers v2: რევოლუციური განახლებები და ინტეგრაცია Hugging Face Hub-თან
Sentence Transformers-ის v2 ვერსიის გამოშვება ახალ შესაძლებლობებს გვთავაზობს წინადადების, აბზაცისა და გამოსახულების ემბედინგებისთვის. განახლება მოიცავს Hugging Face Hub-თან ღრმა ინტეგრაციას, 90-ზე მეტი წინასწარ გაწვრთნილი მოდელით 100-ზე მეტი ენისთვის. წარმოდგენილია ახალი ვიჯეტები – ფუნქციის ექსტრაქციისა და წინადადების მსგავსების გამოსათვლელად, ასევე API ინტერფეისები მოდელებთან პროგრამული წვდომისთვის, რაც საზოგადოებას საშუალებას აძლევს მარტივად გააზიაროს და გამოიყენოს თავისი გაწვრთნილი მოდელები.
SmolVLM2: ვიდეოს გაგება ხელმისაწვდომი ხდება ყველა მოწყობილობაზე
SmolVLM2 წარმოადგენს ფუნდამენტურ ცვლილებას ვიდეოს გაგების მიდგომაში, მოძრაობს მასიური, რესურსმომთხოვნი მოდელებიდან ეფექტურ, ნებისმიერ მოწყობილობაზე გაშვებად გადაწყვეტილებებზე. მიზანია ვიდეოს გაგება ხელმისაწვდომი გახდეს ყველა მოწყობილობისთვის, ტელეფონებიდან სერვერებამდე. გამოშვებულია სამი ზომის (2.2B, 500M და 256M) მოდელი, MLX-თან თავსებადობით (Python და Swift API-ები). ეს მოდელები, მიუხედავად მცირე ზომისა, მნიშვნელოვნად აღემატება არსებულ ანალოგებს მეხსიერების მოხმარების მხრივ და ზოგიერთ შემთხვევ
Hugging Face spaCy-ის ინტეგრაციით მოდელების გაზიარებასა და გამოყენებას ამარტივებს
Hugging Face-მა და spaCy-იმ განახორციელეს ინტეგრაცია, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ, დააყენონ და გამოიყენონ spaCy-ის კონვეიერები და მოდელები. ახალი ფუნქციონალი მოიცავს ავტომატურ მეტამონაცემების გენერაციას, დასკვნის (Inference) API-ს NER-ისთვის (Named Entity Recognition), ბრაუზერში ინტერაქტიულ ტესტირებას, `pip install`-ის მხარდაჭერას და `spacy-huggingface-hub` ბიბლიოთეკას მოდელების სწრაფი გაზიარებისთვის. ხელმისაწვდომია 60-ზე მეტი კანონიკური მოდელი, და მალე დაემატება ტექსტ
Hugging Face-ი და Graphcore-ი AI-ის ოპტიმიზაციისთვის პარტნიორობენ IPU-ებზე Transformer მოდელების განვითარებით
Hugging Face-ის ახალი აპარატურის პარტნიორის პროგრამა Graphcore-ის სისტემების მომხმარებელ დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ IPU-ებისთვის ოპტიმიზებული უახლესი Transformer მოდელები. ეს თანამშრომლობა მიზნად ისახავს ხელოვნური ინტელექტის აპლიკაციების დაჩქარებას, მაღალი წარმადობისა და ეფექტურობის უზრუნველყოფით ისეთ სფეროებში, როგორიცაა ბუნებრივი ენის დამუშავება (NLP), კომპიუტერული ხედვა და სხვა.
ობიექტის ამოცნობის ლიდერბორდი: მეტრული მაჩვენებლების გაგება და კრიტიკული შეფასება
Hugging Face Hub-მა გამოაქვეყნა ობიექტის ამოცნობის ლიდერბორდი, რომელიც აფასებს მოდელებს სხვადასხვა მეტრიკის საფუძველზე, როგორიცაა „კვეთა გაერთიანებაზე“ (IoU), „საშუალო სიზუსტე“ (AP) და „საშუალო გახსენება“ (AR). ეს ბლოგი დეტალურად განიხილავს მოდელების შეფასების მეთოდებს, განმარტავს გამოყენებულ მეტრიკას და მიზნად ისახავს შეფასებისას წარმოშობილი სირთულეების გამარტივებას, რათა მომხმარებლებს შეეძლოთ მოდელის მუშაობის კრიტიკულად შეფასება. ასევე ახსნილია ობიექტის ამოცნობის კონცეფცია, მისი აპლიკაციები და
Hugging Face-ის ზაფხულის განახლებები: ივნისი, ივლისი, აგვისტო
ეს პოსტი აჯამებს Hugging Face-ის ივნის-აგვისტოს განახლებებს, მათ შორის საჯარო მოდელების რეპოზიტორიების 10,000-დან 16,000-მდე ზრდას. წარმოდგენილია ახალი ფუნქციები, როგორიცაა „Spaces“ ML დემო აპლიკაციების ჰოსტინგისთვის, ნივთების „მოწონების“ შესაძლებლობა, TensorBoard-ის ინტეგრაცია, შეფასების მეტრიკები, რომლებიც დაკავშირებულია Papers With Code-თან, ახალი ვიჯეტები სხვადასხვა ML ამოცანებისთვის (აუდიო, სტრუქტურირებული მონაცემები, გამოსახულება), გაუმჯობესებული დოკუმენტაცია, რეპოზიტორიების გადატანა/გადარ
მარტივად შექმენით ინტერაქტიული ML დემოები Gradio-თი Hugging Face Spaces-ზე
ეს სტატია განმარტავს, თუ როგორ უნდა შექმნათ და უმასპინძლოთ ინტერაქტიულ მანქანური სწავლების მოდელების დემოებს Hugging Face Spaces-ზე Gradio-ს გამოყენებით. ის დეტალურად აღწერს პროცესს ინტერფეისების განსაზღვრიდან რთული მოდელების პაიპლაინების განთავსებამდე, ხაზს უსვამს Hugging Face-ის Inference API-სთან ინტეგრაციასა და Gradio Series-ის მოქნილობას.
Hugging Face PRO მომხმარებლებისთვის ინფერენსის API ხელმისაწვდომი ხდება
Hugging Face-მა PRO მომხმარებლებისთვის ახალი ინფერენსის API გამოუშვა, რომელიც ექსკლუზიურ წვდომას აძლევს მათ კურირებულ, ულტრა-სწრაფ მოდელებზე, გაუმჯობესებული მოთხოვნათა ლიმიტებით. სიახლე ამარტივებს მოწინავე AI მოდელებთან ექსპერიმენტებს, პროტოტიპირებას და ინტეგრაციას დეველოპმენტის გარემოებებში, ინფრასტრუქტურის განლაგების საჭიროების გარეშე. სერვისი მოიცავს ტექსტის, კოდისა და გამოსახულების გენერაციის შესაძლებლობებს.
როგორ განათავსოთ AI Comic Factory თქვენს პირად სივრცეში და თავიდან აიცილოთ ლოდინი
AI Comic Factory, აპლიკაცია, რომელმაც ათასობით მომხმარებელი მოიზიდა საკუთარი AI კომიქსების შესაქმნელად, წარმოუდგენლად პოპულარული გახდა. ეს გაკვეთილი გიჩვენებთ, თუ როგორ უნდა მოახდინოთ მისი კლონირება (fork) და კონფიგურაცია, რათა თავიდან აიცილოთ ხანგრძლივი ლოდინის დრო და განათავსოთ აპლიკაცია თქვენს პირად Hugging Face სივრცეში Inference API-ის გამოყენებით. მართალია, არ არის საჭირო ძლიერი ტექნიკური უნარები, მაგრამ რეკომენდებულია API-ების, გარემოს ცვლადების (environment variables) და LLM-ებისა და Sta
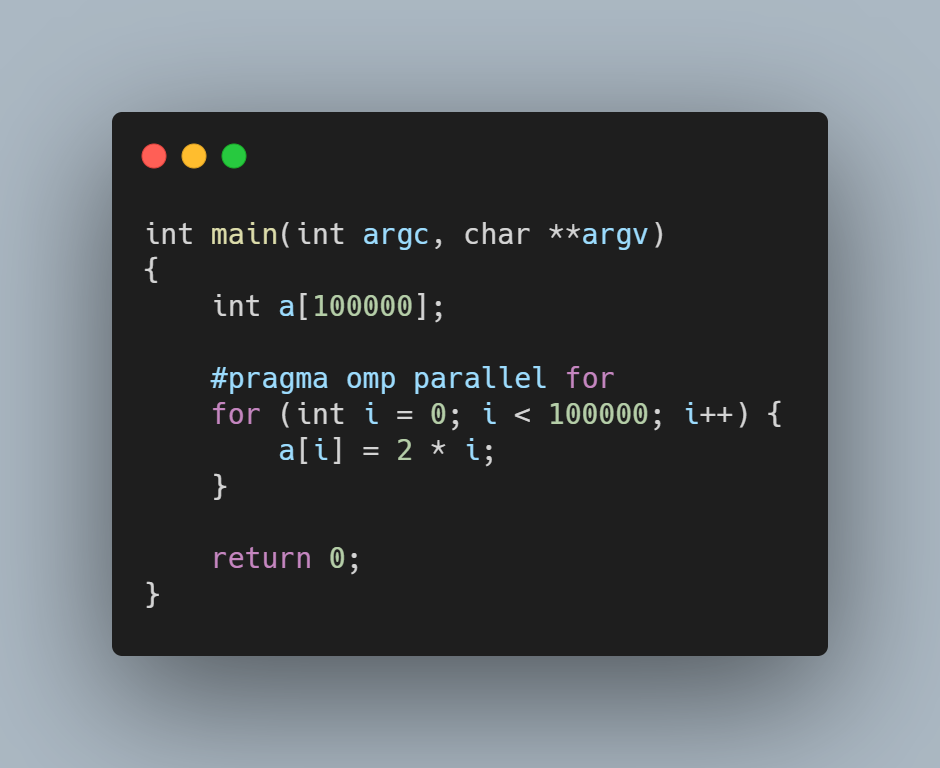
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და
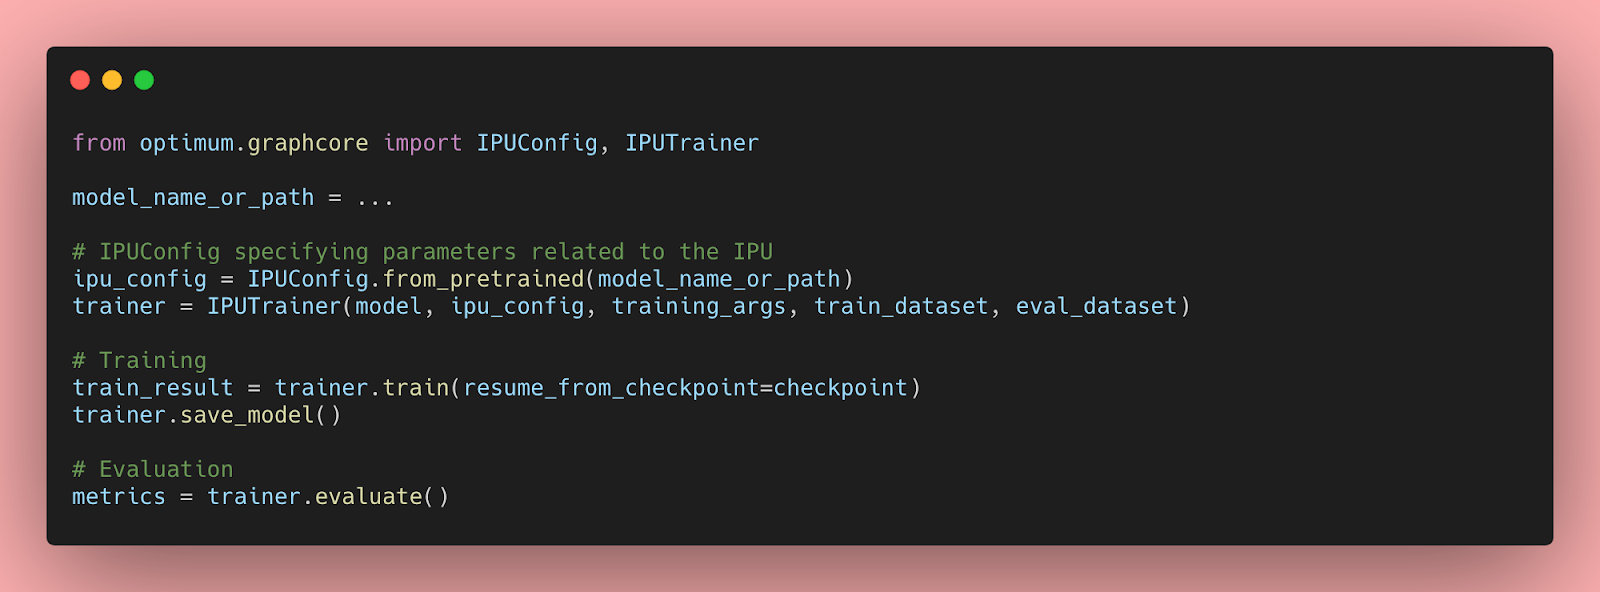
Transformer მოდელების აჩქარება Graphcore IPU-ებზე Hugging Face Optimum-ით
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. Graphcore-სა და Hugging Face-ის პარტნიორობის ფარგლებში, ახლა წარმოდგენილია BERT, როგორც პირველი IPU-ზე ოპტიმიზებული მოდელი, რომელიც განკუთვნილია Graphcore-ის ინტელექტუალური დამუშავების ერთეულისთვის (IPU). ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ Optimum და IPU-ები BERT მოდელების მარტივად გასაწვრთნელად და დასაჩქარებლად, მ
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე

LLM ინფერენციის სამართლიანი დაგეგმვა: გამოწვევები და გადაწყვეტები
სტატია მიმოიხილავს LLM ინფერენციის ძრავებში (მაგ. vLLM, HuggingFace TGI) სამართლიანი დაგეგმვის გამოწვევებს, სადაც GPU-ზე ჯგუფური დამუშავება ეფექტურია, თუმცა ერთი მომხმარებელი ხშირად მონოპოლიზებს ბექენდის რიგს. TNG-ის მიერ შემოთავაზებული გადაწყვეტა მოიცავს ცალკე API სერვერს ("LLM-სერვერს"), რომელიც მართავს მოთხოვნებს ინფერენციის ძრავამდე. ეს სერვერი იყენებს თითოეული მომხმარებლისთვის ცალკეულ რიგებს და "მრგვალი მაგიდის" (round-robin) პრინციპით დაგეგმვას სამართლიანობისთვის. ის ასევე ითვალისწინებს მო
NLP მოდელების შედარებითი ანალიზი: RoBERTa, Mistral-7b და Llama-2-7b LoRA-ს გამოყენებით კატასტროფის ტვიტების კლასიფიკაციისთვის
ბუნებრივი ენის დამუშავების (NLP) სწრაფად განვითარებად სამყაროში, ენობრივი მოდელების შედარება გადამწყვეტია მათი ოპტიმალური გამოყენებისთვის კონკრეტულ ამოცანებში. ეს პოსტი ეძღვნება სამი მოდელის – RoBERTa, Mistral-7b და Llama-2-7b – შედარებას კატასტროფების შესახებ ტვიტების კლასიფიკაციის პრობლემაში. კვლევაში გამოყენებულია PEFT (Parameter-Efficient Fine-Tuning) ტექნიკის LoRA (Low-Rank Adaptation) მეთოდი, რომელიც მნიშვნელოვნად ამცირებს პარამეტრების რაოდენობას მოდელის წვრილად მორგებისას. განხილულია თითო

Gradio-ს 5-წლიანი გზა: როგორ გახდა ის AI ვებ აპლიკაციების სტანდარტი
5 წლის წინ Stanford-ის მკვლევრებისთვის შექმნილი Gradio დღეს მილიონობით დეველოპერს ეხმარება AI ვებ აპლიკაციების შექმნასა და გაზიარებაში. სტატია მიმოიხილავს Gradio-ს ზრდის სტრატეგიებს, მათ შორის, დაბალდონიანი API-ების განვითარებას მაღალი დონის აბსტრაქციების ნაცვლად, ვიწრო, მზარდ ნიშაზე ფოკუსირებას (ML ვებ აპლიკაციები) და მომხმარებლებისთვის გაზიარების მარტივი მექანიზმების შეთავაზებას.

Gradio: ყოვლისმომცველი ჩარჩო AI/ML აპლიკაციების შესაქმნელად – მეტი, ვიდრე უბრალო UI ბიბლიოთეკა
Gradio, რომელიც ხშირად აღიქმება მხოლოდ UI ბიბლიოთეკად, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ურთიერთობისთვის UI-ებისა და API-ების მეშვეობით, რომელიც უზრუნველყოფს მაღალ შესრულებას, უსაფრთხოებასა და რეაგირებას. სტატია დეტალურად განიხილავს Gradio-ს უნიკალურ მახასიათებლებს, როგორებიცაა API Recorder, სერვერული რენდერინგი (SSR), დახვეწილი რიგების სისტემა, სტრიმინგი, მრავალგვერდიანი აპლიკაციების მხარდაჭერა, Groovy ტრანსპილაცია, თემების სისტემა, დინამიური რენდერინგი, Grad
Gradio: მეტი ვიდრე უბრალოდ UI ბიბლიოთეკა – ხელოვნური ინტელექტის აპლიკაციების მძლავრი ჩარჩო
Gradio, რომელიც ხშირად მხოლოდ UI ბიბლიოთეკად აღიქმება, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ინტერფეისებისა და API-ების მეშვეობით ურთიერთობისთვის, რაც უზრუნველყოფს მაღალ წარმადობას, უსაფრთხოებასა და რეაგირებას. ეს სტატია წარმოგიდგენთ მის უნიკალურ მახასიათებლებს, რომლებიც გადამწყვეტია თანამედროვე AI აპლიკაციების შესაქმნელად.

MCP (Model Context Protocol): ახალი სტანდარტი AI აგენტებისა და LLM-ების ინტეგრაციისთვის
ბოლო კვირების განმავლობაში, MCP-ის (Model Context Protocol) სიღრმისეული შესწავლის შედეგად, ნათელი გახდა მისი მნიშვნელობა ხელოვნური ინტელექტის განვითარებაში. ეს არის მარტივი, მაგრამ ძლიერი სტანდარტული API, რომელიც დიდ ენობრივ მოდელებს (LLM) საშუალებას აძლევს, ეფექტურად გამოიყენონ სხვადასხვა ხელსაწყოები. სტატია დეტალურად აღწერს MCP კლიენტის განხორციელებას Typescript-ში და ხაზს უსვამს, თუ როგორ ამარტივებს ის Agentic AI-ს შექმნას. იგი განიხილავს LLM-ების „ფუნქციის გამოძახების“ შესაძლებლობებს და აჩვე
Habana Labs და Hugging Face-ი თანამშრომლობენ ტრანსფორმერული მოდელების ტრენინგის დასაჩქარებლად
Habana Labs, ღრმა სწავლის პროცესორების პიონერი, და Hugging Face, ტრანსფორმერული მოდელების ცენტრალური პლატფორმა, აცხადებენ პარტნიორობის შესახებ, რომლის მიზანია მაღალი ხარისხის ტრანსფორმერული მოდელების სწავლების პროცესის გამარტივება, დაჩქარება და გაიაფება. Habana-ს SynapseAI პროგრამული პაკეტის Hugging Face Optimum-ის ღია კოდის ბიბლიოთეკასთან ინტეგრაცია საშუალებას მისცემს მონაცემთა მეცნიერებსა და მანქანური სწავლების ინჟინრებს, ეფექტურად გამოიყენონ Habana Gaudi პროცესორები, შეამცირონ ხარჯები და გაზა

დიდი ML მოდელების სწავლება: FullyShardedDataParallel (FSDP) შესაძლებლობები
მანქანური სწავლების (ML) მოდელების მუდმივად მზარდი მასშტაბები აპარატურულ შეზღუდვებს წარმოქმნის. ეს სტატია იკვლევს, თუ როგორ უმკლავდება განაწილებული სწავლება, კერძოდ PyTorch-ის FullyShardedDataParallel (FSDP) ფუნქცია, ამ გამოწვევას. ჩვენ ვადარებთ FSDP-ის წარმადობას DDP-სთან GPT-2 მოდელების გამოყენებით, ვაჩვენებთ FSDP-ის უნარს, მოახდინოს უფრო დიდი პაკეტის ზომების დამუშავება და კიდევ უფრო დიდი მოდელების სწავლება, რითაც ხელმისაწვდომს ხდის მძლავრ ML ტექნოლოგიებს.
დიდი ML მოდელების ეფექტური ვარჯიში: PyTorch FSDP-ის გამოყენება განაწილებულ სისტემებში
მანქანური სწავლების (ML) მოდელების მზარდი ზომისა და პარამეტრების გამო, სპეციალისტებს უჭირთ მათი ვარჯიში სტანდარტულ აპარატურაზე, მიუხედავად იმისა, რომ დიდი მოდელები უფრო სწრაფად სწავლობენ და მაღალ წარმადობას ავლენენ. ამ გამოწვევის საპასუხოდ, განაწილებული სწავლება ხდება გადამწყვეტი. ეს სტატია იკვლევს მონაცემთა პარალელიზმს ZeRO კონცეფციის გამოყენებით და კონკრეტულად PyTorch-ის უახლეს ფუნქციას, FullyShardedDataParallel (FSDP)-ს. DeepSpeed-ისა და FairScale-ის მიერ დანერგილი ZeRO-ის იდეები, PyTorch-ში
Hugging Face-მა C სერიის დაფინანსებით 100 მილიონი დოლარი მოიზიდა: ხელოვნური ინტელექტის მომავლისკენ
Hugging Face-მა, ხელოვნური ინტელექტის წამყვანმა პლატფორმამ, 100 მილიონი დოლარის დაფინანსება მოიზიდა C სერიის ფარგლებში, Lux Capital-ის ხელმძღვანელობით, Sequoia-სა და Coatue-ის მნიშვნელოვანი მონაწილეობით. კომპანია, რომელიც 2018 წლიდან მასშტაბურ ზრდას განიცდის, განაგრძობს მანქანური სწავლების დემოკრატიზაციას ღია წყაროს, გამჭვირვალობისა და თანამშრომლობის პრინციპებზე დაყრდნობით, რათა ხელი შეუწყოს პასუხისმგებლიან ხელოვნურ ინტელექტს და გაუმკლავდეს სფეროს გამოწვევებს.