კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)
NLP მოდელების შედარებითი ანალიზი: RoBERTa, Mistral-7b და Llama-2-7b LoRA-ს გამოყენებით კატასტროფის ტვიტების კლასიფიკაციისთვის
ბუნებრივი ენის დამუშავების (NLP) სწრაფად განვითარებად სამყაროში, ენობრივი მოდელების შედარება გადამწყვეტია მათი ოპტიმალური გამოყენებისთვის კონკრეტულ ამოცანებში. ეს პოსტი ეძღვნება სამი მოდელის – RoBERTa, Mistral-7b და Llama-2-7b – შედარებას კატასტროფების შესახებ ტვიტების კლასიფიკაციის პრობლემაში. კვლევაში გამოყენებულია PEFT (Parameter-Efficient Fine-Tuning) ტექნიკის LoRA (Low-Rank Adaptation) მეთოდი, რომელიც მნიშვნელოვნად ამცირებს პარამეტრების რაოდენობას მოდელის წვრილად მორგებისას. განხილულია თითო

Hugging Face-ის სასწავლო პლატფორმის მასშტაბური განახლება: NLP კურსი ახლა LLM კურსია
Hugging Face აცხადებს hf.co/learn პლატფორმის მასშტაბურ განახლებას, რომლის ფარგლებშიც პოპულარული NLP კურსი LLM კურსად გარდაიქმნა. ეს ცვლილება ასახავს ხელოვნური ინტელექტის სფეროში მიმდინარე სწრაფ განვითარებას, ამატებს ახალ თავებს დიდი ენობრივი მოდელების დახვეწასა და მსჯელობის მოდელების შექმნაზე, აფართოებს საზოგადოებასთან თანამშრომლობას და გეგმავს სერტიფიცირების პროგრამას მომავალში.
Llama 2-ის ეფექტური განთავსება AWS Inferentia2-ზე Hugging Face Optimum Neuron-ის მეშვეობით
Hugging Face-ის ბლოგზე ადრე წარდგენილი AWS Inferentia2-ის გაფართოების შედეგად, ახლა შესაძლებელია დიდი ენობრივი მოდელების (LLM) განთავსება ტექსტის გენერაციისთვის AWS Inferentia2 ინსტანციებზე Optimum Neuron-ის გამოყენებით. სტატია დეტალურად აღწერს Llama 2-ის განთავსების პროცესს, გთავაზობთ რეკომენდაციებს Hugging Face Neuron Deep Learning AMI-ზე ან Amazon SageMaker-ზე განთავსების შესახებ და განმარტავს მოდელების კომპილაციასა და ექსპორტს. ასევე, მოცემულია Inferentia2-ზე ტექსტის გენერაციის ეფექტურობის ა

არაბული AI მოდელების შეფასების პლატფორმისა და AraGen ეტალონის მნიშვნელოვანი განახლებები
მიმდინარე ძალისხმევის ფარგლებში, წარმოდგენილია მნიშვნელოვანი განახლებები არაბული AI მოდელების შეფასების პლატფორმაზე. ამოქმედდა Arabic-Leaderboards, რომელიც არაბული ენის მოდელების შეფასებისთვის ერთიან სივრცეს წარმოადგენს. დეკემბერში დაინერგა AraGen ეტალონი დინამიური შეფასების მეთოდოლოგიით, სადაც მონაცემთა ნაკრები სამი თვის განმავლობაში კონფიდენციალური რჩება სამართლიანი შეფასებისთვის. გაფართოვდა AraGen მონაცემთა ნაკრები და დაიხვეწა შემფასებელი სისტემის მოთხოვნები. მიუხედავად იმისა, რომ ახალმა განა
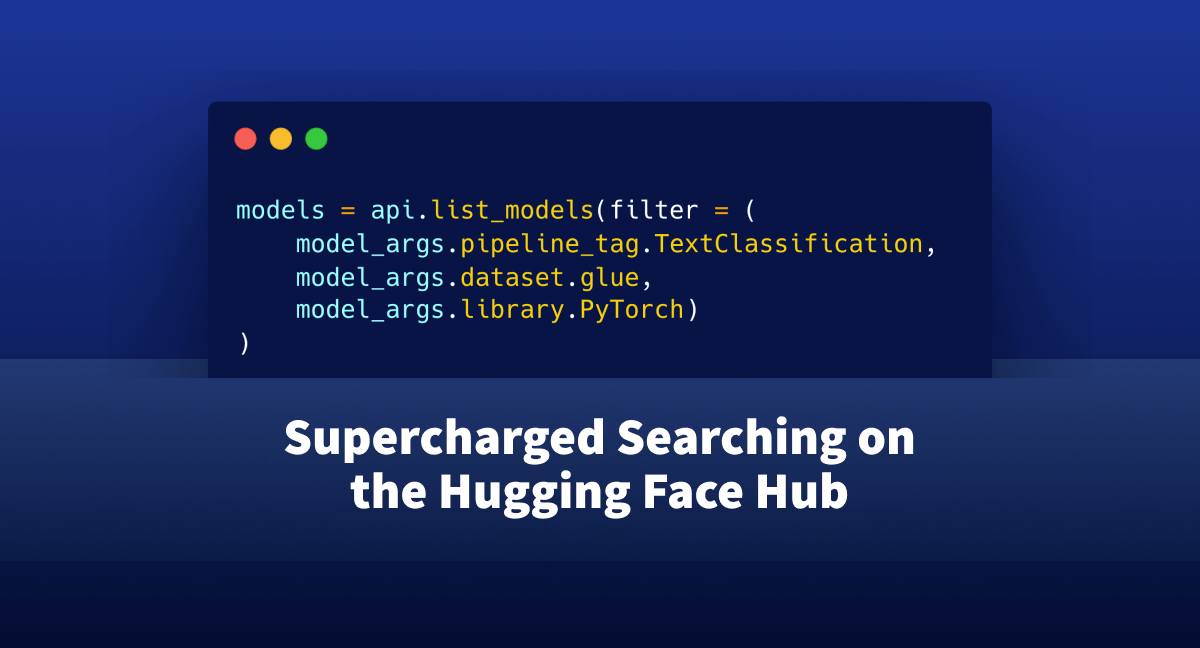
Hugging Face Hub-ის ძიების გამარტივება: პროგრამული ინტერფეისის ახალი შესაძლებლობები
სტატიაში წარმოდგენილია `huggingface_hub` ბიბლიოთეკის ახალი ფუნქციები, `ModelSearchArguments` და `ModelFilter`, რომლებიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე AI მოდელებისა და მონაცემთა ნაკრებების ძიებას პირდაპირ Python-ის ან Jupyter-ის გარემოდან. ეს სიახლე დეველოპერებს საშუალებას აძლევს, არ დატოვონ IDE და ეფექტურად მართონ რთული მოთხოვნები, რაც მნიშვნელოვნად აუმჯობესებს სამუშაო პროცესს.

LLM შეფასების კრიტიკული ხარვეზები DROP ბენჩმარკში: ნორმალიზაციისა და „გაჩერების ტოკენების“ პრობლემა
Open LLM Leaderboard-ზე DROP ბენჩმარკის დამატების შემდეგ, მოდელების f1-ქულებმა მოულოდნელად დაბალი შედეგები აჩვენა. გამოკვლევამ გამოავლინა ორი ძირითადი პრობლემა: არასწორი ნორმალიზაცია, რომელიც უგულებელყოფდა რიცხვით პასუხებს არასტანდარტული სიცარიელის სიმბოლოების გამო, და წერტილის (.) „გაჩერების ტოკენად“ გამოყენება. ამ ხარვეზების აღმოფხვრა, მათ შორის \n სიმბოლოზე დაყოფა, მნიშვნელოვნად აუმჯობესებს ქულების კორელაციას საერთო შესრულებასთან. თუმცა, სრული ხელახალი შეფასება ძვირი და შრომატევადია, რაც მიუთ

Cloudflare-ისა და FastRTC-ის პარტნიორობა: AI-ზე დაფუძნებული რეალურ დროში კომუნიკაციის გამარტივება
Cloudflare-ისა და Hugging Face-ის FastRTC-ის პარტნიორობა AI დეველოპერებს საშუალებას აძლევს, მინიმალური კოდით შექმნან დაბალლატენტური, ხელოვნურ ინტელექტზე დაფუძნებული აუდიო და ვიდეო ნაკადები. ეს ინტეგრაცია აბსტრაგირებს WebRTC-ის სირთულეებს და იყენებს Cloudflare-ის გლობალურ TURN ქსელს საიმედო კავშირების უზრუნველსაყოფად, რაც დეველოპერებს საშუალებას აძლევს ფოკუსირება მოახდინონ აპლიკაციის ძირითად ლოგიკაზე ინფრასტრუქტურის შენარჩუნების გარეშე. პარტნიორობა ასევე გთავაზობთ 10 GB უფასო მონაცემს ყოველთვიურა

Hugging Face და Protect AI მანქანური სწავლების მოდელების უსაფრთხოების გაძლიერების მიზნით თანამშრომლობენ
2024 წლის ოქტომბერში Hugging Face-მა და Protect AI-მ პარტნიორობა დაიწყეს მანქანური სწავლების (ML) მოდელების უსაფრთხოების გასაუმჯობესებლად. Protect AI-ის Guardian სკანირების ტექნოლოგია Hugging Face Hub-ის მომხმარებლებს კრიტიკულ უსაფრთხოების ინფორმაციას აწვდის. პარტნიორობის ფარგლებში, Protect AI-მ მნიშვნელოვნად გააფართოვა Guardian-ის აღმოჩენის შესაძლებლობები, მოიცვა მეტი ფაილის ფორმატი და გამოავლინა დახვეწილი ობსკურაციის ტექნიკები, მათ შორის მაღალი რისკის CVE-2025-1550 მოწყვლადობა Keras-ში. 2025 წ
შეზღუდული სხივური ძიება: კონტროლი ტექსტის გენერაციის პროცესზე
ეს სტატია განიხილავს ტექსტის გენერაციის გაუმჯობესებულ მეთოდს – შეზღუდულ სხივურ ძიებას (constrained beam search). ჩვეულებრივი სხივური ძიებისგან განსხვავებით, ეს მეთოდი საშუალებას გვაძლევს ზუსტი კონტროლი მოვახდინოთ გენერირებულ გამოსავალზე. ის წყვეტს იმ გამოწვევებს, როდესაც საჭიროა კონკრეტული სიტყვების ან ფრაზების ჩართვა, მრავალი შეზღუდვის დაწესება ან ალტერნატიული სიტყვის ფორმების გათვალისწინება (განმყოფი შეზღუდვები). ამ მიდგომით, ტექსტის გენერაცია ხდება უფრო კონტექსტზე მორგებული და მომხმარებლის მი
Hugging Face-ის ბიბლიოთეკა Decision Transformer-ს აერთიანებს: ახალი ეტაპი ღრმა გაძლიერებულ სწავლაში
Hugging Face-მა სიხარულით განაცხადა, რომ Decision Transformer, ოფლაინ გაძლიერებული სწავლის (Offline Reinforcement Learning) მეთოდი, ინტეგრირებულია მათ 🤗 ტრანსფორმერების ბიბლიოთეკაში და Hugging Face ჰაბში. ეს ნაბიჯი ღრმა გაძლიერებული სწავლის (Deep RL) სფეროში ხელმისაწვდომობის გაუმჯობესების გეგმის ნაწილია. სტატია განმარტავს RL-ის საფუძვლებს, განასხვავებს ონლაინ და ოფლაინ გაძლიერებულ სწავლებას და დეტალურად აღწერს Decision Transformer-ის მოდელს, რომელიც წარმოადგენს პარადიგმის ცვლილებას, რადგან ტრადი
Hugging Face-ი Decision Transformer-ს აინტეგრირებს: ახალი მიდგომა გაძლიერებით სწავლებაში
Hugging Face-მა Decision Transformer, ოფლაინ გაძლიერებითი სწავლის (Offline Reinforcement Learning) მეთოდი, თავის 🤗 transformers ბიბლიოთეკასა და Hugging Face Hub-ში ინტეგრირება მოახდინა. ეს ინტეგრაცია მნიშვნელოვან ნაბიჯს წარმოადგენს Deep Reinforcement Learning-ის (Deep RL) სფეროში ხელმისაწვდომობის გასაუმჯობესებლად. Decision Transformer წარმოადგენს პარადიგმის ცვლას, სადაც ტრადიციული RL მეთოდების ნაცვლად გამოიყენება მიმდევრობის მოდელირების ალგორითმი სასურველი შედეგის მისაღწევად მომავალი მოქმედებები

Llama Guard 4 და Prompt Guard 2: ხელოვნური ინტელექტის უსაფრთხოების ახალი მულტიმოდალური მოდელები
წარმოგიდგენთ Llama Guard 4-ს, მულტიმოდალურ მოდელს, რომელიც შექმნილია გამოსახულებებსა და ტექსტში სახიფათო კონტენტის აღმოსაჩენად, მათ შორის „jailbreak“-ის თავიდან ასაცილებლად. მასთან ერთად, Llama Prompt Guard 2 აძლიერებს დაცვას „prompt injection“-ებისა და სხვა მავნე შეტევებისგან, რაც უზრუნველყოფს ხელოვნური ინტელექტის უსაფრთხო და მოქნილ მოდერაციას. ეს მოდელები მნიშვნელოვნად აუმჯობესებენ AI სისტემების დაცვას საწარმოო გარემოში.
Vectara-ს HHEM ლიდერბორდი Hugging Face-ის შაბლონით LLM-ის „ჰალუცინაციის“ შესაფასებლად
კომპანია Vectara-მ წარმოადგინა ჰიუზის ჰალუცინაციის შეფასების მოდელი (HHEM), ღია კოდის ინსტრუმენტი, რომელიც ზომავს დიდი ენობრივი მოდელების (LLM) მიერ „ჰალუცინაციის“ (უაზრო ტექსტის გენერირება) ხარისხს. მოდელი აფასებს როგორც ღია კოდის, ასევე კომერციულ LLM-ებს, ხაზს უსვამს მათ შორის არსებულ განსხვავებებს. HHEM ლიდერბორდის მართვის საჭიროების გამო, Vectara-მ Hugging Face-ის ახალი ლიდერბორდის შაბლონები გამოიყენა და გამოუშვა HHEM ლიდერბორდი. ეს ინიციატივა მიზნად ისახავს LLM „ჰალუცინაციების“ შეფასების დე
მანქანური სწავლების მოდელების ნახშირბადის კვალის თვალყურის დევნება და შემცირება
ეს სტატია განიხილავს მანქანური სწავლების მოდელების ვარჯიშისა და განთავსების ეკოლოგიურ ზემოქმედებას, კერძოდ, მათ ნახშირბადის ემისიებს. წარმოდგენილია ისეთი ხელსაწყოები, როგორიცაა huggingface_hub ბიბლიოთეკა და codecarbon ინტეგრაცია, რომლებიც ხელს უწყობენ ამ ემისიების თვალყურის დევნას, ანგარიშგებას და მართვას, რითაც ხდება ეკო-მეგობრული AI-ის განვითარების ხელშეწყობა.
PatchTSMixer: IBM Research-ისა და Hugging Face-ის რევოლუციური მოდელი დროითი სერიების მოდელირებისთვის
IBM Research-მა Hugging Face-თან ერთად წარმოადგინა PatchTSMixer, ინოვაციური მოდელი, რომელიც Transformers ბიბლიოთეკაშია ინტეგრირებული. ეს მოდელი შექმნილია მრავალვარიანტული დროითი სერიების ეფექტური მოდელირებისთვის, მსუბუქი შერევის გამოყენებით პაჩებს, არხებსა და დამალულ მახასიათებლებს შორის. PatchTSMixer მნიშვნელოვნად აღემატება არსებულ MLP და Transformer მოდელებს პროგნოზირებაში, აჩვენებს 8-60%-იან გაუმჯობესებას და ამცირებს მეხსიერების მოხმარებასა და შესრულების დროს. იგი მხარს უჭერს ტრანსფერულ სწავლ

Hugging Face აძლიერებს ხელოვნური ინტელექტის მოდელების გაშვებას Whisper-ის დახმარებით: საზოგადოება და ეფექტურობა ცენტრში
Hugging Face-ი თავის Inference Endpoints-ს უფრო საზოგადოებაზე ორიენტირებულს ხდის, რაც ნებისმიერს აძლევს საშუალებას, წვლილი შეიტანოს ხელოვნური ინტელექტის მოდელების ეფექტურ განლაგებაში. განსაკუთრებული ყურადღება ექცევა Whisper მოდელებს, რომელთა გაშვებაც ოპტიმიზებულია vLLM-ის, CUDA-ს გრაფიკების და დინამიური კვანტიზაციის გამოყენებით, რის შედეგადაც Whisper Large V3-ისთვის შესრულების სიჩქარე (RTFx) თითქმის 8-ჯერ იზრდება. პლატფორმა უზრუნველყოფს მარტივ განლაგებას და რეალურ დროში ტრანსკრიფციის აპლიკაციები
DecodingTrust: LLM-ების სანდოობის შეფასების პლატფორმა და ახალი უსაფრთხოების ლიდერბორდი
2023 წელს Secure Learning Lab-მა წარმოადგინა DecodingTrust, პირველი ყოვლისმომცველი პლატფორმა დიდი ენობრივი მოდელების (LLM) სანდოობის შესაფასებლად. პლატფორმა მოიცავს რვა პერსპექტივას, მათ შორის ტოქსიკურობას, სტერეოტიპულ მიკერძოებას, კონფიდენციალურობასა და ეთიკას, და იყენებს ინოვაციურ „წითელი გუნდის“ (red-teaming) მეთოდოლოგიებს. ცოტა ხნის წინ, გამოქვეყნდა ახალი LLM უსაფრთხოების ლიდერბორდი, რომელიც LLM-ების უსაფრთხოების შეფასებაზეა ორიენტირებული.

დიდი ML მოდელების სწავლება: FullyShardedDataParallel (FSDP) შესაძლებლობები
მანქანური სწავლების (ML) მოდელების მუდმივად მზარდი მასშტაბები აპარატურულ შეზღუდვებს წარმოქმნის. ეს სტატია იკვლევს, თუ როგორ უმკლავდება განაწილებული სწავლება, კერძოდ PyTorch-ის FullyShardedDataParallel (FSDP) ფუნქცია, ამ გამოწვევას. ჩვენ ვადარებთ FSDP-ის წარმადობას DDP-სთან GPT-2 მოდელების გამოყენებით, ვაჩვენებთ FSDP-ის უნარს, მოახდინოს უფრო დიდი პაკეტის ზომების დამუშავება და კიდევ უფრო დიდი მოდელების სწავლება, რითაც ხელმისაწვდომს ხდის მძლავრ ML ტექნოლოგიებს.
დიდი ML მოდელების ეფექტური ვარჯიში: PyTorch FSDP-ის გამოყენება განაწილებულ სისტემებში
მანქანური სწავლების (ML) მოდელების მზარდი ზომისა და პარამეტრების გამო, სპეციალისტებს უჭირთ მათი ვარჯიში სტანდარტულ აპარატურაზე, მიუხედავად იმისა, რომ დიდი მოდელები უფრო სწრაფად სწავლობენ და მაღალ წარმადობას ავლენენ. ამ გამოწვევის საპასუხოდ, განაწილებული სწავლება ხდება გადამწყვეტი. ეს სტატია იკვლევს მონაცემთა პარალელიზმს ZeRO კონცეფციის გამოყენებით და კონკრეტულად PyTorch-ის უახლეს ფუნქციას, FullyShardedDataParallel (FSDP)-ს. DeepSpeed-ისა და FairScale-ის მიერ დანერგილი ZeRO-ის იდეები, PyTorch-ში

წარმოგიდგენთ nanoVLM-ს: მარტივი გზა ვიზუალური ენის მოდელების შესაქმნელად
nanoVLM არის ხელსაწყოების ნაკრები, რომელიც შთაგონებულია Andrej Karpathy-ის nanoGPT-ით, მაგრამ შექმნილია ვიზუალური სფეროსთვის. ის საშუალებას გაძლევთ შექმნათ და გაავარჯიშოთ მოდელები, რომლებსაც შეუძლიათ გამოსახულებებისა და ტექსტის გაგება, შემდეგ კი ამის საფუძველზე ტექსტის გენერირება. პროექტი გამოირჩევა სიმარტივითა და კოდის წაკითხვადობით, რაც მას იდეალურს ხდის დამწყებთათვის. nanoVLM ძირითადად ფოკუსირებულია ვიზუალურ კითხვა-პასუხზე (Visual Question Answering) და აგებულია Google-ის SigLIP-ისა და Llama

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M

Falcon-Arabic: ტექნოლოგიური ინსტიტუტის ახალი ენის მოდელი არაბული ხელოვნური ინტელექტის საზღვრებს ცვლის
არაბთა გაერთიანებული საამიროების ტექნოლოგიური ინოვაციების ინსტიტუტმა (TII) წარმოადგინა Falcon-Arabic, 7 მილიარდი პარამეტრის მრავალენოვანი ენის მოდელი, რომელიც ახალ სტანდარტებს ადგენს არაბული ბუნებრივი ენის დამუშავებისთვის (NLP). Falcon 3 არქიტექტურაზე აგებული, Falcon-Arabic მნიშვნელოვნად აღემატება არსებულ არაბულ LLM-ებს ეფექტურობითა და შესაძლებლობებით, რაც ხელს უწყობს არაბულენოვანი საზოგადოებების სრულ ინტეგრაციას ხელოვნური ინტელექტის რევოლუციაში და უზრუნველყოფს უფრო ბუნებრივ, ინტელექტუალურ და ინ