
Meta-მ Gaia2 წარმოადგინა: ახალი ბენჩმარკი AI აგენტებისთვის
კომპანია Meta-მ წარმოადგინა Gaia2, ახალი აგენტური ბენჩმარკი, რომელიც GAIA-ს გაგრძელებაა და მიზნად ისახავს ხელოვნური ინტელექტის აგენტების მნიშვნელოვნად უფრო რთული ქცევების ანალიზს. Gaia2 გამოვიდა Meta-ს ღია Agents Research Environments (ARE) ფრეიმვორქთან ერთად, რაც საშუალებას იძლევა აგენტების გაშვებას, გამართვას და შეფასებას რეალური სამყაროს მსგავს პირობებში. ბენჩმარკი აფასებს აგენტებს ინტერაქციულ ქცევაში, ბუნდოვანი ან დროში შეზღუდული მოთხოვნების შესრულებაში, ხმაურიან გარემოში ადაპტირებასა და ხელ
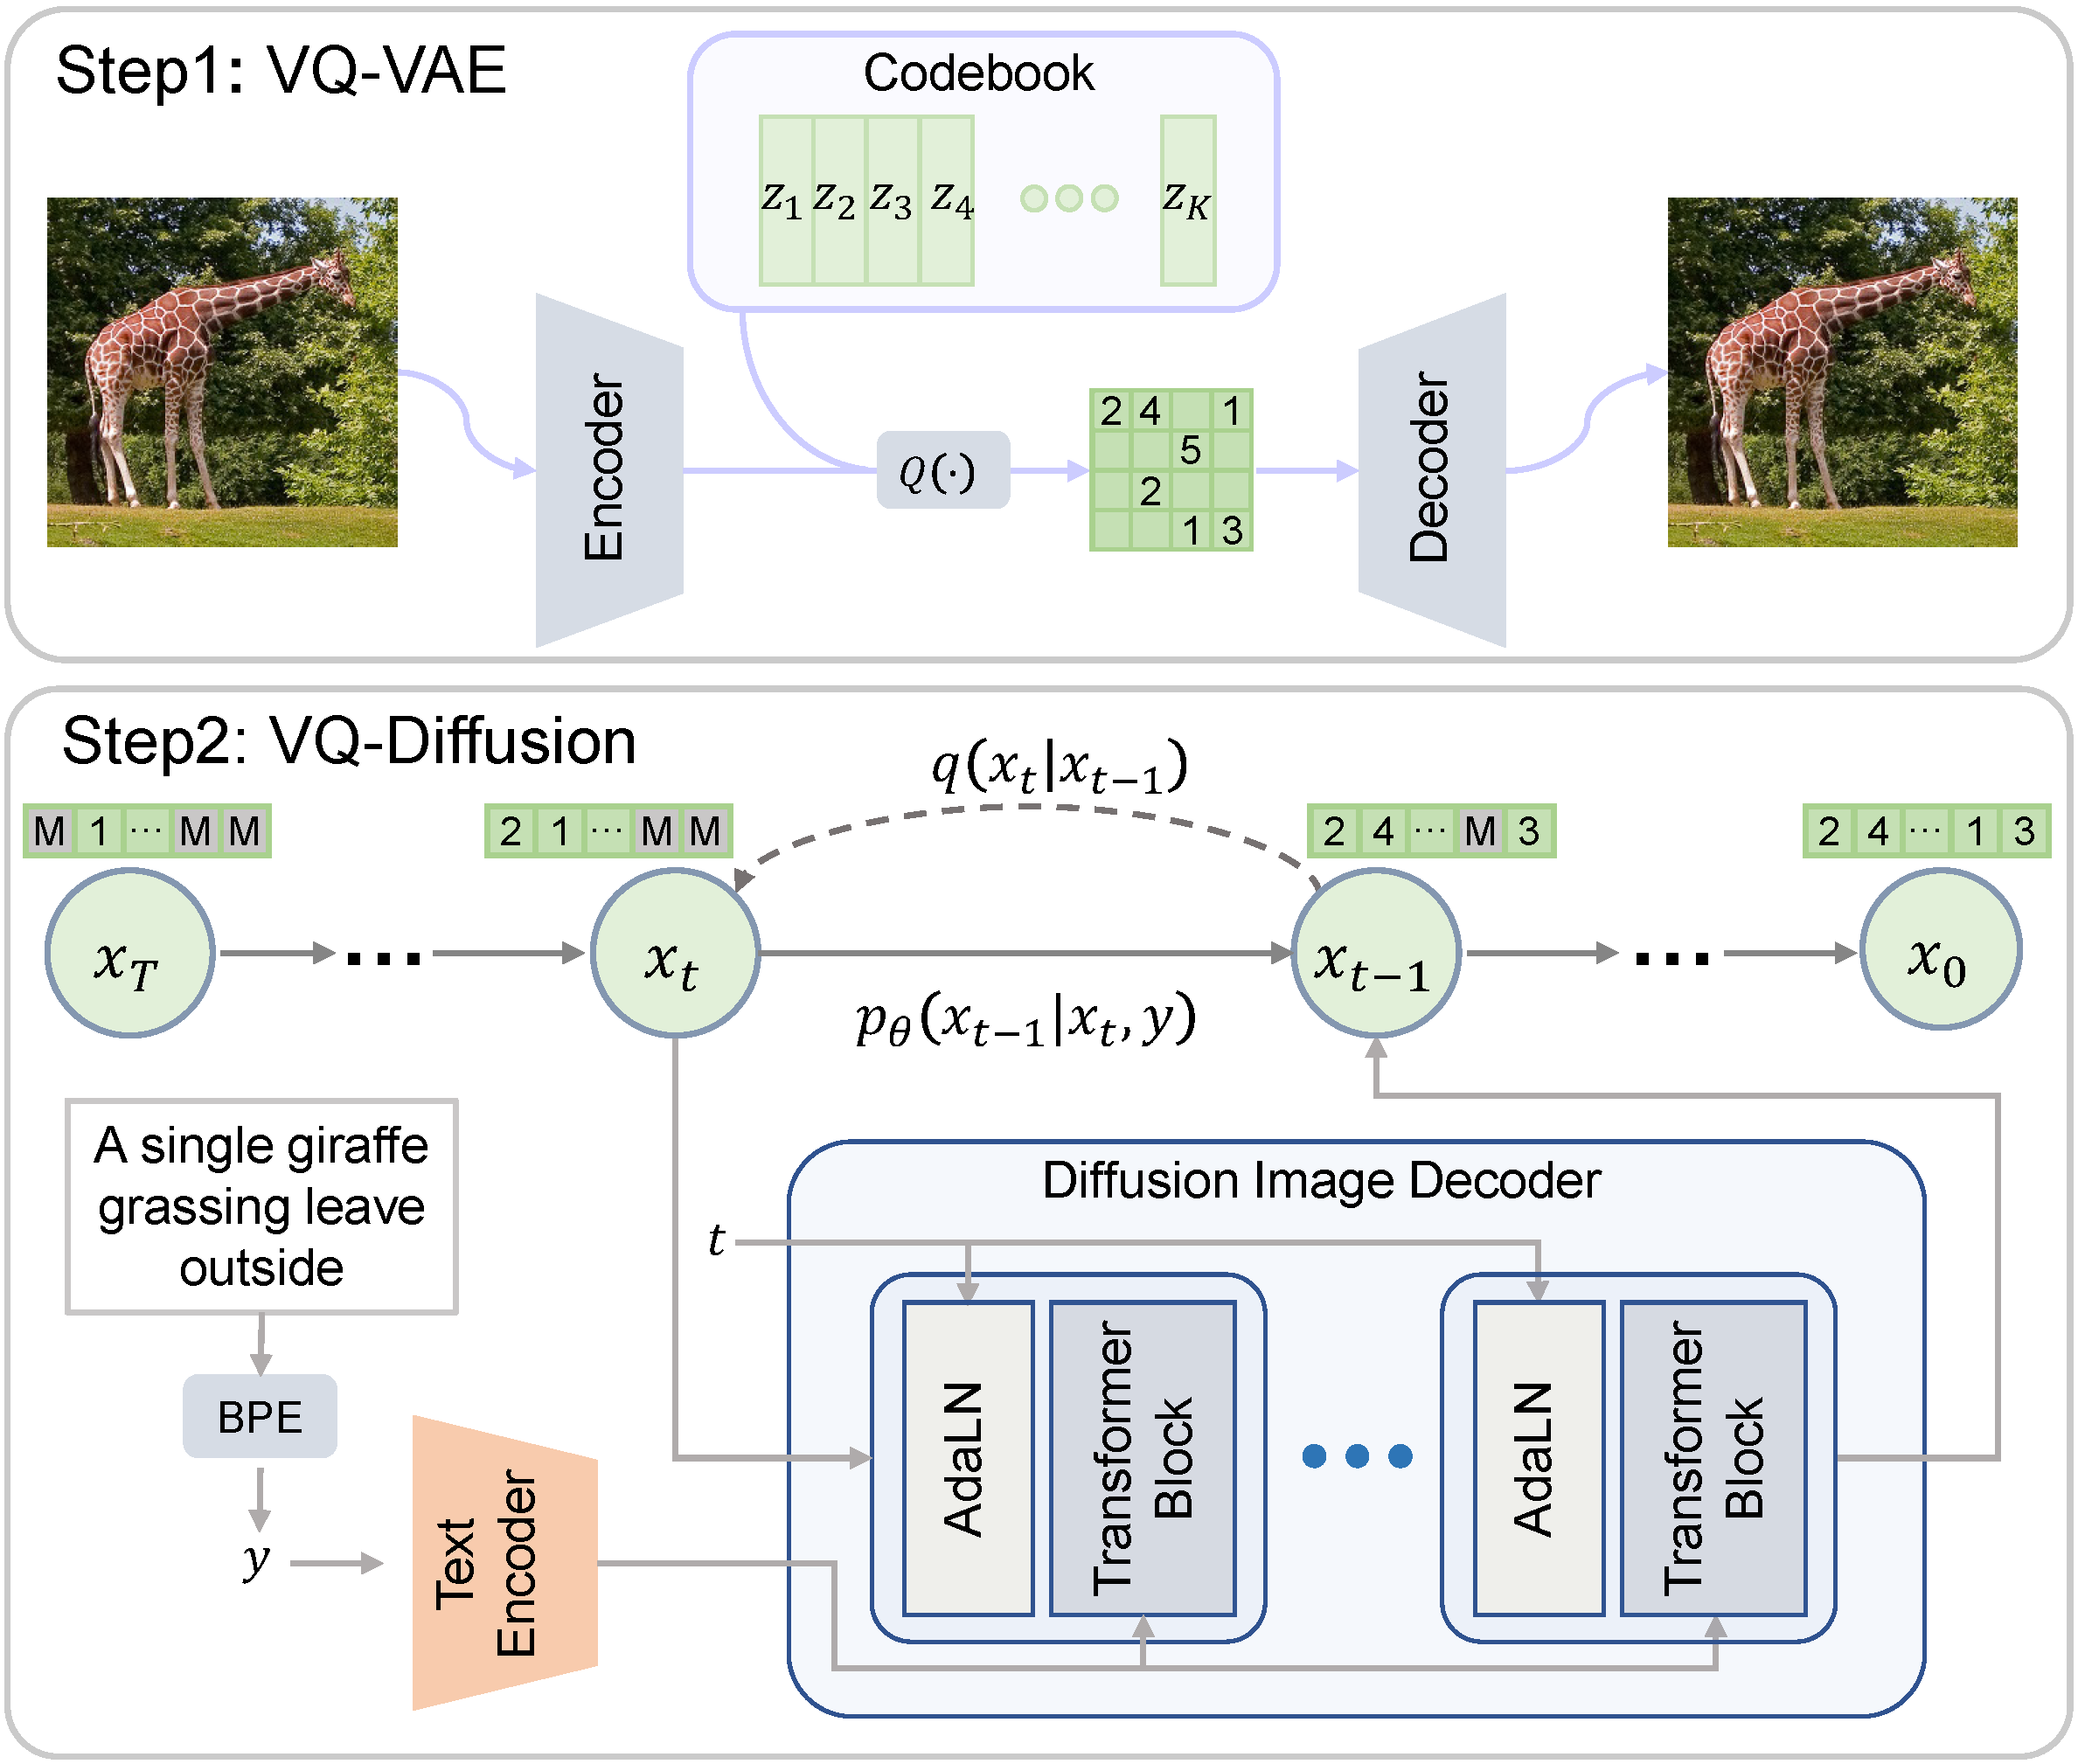
VQ-Diffusion: ახალი სიტყვა სურათების გენერაციაში Diffusers-ის დახმარებით
წარმოგიდგენთ VQ-Diffusion-ს, დისკრეტულ დიფუზიურ მოდელს, რომელიც სურათების გენერაციას სულ რამდენიმე ხაზი კოდით შესაძლებელს ხდის Diffusers ბიბლიოთეკის გამოყენებით. მოდელი ეფუძნება VQ-VAE ენკოდერს გამოსახულებების ლატენტურ ტოკენებად გარდასაქმნელად და იყენებს ენკოდერ-დეკოდერ ტრანსფორმერს. VQ-Diffusion მნიშვნელოვნად აუმჯობესებს AR მოდელების ნაკლოვანებებს, როგორიცაა ინფერენციის სიჩქარე და შეცდომების დაგროვება, რაც მას ეფექტურ და მძლავრ ინსტრუმენტად აქცევს ხელოვნური ინტელექტის საფუძველზე გამოსახულების შ

მანქანური სწავლება Elixir-ში: ახალი შესაძლებლობები Bumblebee-სთან ერთად
Elixir-ის ეკოსისტემაში მანქანური სწავლების მხარდაჭერა მნიშვნელოვნად გაუმჯობესდა ისეთი პროექტების წყალობით, როგორებიცაა Nx, Axon, Explorer და, განსაკუთრებით, Bumblebee. Livebook პლატფორმაში ინტეგრირებული „Smart cells“-ის მეშვეობით, დეველოპერებს შეუძლიათ ნერვული ქსელების ამოცანების სწრაფად ინტეგრირება. Erlang ვირტუალური მანქანის კონკურენტულობისა და დისტრიბუციის წყალობით, ეს მოდელები ადვილად ინტეგრირდება არსებულ Elixir აპლიკაციებში, როგორიცაა Phoenix, Broadway და Nerves, და კომპილირდება როგორც CPU-

BigCodeArena: კოდის გენერაციის ხელოვნური ინტელექტის მოდელების შეფასების ახალი სტანდარტი რეალური გაშვებით
BigCodeArena არის ინოვაციური პლატფორმა, რომელიც საშუალებას აძლევს მომხმარებლებს, შეადარონ ხელოვნური ინტელექტის კოდის გენერაციის მოდელები არა მხოლოდ კოდის წაკითხვით, არამედ მისი რეალური გაშვებით და შედეგების დანახვით. ის აგვარებს ტრადიციული შეფასების მეთოდების პრობლემებს, გვთავაზობს სანდბოქს გარემოებს კოდის ავტომატური გაშვებისთვის, მრავალსვლიან ინტერაქციებს და მომხმარებლის შეფასებებზე დაფუძნებულ ლიდერბორდს. პლატფორმა უკვე ლიდერბორდში აერთიანებს მოწინავე LLM-ების რეიტინგებს, აჩვენებს რა გამოკვეთილ
XLSCOUT-ი Hugging Face-თან პარტნიორობით პატენტების ანალიზში რევოლუციას ახდენს ParaEmbed 2.0-ით
ინტელექტუალურ საკუთრებაში ხელოვნური ინტელექტის (AI) გამოყენების ლიდერმა, XLSCOUT-მა, Hugging Face-თან თანამშრომლობით შეიმუშავა ParaEmbed 2.0 – მძლავრი საკუთრების მოდელი, რომელიც 23%-ით აუმჯობესებს სიზუსტეს პატენტების რთული დოკუმენტების ანალიზში. ეს პარტნიორობა, ღია კოდის AI მოდელებისა და XLSCOUT-ის სპეციალიზებული მონაცემების გაერთიანებით, უზრუნველყოფს მოწინავე გადაწყვეტილებებს პატენტების შედგენის, სიახლის ძიებისა და ბათილობის კვლევებისთვის, რითაც სარგებელს მიიღებენ კორპორაციები, უნივერსიტეტები დ

Arm PyTorch კონფერენციაზე: დეველოპერების გაძლიერება AI გადაწყვეტილებების შექმნაში
Arm-ი 22-23 ოქტომბერს PyTorch კონფერენციაზე დეველოპერებს სთავაზობს უნიკალურ შესაძლებლობებს ხელოვნური ინტელექტის (AI) აპლიკაციების შექმნისა და განთავსებისთვის PyTorch-ისა და ExecuTorch-ის გამოყენებით. კონფერენციაზე წარმოდგენილი იქნება უახლესი AI ტექნოლოგიები, ჩატარდება ინდივიდუალური ვორქშოფები პასუხისმგებლიანი AI განვითარების შესახებ და „დეველოპერის ხმის“ სესიები, სადაც დეველოპერები გაუზიარებენ საკუთარ გამოცდილებას. მონაწილეებს შესაძლებლობა ექნებათ გააფართოონ პროფესიული ქსელი, მიიღონ პრაქტიკული რ

Hugging Face მონაცემთა ნაკრებების ძებნის ოთხ ახალ ფუნქციას წარმოგიდგენთ
Hugging Face განაგრძობს Dataset Hub-ის გაუმჯობესებას და Dataset Search-ისთვის ოთხ ახალ ფუნქციას აცხადებს. ეს სიახლეები მოიცავს მონაცემთა მოდალობის (ტიპის) მიხედვით ფილტრაციას, სტრიქონების რაოდენობის მიხედვით ძებნას, მონაცემთა ფორმატების ფილტრაციას და ბიბლიოთეკებთან თავსებადობის მიხედვით ძებნას, რაც მომხმარებლებს საშუალებას მისცემს, უფრო ეფექტურად იპოვონ სასურველი ღია მონაცემთა ნაკრებები.
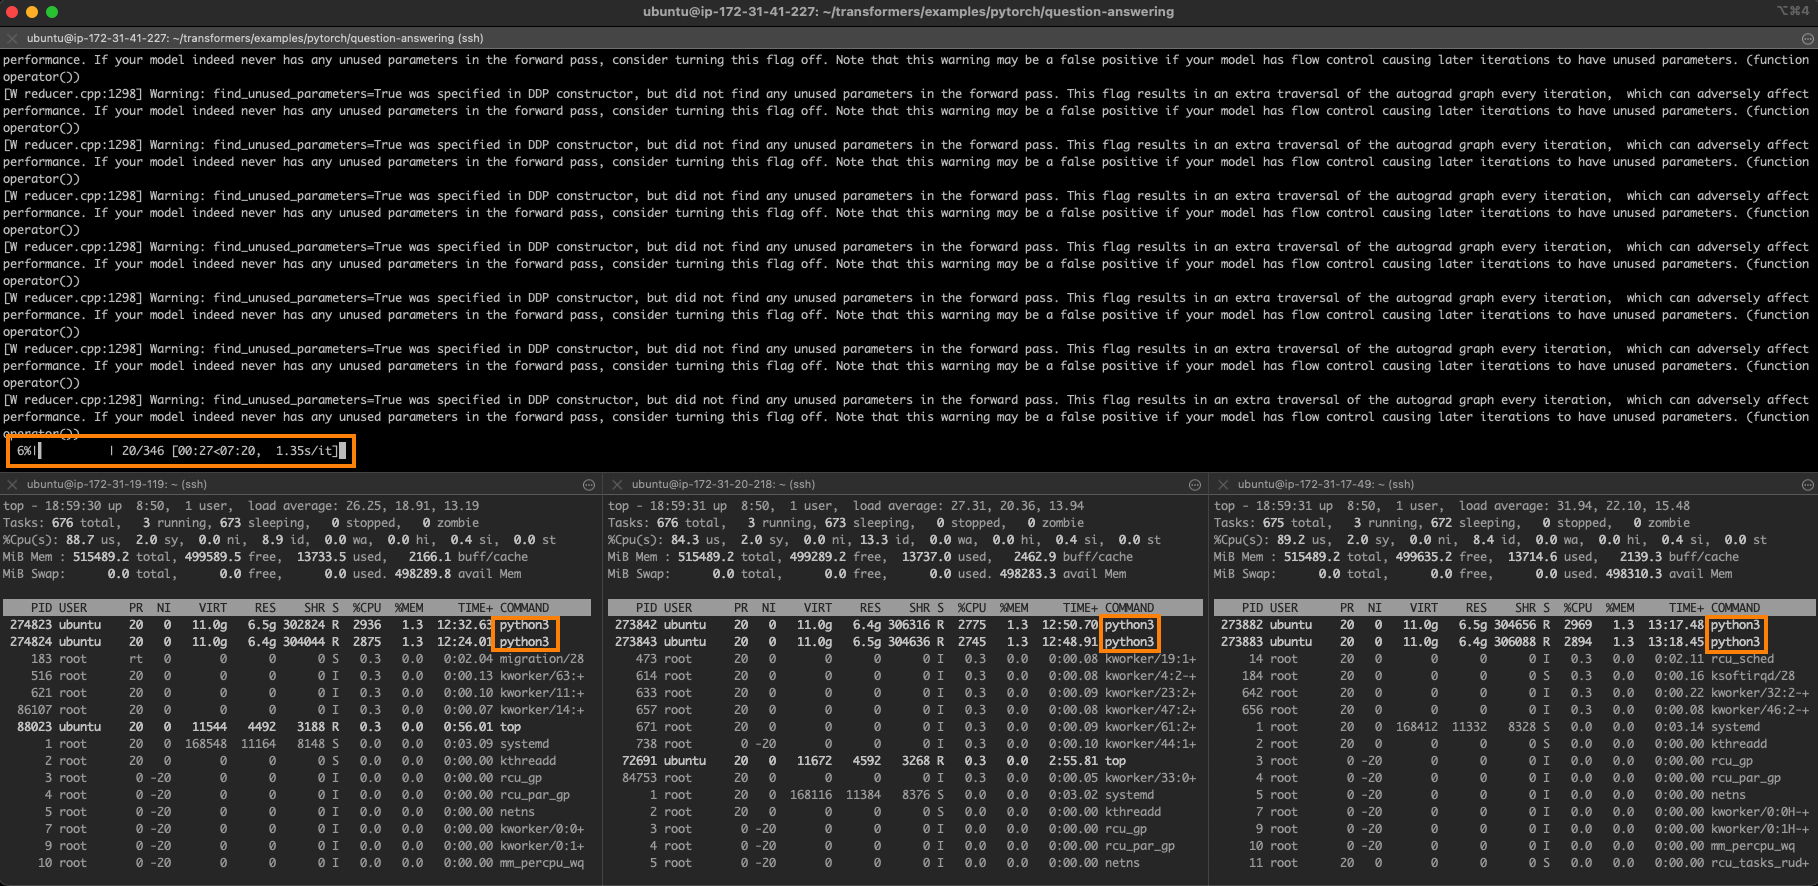
PyTorch-ის სწავლების დაჩქარება AWS-ზე Intel Sapphire Rapids პროცესორებით
ეს პუბლიკაცია განიხილავს, თუ როგორ შეიძლება PyTorch-ის ღრმა სწავლების სამუშაოების მნიშვნელოვნად დაჩქარება AWS-ზე განთავსებული Intel Sapphire Rapids სერვერების კლასტერის მეშვეობით. სტატია დეტალურად აღწერს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას გადანაწილებული სწავლებისთვის, რომლებიც სრულად ინტეგრირებულია Hugging Face transformers-თან. ხაზგასმულია Intel Xeon CPU-ების უპირატესობები ღრმა სწავლებისას, მათ შორის ხარჯთეფექტურო
PyTorch-ის ტრენინგის დაჩქარება AWS-ზე Sapphire Rapids სერვერებით
ეს პოსტი აღწერს, თუ როგორ უნდა დააჩქაროთ PyTorch-ის ტრენინგის სამუშაოები AWS-ზე Sapphire Rapids სერვერების კლასტერის გამოყენებით. სტატია დეტალურად განიხილავს Intel oneAPI Collective Communications Library (CCL) და Intel Extension for PyTorch (IPEX) ბიბლიოთეკების გამოყენებას განაწილებული ტრენინგისთვის და ახალი CPU ინსტრუქციების ოპტიმიზაციისთვის. ასევე ხაზგასმულია Intel Xeon CPU-ების ღირებულებითი ეფექტურობა, მასშტაბურობა და მოწინავე ფუნქციები (AVX-512, Hyper-Threading, AMX) ღრმა სწავლის მოდელების

მეხსიერების გლობალური კრიზისი: ხელოვნური ინტელექტის გავლენა RAM-ისა და SSD-ის ფასებზე
2025 წლის დეკემბერში დაიწყო გლობალური ფასების კრიზისი RAM-ისა და SSD-ის ბაზარზე, რამაც გამოიწვია მეხსიერების ფასების 500%-მდე ზრდა და SSD-ის ფასების გაორმაგება. მიზეზი ხელოვნური ინტელექტის (AI) გიგანტების, განსაკუთრებით OpenAI-სა და Nvidia-ს მიერ, მეხსიერების ჩიპების მასშტაბური შესყიდვებია. OpenAI-ის „Stargate“ პროექტი თვეში 900 000 DRAM ვაფლს მოითხოვს, რაც მსოფლიო წარმოების 40%-ს შეადგენს. ეს იწვევს გლობალურ დეფიციტს, ფასების ზრდას სამომხმარებლო ელექტრონიკაზე და შესაძლოა, ტექ-კომპანიების სტრატე

Nvidia-ს ბრალი ედება ხელოვნური ინტელექტის მოდელების გასაწვრთნელად პირატული წიგნების გამოყენებაში
განახლებული სარჩელის მიხედვით, Nvidia-ს ბრალი ედება მილიონობით პირატული წიგნის შეგნებულად გამოყენებაში თავისი ხელოვნური ინტელექტის მოდელების გასაწვრთნელად, მას შემდეგ, რაც კომპანია დაუკავშირდა საკამათო „ჩრდილოვან ბიბლიოთეკას“ Anna’s Archive. ავტორები საავტორო უფლებების დარღვევისთვის კომპენსაციას ითხოვენ. ეს ფაქტი კითხვებს აჩენს ტექნოლოგიური კომპანიების ეთიკისა და მონაცემების მიმართ სასოწარკვეთილების შესახებ, მიუხედავად იმისა, რომ მათ გაფრთხილება ჰქონდათ მიღებული შინაარსის უკანონობის შესახებ.

მოკლედ: Squarespace/Shopify ვებსაიტებიდან მონაცემების მოპოვება AI-სთვის
ეს ვებ-სკრეპერი სრულად მუშაობს თქვენს ბრაუზერში და იდეალურია ხელოვნური ინტელექტის მოდელებისთვის საწვრთნელი მონაცემების შესაქმნელად. ის ვებსაიტის sitemap.xml ფაილის წაკითხვით ფუნქციონირებს, რაც მას განსაკუთრებით კარგად ერგება თანამედროვე პლატფორმებს, როგორიცაა Squarespace და Shopify, რომლებიც ავტომატურად ქმნიან საიტის რუკებს. სკრეპერი ინარჩუნებს კონტენტის სტრუქტურას, სათაურების, აბზაცების, სიების და ცხრილების ჩათვლით, და ამავდროულად აცილებს ზედმეტ ელემენტებს, როგორიცაა ნავიგაციის მენიუები და ქვედ
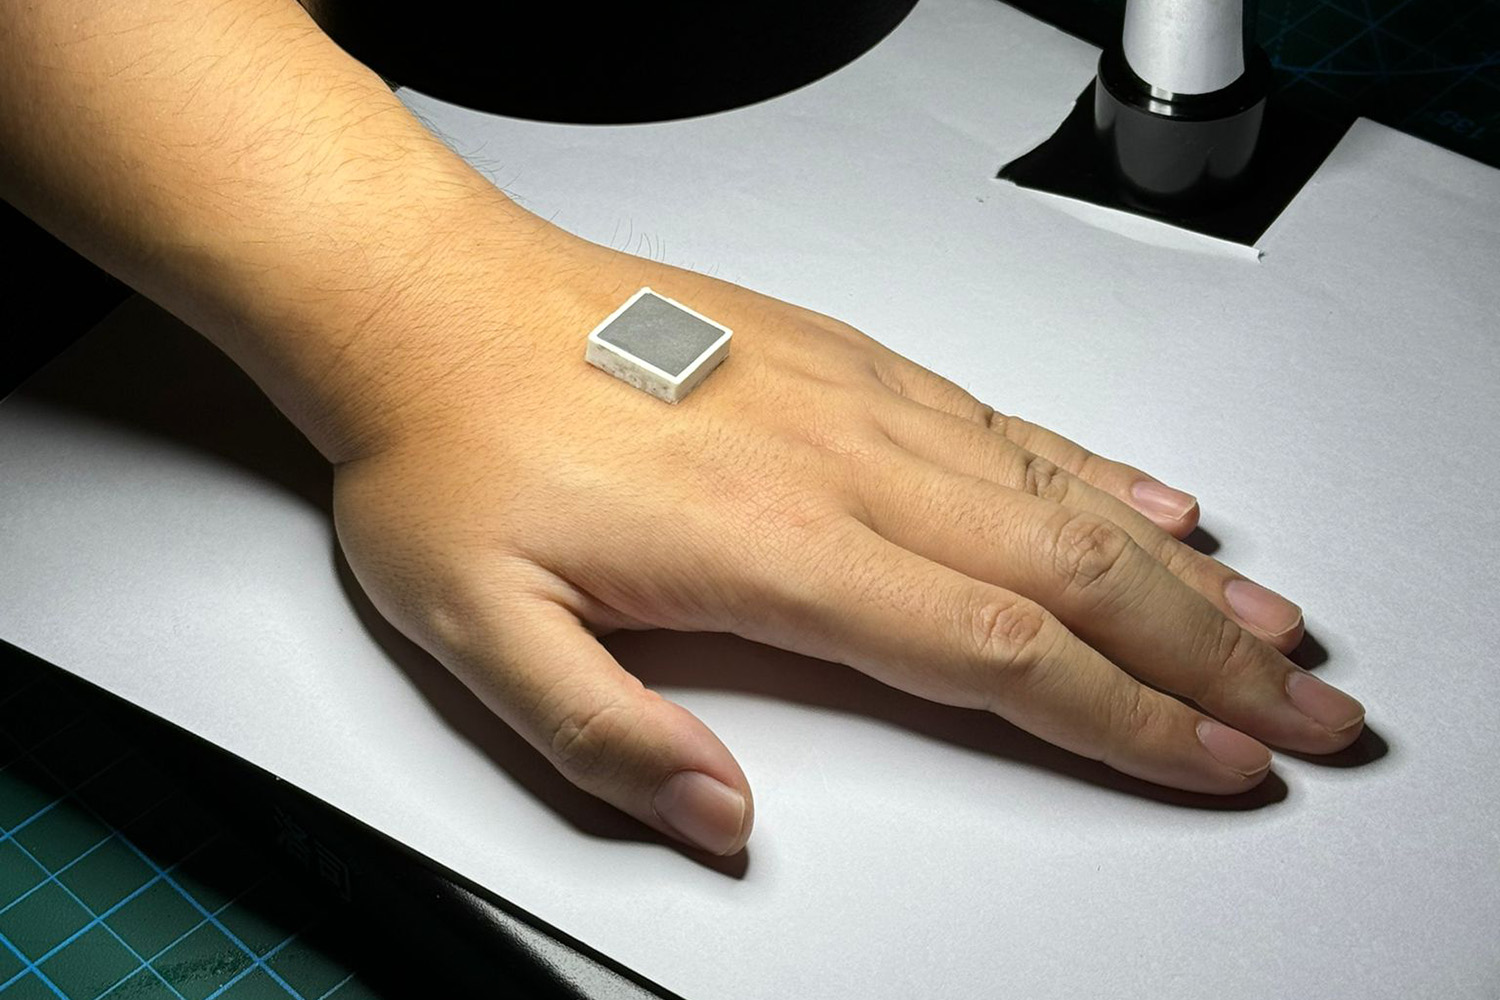
ახალი ეპოქა ქრონიკული დაავადებების მონიტორინგში: ტარებადი ულტრაბგერითი სისტემა SMART-ისგან
სინგაპურ-მასაჩუსეტსის ტექნოლოგიური ინსტიტუტის კვლევისა და ტექნოლოგიების ალიანსმა (SMART) დაიწყო ინოვაციური პროექტი „ტარებადი გამოსახულება ხანდაზმულთა მოვლის ტრანსფორმაციისთვის“ (WITEC). პროექტის მიზანია მსოფლიოში პირველი ტარებადი ულტრაბგერითი გამოსახულების სისტემის შექმნა, რომელიც ქრონიკული დაავადებების, როგორიცაა ჰიპერტენზია და გულის უკმარისობა, 48-საათიან უწყვეტ მონიტორინგს უზრუნველყოფს სახლში ან მოძრაობისას. ეს ტექნოლოგია ცვლის რეაქტიულ, საავადმყოფოზე დაფუძნებულ მოვლას პრევენციულ, სახლის პირო
პორტატული ულტრაბგერითი სისტემა WITEC: რევოლუცია ქრონიკული დაავადებების მონიტორინგში
სინგაპურ-მასაჩუსეტსის ტექნოლოგიური ინსტიტუტის (SMART) ალიანსმა წამოიწყო ახალი კვლევითი პროექტი „პორტატული გამოსახულება ხანდაზმულთა მოვლის ტრანსფორმაციისთვის“ (WITEC). პროექტი მიზნად ისახავს მსოფლიოში პირველი პორტატული ულტრაბგერითი გამოსახულების სისტემის შექმნას, რომელიც 48 საათის განმავლობაში შეძლებს ქრონიკული დაავადებების, როგორიცაა ჰიპერტენზია და გულის უკმარისობა, უწყვეტ მონიტორინგს რეალურ დროში. ეს ინოვაცია საავადმყოფოებზე დაფუძნებული, რეაქტიული მკურნალობიდან პრევენციულ, სახლის პირობებში მოვლ
MIT-ის EnCompass: ჩარჩო, რომელიც AI აგენტებს LLM-ის შეცდომების გამოსწორებაში ეხმარება
ხელოვნური ინტელექტის (AI) ინსტრუმენტები, განსაკუთრებით AI აგენტები, სულ უფრო მოთხოვნადი ასისტენტები ხდებიან. ისინი ხშირად იყენებენ დიდ ენობრივ მოდელებს (LLM), რომლებიც, მიუხედავად მათი სიმძლავრისა, შეცდომებსაც უშვებენ. ასეთი შეცდომების გამოსწორების ლოგიკის (უკან დაბრუნება, ხელახალი მცდელობა) დაპროგრამება შრომატევადია. MIT-ის კომპიუტერული მეცნიერებისა და ხელოვნური ინტელექტის ლაბორატორიის (CSAIL) და Asari AI-ის მკვლევარებმა შექმნეს ჩარჩო „EnCompass“, რომელიც ავტომატურად უმკლავდება LLM-ის შეცდომებს
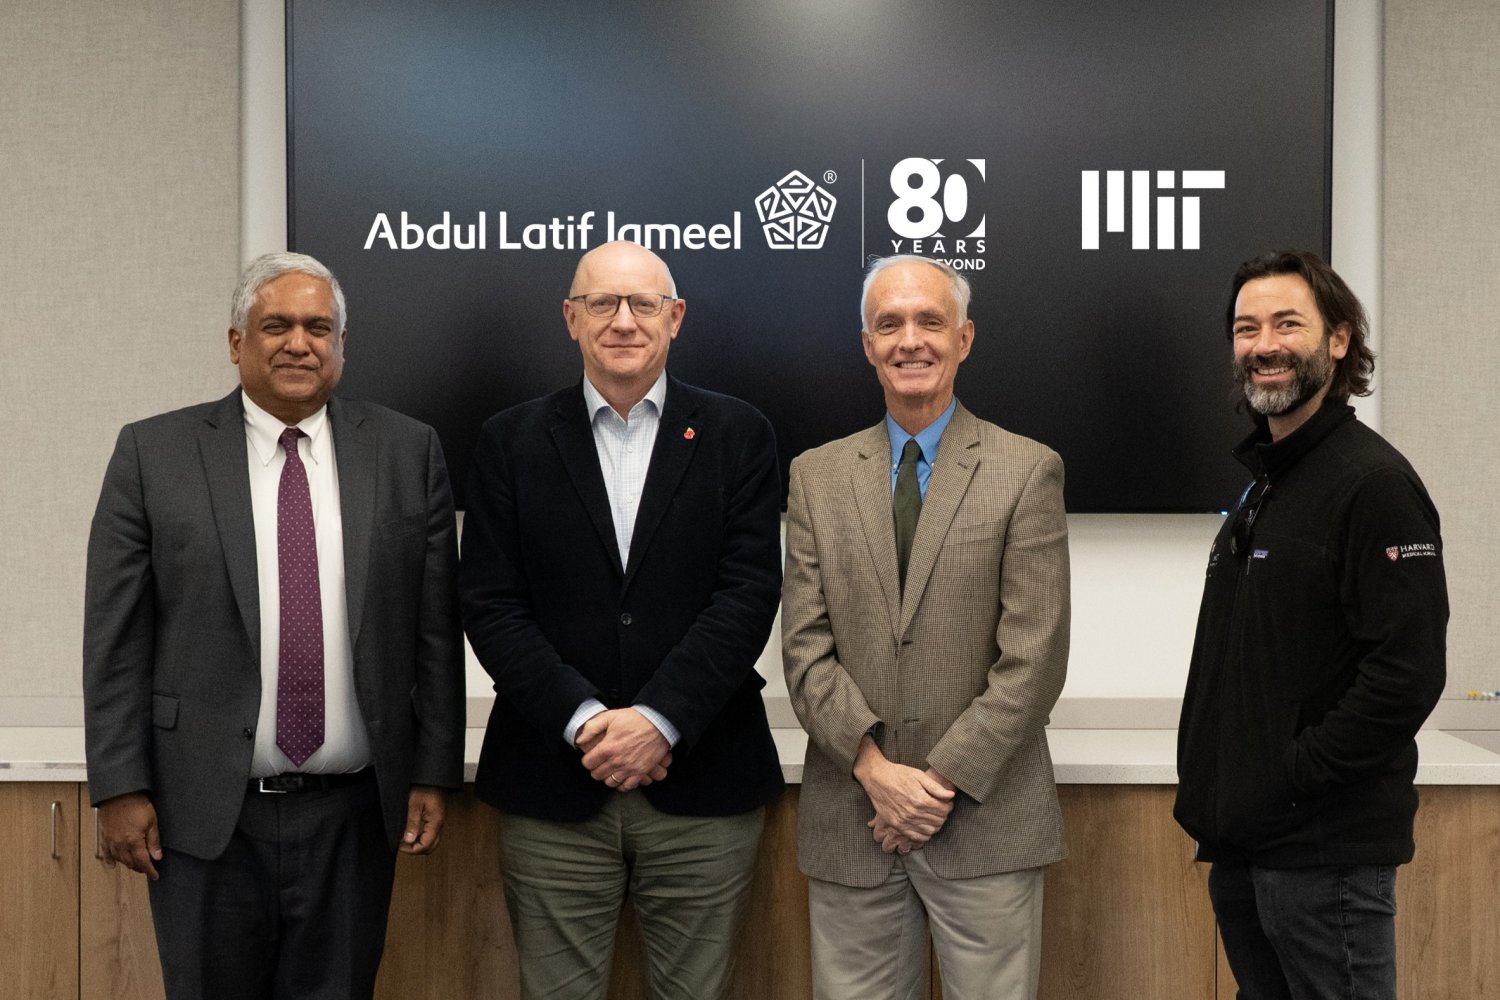
MIT-ის მკვლევარი AMR-ის წინააღმდეგ სინთეზურ ბიოლოგიასა და ხელოვნურ ინტელექტს იყენებს
MIT-ის პროფესორი ჯეიმს ჯ. კოლინზი მრავალდისციპლინურ კვლევით პროექტს უძღვება, რომელიც ანტიმიკრობული რეზისტენტობის (AMR) მზარდი გლობალური საფრთხის წინააღმდეგ სინთეზურ ბიოლოგიასა და გენერაციულ ხელოვნურ ინტელექტს იყენებს. Jameel Research-ის მიერ დაფინანსებული 3-წლიანი, 3 მილიონი დოლარის ღირებულების პროექტი მიზნად ისახავს პროგრამირებადი ანტიბაქტერიულების შემუშავებას ძირითადი პათოგენების წინააღმდეგ. კვლევა ფოკუსირებულია ხელოვნური ინტელექტის გამოყენებით მცირე ცილების შექმნაზე, რომლებიც მიზანმიმართულად

AI-ის ხილვადობის დილემა: ბიზნესები AI მოდელებს ბლოკავენ, ასისტენტებს კი უშვებენ – რას ნიშნავს ეს?
Hostinger-ის ახალი ანალიზი ცხადყოფს პარადოქსს: კომპანიები ბლოკავენ AI მოდელების სავარჯიშო ბოტებს, თუმცა AI ასისტენტების ქსელურ მცოცავებს თავისუფლად აძლევენ საიტებზე წვდომას. გაიგეთ, რატომ არის ეს გადაწყვეტილება საზიანო ბიზნესის AI ხილვადობისთვის და რა არის პარამეტრული ცოდნის (Parametric Knowledge) მნიშვნელობა.

Google-ის რევოლუციური ნაბიჯი: Gemini 3 AI მიმოხილვების სტანდარტული მოდელი ხდება და ძიებას ახალ დონეზე გადაჰყავს
Google-მა თავისი ყველაზე მოწინავე Large Language Model [LLM], Gemini 3, AI Overview-ებისთვის სტანდარტულ მოდელად აქცია, რაც მნიშვნელოვნად აუმჯობესებს საძიებო შედეგების სიზუსტესა და სიღრმეს. ეს განახლება მომხმარებლებს საშუალებას აძლევს, შეუფერხებლად გააგრძელონ საუბარი ხელოვნურ ინტელექტთან, რაც საძიებო გამოცდილებას კიდევ უფრო ინტუიტიურსა და ეფექტურს ხდის.

SparkToro-ს კვლევა AI რეკომენდაციების არასტაბილურობას ამხელს
SparkToro-ს უახლესმა კვლევამ აჩვენა, რომ ხელოვნური ინტელექტის [AI] ინსტრუმენტები თითქმის არასდროს აბრუნებენ ერთსა და იმავე ბრენდის რეკომენდაციებს, თუნდაც ერთი და იმავე მოთხოვნის [prompt] განმეორებისას. ეს მიგნებები ეჭვქვეშ აყენებს „AI რეიტინგის პოზიციის“ [AI ranking position] მეტრული ერთეულის სანდოობას და ხაზს უსვამს AI-ის პასუხების ფუნდამენტურ არათანმიმდევრულობას.
SparkToro-ს შოკისმომგვრელი კვლევა: რამდენად სანდოა AI-ის რეკომენდაციები?
SparkToro-ს ახალი კვლევა ხელოვნური ინტელექტის [AI] რეკომენდაციების გაუგონარ არათანმიმდევრულობას ავლენს, რაც სერიოზულ კითხვებს აჩენს AI-ზე დაფუძნებული საძიებო სისტემებისა და მარკეტინგული სტრატეგიების სანდოობასთან დაკავშირებით. ეს ანგარიში იწვევს დისკუსიას AI რანჟირების პოზიციების ღირებულებასა და ტრეკინგის ხელსაწყოების მეთოდოლოგიის გამჭვირვალობის აუცილებლობაზე.

Google-ის გაფრთხილება: მარკდაუნი [Markdown] AI ქროლერებისთვის – კარგი იდეაა თუ „სულელური“?
Google Search Advocate ჯონ მიულერი [John Mueller] მკაცრად ეწინააღმდეგება იდეას, რომ ხელოვნური ინტელექტის (AI) დიდი ენობრივი მოდელების ქროლერებს [LLM crawlers] Markdown ფაილები მიეწოდოთ HTML-ის ნაცვლად. მიულერის აზრით, ეს მიდგომა, რომელიც ტოკენების მოხმარების შემცირებას ისახავს მიზნად, სერიოზულ ტექნიკურ და სტრუქტურულ პრობლემებს შექმნის საძიებო სისტემებისთვის.

Threads-ი AI-ს დახმარებით ფიდის პერსონალიზაციის ახალ ერას იწყებს: „ძვირფასო ალგო“ კონკურენტებს უკან ტოვებს
Threads-მა, Meta-ს საკუთრებაში არსებულმა სოციალურმა ქსელმა, წარმოადგინა AI-ზე დაფუძნებული ფუნქცია „ძვირფასო ალგო“ (Dear Algo), რომელიც მომხმარებლებს საშუალებას აძლევს, დროებით მოახდინონ თავიანთი ფიდის პერსონალიზაცია. ეს ინოვაცია Threads-ს მნიშვნელოვან უპირატესობას ანიჭებს კონკურენტებთან, როგორიცაა X და Bluesky, და მიზნად ისახავს რეალურ დროში უფრო მეტი ჩართულობის შექმნას.
Uber Eats ხელოვნური ინტელექტით საყიდლების პროცესს ამარტივებს: წარმოგიდგენთ „Cart Assistant“-ს
Uber Eats-მა წარმოადგინა „Cart Assistant“, ხელოვნური ინტელექტის (AI) ახალი ფუნქცია, რომელიც მომხმარებლებს სასურსათო პროდუქტების კალათის უფრო სწრაფად და მარტივად შევსებაში ეხმარება. ეს ინოვაცია მნიშვნელოვნად ამარტივებს ონლაინ საყიდლებს, ხდის მათ უფრო პერსონალიზებულს და ზრდის კომპანიის კონკურენტუნარიანობას ბაზარზე.

ილონ მასკის xAI-ის ფარული გეგმები გასაჯაროვდა: Grok, Macrohard და კოსმოსური ამბიციები
ილონ მასკის ხელოვნური ინტელექტის სტარტაპმა, xAI-მ, საჯარო შეხვედრის სრული ვიდეო გამოაქვეყნა, სადაც კომპანიის რესტრუქტურიზაცია, პროდუქტების სამომავლო გეგმები და კოსმოსური მონაცემთა ცენტრების ამბიციური ხედვა გახდა ცნობილი. გაეცანით დეტალებს, თუ როგორ გეგმავს xAI ხელოვნური ინტელექტის სამყაროს შეცვლას, მიუხედავად შიდა გამოწვევებისა და საკამათო საკითხებისა.