
TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო
Cloudflare Workers AI და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი გენერაციული AI დეველოპერებისთვის
Cloudflare Workers AI-ზე განთავსება დეველოპერებს საშუალებას აძლევს შექმნან მძლავრი გენერაციული AI აპლიკაციები GPU ინფრასტრუქტურისა და სერვერების მართვის გარეშე, ძალიან დაბალი საოპერაციო ხარჯებით. ეს ინტეგრაცია, რომელიც აფართოებს Cloudflare-ისა და Hugging Face-ის სტრატეგიულ პარტნიორობას, გვთავაზობს სერვერების გარეშე (serverless) წვდომას პოპულარულ Hugging Face მოდელებზე, მოთხოვნის მიხედვით გადახდის (pay-per-request) მოდელით, რითაც წყდება GPU-ს სიმცირისა და ფიქსირებული ხარჯების პრობლემა.
ღრმა გაძლიერებითი სწავლება: პროქსიმალური პოლიტიკის ოპტიმიზაცია (PPO)
ეს სტატია ღრმა გაძლიერებითი სწავლების კურსის ნაწილია და დეტალურად განიხილავს პროქსიმალური პოლიტიკის ოპტიმიზაციას (PPO). PPO არის არქიტექტურა, რომელიც აუმჯობესებს აგენტის ვარჯიშის სტაბილურობას პოლიტიკის გადაჭარბებული განახლებების თავიდან აცილებით. ჩვენ შევისწავლით, თუ როგორ იყენებს PPO მიმდინარე და ძველი პოლიტიკის თანაფარდობის კლიპინგს სტაბილური განახლებების უზრუნველსაყოფად. თეორიის შემდეგ, სტატია წარმოგიდგენთ PPO არქიტექტურის ნულიდან დაწერას PyTorch-ის გამოყენებით, მაგალითად CartPole-v1-სა და Lu

ხელოვნური ინტელექტი უჯრედის მოდელირებაში: გენის გაჩუმების ეფექტის პროგნოზირება CRISPR-ით
„ვირტუალური უჯრედის გამოწვევა“ მიზნად ისახავს ისეთი ხელოვნური ინტელექტის მოდელის შექმნას, რომელიც შეძლებს CRISPR-ის გამოყენებით გენის გაჩუმების შედეგად უჯრედზე მიღებული ეფექტების პროგნოზირებას, ფიზიკური, ძვირადღღირებული ექსპერიმენტების საჭიროების გარეშე. გამოწვევისთვის Arc-მა შეაგროვა 300 ათასი ერთუჯრედოვანი რნმ სეკვენირების პროფილის მონაცემთა ნაკრები. ამ პროცესში მნიშვნელოვანი სირთულეებია უჯრედის მდგომარეობის გაზომვის შეუძლებლობა ცვლილებამდე და მის შემდეგ, რაც მოითხოვს საკონტროლო უჯრედების გამო
AI-ის როლი გენის გაჩუმების პროგნოზირებაში: ვირტუალური უჯრედის გამოწვევა
თანამედროვე კვლევები მიზნად ისახავს ხელოვნური ინტელექტის (AI) მოდელის შექმნას, რომელიც CRISPR-ის გამოყენებით გენის გაჩუმების უჯრედზე ზემოქმედებას იწინასწარმეტყველებს. „ვირტუალური უჯრედის გამოწვევა“ ცდილობს გადალახოს ფიზიკური ექსპერიმენტების სირთულეები და მაღალი ღირებულება, რაც საშუალებას მისცემს ათასობით წამლის კანდიდატის ტესტირებას ვირტუალურ გარემოში. Arc-ის მიერ შეგროვებული 300 ათასი ერთუჯრედოვანი რნმ-ის სექვენირების პროფილის მონაცემთა ნაკრები გამოიყენება ნერვული ქსელების სავარჯიშოდ. სტატია ას
Hugging Face-ის ტრანსფორმატორები TensorFlow-ის ინჟინრებისთვის: გზამკვლევი
სტატია განიხილავს PyTorch-ის ინჟინრების მიერ TensorFlow-თან მიდგომის ხშირ შეცდომას, კერძოდ, Keras-ის მაღალი დონის API-ის უგულებელყოფას. ხაზგასმულია, რომ Keras-ის გამოყენება TensorFlow-სთან ოპტიმალურია. შემდეგ წარმოდგენილია Hugging Face-ის ტრანსფორმატორები, როგორც ძლიერი ინსტრუმენტები, რომლებიც TensorFlow-ის ინჟინრებს საშუალებას აძლევს, გამოიყენონ უახლესი მოდელები ნაცნობი Keras API-ის მეშვეობით. დეტალურად არის ახსნილი ტრანსფერული სწავლის (transfer learning) კონცეფცია, როგორც ML პრობლემების გადაჭრ
Hugging Face-მა ახალი ბიბლიოთეკა Skops წარადგინა: scikit-learn მოდელების ჰოსტინგი და თანამშრომლობა გაუმჯობესდა
Hugging Face-მა წარმოადგინა Skops, ახალი ბიბლიოთეკა, რომელიც შექმნილია scikit-learn მოდელების Hugging Face Hub-ზე განთავსების პროცესის გასამარტივებლად. Skops უზრუნველყოფს მოდელების უსაფრთხო ჰოსტინგს, დოკუმენტაციას მოდელის ბარათების მეშვეობით და გაუმჯობესებულ თანამშრომლობას, რითაც ღია კოდის მანქანური სწავლების პროექტებისთვის რეპროდუცირებადობა და ახსნადობა უფრო ხელმისაწვდომი ხდება.

Parquet-ის კონტენტზე დაფუძნებული დანაწილება (CDC) Hugging Face Xet-ზე მონაცემთა ეფექტური შენახვისთვის
Parquet-ის კონტენტზე დაფუძნებული დანაწილება (CDC) უკვე ხელმისაწვდომია PyArrow-სა და Pandas-ში, რაც Parquet ფაილების მაღალეფექტურ დედუპლიკაციას იძლევა ისეთ კონტენტ-მისამართებად საცავ სისტემებზე, როგორიცაა Hugging Face-ის Xet. ეს ინოვაცია მნიშვნელოვნად ამცირებს მონაცემთა გადაცემისა და შენახვის ხარჯებს, რადგან მხოლოდ შეცვლილი მონაცემთა ნაწილები მუშავდება.
Meta-მ Llama 3 გამოუშვა: ღია ხელმისაწვდომობის ხელოვნური ინტელექტის ახალი თაობა
Meta-მ გამოუშვა Llama 3, ღია წვდომის Llama ოჯახის შემდეგი თაობა, რომელიც ხელმისაწვდომია Hugging Face-ზე. ახალი მოდელი, რომელიც ორი ზომის (8B და 70B) ვარიანტებითაა წარმოდგენილი (როგორც საბაზისო, ისე ინსტრუქციებზე მორგებული), აგრძელებს Meta-ს ერთგულებას ღია AI-ის მიმართ. მნიშვნელოვანი სიახლეები მოიცავს გაფართოებულ 128K ლექსიკონის მქონე ტოკენაიზერს, 8K ტოკენის კონტექსტის სიგრძეს, 8B ვერსიაში Grouped-Query Attention-ის გამოყენებას და Llama Guard 2-ის გამოშვებას უსაფრთხო შინაარსის კლასიფიკაციისთვის.
დიდი ენობრივი მოდელები ჯანდაცვაში: პოტენციალი, გამოწვევები და შეფასების პლატფორმა
დიდი ენობრივი მოდელები (LLM) უდიდეს პოტენციალს ფლობს ჯანდაცვის სფეროს რევოლუციონიზაციისთვის, თუმცა მათ გამოყენებას თან ახლავს სერიოზული გამოწვევები სიზუსტისა და სანდოობის კუთხით, რადგან სამედიცინო შეცდომებმა შეიძლება სიცოცხლისთვის საშიში შედეგები გამოიწვიოს. ამ პრობლემების გადასაჭრელად შეიქმნა „Open Medical-LLM Leaderboard“, სტანდარტიზებული პლატფორმა, რომელიც აფასებს და ადარებს LLM-ების მუშაობას სხვადასხვა სამედიცინო ამოცანასა და მონაცემთა ბაზაზე (როგორიცაა MedQA, MedMCQA, PubMedQA, MMLU). მიზან

NVIDIA-ის AI-Q Blueprint ლიდერთა დაფაზე: ღია კოდის AI-ს ტრიუმფი DeepResearch Bench-ზე
NVIDIA-ის AI-Q Blueprint, წამყვანი პორტატული, ღია სიღრმისეული კვლევითი აგენტი, პირველ ადგილზე გავიდა Hugging Face-ის „LLM ძიებით“ ლიდერთა დაფის სათავეში DeepResearch Bench-ზე. ეს მიღწევა ადასტურებს, რომ დეველოპერებისთვის ხელმისაწვდომ მოდელებს შეუძლიათ უზრუნველყონ მოწინავე აგენტური სამუშაო პროცესები, რომლებიც კონკურენციას უწევს ან აღემატება დახურულ ალტერნატივებს გამჭვირვალობისა და კონტროლის შენარჩუნებით. AI-Q აერთიანებს ორ მაღალპროდუქტიულ Llama 3.3 LLM-ს, რაც უზრუნველყოფს გრძელკონტექსტურ ინფორმაც
StarCoder2-15B-Instruct: ახალი ეტალონი კოდის ხელოვნური ინტელექტისთვის თვით-განვითარების გზით
ახალი ენა-მოდელი, StarCoder2-15B-Instruct, აჩვენებს გასაოცარ შედეგებს კოდის გენერაციაში, უსწრებს ისეთ მძლავრ მოდელებს, როგორიცაა CodeLlama-70B-Instruct და აღწევს 72.6 HumanEval ქულას. მისი წარმატების საიდუმლო თვით-მორგების (self-alignment) ინოვაციურ მეთოდოლოგიაში მდგომარეობს, რაც საშუალებას აძლევს მოდელს ეფექტურად ისწავლოს საკუთარი გენერირებული მონაცემებიდან, ძლიერი „მასწავლებელი“ მოდელების გამოყენების გარეშე. ეს მიდგომა გულისხმობს ინსტრუქციების თვით-გენერირებას და საკუთარი კოდის ტესტირებას, რაც
LLM-ის მუშაობის ლიდერბორდი: სიჩქარე, ფასი და ხარისხი AI აპლიკაციებისთვის Hugging Face-ზე
Artificial Analysis-მა გამოაქვეყნა LLM-ის მუშაობის ლიდერბორდი Hugging Face-ზე, რომელიც აფასებს 100-ზე მეტი უსერვერო LLM API ენდპოინტის სიჩქარეს, ფასსა და ხარისხს. ეს ინსტრუმენტი მიზნად ისახავს AI ინჟინრებს დაეხმაროს გადაწყვეტილებების მიღებაში, თუ რომელი მოდელები და პროვაიდერები გამოიყენონ თავიანთ აპლიკაციებში, რადგან სამომხმარებლო და კომპლექსური AI სისტემებისთვის მუშაობის ეს ფაქტორები კრიტიკულია.

Arm-მა დეველოპერებისთვის Neural Super Sampling (NSS) ტექნოლოგია გამოუშვა
Arm-მა წარადგინა შემდეგი თაობის ხელოვნურ ინტელექტზე დაფუძნებული გამოსახულების გაფართოების გადაწყვეტა – Neural Super Sampling (NSS), რომელიც უკვე ხელმისაწვდომია გრაფიკისა და თამაშების დეველოპერებისთვის. ეს ტექნოლოგია ოპტიმიზებულია მობილური მოწყობილობებისთვის, უზრუნველყოფს რეალურ დროში შესრულებას, ამცირებს GPU-ს დატვირთვას და იძლევა მაღალი გარჩევადობის რენდერირების საშუალებას დაბალი გამოთვლითი ხარჯებით, განსაკუთრებით მობილური თამაშებისა და გაფართოებული რეალობის (XR) სცენარებისთვის.
როგორ განვაახლოთ Hugging Face ორგანიზაცია Enterprise Hub-მდე AWS ანგარიშის გამოყენებით
გაიგეთ, თუ როგორ უნდა განაახლოთ თქვენი Hugging Face ორგანიზაცია Enterprise Hub-მდე AWS Marketplace-ის მეშვეობით, რათა ისარგებლოთ გაფართოებული უსაფრთხოების ფუნქციებით, წვდომის კონტროლით და ხელოვნური ინტელექტის კერძოდ და უსაფრთხოდ შექმნის შესაძლებლობით GDPR-თან შესაბამის და SOC2 Type 2 სერტიფიცირებულ პლატფორმაზე.

Arm KleidiAI და SDOT: გენერაციული ხელოვნური ინტელექტი მილიარდობით მოწყობილობაზე, მათ შორის ძველ მოდელებზეც
Arm-ის KleidiAI, SDOT CPU ფუნქციის გამოყენებით, გენერაციულ ხელოვნურ ინტელექტს (GenAI) ხელმისაწვდომს ხდის მოწყობილობების ფართო სპექტრზე – უახლესი ფლაგმანური მოდელებიდან დაწყებული, ხუთ წლამდე ძველი სმარტფონებითა და Raspberry Pi 5-ით დამთავრებული. ეს მიიღწევა პოპულარულ AI ფრეიმვორკებში ჩაშენებული ოპტიმიზაციებით და ExecuTorch 0.7 ბეტაში ნაგულისხმევი ჩართვით, რაც უზრუნველყოფს დიდი ენობრივი მოდელების (LLM) ეფექტურ მუშაობას კოდის შეცვლის გარეშე და მნიშვნელოვანი წარმადობის გაუმჯობესებით.
„Transformers Agents 2.0“-ის (ახლა უკვე smolagents!) გამოშვება: აგენტების ახალი, მძლავრი ჩარჩო
Hugging Face-ი აცხადებს „Transformers Agents 2.0“-ის გამოშვებას, რომელიც ახლა დამოუკიდებელი ბიბლიოთეკა smolagents-ის სახით არის ხელმისაწვდომი. ეს განახლება წარმოგიდგენთ აგენტების ახალ ტიპებს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე იტერაცია მოახდინონ რთული ამოცანების გადასაჭრელად, გამოირჩევიან გაუმჯობესებული შესრულებით (Llama-3-70B-Instruct აგენტები GPT-4-ზე უკეთეს შედეგებს აჩვენებენ GAIA Leaderboard-ზე) და აქცენტი კეთდება კოდის სიცხადეზე, მოდულარულობაზე და საზოგადოების ჩართულობაზე გ
PyTorch-ის განაწილებული წვრთნა: DDP-დან Accelerate-მდე
ეს სტატია განიხილავს PyTorch-ში მრავალ GPU-ზე მოდელის წვრთნის პროცესს Distributed Data Parallelism (DDP) მექანიზმის გამოყენებით. მოცემულია საბაზისო კოდის მაგალითები და ნაჩვენებია, თუ როგორ ამარტივებს `torch.distributed` და შემდგომში `Accelerate` ბიბლიოთეკა ამ პროცესს, რაც საშუალებას იძლევა ეფექტური განაწილებული წვრთნისთვის კოდის მინიმალური ცვლილებებით. ასევე განხილულია მონაცემთა მილსადენის გაუმჯობესება და Jupyter Notebook-თან ინტეგრაცია.
კონტრასტული ძიება: ინოვაციური მიდგომა ბუნებრივი და თანმიმდევრული ტექსტის გენერაციაში
ტექსტის გენერაციის არსებული მეთოდები ხშირად აწყდებიან პრობლემებს, როგორიცაა გამეორებები და სემანტიკური შეუსაბამობა. კონტრასტული ძიება (Contrastive Search) წარმოადგენს ახალ დეკოდირების მეთოდს, რომელიც აბალანსებს ენის მოდელის ნდობასა და კონტექსტთან მსგავსებას, რათა შექმნას მაღალი ხარისხის, გრამატიკულად გამართული და სემანტიკურად თანმიმდევრული ტექსტი.
ჰაგინგ ფეისი და arXiv კვლევით ნაშრომებს ინტერაქტიულს ხდიან: Spaces-ის ინტეგრაცია დემო ჩანართით
Hugging Face და arXiv ითანამშრომლეს, რათა კვლევითი ნაშრომები უფრო ხელმისაწვდომი და ინტერაქტიული გახდეს. ამიერიდან, arXiv-ზე არსებულ ნაშრომებს ექნებათ „დემო“ ჩანართი, რომელიც მომხმარებლებს საშუალებას მისცემს, დაუყოვნებლივ გამოსცადონ ღია კოდის მანქანური სწავლების დემოები ყოველგვარი კოდის დაწერის გარეშე.

RiskRubric.ai: ხელოვნური ინტელექტის მოდელების რისკების სტანდარტიზებული შეფასება
Hugging Face-ის ჰაბზე არსებული 500,000-ზე მეტი AI მოდელის უსაფრთხოებისა და სანდოობის შეფასების გამოწვევის საპასუხოდ, Cloud Security Alliance-მა და Noma Security-მ, Haize Labs-ისა და Harmonic Security-ის მონაწილეობით, წამოიწყეს RiskRubric.ai ინიციატივა. ეს პლატფორმა უზრუნველყოფს AI მოდელების რისკების გამჭვირვალე, სტანდარტიზებულ შეფასებას ექვსი ძირითადი სვეტის მიხედვით: გამჭვირვალობა, სანდოობა, უსაფრთხოება, კონფიდენციალურობა, უვნებლობა და რეპუტაცია. მიზანია დეველოპერებსა და ორგანიზაციებს დაეხმაროს
ხელოვნური ინტელექტის ტექსტიდან გამოსახულების გენერაციის ლიდერბორდი ადამიანის შეფასებებით
კომპანია Artificial Analysis-მა შექმნა ტექსტიდან გამოსახულების გენერაციის ხელოვნური ინტელექტის მოდელების ლიდერბორდი, რომელიც ადამიანის შეფასებებზე დაყრდნობით ზომავს მათ ხარისხს. ELO ქულები ეფუძნება 45,000-ზე მეტ ადამიანურ შეფასებას „Image Arena“-დან. ლიდერბორდზე წარმოდგენილია წამყვანი ღია კოდის და კომერციული მოდელები, როგორიცაა Midjourney, DALL·E და Stable Diffusion. საზოგადოებას შეუძლია მონაწილეობა მიიღოს შეფასების პროცესში და მიიღოს პერსონალიზებული რეიტინგი.
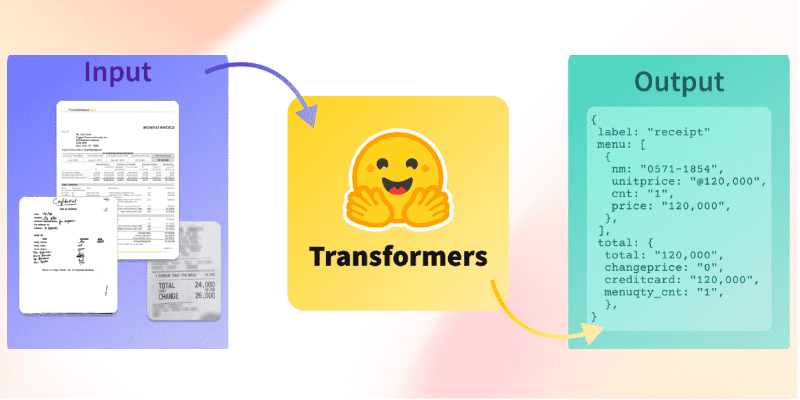
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ
ღია Embedding მოდელების განთავსება Amazon SageMaker-ზე Hugging Face Embedding კონტეინერის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ ღია Embedding მოდელები, როგორიცაა Snowflake Arctic Embed, Amazon SageMaker-ზე ინფერენციისთვის, ახალი Hugging Face Embedding კონტეინერის გამოყენებით. სტატია მოიცავს განვითარების გარემოს დაყენებას, კონტეინერის მოძიებას, მოდელის განთავსებას და მისი მუშაობის შეფასებას როგორც CPU, ასევე GPU ინსტანციებზე, ხაზს უსვამს Text Embedding Inference (TEI)-ის ეფექტურობას და ხარჯ-ეფექტურობას.