PatchTST: ინოვაციური მოდელი დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით
ICLR 2023-ზე წარდგენილი PatchTST მოდელი რევოლუციურ მიდგომას გვთავაზობს დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით. მოდელი ეფუძნება ინდივიდუალური დროითი რიგების „პაჩებად“ დაყოფას, რაც არაერთ სარგებელს იძლევა. სტატიაში აღწერილია PatchTST-ის ვარჯიში Electricity მონაცემთა ნაკრებზე და მისი ტრანსფერული სწავლის შესაძლებლობები ETTh1 მონაცემთა ნაკრებზე, სადაც ნაჩვენებია მნიშვნელოვანი გაუმჯობესება ნულოვანი სწავლის (zero-shot), წრფივი გამოძიების (linear probing) და სრული ფაინ
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ
ხელოვნური ინტელექტის მორგება ღია მოდელებზე: კონსტიტუციური AI და ახალი ინსტრუმენტი llm-swarm
სტატია წარმოგიდგენთ კონსტიტუციურ ხელოვნურ ინტელექტს (CAI), როგორც დიდი ენობრივი მოდელების (LLMs) მომართვის ინოვაციურ ტექნიკას მომხმარებლის მიერ განსაზღვრული პრინციპების გამოყენებით, რაც მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. იგი გვთავაზობს CAI-ის ღია მოდელებით განხორციელების სრულყოფილ გზამკვლევს, მათ შორის ახალ ინსტრუმენტ llm-swarm-ს მასშტაბური სინთეზური მონაცემების გენერირებისთვის. განხილულია CAI მონაცემთა ნაკრებების შექმნისა და მოდელების, მაგალითად Mistral-7B-
კონსტიტუციური ხელოვნური ინტელექტი: ღია მოდელების თვითგასწორება და ახალი ინსტრუმენტი „llm-swarm“
Anthropic-ის მიერ შემოთავაზებული კონსტიტუციური ხელოვნური ინტელექტის (CAI) ტექნიკა LLM-ებს აძლევს საშუალებას, თავად შეაფასონ და გააუმჯობესონ საკუთარი გამომუშავება მომხმარებლის მიერ განსაზღვრული პრინციპების მიხედვით. ეს მიდგომა მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. მოცემულ ნაშრომში აღწერილია კონსტიტუციური AI-ის სრულყოფილი განხორციელების რეცეპტი ღია მოდელებით, ასევე წარმოდგენილია ახალი ინსტრუმენტი „llm-swarm“, რომელიც GPU Slurm კლასტერებს იყენებს სკალირებადი სინთე
NPHardEval: ახალი დინამიური ჩარჩო დიდი ენობრივი მოდელების მსჯელობის უნარის შესაფასებლად
NPHardEval წარმოგიდგენთ ინოვაციურ, დინამიურ და სირთულეზე დაფუძნებულ ჩარჩოს დიდი ენობრივი მოდელების (LLMs) მსჯელობის უნარების მკაცრი შეფასებისთვის. ის მოიცავს 900 ალგორითმულ კითხვას NP-რთული სირთულის კლასიდან და ქვედა დონეებიდან, რომლებიც ყოველთვიურად განახლდება მოდელების ზედმეტი მორგების თავიდან ასაცილებლად. NPHardEval გამოირჩევა გამოთვლითი სირთულის კლასების გამოყენებით, რაც LLM-ის აზროვნების უნარების რაოდენობრივ და მტკიცე შეფასებას უზრუნველყოფს, რეალურ სამყაროში არსებული გამოწვევების ასახვით.
წარმოდგენილია SegMoE: ექსპერტთა ნარევი Stable Diffusion მოდელებისთვის
SegMoE წარმოადგენს ინოვაციურ არქიტექტურას, რომელიც აერთიანებს მრავალ მოდელს ერთში Feed-Forward ფენების MoE ფენებით ჩანაცვლებით. ეს საშუალებას აძლევს Stable Diffusion მოდელებს უფრო ეფექტურად და ზუსტად გენერირდეს სურათები. ახალი პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა და იგი აუმჯობესებს „prompt“ გაგებას, თუმცა აღინიშნება VRAM-ის მაღალი მოხმარება და გარკვეული სისუსტე ერთეულ SD მოდელებთან შედარებით.
SegMoE მოდელების გამოშვება: როგორ გავაერთიანოთ დიფუზიური მოდელები მარტივად
SegMoE წარმოადგენს ახალ მიდგომას დიფუზიური მოდელების შექმნაში, რომელიც სტეიბლ დიფუჟენის არქიტექტურას ეფუძნება და Mixtral 8x7b-ის მსგავსად, რამდენიმე მოდელს ერთში აერთიანებს. ის Feed-Forward შრეებს ცვლის იშვიათი MoE შრით, რომელიც ექსპერტთა როუტერულ ქსელს იყენებს. SegMoE პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა, რაც აუმჯობესებს პრომპტების გაგებას. მოდელი მხარს უჭერს Hugging Face-ისა და CivitAI-ის პლატფორმებს. თუმცა, მას აქვს შეზღუდვები, როგორიცაა ნელი სიჩქარე და VRAM-ის მაღალი მ

ხელოვნური ინტელექტის აგენტების ევოლუცია: სტრუქტურული კოდის გენერაციის უპირატესობა
კვლევა იკვლევს ხელოვნური ინტელექტის აგენტების არქიტექტურის ევოლუციას, ადარებს ტრადიციულ JSON აგენტებს, CodeAgent-ებს და ახალ სტრუქტურულ CodeAgent-ებს. ეს უკანასკნელი აერთიანებს კოდის მოქნილობასა და სტრუქტურული გამომავალი მონაცემების სანდოობას, რაც მნიშვნელოვნად ამცირებს ანალიზის (parsing) შეცდომებს და აუმჯობესებს აგენტების მუშაობას. ნაჩვენებია, რომ სტრუქტურული გენერაცია აიძულებს აგენტებს, უფრო მკაფიოდ გამოხატონ თავიანთი მსჯელობა, თუმცა აღინიშნება, რომ ამ მიდგომის სრული პოტენციალი ვლინდება მაღალი
Hugging Face და AMD აძლიერებენ ხელოვნური ინტელექტის განვითარებას AMD GPU-ებზე
Hugging Face-ი და AMD-ი აცხადებენ მნიშვნელოვან პროგრესს AMD GPU-ებზე დიდი ენობრივი მოდელების (LLM) მხარდაჭერაში, რაც უზრუნველყოფს ტრანსფორმერული მოდელების უწყვეტ გაშვებას კოდის შეცვლის გარეშე. დამატებითი აჩქარების ინსტრუმენტები, როგორიცაა ONNX, Optimum-Benchmark და DeepSpeed, უკვე მხარდაჭერილია. კომპანიები ასევე ხელს უწყობენ დეველოპერებს PC AI კონკურსის ფარგლებში ინოვაციური AI აპლიკაციების შექმნაში AMD Ryzen AI-ით აღჭურვილ კომპიუტერებზე.
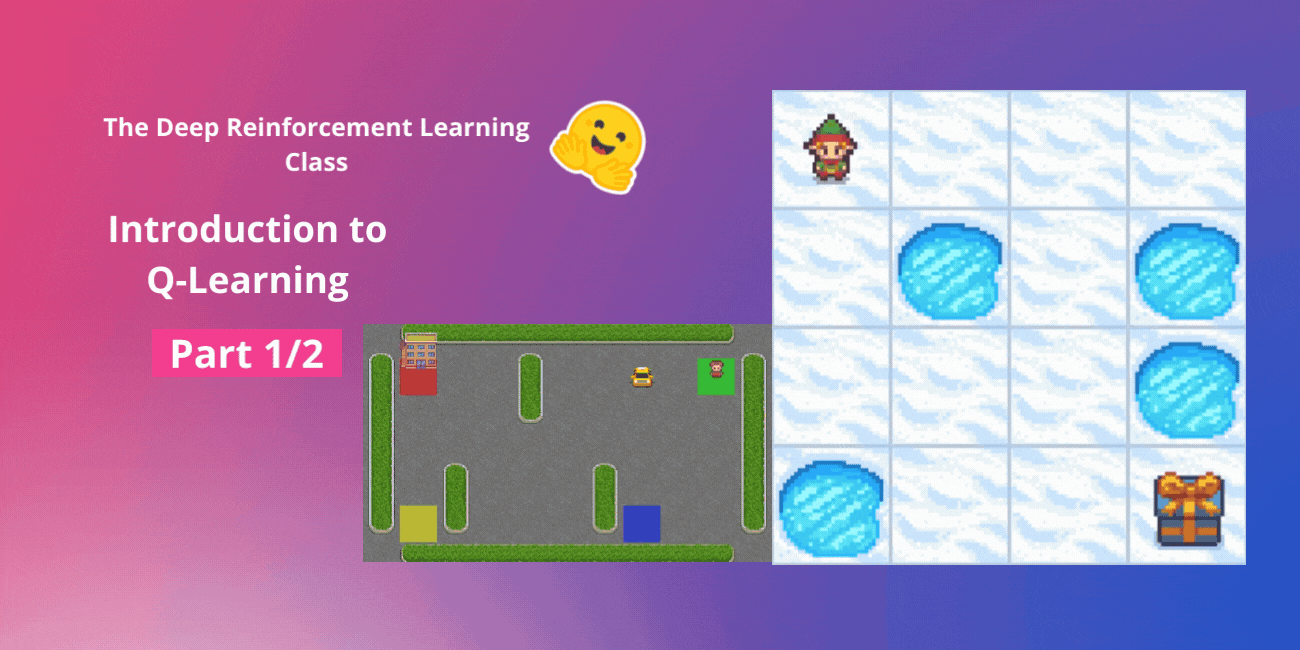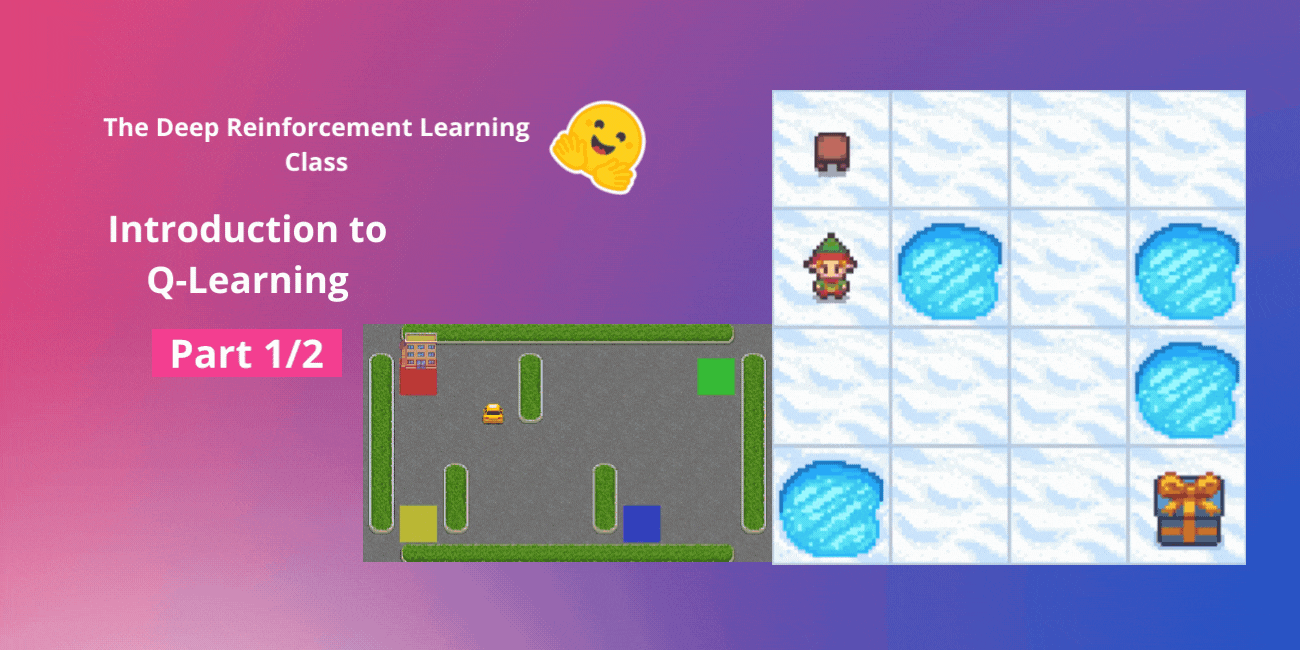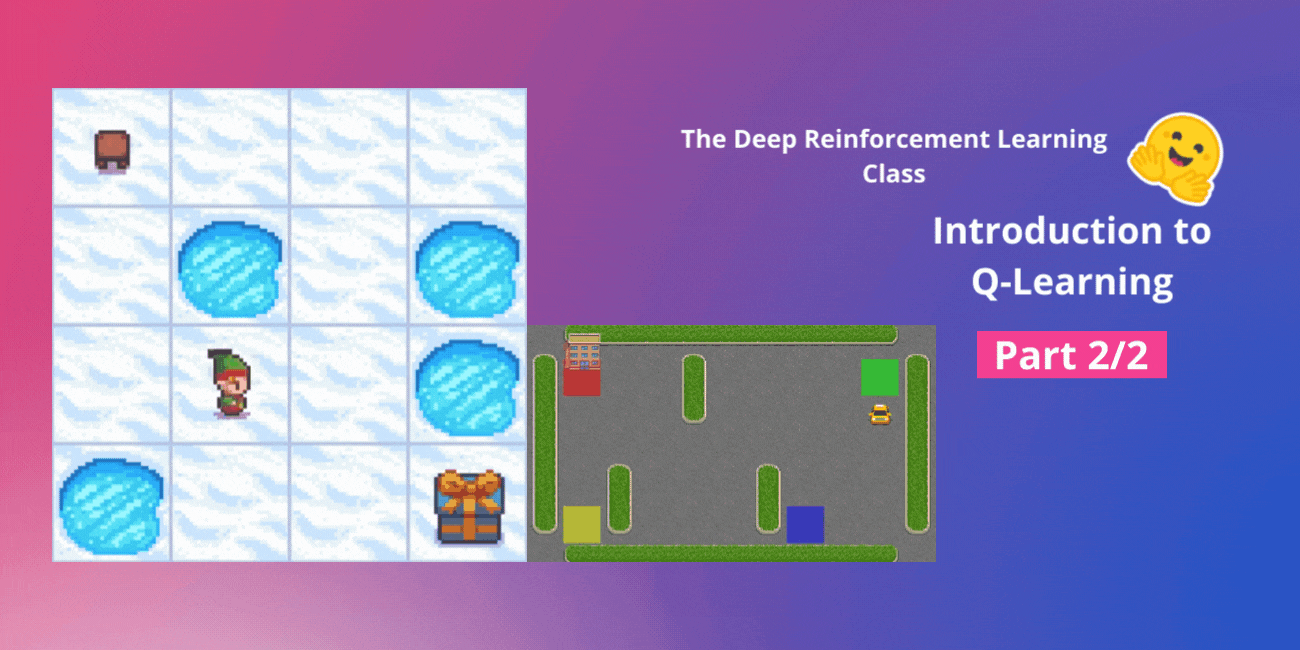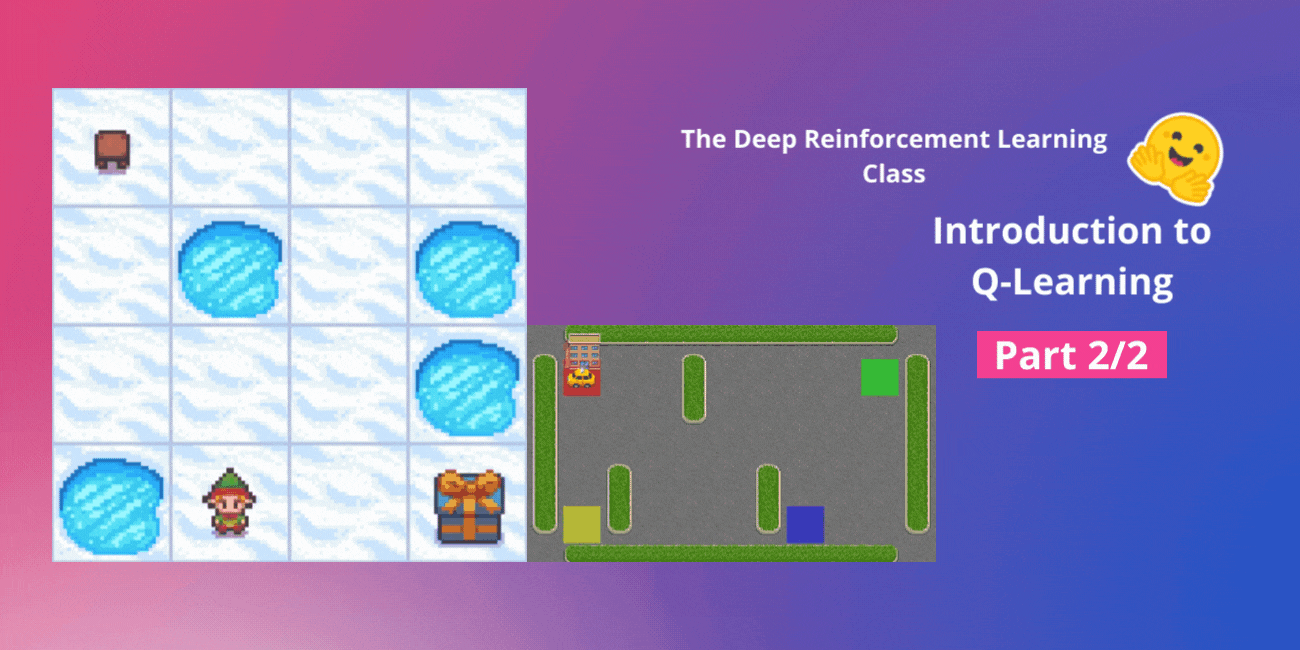
ღრმა გაძლიერებითი სწავლის კურსი: ღირებულებაზე დაფუძნებული მეთოდები და Q-სწავლება
ეს სტატია ღრმა გაძლიერებითი სწავლის (Deep Reinforcement Learning) კურსის ნაწილია, რომელიც დამწყებიდან ექსპერტამდე დონისთვის არის განკუთვნილი. ის დეტალურად განიხილავს ღირებულებაზე დაფუძნებულ მეთოდებსა და Q-სწავლებას, განმარტავს, თუ როგორ იღებენ RL აგენტები ჭკვიან გადაწყვეტილებებს გარემოსთან ცდისა და შეცდომის გზით ურთიერთქმედებით და ჯილდოების მაქსიმიზაციით. სტატია ასევე ეხება მდგომარეობისა და მოქმედების ღირებულების ფუნქციებს შორის განსხვავებას, პოლიტიკისა და ღირებულების ფუნქციის წვრთნის ნიუანსებს,
მოდელების შერწყმა: LoRA ადაპტერების გაერთიანების ახალი მიდგომები PEFT-ში
ამ პოსტში წარმოდგენილია 🤗 PEFT-ის ფარგლებში შემუშავებული LoRA ადაპტერების შერწყმის ახალი, ოპტიმიზებული მეთოდები. განხილულია სტანდარტული მოდელების გაერთიანების მიდგომები, მეხსიერების ინტენსივობის გამოწვევები და შემოთავაზებულია სხვადასხვა ტექნიკა, მათ შორის კონკატენაცია, მატრიცების შეწონილი ჯამი და დავალების არითმეტიკა (Task Arithmetic). სტატია მოიცავს კოდის მაგალითებს, შთამბეჭდავ შედეგებსა და სამომავლო გეგმებს.

AI-ის ძალა მუსიკალურ შემოქმედებაში: Arm-ის პროცესორებით სტუდიური ხმის გენერაცია პირდაპირ მოწყობილობაზე
პროგრამისტმა და მუსიკალურმა პროდიუსერმა შექმნა ინოვაციური აპლიკაცია, რომელიც Arm-ზე დაფუძნებული CPU-სა და ღია კოდის AI მოდელების გამოყენებით, პირდაპირ მოწყობილობაზე გენერირებს სტუდიური ხარისხის ჟღერადობას. ეს ინსტრუმენტი უზრუნველყოფს სწრაფ, პირად და შეუფერხებელ სამუშაო პროცესს მუსიკალური პროდიუსერებისთვის, რაც მათ საშუალებას აძლევს, წამებში შექმნან უნიკალური ხმები მარტივი მოთხოვნებით, ყოველგვარი ღრუბლოვანი სერვისების ან GPU-ს საჭიროების გარეშე. პროექტი გვიჩვენებს კონტენტის შექმნის მომავალს მოწყო
Haize Labs-ი Hugging Face-ის მხარდაჭერით LLM-ების „წითელი გუნდის“ წინააღმდეგობის ახალ ბენჩმარკს წარადგენს
ხელოვნური ინტელექტის (AI) სფეროში, დიდი ენობრივი მოდელების (LLM) უსაფრთხოებასა და არასასურველ ქცევებთან დაკავშირებით მზარდი შეშფოთებაა. ამ გამოწვევის საპასუხოდ, Haize Labs-მა, Hugging Face-ის გუნდის მხარდაჭერით, შექმნა „Red Teaming Resistance Benchmark“ – ახალი საორიენტაციო სისტემა. ის მიზნად ისახავს უახლესი LLM მოდელების მდგრადობის შემოწმებას ადამიანის მიერ შემუშავებული, დახვეწილი „წითელი გუნდის“ (red teaming) შეტევების გამოყენებით, რათა გამოავლინოს მათი სისუსტეები და მოწყვლადობები. ბენჩმარკი ფ
Haize Labs-მა და Hugging Face-მა დიდი ენობრივი მოდელების უსაფრთხოების ახალი ეტალონი, „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ წარადგინეს
დიდი ენობრივი მოდელების (დემ) კვლევის სწრაფი ტემპის ფონზე, Haize Labs-მა, Hugging Face-ის გულუხვი მხარდაჭერით, გამოაქვეყნა „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ (Red Teaming Resistance Benchmark). ეს ახალი ეტალონი მიზნად ისახავს მოწინავე დემ-ების მოწყვლადობების საფუძვლიან შემოწმებას ადამიანის მიერ შექმნილი, ბუნებრივი ენის მსგავსი მავნე მოთხოვნების (prompts) გამოყენებით, განსხვავებით ხელოვნური, ავტომატიზებული შეტევებისგან. ბენჩმარკი აფასებს მოდელების მდგრადობას არასასურველი ქცევების მიმართ, რო
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.
ღრმა Q-სწავლება: როგორ ვავარჯიშოთ აგენტები Atari-ს თამაშებში
ეს სტატია ღრმა გაძლიერებული სწავლების კურსის ნაწილია. განვიხილავთ, თუ როგორ გადადის ტრადიციული Q-სწავლება, რომელსაც შეზღუდვები აქვს დიდი მდგომარეობათა სივრცეების შემთხვევაში, ღრმა Q-სწავლებაში. ეს უკანასკნელი იყენებს ნერვულ ქსელებს Q-მნიშვნელობების აპროქსიმაციისთვის, რაც საშუალებას გვაძლევს მოვამზადოთ აგენტები რთული გარემოებისთვის, როგორიცაა Atari-ს თამაშები. სტატია დეტალურად აღწერს Deep Q-Network-ის არქიტექტურას, მონაცემთა წინასწარ დამუშავებას და ჩარჩოების დაწყობის მნიშვნელობას დროითი შეზღუდვებ
TTS Arena: მეტყველების სინთეზის მოდელების შეფასების დემოკრატიზაცია
მეტყველების სინთეზის სფეროში დიდი ხანია არ არსებობდა მოდელების ხარისხის ზუსტი გაზომვის მეთოდი. არსებული ობიექტური და სუბიექტური მეთოდები არაეფექტურია მსგავსი ხარისხის მოდელების შესადარებლად. ამ გამოწვევის საპასუხოდ, შეიქმნა TTS Arena, სადაც საზოგადოებას შეუძლია შეაფასოს სინთეზირებული აუდიო და დაეხმაროს მოდელების რანჟირების დემოკრატიზაციას. პლატფორმა იყენებს ადამიანის შეფასებას, მსგავსად Chatbot Arena-ისა, მოდელების ობიექტური შედარებისთვის.
წარმოგიდგენთ StarCoder2-ს: ინოვაცია პროგრამირების ენობრივ მოდელებში
StarCoder2 არის ღია კოდის დიდი ენობრივი მოდელების (LLM) ოჯახი, შექმნილი კოდის გენერაციისა და ანალიზისთვის. ის ხელმისაწვდომია სამი ზომის ვარიანტში – 3B, 7B და 15B პარამეტრით. ფლაგმანი StarCoder2-15B მოდელი გაწვრთნილია 4 ტრილიონზე მეტ ტოკენსა და 600-ზე მეტ პროგრამირების ენაზე The Stack v2 მონაცემთა ბაზიდან, რაც მას თავის ზომის კლასში საუკეთესოდ აქცევს და კონკურენციას უწევს 33B+ ზომის მოდელებს. პროექტი არის BigCode-ის თანამშრომლობის ნაწილი, რომელიც მიზნად ისახავს კოდისთვის განკუთვნილი LLM-ების პასუ
Hugging Face და Argilla: ერთობლივი ძალებით უკეთესი მონაცემთა ბაზებისთვის
Hugging Face და Argilla ერთობლივ ინიციატივას იწყებენ, რათა საზოგადოებას დაეხმარონ მაღალი ხარისხის მონაცემთა ბაზების შექმნაში, განსაკუთრებით ნაკლებად წარმოდგენილი ენებისა და ამოცანებისთვის. პროექტი გულისხმობს ინსტრუმენტების, როგორიცაა Argilla და Hugging Face Spaces, გამოყენებას ანოტაციის პროცესის გასამარტივებლად. მოწვეულნი არიან დაინტერესებული თემები, რათა შეუერთდნენ საწყის კოჰორტას და წვლილი შეიტანონ ხელოვნური ინტელექტის განვითარებაში, კოდირების ცოდნის გარეშეც.

OOM შეცდომების დავიწყება: დიდი მოდელების ეფექტური წვრთნა DeepSpeed ZeRO-ს გამოყენებით
დაიღალეთ მეხსიერებიდან ამოწურვის (OOM) შეცდომებით დიდი ხელოვნური ინტელექტის მოდელების წვრთნისას? ეს სტატია წარმოგიდგენთ DeepSpeed ZeRO (Zero Redundancy Optimizer) ტექნოლოგიას, რომელიც მონაცემთა პარალელიზმის (Data Parallelism) გამოყენებით საშუალებას გაძლევთ მაქსიმალურად გამოიყენოთ არსებული აპარატურა. ჩვენ განვიხილავთ ZeRO-ს სხვადასხვა სტადიას, ოპტიმიზატორის მდგომარეობების, გრადიენტებისა და მოდელის პარამეტრების დანაწილების ჩათვლით. სტატია აჩვენებს, თუ როგორ შეუძლია DeepSpeed ZeRO Stage-2-ს, Accele

მაღალი წარმადობისა და საიმედოობის შენარჩუნება: Hugging Face-ის ინფრასტრუქტურის ძირითადი ინსტრუმენტები
ეს სტატია დეტალურად განიხილავს Hugging Face-ის წარმოების ინფრასტრუქტურის მხარდაჭერისთვის გამოყენებულ სამ ძირითად გაფრთხილებას, NAT კარიბჭეების მნიშვნელობას გამავალი ტრაფიკის მონიტორინგისთვის და ხარჯების ოპტიმიზაციის სტრატეგიებს. აღწერილია ქსელის ტრაფიკის მოცულობის მონიტორინგის სისტემა, რომელიც იძლევა დროულ გაფრთხილებებს და ხელს უწყობს ინფრასტრუქტურის კონფიგურაციის ოპტიმიზაციას. ასევე განხილულია Hugging Face-ის დახვეწილი ლოგირების ინფრასტრუქტურა (Filebeat, Logstash, Elasticsearch), რომელიც უზრუნვ
როგორ შევქმნათ მუსიკალური ფლეილისტი ტექსტური მოთხოვნით: Sentence Transformers და Gradio
ეს სტატია განმარტავს, თუ როგორ შეიძლება Sentence Transformers ბიბლიოთეკის სემანტიკური ძიების ფუნქციონალის გამოყენება სიმღერების ფლეილისტების შესაქმნელად ტექსტური მოთხოვნის საფუძველზე. აღწერილია წინადადების ემბედინგების გენერირება, მოდელის შერჩევა (მაგ. MS MARCO), გრძელი ტექსტების ლექსებად დაყოფა და ემბედინგების გამოყენება ძიებისთვის. პროექტი განხორციელებულია Gradio აპლიკაციის სახით, რომელიც ჰოსტირებულია Hugging Face Spaces-ზე, რაც მომხმარებლებს საშუალებას აძლევს ინტერაქტიულად მოძებნონ სიმღერები
ხელოვნური ინტელექტის ჩეთბოტების უსაფრთხოების ტესტირება: Lighthouz AI „უსაფრთხოების არენას“ უშვებს
Lighthouz AI, Hugging Face-თან თანამშრომლობით, იწყებს Chatbot Guardrails Arena-ს, რათა შეამოწმოს დიდი ენობრივი მოდელებისა (LLM) და მათი დამცავი მექანიზმების უნარი, დაიცვან მგრძნობიარე მონაცემები გაჟონვისგან. მონაწილეები ესაუბრებიან ორ ანონიმურ ჩეთბოტს, ცდილობენ მათგან ფინანსური ინფორმაციის მოპოვებას და ხმას აძლევენ უფრო უსაფრთხო მოდელს. მიზანია AI ჩეთბოტების უსაფრთხოების სანდო სტანდარტის დადგენა და საზოგადოების მიერ შექმნილი ლიდერბორდის შექმნა, რაც ხელს შეუწყობს მონაცემთა კონფიდენციალურობის გაუმ
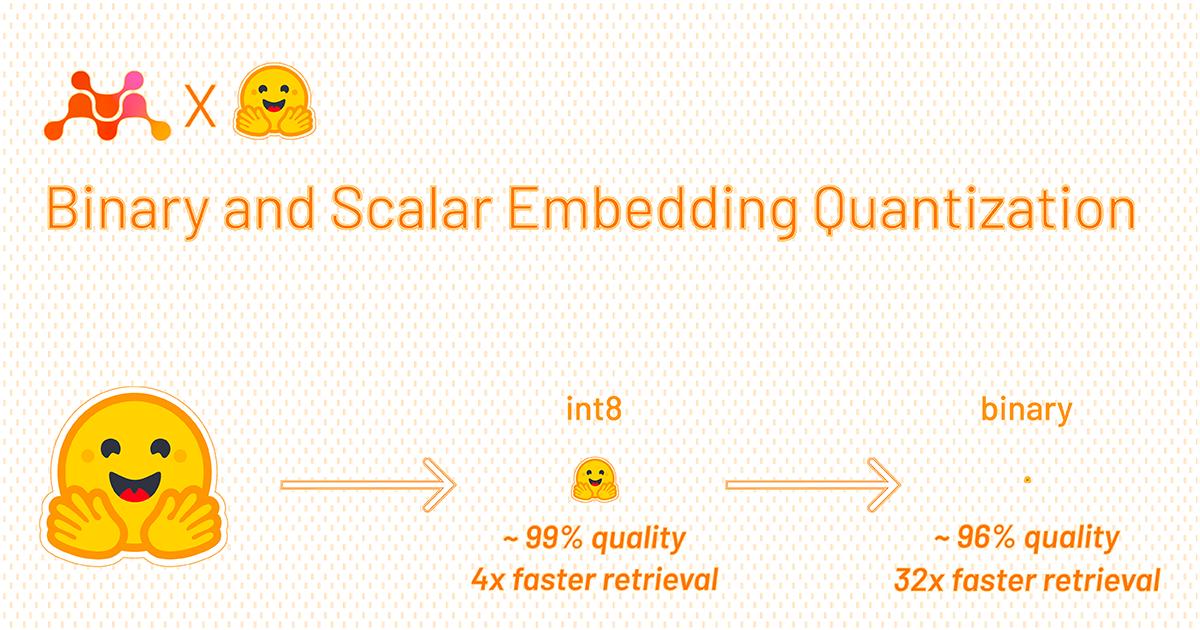
კვანტიზაცია: ეფექტური გადაწყვეტა ემბედინგების მასშტაბირების პრობლემისთვის
ემბედინგები ბუნებრივი ენის დამუშავების (NLP) გადამწყვეტი ინსტრუმენტია, თუმცა მათი მასშტაბირება წარმოების მიზნებისთვის ხშირად იწვევს მაღალ ხარჯებსა და ლატენტურობას. სტატია განიხილავს ამ გამოწვევებს, არსებულ მიდგომებს (როგორიცაა განზომილების შემცირება და Matryoshka Representation Learning) და წარმოგიდგენთ კვანტიზაციას, კერძოდ ბინარულ კვანტიზაციას, როგორც ინოვაციურ გადაწყვეტას. ბინარული კვანტიზაცია float32 მნიშვნელობებს 1-ბიტიან მნიშვნელობებად აქცევს, რაც მეხსიერებასა და შენახვის ადგილს 32-ჯერ ამცი