Panel: Python ბიბლიოთეკა მძლავრი აპლიკაციების მარტივად შესაქმნელად
Panel არის ღია წყაროს Python ბიბლიოთეკა, რომელიც დეველოპერებს საშუალებას აძლევს, სრულად Python-ზე შექმნან მძლავრი ხელსაწყოები, დაფები (dashboards) და კომპლექსური აპლიკაციები. ის გთავაზობთ მდიდარ ეკოსისტემას და მოქნილ API-ებს სწრაფი და ინტერაქტიული აპლიკაციების ასაშენებლად.
Bamba-9B: ახალი ჰიბრიდული Mamba2 მოდელი გაუმჯობესებული ეფექტურობით და ღია წყაროს ხელმისაწვდომობით
წარმოგიდგენთ Bamba-9B-ს, დასკვნის ეფექტურობაზე ორიენტირებულ ჰიბრიდულ Mamba2 მოდელს, რომელიც შემუშავებულია IBM-ის, პრინსტონის, CMU-სა და UIUC-ის მიერ, სრულად ღია მონაცემებზე. მოდელი უზრუნველყოფს 2.5-ჯერ გამტარუნარიანობის გაუმჯობესებას და 2-ჯერ შეყოვნების შემცირებას სტანდარტულ ტრანსფორმერებთან შედარებით და დაუყოვნებლივ ხელმისაწვდომია საზოგადოებისთვის ექსპერიმენტებისთვის სხვადასხვა პოპულარულ ბიბლიოთეკაში. მისი მიზანია KV-ქეშის შეზღუდვების დაძლევა და Mamba არქიტექტურების ფართოდ დანერგვა.
Hugging Face Diffusers-ის 1 წელი: რევოლუცია AI გენერაციულ მოდელებში
Hugging Face-ის მიზანია კარგი მანქანური სწავლების დემოკრატიზაცია ღია და ეთიკური ხელოვნური ინტელექტის მომავლის შესაქმნელად. ამ მიზნით შეიქმნა 🤗 Diffusers ბიბლიოთეკა, რომელიც ყველას საშუალებას აძლევს, ექსპერიმენტი ჩაატაროს „ტექსტიდან გამოსახულებამდე“ მოდელებით. როგორც მოდულური ხელსაწყოების ყუთი, Diffusers 1 წლის გახდა და ამ პერიოდში, საზოგადოების დახმარებით, მას მრავალი მნიშვნელოვანი ფუნქცია დაემატა. მათ შორისაა გამოსახულების ხარისხის გაუმჯობესება DeepFloyd IF-ისა და Stability AI SDXL-ის მოდელებით
Hugging Face-ის Diffusers ბიბლიოთეკა 1 წლის ხდება: ინოვაციები და ღია ხელოვნური ინტელექტის მომავალი
Hugging Face-ის Diffusers ბიბლიოთეკა, რომელიც მიზნად ისახავს მანქანური სწავლების დემოკრატიზაციას და ეთიკური ხელოვნური ინტელექტის განვითარებას, 1 წლის გახდა. ამ ხნის განმავლობაში, საზოგადოების დახმარებით, ბიბლიოთეკას დაემატა უმნიშვნელოვანესი ფუნქციები, მათ შორის გაუმჯობესებული ტექსტი-გამოსახულებად გენერაცია (DeepFloyd IF, SDXL), ტექსტი-ვიდეოდ და ტექსტი-3D-დ გარდაქმნის შესაძლებლობები, გამოსახულების რედაქტირების ახალი მეთოდები, მნიშვნელოვანი ოპტიმიზაციები სიჩქარისთვის და უსაფრთხოების მექანიზმები არ
TimmWrapper: PyTorch-ის გამოსახულების მოდელების ინტეგრაცია Hugging Face Transformers-თან
TimmWrapper წარმოადგენს ინსტრუმენტს, რომელიც აერთიანებს PyTorch Image Models (timm) ბიბლიოთეკას Hugging Face transformers-თან. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს გამოიყენონ timm-ის თანამედროვე კომპიუტერული ხედვის მოდელების ფართო კოლექცია transformers-ის ეკოსისტემაში. ის უზრუნველყოფს ისეთ ფუნქციებს, როგორიცაა pipeline API-ის გამოყენება, Auto Classes, კვანტიზაცია და მოქნილი წვრილი მორგება (LoRA-ს ჩათვლით) ნაცნობი Trainer API-ის მეშვეობით. TimmWrapper ავსებს ამ ორ მძლავრ ბიბლიოთეკას შორი
HfAgent: ხელოვნური ინტელექტის ინტეგრაცია მარტივად და უსაფრთხოდ
HfAgent ბიბლიოთეკა, რომელიც ხელოვნური ინტელექტის შესაძლებლობებს ადვილად აერთიანებს თქვენს პროექტებში, გთავაზობთ მარტივ ინსტალაციასა და გამოყენებას. ის საშუალებას გაძლევთ შეასრულოთ ტექსტური ბრძანებები, წარმოქმნათ და შეაფასოთ კოდი. სტატია ასევე ყურადღებას ამახვილებს უსაფრთხოების რისკებზე თვითნებური კოდის შესრულებისას, გვირჩევს უსაფრთხო მეთოდებს და განმარტავს LLM-ისა და ხელსაწყოების მორგების ვარიანტებს, მათ შორის ფაილების შეყვანის შესაძლებლობას.
Hugging Face-მა გამოუშვა pytorch_block_sparse: ახალი ინსტრუმენტი ნერვული ქსელების დასაჩქარებლად და დასაპატარავებლად
კომპანია Hugging Face-მა გამოუშვა pytorch_block_sparse – გაფართოება, რომელიც მიზნად ისახავს ნერვულ ქსელებში მეჩხერი მატრიცების გამოთვლების არაეფექტურობის პრობლემის გადაჭრას. ეს ახალი ბიბლიოთეკა შესაძლებელს ხდის უფრო მცირე ზომის და სწრაფი მოდელების შექმნას, რაც მნიშვნელოვნად ამცირებს საოპერაციო ხარჯებს და აუმჯობესებს საბოლოო მომხმარებლის გამოცდილებას. ის წარმოადგენს torch.nn.Linear-ის მარტივ შემცვლელს, რომელიც იყენებს C++ CUDA შაბლონებსა და CUTLASS-ს მაღალეფექტური ბლოკ-მეჩხერი მატრიცის გამრავლები
Segmind-ის ინოვაცია: გენერაციული AI მოდელები SD-Small და SD-Tiny - უფრო სწრაფი და ეფექტური
კომპანია Segmind-მა წარმოადგინა შეკუმშული გენერაციული AI მოდელები, SD-Small და SD-Tiny, რომლებიც მნიშვნელოვნად აჩქარებენ დასკვნის გამოტანის პროცესს და ამცირებენ რესურსების მოხმარებას. Knowledge-Distillation (KD) ტექნიკით გაწვრთნილი ეს მოდელები საბაზისო მოდელებთან შედარებით 35%-ით და 55%-ით ნაკლებ პარამეტრს შეიცავს, მაგრამ გამოსახულების შედარებით ხარისხს ინარჩუნებს. წინა წელს გამოშვებულ voltaML ბიბლიოთეკასთან ერთად, რომელიც ინფერენციის სიჩქარეს 4-6-ჯერ ზრდის, ახალი მოდელები 100%-მდე მეტ სისწრაფეს
მაღალი ხარისხის მთარგმნელის ადაპტირება: გამოწვევები და პროცესი
სტატია დეტალურად აღწერს Facebook FAIR-ის WMT19-ის ახალი ამბების მთარგმნელობითი სისტემის `transformers` ბიბლიოთეკასთან ადაპტირების (porting) პროცესს. პროექტის მიზანი იყო მაღალი ხარისხის მთარგმნელის ადაპტირება, რისთვისაც თავდაპირველი სისტემის დეტალური შესწავლა გახდა საჭირო. ავტორი განიხილავს პროექტის კომპლექსურობის დაძლევას მცირე ამოცანებად დაყოფით, წინასწარ გაწვრთნილი en-ru/ru-en მოდელებთან მუშაობის უპირატესობებს და ლექსიკონების განსხვავებების (გაერთიანებული vs. ცალკეული) დამუშავების თავისებურებე
Hugging Face Hub-ის მონაცემთა ნაკრებების მეტამონაცემების გაუმჯობესება მანქანური სწავლების საშუალებით
Hugging Face Hub, როგორც მანქანური სწავლების რესურსების ცენტრალური საცავი, აუმჯობესებს მონაცემთა ნაკრებების მეტამონაცემებს ხელოვნური ინტელექტის გამოყენებით. ახალი ინიციატივის ფარგლებში, მანქანური სწავლების ალგორითმები ამოიცნობენ ენას იმ მონაცემთა ნაკრებებში, რომლებსაც არ აქვთ ენის მეტამონაცემები, ხოლო ავტომატიზებული „ბიბლიოთეკარი-ბოტები“ ამ ინფორმაციას მეტამონაცემებში დაამატებენ. ეს პროექტი მიზნად ისახავს რესურსების მოძიების გაადვილებას და Hub-ზე წარმოდგენილი ენობრივი მიკერძოებების უკეთ გაგებას.
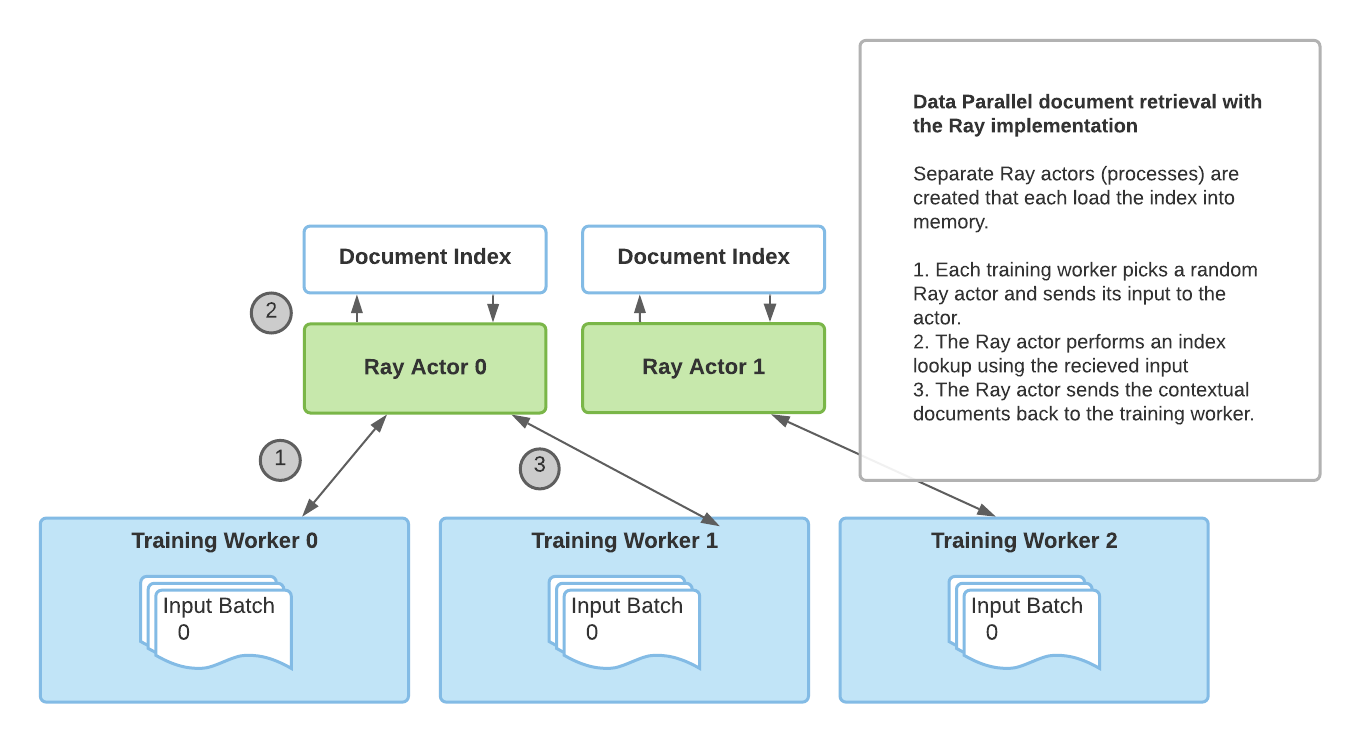
RAG მოდელების გაუმჯობესება: Ray-ის ინტეგრაცია სწრაფი განაწილებული დახვეწისთვის
სტატია მიმოიხილავს RAG (Retrieval Augmented Generation) მოდელებს, რომლებიც კონტექსტურ დოკუმენტებს გარე წყაროებიდან იძიებენ შედეგების გენერაციისთვის. ის ხაზს უსვამს დოკუმენტების მოძიების პროცესის სირთულესა და მასშტაბირებადობის გამოწვევებს `torch.distributed` იმპლემენტაციის დროს. წარმოდგენილია Ray-ზე დაფუძნებული ახალი გადაწყვეტა, რომელიც მნიშვნელოვნად აუმჯობესებს მოძიების სიჩქარესა და RAG მოდელების დახვეწის მასშტაბირებადობას Huggingface Transformers ბიბლიოთეკაში. აღწერილია Ray-ის გამოყენების უპირა
Hugging Face-მა AutoGPTQ ინტეგრირება მოახდინა Transformers-ში: ხელმისაწვდომი დიდი ენობრივი მოდელები
Hugging Face-მა თავის Transformers ბიბლიოთეკაში AutoGPTQ-ის ინტეგრირებით, დიდი მანქანური სწავლის მოდელების ხელმისაწვდომობა მნიშვნელოვნად გაზარდა. ეს მომხმარებლებს საშუალებას აძლევს, მოდელების 8-დან 2-ბიტამდე სიზუსტით კვანტიზაცია და გაშვება შეძლონ GPTQ ალგორითმის გამოყენებით, მინიმალური სიზუსტის დაკარგვით და გაუმჯობესებული წარმადობით. ინტეგრაცია ხელმისაწვდომია როგორც Nvidia, ასევე RoCm-ზე მომუშავე AMD GPU-ებისთვის, რაც LLM-ების ოპტიმიზაციას უფრო ფართო აუდიტორიისთვის ხდის შესაძლებელს.
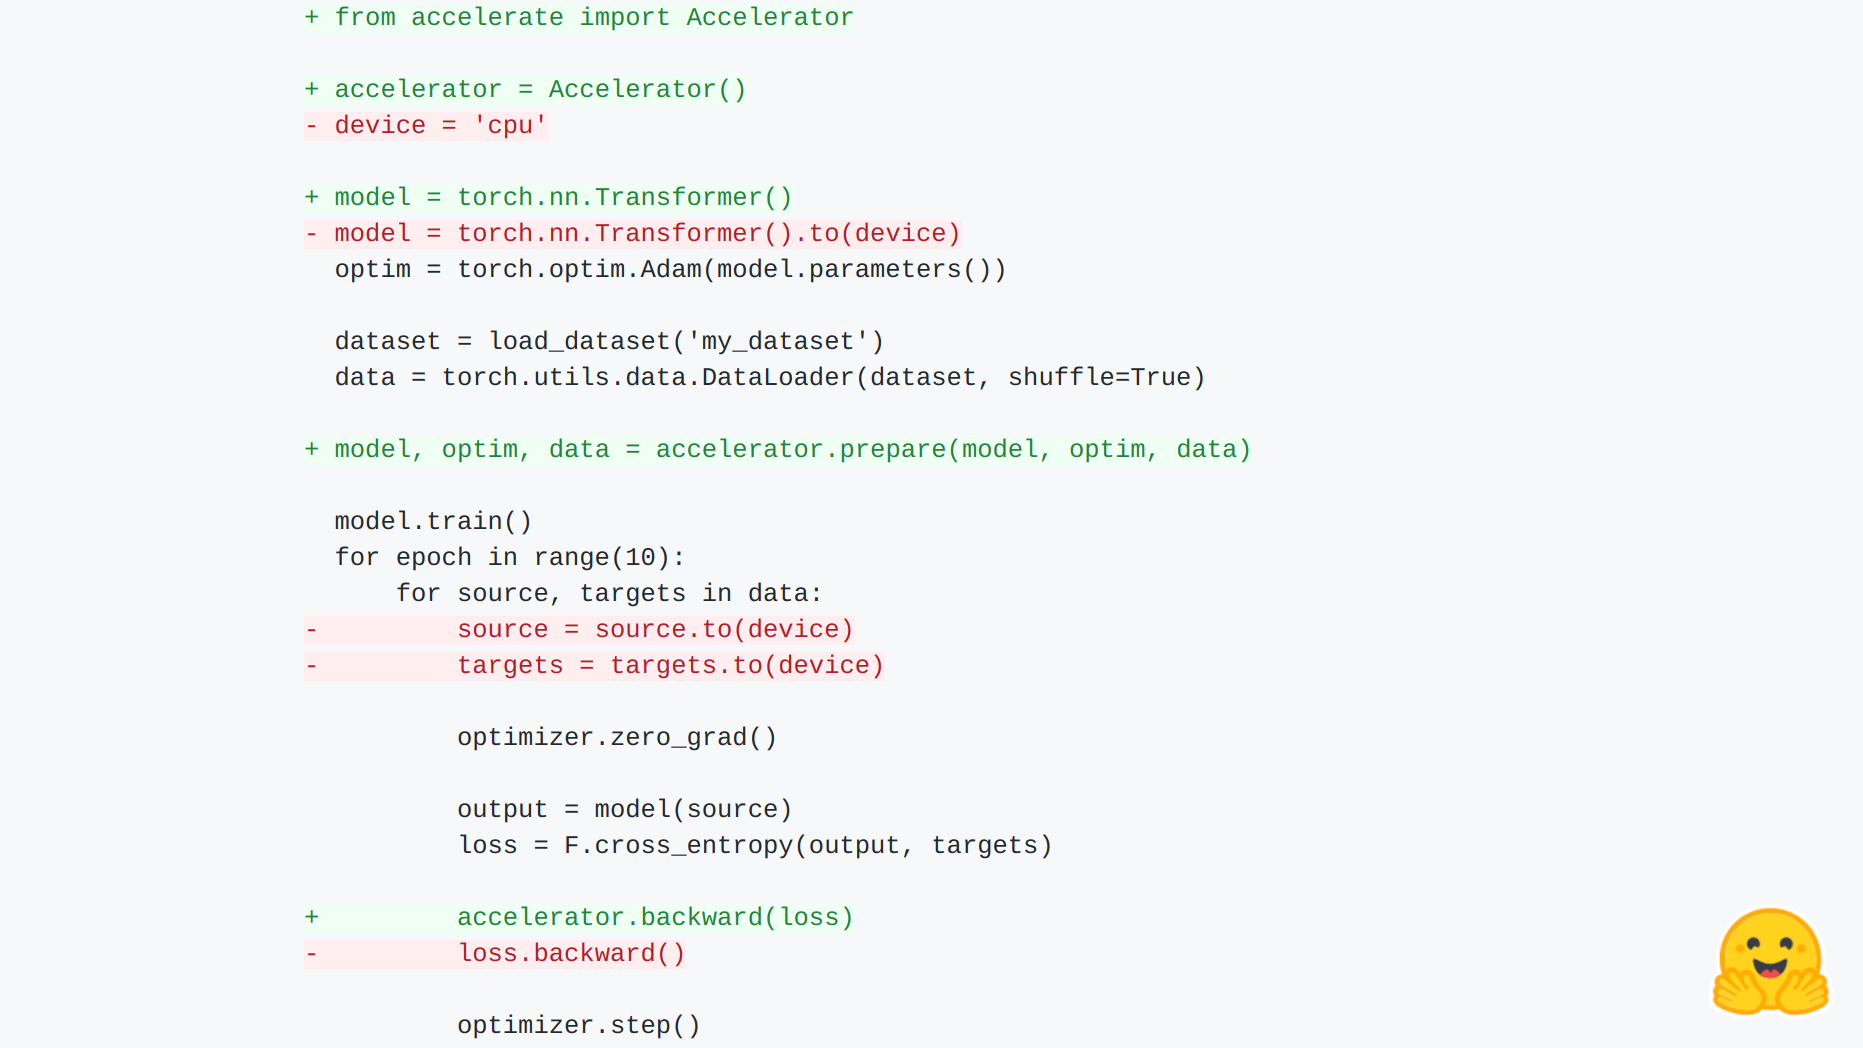
🤗 Accelerate: გაამარტივეთ PyTorch-ის განაწილებული ტრენინგი სრული კონტროლის შენარჩუნებით
🤗 Accelerate არის PyTorch-ის მომხმარებლებისთვის შექმნილი ბიბლიოთეკა, რომელიც ამარტივებს განაწილებული ტრენინგისა და შერეული სიზუსტის გამოყენებას. ის საშუალებას აძლევს მომხმარებლებს, სრულად აკონტროლონ თავიანთი სავარჯიშო ციკლები, თავიდან აიცილონ რთული შაბლონური კოდის წერა და მარტივად გაუშვან სკრიპტები სხვადასხვა მოწყობილობაზე (მრავალ-GPU, TPU) მინიმალური ცვლილებებით. ბიბლიოთეკა აბსტრაგირებს რუტინულ კოდს და უზრუნველყოფს მარტივ API-ს, რაც გაცილებით მოსახერხებელს ხდის რთული ტრენინგის კონფიგურაციებს.
Gradio 2.0: Hugging Face-ის მოდელების გამოყენება გრაფიკული ინტერფეისით კოდის მხოლოდ 1 ხაზში
Hugging Face-ის მოდელების ცენტრში ათასობით მანქანური სწავლების მოდელია ხელმისაწვდომი. Gradio-ს ბიბლიოთეკა დეველოპერებს უკვე აძლევდა საშუალებას, მარტივად შეექმნათ დემოები. ახლა, Gradio 2.0-ით, Hugging Face-ის თითქმის ნებისმიერი მოდელის ჩატვირთვა და გრაფიკული ინტერფეისით (GUI) გამოყენება კოდის მხოლოდ 1 ხაზშია შესაძლებელი. ეს სიახლე მნიშვნელოვნად ამარტივებს ხელოვნური ინტელექტის მოდელების ხელმისაწვდომობას როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის და ხსნის ახალ შესაძლებლობებს კომპლექსური
მოდელების კვანტიზაცია: bitsandbytes-ისა და GPTQ-ის შედარება
ეს სტატია განიხილავს მოდელების კვანტიზაციის ორ ძირითად მიზანს და `transformers` ბიბლიოთეკაში ინტეგრირებულ ორ ძირითად სქემას: `bitsandbytes`-ს და `auto-gptq`-ს. მოცემულია თითოეული მეთოდის დადებითი და უარყოფითი მხარეები, საზოგადოების გამოხმაურების საფუძველზე. ასევე წარმოდგენილია ინფერენციისა და ადაპტერების დაზუსტების ბენჩმარკები სხვადასხვა აპარატურაზე, რაც მომხმარებლებს დაეხმარება ოპტიმალური მიდგომის არჩევაში.
მოდელების კვანტიზაცია: Bitsandbytes-ისა და GPTQ-ის შედარებითი ანალიზი
სტატია განიხილავს ხელოვნური ინტელექტის მოდელების კვანტიზაციის ორ ძირითად მეთოდს, bitsandbytes-სა და auto-gptq-ს, რომლებიც მშობლიურად არის მხარდაჭერილი Transformers ბიბლიოთეკაში. წარმოდგენილია თითოეული მეთოდის უპირატესობები და ნაკლოვანებები, მათ შორის გამოყენების სიმარტივე, კროს-მოდალური თავსებადობა, ადაპტერების ინტეგრაცია, ტექსტის გენერირების სიჩქარე, სერიალიზაციის შესაძლებლობები და ტექნიკური შეზღუდვები. მოცემულია ბენჩმარკის შედეგები ინფერენსისა და ადაპტერების დახვეწის წარმადობის შესადარებლად სხ
Hugging Face spaCy-ის ინტეგრაციით მოდელების გაზიარებასა და გამოყენებას ამარტივებს
Hugging Face-მა და spaCy-იმ განახორციელეს ინტეგრაცია, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ, დააყენონ და გამოიყენონ spaCy-ის კონვეიერები და მოდელები. ახალი ფუნქციონალი მოიცავს ავტომატურ მეტამონაცემების გენერაციას, დასკვნის (Inference) API-ს NER-ისთვის (Named Entity Recognition), ბრაუზერში ინტერაქტიულ ტესტირებას, `pip install`-ის მხარდაჭერას და `spacy-huggingface-hub` ბიბლიოთეკას მოდელების სწრაფი გაზიარებისთვის. ხელმისაწვდომია 60-ზე მეტი კანონიკური მოდელი, და მალე დაემატება ტექსტ
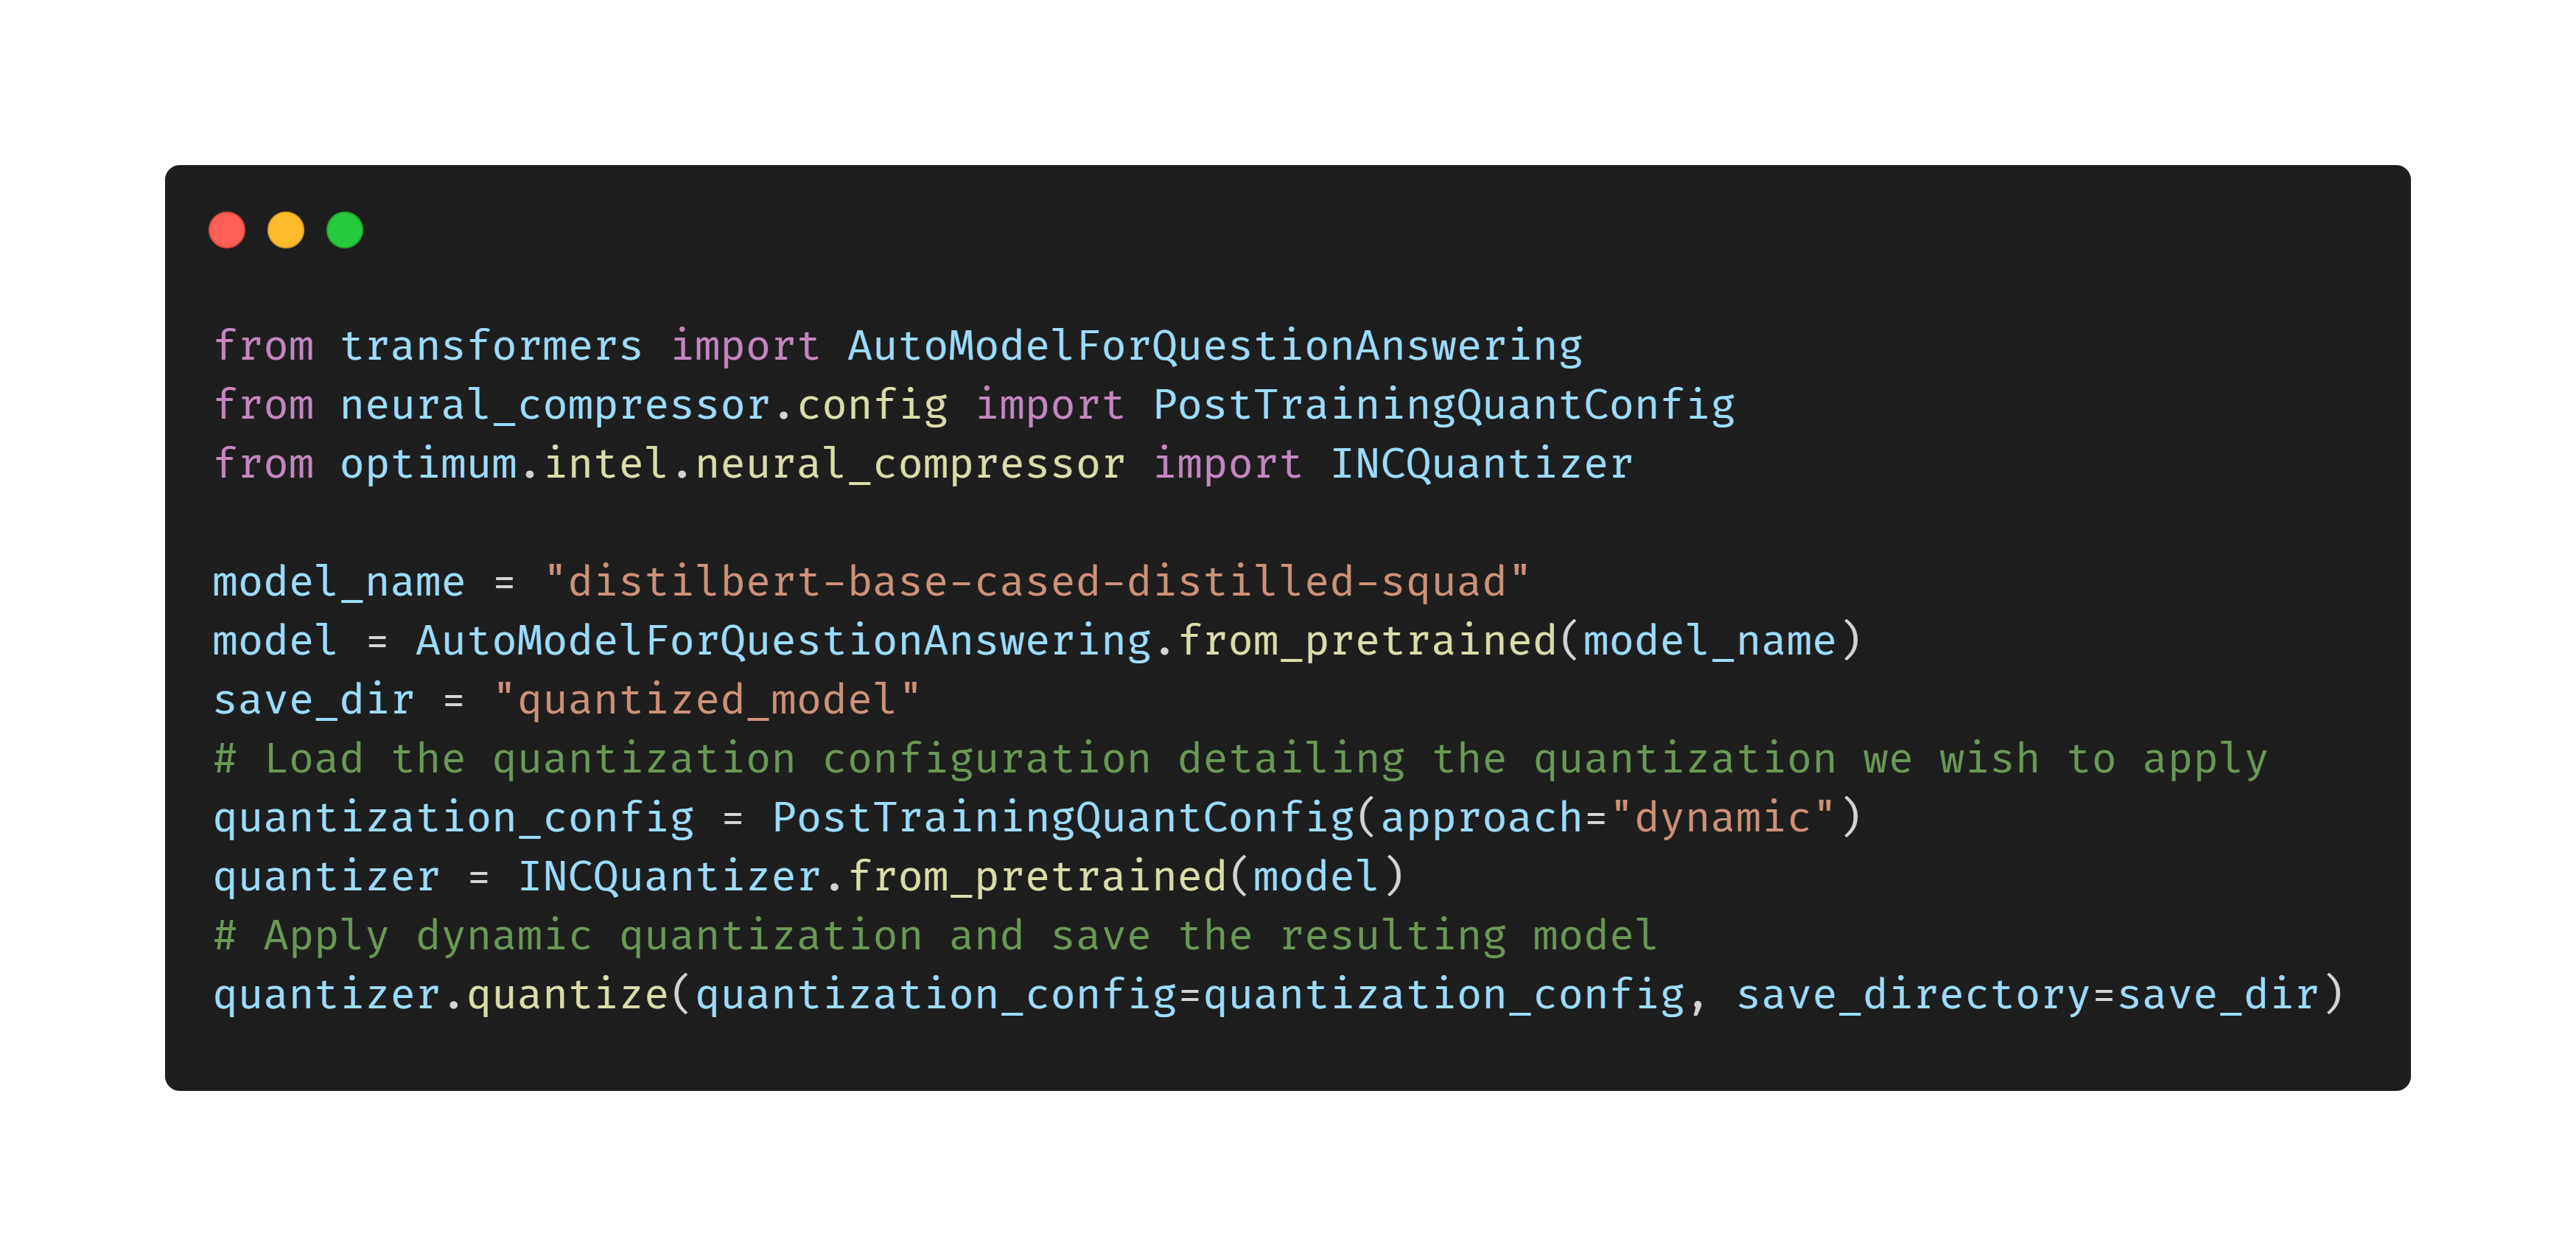
ტრანსფორმერული მოდელები წარმოებაში: გამოწვევები და Optimum-ის გადაწყვეტა
ტრანსფორმერული მოდელები, რომლებიც თანამედროვე ხელოვნური ინტელექტის განუყოფელი ნაწილია, ფართოდ გამოიყენება ტექნოლოგიური გიგანტების მიერ ისეთ სფეროებში, როგორიცაა ავტოპილოტი, ენის დამუშავება და ვიზუალური ამოცნობა. თუმცა, ამ მასიური მოდელების ეფექტურად წარმოებაში დანერგვა სერიოზულ გამოწვევებს აწყდება, განსაკუთრებით იმ გუნდებისთვის, რომლებსაც არ გააჩნიათ შეუზღუდავი რესურსები. Hugging Face-ის ახალი ღია კოდის ბიბლიოთეკა Optimum, Intel® Neural Compressor-თან თანამშრომლობით, მიზნად ისახავს ამ პროცესის გ

FastRTC: ახალი Python ბიბლიოთეკა რეალურ დროში AI აუდიო და ვიდეო აპლიკაციებისთვის
მიუხედავად ხელოვნური ინტელექტის მოდელებისა და დაფინანსების მხრივ სწრაფი განვითარებისა, რეალურ დროში AI აპლიკაციების შექმნა, რომლებიც აუდიო და ვიდეო ნაკადებს ამუშავებენ, განსაკუთრებით Python-ში, კვლავ სირთულეებთანაა დაკავშირებული. FastRTC, ახალი კომუნიკაციის ბიბლიოთეკა Python-ისთვის, შექმნილია სწორედ ამ პროცესის გასამარტივებლად, რაც დეველოპერებს საშუალებას აძლევს მარტივად ააწყონ რეალურ დროში აუდიო და ვიდეო AI აპლიკაციები მხოლოდ Python-ის გამოყენებით.
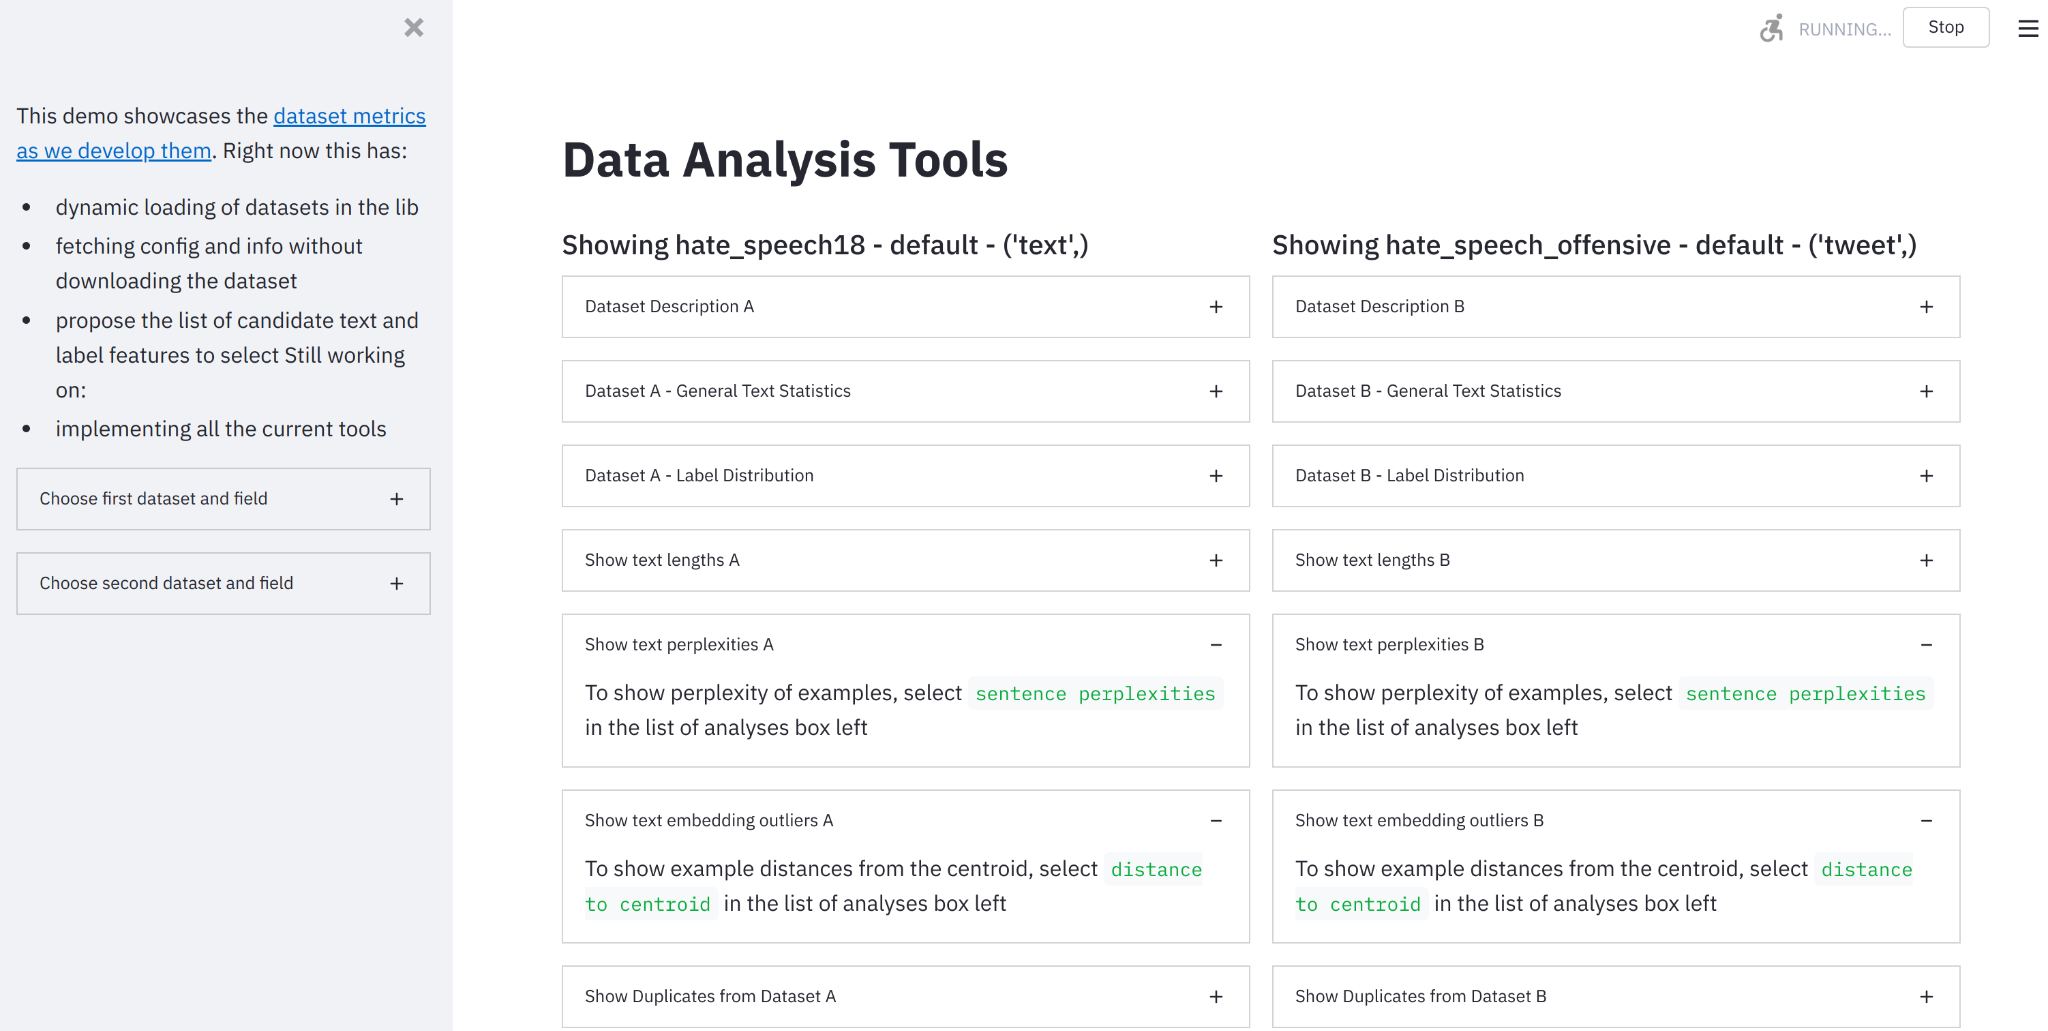
Hugging Face წარმოგიდგენთ მონაცემთა გაზომვის ხელსაწყოს AI მონაცემთა პასუხისმგებლიანი განვითარებისთვის
Hugging Face-ის გუნდმა გამოუშვა ღია კოდის Python ბიბლიოთეკა და უკოდო ინტერფეისი, სახელწოდებით „მონაცემთა გაზომვის ხელსაწყო“ (Data Measurements Tool - DMT). ეს ინსტრუმენტი მიზნად ისახავს მანქანური სწავლების მონაცემთა ნაკრებების გაგებას, შექმნას, კურირებასა და შედარებას. DMT პასუხობს ხელოვნური ინტელექტის განვითარებაში მონაცემთა გააზრებული ანალიზის ხარვეზს, განსაკუთრებით „დიდი მონაცემების“ გამოყენებისას არსებულ მიკერძოებებსა და ხარვეზებს. ის მომხმარებლებს საშუალებას აძლევს ავტომატურად გამოთვალონ მნ
Gradio-lite: Gradio აპლიკაციების გაშვება პირდაპირ ბრაუზერში Pyodide-ით
Gradio-lite არის JavaScript ბიბლიოთეკა, რომელიც საშუალებას გაძლევთ გაუშვათ Gradio აპლიკაციები პირდაპირ ვებ ბრაუზერში, Pyodide-ის გამოყენებით (Python runtime WebAssembly-ისთვის). ეს გამორიცხავს სერვერის ინფრასტრუქტურის საჭიროებას, ამარტივებს დეპლოიმენტს, ამცირებს ხარჯებს და უზრუნველყოფს სწრაფ ინტერაქციასა და მონაცემთა დაცვას. სტატიაში აღწერილია Gradio-lite-ის ძირითადი ფუნქციები, აპლიკაციის შექმნა, მრავალფაილიანი პროექტებისა და დამატებითი მოთხოვნების მართვა. განხილულია მისი უპირატესობები, როგორიცა
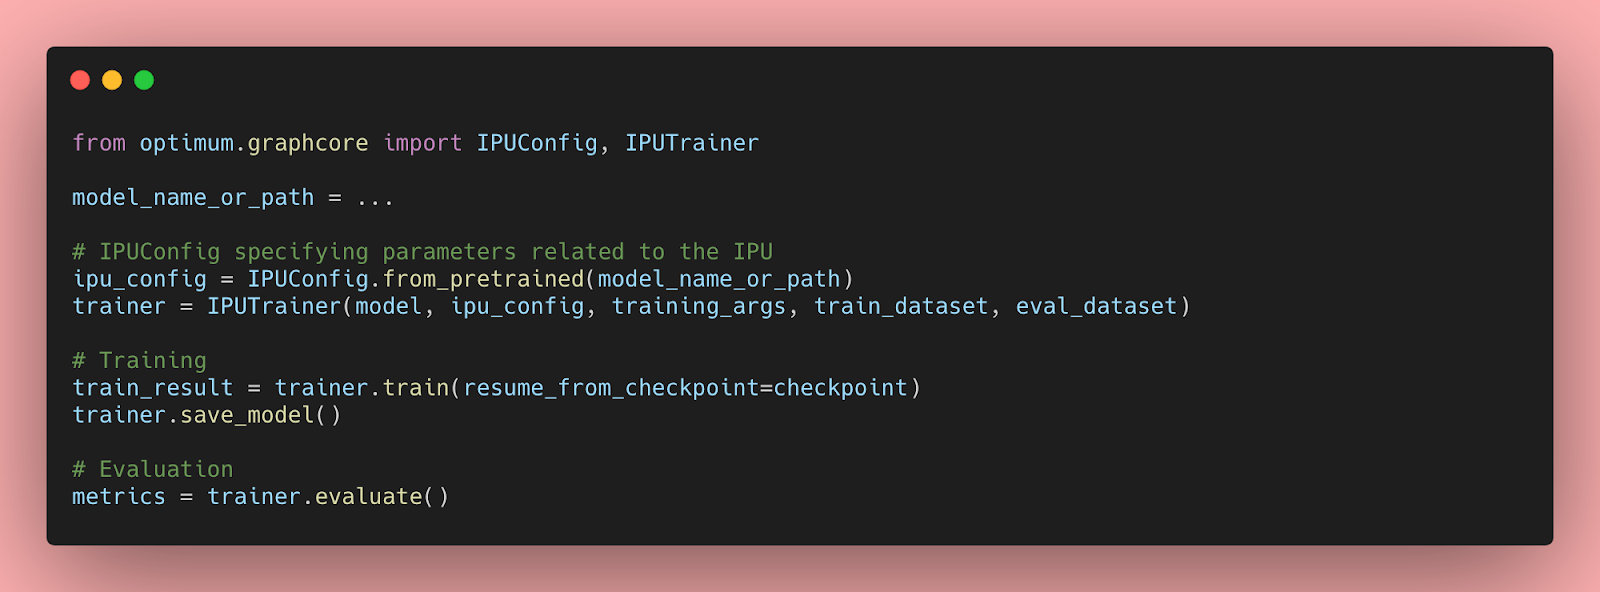
Transformer მოდელების აჩქარება Graphcore IPU-ებზე Hugging Face Optimum-ით
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. Graphcore-სა და Hugging Face-ის პარტნიორობის ფარგლებში, ახლა წარმოდგენილია BERT, როგორც პირველი IPU-ზე ოპტიმიზებული მოდელი, რომელიც განკუთვნილია Graphcore-ის ინტელექტუალური დამუშავების ერთეულისთვის (IPU). ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ Optimum და IPU-ები BERT მოდელების მარტივად გასაწვრთნელად და დასაჩქარებლად, მ
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.