
NASA-მ „არტემის II“-ის გაშვება კიდევ გადადო, ახალ თარიღად აპრილი დასახელდა
NASA-მ კიდევ ერთხელ გადადო „არტემის II“-ის, მთვარის გარშემო ეკიპაჟიანი ფრენის მისიის გაშვება, ახალ სავარაუდო თარიღად აპრილი დასახელდა. შეფერხება გამოწვეულია SLS რაკეტის შუალედურ კრიოგენულ ამძრავ ეტაპზე ჰელიუმის ნაკადის პრობლემით, რაც აუცილებელია ძრავების გასაწმენდად და საწვავის ავზების დასაპრესად. ეს უკვე მეორე გადადებაა, მას შემდეგ რაც თებერვალში წყალბადის გაჟონვის გამო გაშვება გადაიდო. მიუხედავად იმედგაცრუებისა, NASA-ს ადმინისტრატორი ჯარედ აიზეკმანი აცხადებს, რომ პროგრამა „აპოლოს“ მიღწევებს გა

Google-ის Gemini 3.1 Pro: ხელოვნური ინტელექტის რბოლა ინტენსიურდება
Google-მა წარმოადგინა Gemini 3.1 Pro, ხელოვნური ინტელექტის ახალი მოდელი, რომელიც ორიენტირებულია კომპლექსურ, მრავალსაფეხურიან ამოცანებზე, როგორიცაა მსჯელობა, კოდირება და კვლევა, რითაც ის დიფერენცირდება ჩვეულებრივი ჩეთბოტებისგან. ეს გაშვება Google-ის AI სტრატეგიის ნაწილია, რომელიც მიზნად ისახავს ხელოვნური ინტელექტის ინტეგრირებას ძირითად ინფრასტრუქტურასა და სერვისებში (Workspace, Cloud). სტატიაში განიხილება მოდელის რეალური გამოყენების ეფექტურობა, მზარდი კონკურენცია (OpenAI, Anthropic) და მაღალი რის

ინდურმა AI ლაბორატორიამ „სარვამმა“ ახალი დიდი ენობრივი მოდელები წარადგინა, კონკურენციას უწევს გლობალურ გიგანტებს
ინდურმა ხელოვნური ინტელექტის ლაბორატორიამ Sarvam-მა წარმოადგინა ახალი თაობის დიდი ენობრივი მოდელები, მათ შორის 30-მილიარდიანი და 105-მილიარდიანი პარამეტრების მოდელები. კომპანია ფსონს დებს მცირე, ეფექტურ ღია კოდის AI მოდელებზე, რათა დაეუფლოს ბაზრის წილს უფრო ძვირი ამერიკული და ჩინური სისტემებისგან. ეს გაშვება შეესაბამება ინდოეთის მიზანს, შეამციროს დამოკიდებულება უცხოურ AI პლატფორმებზე და მოარგოს მოდელები ადგილობრივ ენებსა და გამოყენების შემთხვევებს, რეალურ დროში აპლიკაციების მხარდაჭერით.

LeMaterial-ის გაშვება: ღია კოდის კოლაბორაციული პროექტი მასალების კვლევისთვის Entalpic-ისა და Hugging Face-ისგან
Entalpic-ისა და Hugging Face-ის მიერ ინიცირებული ღია კოდის კოლაბორაციული პროექტი LeMaterial ამოქმედდა, რომლის მიზანია მასალების კვლევის გამარტივება და დაჩქარება. პროექტი ხელს შეუწყობს მანქანური სწავლების მოდელების გაწვრთნას, ახალი მასალების იდენტიფიცირებას და ქიმიური სივრცეების შესწავლას. პირველ ეტაპზე გამოვიდა LeMat-Bulk მონაცემთა ნაკრები, რომელიც აერთიანებს, ასუფთავებს და სტანდარტიზაციას უკეთებს წამყვან მონაცემთა ბაზებს (Materials Project, Alexandria, OQMD), ქმნის 6.7 მილიონი ჩანაწერისა და 7 მ

ახალი მეთოდი სტატიკური ემბედინგის მოდელების საწვრთნელად: 100-400-ჯერ უფრო სწრაფი CPU-ზე
ეს ბლოგპოსტი წარმოგიდგენთ მეთოდს სტატიკური ემბედინგის მოდელების საწვრთნელად, რომლებიც CPU-ზე 100-400-ჯერ უფრო სწრაფად მუშაობენ, ვიდრე უახლესი მოდელები, ხარისხის უმეტესი ნაწილის შენარჩუნებით. ეს ხსნის უამრავ საინტერესო გამოყენების შესაძლებლობას, მათ შორის მოწყობილობაზე და ბრაუზერში გაშვებას, Edge Computing-ს, დაბალენერგეტიკულ და ჩაშენებულ აპლიკაციებს. ჩვენ გამოვიყენეთ ეს მიდგომა ორი უკიდურესად ეფექტური ემბედინგის მოდელის მოსამზადებლად: sentence-transformers/static-retrieval-mrl-en-v1 ინგლისური ინ
Stable Diffusion XL სამომხმარებლო აპარატურაზე: მოდელის ზომისა და მუშაობის ოპტიმიზაციის ახალი გზები
Stable Diffusion XL (SDXL) დიდი ზომის მოდელია, თუმცა მისი გაშვება უკვე შესაძლებელია 16 GB GPU RAM-ის მქონე CUDA აპარატურაზე, მათ შორის Colab-ის უფასო ვერსიაზეც. ბოლო თვეებში გაიზარდა ინტერესი ML მოდელების ადგილობრივად გაშვების მიმართ, რაც განპირობებულია კონფიდენციალურობითა და მოხერხებულობით. Apple-მა და Hugging Face-მა წარმოადგინეს SDXL-ის Core ML ვერსია, რომელიც ღია წყაროა. ნერგდება ახალი ტექნიკა – შერეული ბიტის პალეტიზაცია (mixed-bit palettization), რომელიც მნიშვნელოვნად ამცირებს მოდელის ზომას

არაბული LLM ლიდერბორდების აღზევება: გამოწვევები და ინოვაციები
არაბულენოვანი დიდი ენობრივი მოდელების (LLM) მზარდი ხელმისაწვდომობის ფონზე, 2024 წელს დაიწყო რამდენიმე სპეციალიზებული ლიდერბორდის გაშვება, რომლებმაც მნიშვნელოვნად გააუმჯობესეს არაბული ხელოვნური ინტელექტის მოდელების შეფასება. ამ ინიციატივებმა, მათ შორის Open Arabic LLM Leaderboard (OALL), Balsam Index-მა და AraGen Leaderboard-მა, გადაჭრა არსებული გამოწვევები და სწრაფად მოიპოვა პოპულარობა, გახდა რა ცენტრალური პლატფორმები არაბული AI საზოგადოებისთვის. მათ ხაზი გაუსვეს არაბული ენის უნიკალური სირთულეებ
Hugging Face-მა AutoGPTQ ინტეგრირება მოახდინა Transformers-ში: ხელმისაწვდომი დიდი ენობრივი მოდელები
Hugging Face-მა თავის Transformers ბიბლიოთეკაში AutoGPTQ-ის ინტეგრირებით, დიდი მანქანური სწავლის მოდელების ხელმისაწვდომობა მნიშვნელოვნად გაზარდა. ეს მომხმარებლებს საშუალებას აძლევს, მოდელების 8-დან 2-ბიტამდე სიზუსტით კვანტიზაცია და გაშვება შეძლონ GPTQ ალგორითმის გამოყენებით, მინიმალური სიზუსტის დაკარგვით და გაუმჯობესებული წარმადობით. ინტეგრაცია ხელმისაწვდომია როგორც Nvidia, ასევე RoCm-ზე მომუშავე AMD GPU-ებისთვის, რაც LLM-ების ოპტიმიზაციას უფრო ფართო აუდიტორიისთვის ხდის შესაძლებელს.
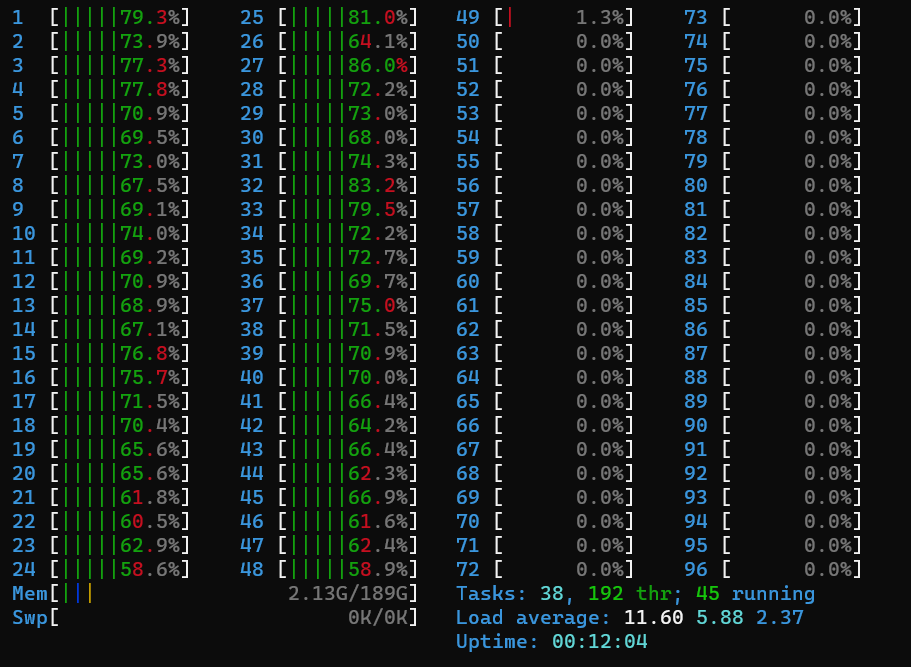
Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.
SmolVLM2: ვიდეოს გაგება ხელმისაწვდომი ხდება ყველა მოწყობილობაზე
SmolVLM2 წარმოადგენს ფუნდამენტურ ცვლილებას ვიდეოს გაგების მიდგომაში, მოძრაობს მასიური, რესურსმომთხოვნი მოდელებიდან ეფექტურ, ნებისმიერ მოწყობილობაზე გაშვებად გადაწყვეტილებებზე. მიზანია ვიდეოს გაგება ხელმისაწვდომი გახდეს ყველა მოწყობილობისთვის, ტელეფონებიდან სერვერებამდე. გამოშვებულია სამი ზომის (2.2B, 500M და 256M) მოდელი, MLX-თან თავსებადობით (Python და Swift API-ები). ეს მოდელები, მიუხედავად მცირე ზომისა, მნიშვნელოვნად აღემატება არსებულ ანალოგებს მეხსიერების მოხმარების მხრივ და ზოგიერთ შემთხვევ

VAE დეკოდირების დელეგირება დისტანციურ ენდპოინტზე: მეხსიერების ეფექტურობა მაღალი რეზოლუციის სურათებისა და ვიდეოების სინთეზისთვის
მაღალი რეზოლუციის სურათებისა და ვიდეოების გენერირებისთვის, VAE დეკოდერები ხშირად დიდ მეხსიერებას მოიხმარენ, რაც ართულებს მათ გაშვებას სამომხმარებლო GPU-ებზე. არსებული გადაწყვეტილებები, როგორიცაა offloading ან tiling, იწვევს შეფერხებებს ან ხარისხის გაუარესებას. ამ პრობლემის გადასაჭრელად, Diffusers-მა შეიმუშავა ექსპერიმენტული ფუნქცია VAE დეკოდირების დისტანციურ ენდპოინტზე დელეგირებისთვის. ეს მიდგომა ზოგავს მეხსიერებას, აუმჯობესებს პარალელურ დამუშავებას, ღია კოდის პრინციპებზეა დაფუძნებული და Hugging

მობილური AI ჩატბოტი: LLM-ების ლოკალურად გაშვება React Native-ით
ეს დეტალური გზამკვლევი აღწერს, თუ როგორ შევქმნათ React Native მობილური აპლიკაცია, რომელიც მომხმარებლებს საშუალებას აძლევს, პირადულ გარემოში, ლოკალურად ესაუბრონ ხელოვნური ინტელექტის დიდ ენობრივ მოდელებს (LLM). სტატია მოიცავს მოდელების შერჩევის კრიტერიუმებს, განვითარების გარემოს კონფიგურაციასა და აპლიკაციის საწყის ეტაპებს, `llama.rn`-ის ეფექტური გამოყენებით GGUF ფაილების ჩასატვირთად Hugging Face Hub-იდან.
Gradio-lite: Gradio აპლიკაციების გაშვება პირდაპირ ბრაუზერში Pyodide-ით
Gradio-lite არის JavaScript ბიბლიოთეკა, რომელიც საშუალებას გაძლევთ გაუშვათ Gradio აპლიკაციები პირდაპირ ვებ ბრაუზერში, Pyodide-ის გამოყენებით (Python runtime WebAssembly-ისთვის). ეს გამორიცხავს სერვერის ინფრასტრუქტურის საჭიროებას, ამარტივებს დეპლოიმენტს, ამცირებს ხარჯებს და უზრუნველყოფს სწრაფ ინტერაქციასა და მონაცემთა დაცვას. სტატიაში აღწერილია Gradio-lite-ის ძირითადი ფუნქციები, აპლიკაციის შექმნა, მრავალფაილიანი პროექტებისა და დამატებითი მოთხოვნების მართვა. განხილულია მისი უპირატესობები, როგორიცა

Gradio-ს ახალი შესაძლებლობები: LLM ინსტრუმენტების სერვერები Model Context Protocol-ით (MCP)
Gradio, პოპულარული Python ბიბლიოთეკა მანქანური სწავლების ინტერფეისებისთვის, ახლა მხარს უჭერს Model Context Protocol (MCP) სერვერების გაშვებას დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპლიკაციებს საშუალებას აძლევს ფუნქციონირებდნენ როგორც ხელსაწყოები LLM-ებისთვის, რაც მათ სთავაზობს დამატებით შესაძლებლობებს, როგორიცაა გამოსახულების გენერაცია, აუდიო სინთეზი ან კონკრეტული გამოთვლები. სტატია აღწერს, თუ როგორ შეიძლება რამდენიმე ხაზი კოდით Gradio-ს MCP სერვერად გადაქცევა და წარმოადგენს მის

Hugging Face აძლიერებს ხელოვნური ინტელექტის მოდელების გაშვებას Whisper-ის დახმარებით: საზოგადოება და ეფექტურობა ცენტრში
Hugging Face-ი თავის Inference Endpoints-ს უფრო საზოგადოებაზე ორიენტირებულს ხდის, რაც ნებისმიერს აძლევს საშუალებას, წვლილი შეიტანოს ხელოვნური ინტელექტის მოდელების ეფექტურ განლაგებაში. განსაკუთრებული ყურადღება ექცევა Whisper მოდელებს, რომელთა გაშვებაც ოპტიმიზებულია vLLM-ის, CUDA-ს გრაფიკების და დინამიური კვანტიზაციის გამოყენებით, რის შედეგადაც Whisper Large V3-ისთვის შესრულების სიჩქარე (RTFx) თითქმის 8-ჯერ იზრდება. პლატფორმა უზრუნველყოფს მარტივ განლაგებას და რეალურ დროში ტრანსკრიფციის აპლიკაციები
Hugging Face და AMD აძლიერებენ ხელოვნური ინტელექტის განვითარებას AMD GPU-ებზე
Hugging Face-ი და AMD-ი აცხადებენ მნიშვნელოვან პროგრესს AMD GPU-ებზე დიდი ენობრივი მოდელების (LLM) მხარდაჭერაში, რაც უზრუნველყოფს ტრანსფორმერული მოდელების უწყვეტ გაშვებას კოდის შეცვლის გარეშე. დამატებითი აჩქარების ინსტრუმენტები, როგორიცაა ONNX, Optimum-Benchmark და DeepSpeed, უკვე მხარდაჭერილია. კომპანიები ასევე ხელს უწყობენ დეველოპერებს PC AI კონკურსის ფარგლებში ინოვაციური AI აპლიკაციების შექმნაში AMD Ryzen AI-ით აღჭურვილ კომპიუტერებზე.

როგორ გავუშვათ მოწინავე LLM-ები ჩვეულებრივ ლეპტოპზე?
ოდესღაც შეუძლებლად მიჩნეული მაღალეფექტური დიდი ენობრივი მოდელების (LLM) გაშვება ჩვეულებრივ პერსონალურ კომპიუტერებზე დღეს უკვე რეალობაა. სტატია იკვლევს, თუ როგორ ხდის თანამედროვე ტექნოლოგიები, როგორიცაა აპარატურის აჩქარება (მათ შორის Intel Meteor Lake-ის NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია, შესაძლებელს ამ მიღწევას. განხილულია Microsoft-ის Phi-2 მოდელისა და Intel OpenVINO-ს ინტეგრაციის გამოყენება Intel Core Ultra პროცესორზე, რათა LLM-ები ეფექტურად იმუშაოს საშუალო დონის ლეპტოპებზე.
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
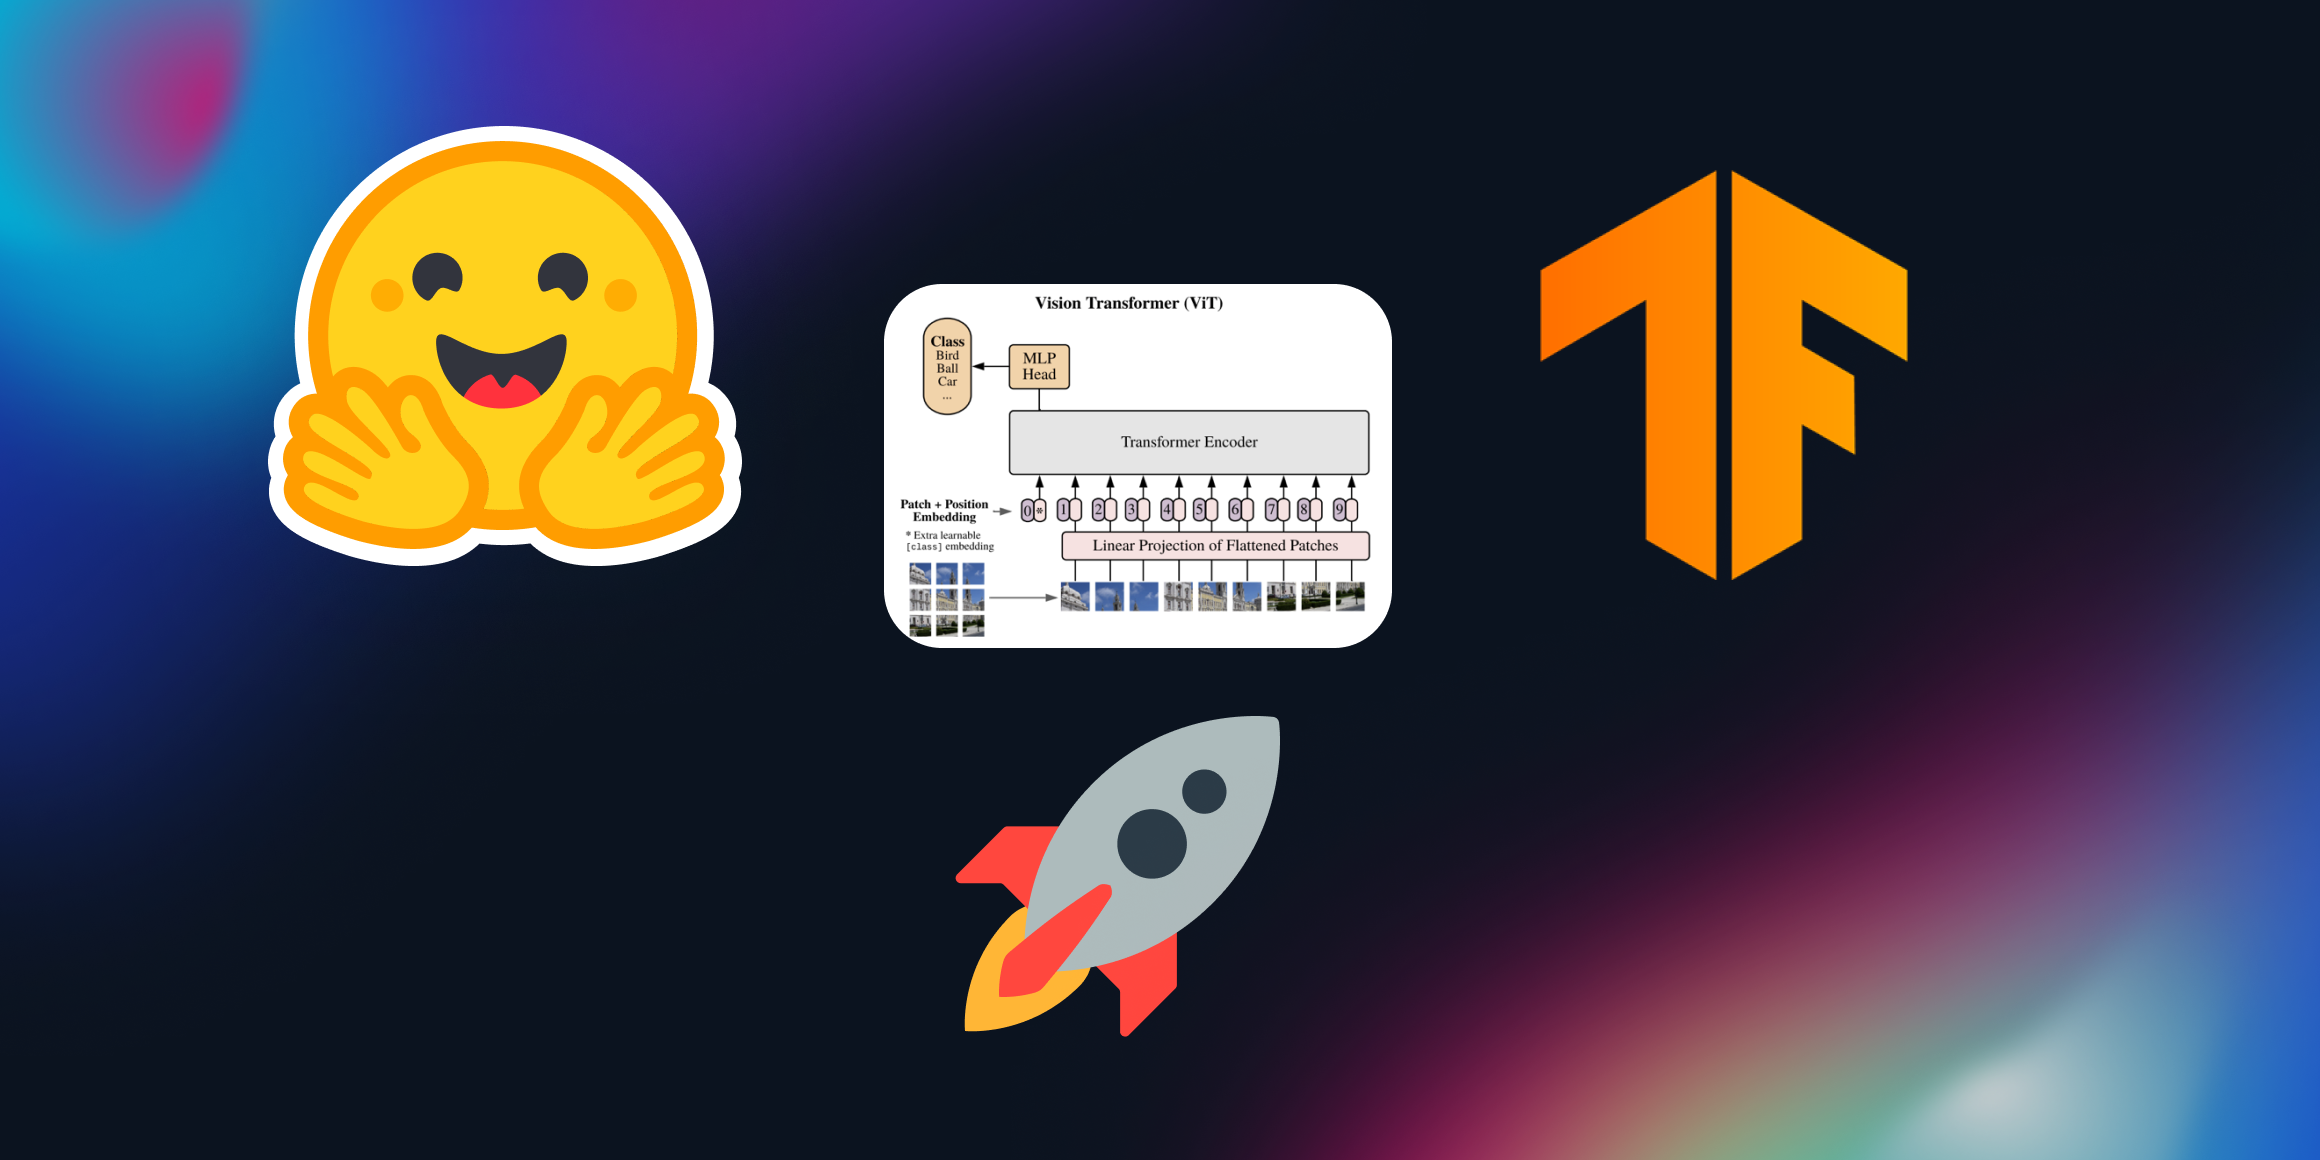
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.

Ryght Preview-ის ოფიციალური გაშვება: ხელოვნური ინტელექტი ჯანდაცვისა და სიცოცხლის მეცნიერებებისთვის
კომპანია Ryght-ი ოფიციალურად უშვებს Ryght Preview-ს, გენერაციული ხელოვნური ინტელექტის პლატფორმას, რომელიც შექმნილია ჯანდაცვისა და სიცოცხლის მეცნიერებების სექტორისთვის. პლატფორმა მიზნად ისახავს ამ სფეროებში მონაცემთა მოძველებული ანალიზის პრობლემის გადაჭრას, რაც დიდ გუნდებს მოითხოვს. Ryght უზრუნველყოფს სწრაფ და უსაფრთხო ანალიტიკურ მონაცემებს წამლის შექმნის, კლინიკური კვლევებისა და კომერციული საქმიანობის დასაჩქარებლად. კომპანია პარტნიორობს Hugging Face-თან ტექნიკური მხარდაჭერისთვის, რათა მუდმივად ი
როგორ გავუშვათ მასშტაბური ენობრივი მოდელები მომხმარებლის აპარატურაზე: Hugging Face-ის Accelerate
Meta AI-მ და BigScience-მა ცოტა ხნის წინ საჯაროდ ხელმისაწვდომი გახადეს ძალიან დიდი ენობრივი მოდელები, რომლებიც მომხმარებლის უმეტესი აპარატურის მეხსიერებაში (RAM ან GPU) არ ეტევა. Hugging Face-ის Accelerate ბიბლიოთეკა გვთავაზობს ინოვაციურ გადაწყვეტებს, მათ შორის PyTorch-ის „მეტა მოწყობილობის“ გამოყენებას და ავტომატურ მოწყობილობათა რუკას, რათა შესაძლებელი გახდეს ამ მოდელების ეფექტურად ჩატვირთვა და გაშვება შეზღუდული RAM-ისა და GPU მეხსიერების პირობებშიც კი. ეს მეთოდები საშუალებას იძლევა უზარმაზარი
Dell Enterprise Hub-ის გაშვება Hugging Face-ზე: ხელოვნური ინტელექტის მოდელების მარტივი ტრენინგი და განთავსება ადგილზე
Dell Technologies-ისა და Hugging Face-ის პარტნიორობის ფარგლებში, წარმოდგენილია Dell Enterprise Hub. ეს ახალი პლატფორმა საშუალებას აძლევს საწარმოებს, მარტივად მოამზადონ და განათავსონ ღია ხელოვნური ინტელექტის მოდელები საკუთარ ინფრასტრუქტურაზე (on-premises), Dell-ის პლატფორმების გამოყენებით. Dell Enterprise Hub მნიშვნელოვნად ამცირებს განთავსების დროს კვირებიდან წუთებამდე, უზრუნველყოფს მონაცემთა უსაფრთხოებას, კონფიდენციალურობასა და შესაბამისობას, და გთავაზობთ წვდომას უახლეს ღია მოდელებზე, როგორიცაა

Meta-მ Gaia2 წარმოადგინა: ახალი ბენჩმარკი AI აგენტებისთვის
კომპანია Meta-მ წარმოადგინა Gaia2, ახალი აგენტური ბენჩმარკი, რომელიც GAIA-ს გაგრძელებაა და მიზნად ისახავს ხელოვნური ინტელექტის აგენტების მნიშვნელოვნად უფრო რთული ქცევების ანალიზს. Gaia2 გამოვიდა Meta-ს ღია Agents Research Environments (ARE) ფრეიმვორქთან ერთად, რაც საშუალებას იძლევა აგენტების გაშვებას, გამართვას და შეფასებას რეალური სამყაროს მსგავს პირობებში. ბენჩმარკი აფასებს აგენტებს ინტერაქციულ ქცევაში, ბუნდოვანი ან დროში შეზღუდული მოთხოვნების შესრულებაში, ხმაურიან გარემოში ადაპტირებასა და ხელ

Qwen3-8B-ის რევოლუციური აჩქარება: სპეკულაციური დეკოდირება და ოპტიმიზაცია OpenVINO-თი, ლოკალური AI აგენტებისთვის
ახლახან გამოშვებული Qwen3-8B მოდელი, თავისი აგენტური შესაძლებლობებით, იდეალურია AI პერსონალური კომპიუტერებისთვის. OpenVINO.GenAI-ის მეშვეობით, სპეკულაციური დეკოდირების გამოყენებით და მსუბუქი Qwen3-0.6B დრაფტ მოდელის გამოყენებით, გენერაციის სიჩქარე 1.3-ჯერ გაიზარდა. დრაფტ მოდელის ოპტიმიზაციით ეს მაჩვენებელი 1.4-ჯერ მიაღწია. ეს გაუმჯობესებები შესაძლებელს ხდის სწრაფი, ლოკალური AI აგენტების გაშვებას, რაც მათ უფრო პრაქტიკულს ხდის Intel® Core™ Ultra პლატფორმებზე.

AI მოდელების ლოკალური გაშვება: ოპტიმიზაცია Optimum Intel-ით და OpenVINO-თი
AI მოდელების საკუთარ მოწყობილობაზე გაშვება უზრუნველყოფს გაუმჯობესებულ კონფიდენციალურობას, სიჩქარესა და სანდოობას. ეს ბლოგპოსტი აღწერს, თუ როგორ შეიძლება მცირე, ეფექტური მოდელების, როგორიცაა SmolVLM, ოპტიმიზაცია და ლოკალურად გაშვება Optimum Intel-ისა და OpenVINO-ს ინსტრუმენტების გამოყენებით, ძვირადღირებული აპარატურის გარეშე. განხილულია კვანტიზაციის მეთოდები (მხოლოდ წონების კვანტიზაცია და სტატიკური კვანტიზაცია) მეხსიერების მოხმარების შემცირებისა და ინფერენციის დაჩქარების მიზნით. ბენჩმარკები აჩვენე