
NASA-ს „არტემისის“ პროგრამაში მასშტაბური ცვლილებები: მისიების დაჩქარება და ძვირადღირებული საფეხურის გაუქმება
ნასას ადმინისტრატორმა ჯარედ აიზეკმანმა პარასკევს „არტემისის“ პროგრამაში მნიშვნელოვანი ცვლილებები გამოაცხადა, მათ შორის მისიების სიხშირის გაზრდა და ძვირადღირებული სარაკეტო საფეხურის გაუქმება. ეს გადაწყვეტილება განპირობებულია ჩინეთის მზარდი კოსმოსური პროგრამის კონკურენციით, ნასას მიერ Space Launch System (SLS) რაკეტის გამართვის სირთულეებით და სააგენტოს ნელი ტემპით ღრმა კოსმოსის მისიებში. მიზანია ოპერაციების სტანდარტიზაცია, რათა დაჩქარდეს ამერიკელი ასტრონავტების მთვარეზე დაბრუნება, რაც მოიცავს „აპო

Bluetooth 6: ახალი სტანდარტი, რომელიც თქვენს ყურსასმენებს შეცვლის
Bluetooth 6-ის მოსვლასთან ერთად, მომხმარებლებს ყურსასმენებთან დაკავშირებული მნიშვნელოვანი გაუმჯობესებები ელოდებათ. ახალი სტანდარტი გვთავაზობს დაწყვილებისა და ხელახალი დაკავშირების დაჩქარებას, შემცირებულ შეყოვნებას (latency) აუდიო-ვიდეოსა და თამაშებისთვის, ასევე მოწყობილობების ზუსტ ლოკაციას Find My Device ტექნოლოგიის გამოყენებით. ეს ყველაფერი Bluetooth მოწყობილობების გამოყენებას უფრო კომფორტულს და ეფექტურს გახდის.

ZDNET-ის სარედაქციო პრინციპები და Microsoft Excel-ში ჩამოსაშლელი სიების შექმნის გზამკვლევი
ეს სტატია განმარტავს ZDNET-ის რეკომენდაციების მიღმა არსებულ მეთოდოლოგიას, რომელიც ეფუძნება საფუძვლიან ტესტირებას, კვლევასა და დამოუკიდებელ შეფასებებს, ხაზს უსვამს სარედაქციო მიუკერძოებლობას. გარდა ამისა, მოცემულია დეტალური სახელმძღვანელო Microsoft Excel-ში ჩამოსაშლელი სიების შექმნისა და მორგების შესახებ, რაც დაგეხმარებათ მონაცემთა შეყვანის დაჩქარებასა და სისწორის გაუმჯობესებაში. სტატია მოიცავს ასევე ექსპერტულ რჩევებსა და ხშირად დასმულ კითხვებზე პასუხებს Google Sheets-სა და Excel-ის ლიმიტებთან და

OpenAI-ი Pine Labs-თან პარტნიორობს ინდოეთში ხელოვნური ინტელექტით მართული კომერციის გასაძლიერებლად
ინდოეთში ხელოვნური ინტელექტის გლობალურ ჰაბად ჩამოყალიბების ფონზე, OpenAI-მ Pine Labs-თან ითანამშრომლა, რათა AI-ზე დაფუძნებული შესაძლებლობები ფინტექ კომპანიის გადახდების სისტემაში ინტეგრირდეს. ეს ნაბიჯი მიზნად ისახავს ანგარიშსწორებისა და ინვოისების დამუშავების პროცესების ავტომატიზაციას, რაც ხელს შეუწყობს ინდოეთში ხელოვნური ინტელექტით მართული კომერციის დაჩქარებას. პარტნიორობა OpenAI-ს საშუალებას აძლევს, გააფართოვოს თავისი ყოფნა ინდოეთის მზარდ ბაზარზე და მისი ტექნოლოგია განათლებაში, ბიზნესსა და ინფ

LeMaterial-ის გაშვება: ღია კოდის კოლაბორაციული პროექტი მასალების კვლევისთვის Entalpic-ისა და Hugging Face-ისგან
Entalpic-ისა და Hugging Face-ის მიერ ინიცირებული ღია კოდის კოლაბორაციული პროექტი LeMaterial ამოქმედდა, რომლის მიზანია მასალების კვლევის გამარტივება და დაჩქარება. პროექტი ხელს შეუწყობს მანქანური სწავლების მოდელების გაწვრთნას, ახალი მასალების იდენტიფიცირებას და ქიმიური სივრცეების შესწავლას. პირველ ეტაპზე გამოვიდა LeMat-Bulk მონაცემთა ნაკრები, რომელიც აერთიანებს, ასუფთავებს და სტანდარტიზაციას უკეთებს წამყვან მონაცემთა ბაზებს (Materials Project, Alexandria, OQMD), ქმნის 6.7 მილიონი ჩანაწერისა და 7 მ
Habana Gaudi2-ის რეკორდული სისწრაფე BridgeTower-ის დახვეწისას: A100-ზე 2.5-ჯერ, H100-ზე 1.4-ჯერ სწრაფი
უახლესი კვლევის მიხედვით, Habana Gaudi2-ზე Optimum Habana v1.7-ის გამოყენებით, შესაძლებელია BridgeTower ხედვა-ენის მოდელის დახვეწის პროცესის მნიშვნელოვნად დაჩქარება. ეს მიღწევა, რომელიც A100-თან შედარებით 2.5-ჯერ, ხოლო H100-თან შედარებით 1.4-ჯერ ზრდის სისწრაფეს, ეფუძნება აპარატურულად აჩქარებულ მონაცემთა ჩატვირთვას. ეს ტექნიკები ნებისმიერ სხვა სამუშაო დატვირთვასაც ესადაგება, სადაც მონაცემთა ჩატვირთვა წარმოადგენს შეფერხებას, რაც ხედვის მოდელებისთვის ხშირია.
Hugging Face-ი და Graphcore-ი AI-ის ოპტიმიზაციისთვის პარტნიორობენ IPU-ებზე Transformer მოდელების განვითარებით
Hugging Face-ის ახალი აპარატურის პარტნიორის პროგრამა Graphcore-ის სისტემების მომხმარებელ დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ IPU-ებისთვის ოპტიმიზებული უახლესი Transformer მოდელები. ეს თანამშრომლობა მიზნად ისახავს ხელოვნური ინტელექტის აპლიკაციების დაჩქარებას, მაღალი წარმადობისა და ეფექტურობის უზრუნველყოფით ისეთ სფეროებში, როგორიცაა ბუნებრივი ენის დამუშავება (NLP), კომპიუტერული ხედვა და სხვა.

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.

ONNX Runtime Hugging Face-ის მოდელების მუშაობას აუმჯობესებს
ONNX Runtime არის კროს-პლატფორმული ინსტრუმენტი, რომელიც აჩქარებს მანქანური სწავლების მოდელებს, განსაკუთრებით ONNX-ის მხარდაჭერით. Hugging Face-ზე, ღია კოდის პლატფორმაზე, 130 000-ზე მეტი ასეთი მოდელია, მათ შორის დიდი ენობრივი (LLM) და ღრუბლოვანი მოდელები, რომლებსაც შეუძლიათ მნიშვნელოვნად გააუმჯობესონ მუშაობა ONNX Runtime-ის მეშვეობით. მაგალითად, whisper-tiny მოდელის დაჩქარება PyTorch-თან შედარებით 74.30%-მდე ეფექტურობას იძლევა. ONNX Runtime მჭიდროდ თანამშრომლობს Hugging Face-თან 90-ზე მეტი არქიტე
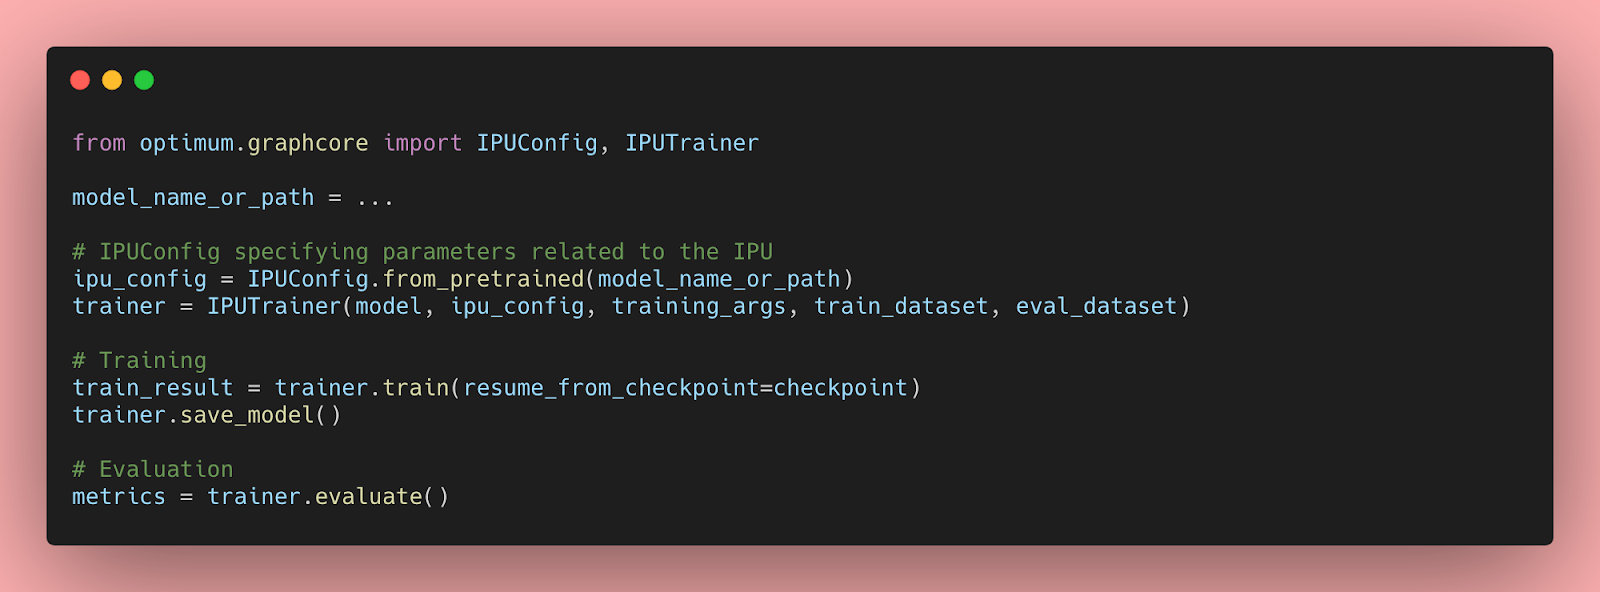
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
Stable Diffusion-ისა და SDXL-ის რევოლუციური დაჩქარება LCM LoRA-ს მეშვეობით
დღეს წარმოდგენილია ინოვაციური მეთოდი, LCM LoRA, რომელიც მნიშვნელოვნად აჩქარებს Stable Diffusion-ისა და SDXL მოდელების გამოსახულების გენერირების პროცესს. ეს სიახლე მათ თითქოს LCM დისტილაციის პროცესით დამუშავებულს ხდის და საშუალებას აძლევს SDXL მოდელებს იმუშაონ დაახლოებით 1 წამში (3090 GPU-ზე, 7 წამის ნაცვლად) ან 10-ჯერ უფრო სწრაფად Mac-ზე, რაც ხსნის ახალ შესაძლებლობებს რეალურ დროში აპლიკაციებისთვის და გამოსახულების გენერირების სამუშაო პროცესებისთვის.

BERT-ისა და ტრანსფორმერების დაჩქარება AWS Inferentia-ს მეშვეობით: სრულფასოვანი გზამკვლევი
ტრანსფორმერებზე დაფუძნებული მოდელები ხელოვნურ ინტელექტში სულ უფრო ფართოდ გამოიყენება, თუმცა მათი ზომა და სირთულე დიდმასშტაბიანი ამოცანებისთვის გამოწვევას წარმოადგენს. AWS ამ პრობლემას Inferentia ჩიპით აგვარებს, რომელიც სპეციალურად ოპტიმიზირებულია ინფერენციისთვის, უზრუნველყოფს ხარჯების 80%-მდე შემცირებას და 2.3-ჯერ მეტ გამტარუნარიანობას. ეს სტატია განმარტავს, თუ როგორ შეიძლება Hugging Face Transformers-ის, Amazon SageMaker-ისა და AWS Inferentia-ს კომბინაციით BERT-ის ინფერენციის დაჩქარება ტექსტის
Habana Labs და Hugging Face-ი თანამშრომლობენ ტრანსფორმერული მოდელების ტრენინგის დასაჩქარებლად
Habana Labs, ღრმა სწავლის პროცესორების პიონერი, და Hugging Face, ტრანსფორმერული მოდელების ცენტრალური პლატფორმა, აცხადებენ პარტნიორობის შესახებ, რომლის მიზანია მაღალი ხარისხის ტრანსფორმერული მოდელების სწავლების პროცესის გამარტივება, დაჩქარება და გაიაფება. Habana-ს SynapseAI პროგრამული პაკეტის Hugging Face Optimum-ის ღია კოდის ბიბლიოთეკასთან ინტეგრაცია საშუალებას მისცემს მონაცემთა მეცნიერებსა და მანქანური სწავლების ინჟინრებს, ეფექტურად გამოიყენონ Habana Gaudi პროცესორები, შეამცირონ ხარჯები და გაზა

Microsoft Azure-ი Hugging Face-თან თანამშრომლობას აფართოებს: 10,000-ზე მეტი AI მოდელი Azure AI Foundry-ზე
Microsoft-მა და Hugging Face-მა გააფართოვეს სტრატეგიული თანამშრომლობა, რის შედეგადაც Azure AI Foundry-ზე 10,000-ზე მეტი Hugging Face-ის ღია მოდელი გახდა ხელმისაწვდომი. ეს ინიციატივა დეველოპერებსა და საწარმოებს საშუალებას აძლევს, მარტივად განათავსონ AI აპლიკაციები ტექსტთან, აუდიოსთან და გამოსახულებებთან სამუშაოდ, ღია კოდის გამჭვირვალობისა და Azure-ის უსაფრთხო, საწარმოო დონის ინფრასტრუქტურის გამოყენებით. თანამშრომლობა მიზნად ისახავს AI-ის ინოვაციის დაჩქარებას და ორგანიზაციებს საკუთარი AI ბედის კონ

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
Hugging Face Optimum: ტრანსფორმერების მოდელების ტრენინგისა და ინფერენსის დაჩქარება
BERT-ისა და Transformer-ის მოდელების გამოყენება სულ უფრო იზრდება სხვადასხვა სფეროში, თუმცა ისინი ხშირად ნელი და მოცულობითია. Hugging Face-მა შექმნა Optimum – გაფართოება, რომელიც ამ მოდელების ტრენინგსა და ინფერენსს აჩქარებს. Optimum უზრუნველყოფს ოპტიმიზებულ შესრულებას დაჩქარებულ აპარატურაზე, მათ შორის ONNX Runtime-თან ინტეგრაციით, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გადავიდნენ სტანდარტული Transformers API-დან ოპტიმიზებულ ვერსიაზე, მოდელების კვანტიზაციისა და გრაფის ოპტიმიზაციის ჩათვლით.

Hugging Face-ის Kernel Hub: ხელოვნური ინტელექტის მოდელების მუშაობის დაჩქარება ოპტიმიზებული ბირთვებით
Hugging Face-ის ახალი Kernel Hub რევოლუციას ახდენს მანქანური სწავლების მოდელების ოპტიმიზაციაში. ის უზრუნველყოფს ცენტრალიზებულ საცავს წინასწარ კომპილირებული, მაღალეფექტური გამოთვლითი ბირთვებისთვის, რაც დეველოპერებს საშუალებას აძლევს, მარტივად ჩართონ ოპტიმიზებული კოდი სწრაფი ოპერაციებისთვის, განსაკუთრებით GPU-ებზე, რთული კომპილაციის პროცესების გარეშე. ეს დრამატულად ამარტივებს მაღალი წარმადობის მიღწევას ML პროექტებში, რაც დეველოპერებს საშუალებას აძლევს, მეტი დრო დაუთმონ მოდელების აგებას და ნაკლები
აქტორ-კრიტიკოსის მეთოდები ღრმა განმტკიცებით სწავლაში
სტატია განიხილავს აქტორ-კრიტიკოსის მეთოდებს, ჰიბრიდულ მიდგომას ღრმა განმტკიცებით სწავლაში, რომელიც აერთიანებს პოლიტიკაზე დაფუძნებულ და ღირებულებაზე დაფუძნებულ მეთოდებს. ეს მიდგომა მიზნად ისახავს ისეთი პოლიტიკის გრადიენტული ალგორითმების, როგორიცაა Reinforce, მაღალი დისპერსიის პრობლემის გადაჭრას, რაც ხელს უწყობს სწავლის სტაბილიზაციასა და დაჩქარებას. სტატია მოიცავს Advantage Actor Critic (A2C) მეთოდს და მის გამოყენებას რობოტულ გარემოში Stable-Baselines3-ის მეშვეობით.

TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო

ასინქრონული ინფერენცია რობოტებში: 2-ჯერ დაჩქარება და გაუმჯობესებული რეაგირება
რობოტიკის სფეროში დანერგილი ასინქრონული ინფერენცია მიზნად ისახავს რობოტების დავალების შესრულების სიჩქარისა და რეაგირების გაუმჯობესებას. თანმიმდევრული ინფერენციისგან განსხვავებით, რომელიც შეფერხებებს იწვევს, ეს ახალი მიდგომა მოქმედების პროგნოზირებასა და აღსრულებას ერთმანეთისგან აცალკევებს. SmolVLA მოდელში დანერგვით, ამ სისტემამ აჩვენა დავალების დასრულების დროის დაახლოებით 2-ჯერ შემცირება და რობოტი აღარასდროს ელოდება ინფერენციას, რაც უზრუნველყოფილია მაღალეფექტურ gRPC-ზე დაფუძნებული კომუნიკაციით.
SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
SetFit-ის ინფერენციის 7.8-ჯერ დაჩქარება Intel CPU-ებზე Optimum Intel-ის გამოყენებით
SetFit, ხელოვნური ინტელექტის მოდელი, რომელიც ცნობილია მცირე მარკირებული მონაცემებით მაღალი სიზუსტის მიღწევით, ახლა შესაძლებელია Intel CPU-ებზე 7.8-ჯერ უფრო სწრაფად ამუშავდეს. ეს მიიღწევა 🤗 Optimum Intel-ის ბიბლიოთეკის გამოყენებით და პოსტ-ტრენინგული კვანტიზაციით, რაც SetFit-ის გადაწყვეტილებების წარმოებაში დანერგვას საგრძნობლად აადვილებს და გამტარუნარიანობას ზრდის.
Hugging Face Hub: მანქანური სწავლების პროექტების დაჩქარება და კოლაბორაცია
სტატია განიხილავს მანქანური სწავლების (ML) განვითარების გამოწვევებს, როგორიცაა მოდელების პროდუქტიულ ფაზაში ვერ გადასვლა და თანამშრომლობის სირთულეები. წარმოდგენილია Private Hub-ისა და განსაკუთრებით Hugging Face Hub-ის როლი, როგორც ამ პრობლემების გადაწყვეტა. Hugging Face Hub გთავაზობთ ღია წყაროს პლატფორმას მოდელების, მონაცემთა ნაკრებებისა და აპლიკაციების ფართო კოლექციით, Git-ზე დაფუძნებულ რეპოზიტორიებსა და თანამშრომლობით ხელსაწყოებს ML სამუშაო პროცესების დასაჩქარებლად, კვლევიდან დაწყებული წარმოება

NVIDIA NIM ამარტივებს ხელოვნური ინტელექტის მოდელების, მათ შორის LLM-ების განთავსებას
NVIDIA NIM ინფერენციის მიკროსერვისები მომხმარებლებსა და პარტნიორებს საშუალებას აძლევს, გამარტივებული მიდგომით, სწრაფად და საიმედოდ განათავსონ ხელოვნური ინტელექტის უახლესი მოდელები, განსაკუთრებით დიდი ენობრივი მოდელები (LLM). ის მხარს უჭერს 100 000-ზე მეტ LLM-ს Hugging Face-ზე, მუშაობს ერთ Docker კონტეინერში და უზრუნველყოფს ავტომატურ ოპტიმიზაციას კონფიგურაციის გარეშე. ეს სისტემა მიზნად ისახავს AI ინოვაციების დაჩქარებას NVIDIA-ს აჩქარებულ ინფრასტრუქტურაზე, რაც დეველოპერებსა და საწარმოებს ეხმარება