HfAgent: ხელოვნური ინტელექტის ინტეგრაცია მარტივად და უსაფრთხოდ
HfAgent ბიბლიოთეკა, რომელიც ხელოვნური ინტელექტის შესაძლებლობებს ადვილად აერთიანებს თქვენს პროექტებში, გთავაზობთ მარტივ ინსტალაციასა და გამოყენებას. ის საშუალებას გაძლევთ შეასრულოთ ტექსტური ბრძანებები, წარმოქმნათ და შეაფასოთ კოდი. სტატია ასევე ყურადღებას ამახვილებს უსაფრთხოების რისკებზე თვითნებური კოდის შესრულებისას, გვირჩევს უსაფრთხო მეთოდებს და განმარტავს LLM-ისა და ხელსაწყოების მორგების ვარიანტებს, მათ შორის ფაილების შეყვანის შესაძლებლობას.
Hugging Face-მა გამოუშვა pytorch_block_sparse: ახალი ინსტრუმენტი ნერვული ქსელების დასაჩქარებლად და დასაპატარავებლად
კომპანია Hugging Face-მა გამოუშვა pytorch_block_sparse – გაფართოება, რომელიც მიზნად ისახავს ნერვულ ქსელებში მეჩხერი მატრიცების გამოთვლების არაეფექტურობის პრობლემის გადაჭრას. ეს ახალი ბიბლიოთეკა შესაძლებელს ხდის უფრო მცირე ზომის და სწრაფი მოდელების შექმნას, რაც მნიშვნელოვნად ამცირებს საოპერაციო ხარჯებს და აუმჯობესებს საბოლოო მომხმარებლის გამოცდილებას. ის წარმოადგენს torch.nn.Linear-ის მარტივ შემცვლელს, რომელიც იყენებს C++ CUDA შაბლონებსა და CUTLASS-ს მაღალეფექტური ბლოკ-მეჩხერი მატრიცის გამრავლები
ტრანსფორმერზე დაფუძნებული ენკოდერ-დეკოდერის მოდელები: არქიტექტურისა და ინფერენციის სიღრმისეული მიმოხილვა
ეს ბლოგ-პოსტი დეტალურად განმარტავს, თუ როგორ ამუშავებენ ტრანსფორმერზე დაფუძნებული ენკოდერ-დეკოდერის არქიტექტურის მოდელები მიმდევრობა-მიმდევრობაზე ამოცანებს. განხილულია მათემატიკური მოდელი და მისი გამოყენება ინფერენციაში, NLP-ში მიმდევრობა-მიმდევრობაზე მოდელების ისტორიულ კონტექსტთან ერთად. იგი ყოფს ტრანსფორმერის არქიტექტურას ენკოდერისა და დეკოდერის ნაწილებად, გვაწვდის ვიზუალურ მასალას და აკავშირებს თეორიას 🤗Transformers-ის პრაქტიკულ გამოყენებასთან. სტატია მოკლედ მიმოიხილავს ნეირონული ენკოდერ-დეკო
Stable Diffusion XL Core ML-ზე: მოდელის ზომის შემცირება და მუშაობის გაუმჯობესება
Hugging Face-ი და Apple-ი აგრძელებენ ხელოვნური ინტელექტის მოდელების ოპტიმიზაციას სამომხმარებლო მოწყობილობებზე ადგილობრივად გასაშვებად. უახლესი მცდელობა Stable Diffusion XL-ის Core ML-ზე ადაპტაციაა Apple Silicon-ის Mac-ებისთვის, რაც საშუალებას იძლევა მოდელი შემცირდეს ზომით და გაუმჯობესდეს მისი მუშაობა ინოვაციური კვანტიზაციის მეთოდებით, მათ შორის შერეული ბიტების პალეტიზაციით. პროექტი სრულად ღია კოდით არის ხელმისაწვდომი და community-ის ჩართულობას ელის.

დიდი ენობრივი მოდელების კონტექსტის ფანჯრის გამოწვევები: KV Cache-ის მეხსიერების ოპტიმიზაცია KVPress-ით
დიდი ენობრივი მოდელების (LLM) გაფართოებული კონტექსტის ფანჯრები წარმოუდგენელ შესაძლებლობებს იძლევა, თუმცა KV Cache-ის მიერ მოხმარებული მეხსიერების მართვას ართულებს. მაგალითად, 1 მილიონი ტოკენის დამუშავება Llama 3-70B-ით 330 GB-ს მოითხოვს მხოლოდ KV Cache-ისთვის. NVIDIA-ს მიერ შემუშავებული KVPress ამ პრობლემის გადასაჭრელად კომპრესიის ინოვაციურ ტექნიკას გვთავაზობს, რომელიც მეხსიერების მოხმარებას ამცირებს მოდელის სიზუსტის შენარჩუნებით.
smolagents: ვიზუალური მხარდაჭერა და აგენტური ბრაუზერი
ჩვენ smolagents-ს დავუმატეთ ვიზუალური მხარდაჭერა, რაც ხსნის ვიზუალური ენობრივი მოდელების (VLM) გამოყენების შესაძლებლობას აგენტურ პაიპლაინებში მშობლიური ინტეგრაციით. ეს სიახლე მნიშვნელოვნად აუმჯობესებს ისეთ შესაძლებლობებს, როგორიცაა ვებ-დათვალიერება, სადაც ვიზუალური კონტენტი სრულად ვერ აღდგება მხოლოდ ტექსტის ამოღებით. ეს განახლება აგენტებს ნამდვილ სუპერძალას ანიჭებს, რის შედეგადაც მათ შეუძლიათ, მაგალითად, სრულ ავტონომიაში იმოძრაონ ვებ-სივრცეში.
როგორ შევქმნათ PS1-ის სტილის 3D აქტივები გენერაციული ხელოვნური ინტელექტის გამოყენებით
ეს სტატია გთავაზობთ პრაქტიკულ სახელმძღვანელოს, თუ როგორ უნდა მოხდეს გენერაციული ხელოვნური ინტელექტის ინტეგრირება PlayStation 1-ის სტილის 3D აქტივების შექმნაში თამაშებისთვის. ის განმარტავს, თუ რატომ არის ეს სტილი იდეალური არსებული text-to-3D მოდელების დაბალი ხარისხისთვის და გვიჩვენებს ნაბიჯ-ნაბიჯ პროცესს Shap-E-სა და Blender-ის (Dream Textures-თან ერთად) გამოყენებით, ტექსტიდან გამოსაყენებელი დაბალხარისხოვანი 3D მოდელის მისაღებად. სტატია ხაზს უსვამს ამ მეთოდის პოტენციალს უსასრულო დაბალხარისხოვანი
LLM-ების კონფიდენციალურობისა და ინტელექტუალური საკუთრების დაცვა: Zama-ს გადაწყვეტა ჰომომორფული დაშიფვრით
დიდი ენობრივი მოდელების (LLM) ფართო გამოყენების მიუხედავად, მომხმარებლის მონაცემთა კონფიდენციალურობის საკითხი კვლავ გადაუჭრელ პრობლემად რჩება, რადგან არსებობს სენსიტიური ინფორმაციის LLM სერვისის მიმწოდებელთან გაჟონვის რისკი. Zama გვთავაზობს ინოვაციურ გადაწყვეტას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით, რომელიც საშუალებას აძლევს LLM-ებს, იმუშაონ დაშიფრულ მონაცემებზე. ეს მეთოდი იცავს როგორც მომხმარებლის კონფიდენციალურობას, ასევე მოდელის ინტელექტუალურ საკუთრებას, პროგნოზების ხარისხის შენარჩუ

Hugging Face აერთიანებს სერვერულ ინფერენსზე წვდომას ახალი პარტნიორობითა და ფუნქციებით
Hugging Face-მა, საკუთარი სერვერული Inference API-ის ხანგრძლივი მასპინძლობის შემდეგ, გადაწყვიტა ფოკუსირება თანამშრომლობაზე, დიდი მონაცემთა ნაკრებებისა და მოდელების შენახვაზე, ვერსიონირებასა და გავრცელებაზე. ამის პარალელურად, კომპანია მომხმარებლებს სთავაზობს მარტივ და ერთიან წვდომას სერვერულ ინფერენსზე წამყვანი პროვაიდერების მეშვეობით. ეს ნაბიჯი აძლიერებს AI მოდელების ხელმისაწვდომობას, გვთავაზობს მოქნილ ფასებს პირდაპირი და მარშრუტიზებული მოთხოვნებისთვის, და უზრუნველყოფს დამატებით ბენეფიტებს PRO მ
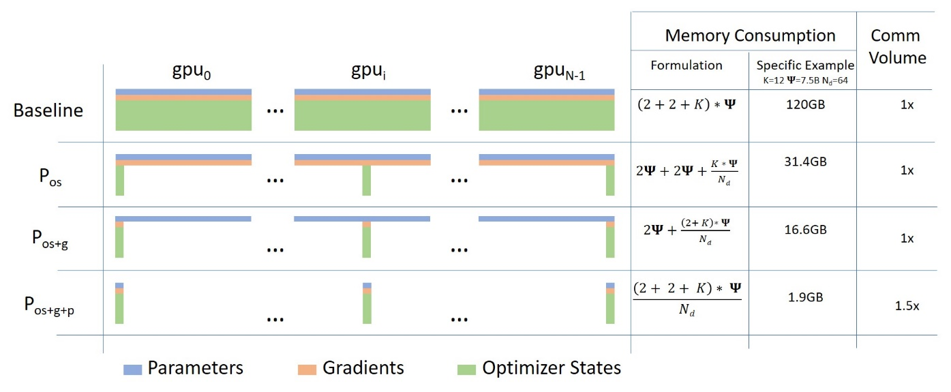
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.
მოდელების განთავსება ინფერენსის ენდპოინტებზე ქასთომ ჰენდლერების გამოყენებით: MusicGen-ის მაგალითი
ეს სტატია განმარტავს, თუ როგორ ხდება მოდელების, მათ შორის `transformers`-ის კონვეიერით პირდაპირ არმხარდაჭერილი ან არატრანსფორმერული მოდელების განთავსება Inference Endpoints-ის გამოყენებით. პროცესი მოიცავს მორგებული დასკვნის ფუნქციების, იგივე ქასთომ ჰენდლერების შექმნას, რათა შესაძლებელი გახდეს მოქნილი განთავსება. MusicGen-ის მაგალითზე დეტალურად არის აღწერილი `handler.py` და `requirements.txt` ფაილების შექმნა და ენდპოინტის კონფიგურაცია.

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ
LLM-ების ინტეგრაცია Swift აპლიკაციებში Core ML-ის გამოყენებით: დეველოპერების სახელმძღვანელო
მანქანური სწავლება (ML) პროგრამული უზრუნველყოფის შექმნის ახალ გზებს ხსნის, განსაკუთრებით Swift დეველოპერებისთვის, რომლებსაც სურთ ხელოვნური ინტელექტის ფუნქციების ინტეგრირება თავიანთ აპლიკაციებში. ეს სტატია წარმოგიდგენთ Core ML-ზე დაფუძნებულ ინსტრუმენტებსა და დეტალურ სახელმძღვანელოს, თუ როგორ უნდა გაუშვათ დიდი ენობრივი მოდელები (LLM), როგორიცაა Llama 2, Mac-ზე. პროექტი მოუწოდებს დეველოპერებს, შეერთდნენ და წვლილი შეიტანონ ამ ინიციატივის ერთობლივ გაუმჯობესებაში, რათა დააჩქარონ ხელოვნური ინტელექტის შ
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს
ნერვული ქსელების აგება და გამართვა: ჰაიპის მიღმა
სტატია მიმოიხილავს ნერვული ქსელების, მათ შორის GPT-3-ის, ირგვლივ არსებულ დიდ აჟიოტაჟს და უპირისპირებს მას ამ ტექნოლოგიების რეალურ შექმნასა და გამართვასთან დაკავშირებულ სირთულეებს. ავტორი გვთავაზობს პრაქტიკულ, სისტემატურ მიდგომას ნერვული ქსელების დიზაინისა და დებაგინგისთვის, ხაზს უსვამს მონაცემთა სიღრმისეული ანალიზის, მარტივი ბაზისური მოდელების გამოყენებისა და დეტალური ტესტირების მნიშვნელობას, განსაკუთრებით Hugging Face-ში მუშაობის გამოცდილებიდან გამომდინარე.

Adyen-ისა და Hugging Face-ის DABstep: ხელოვნური ინტელექტის მოდელების გამოწვევა მონაცემთა ანალიზში
Adyen-მა და Hugging Face-მა ერთობლივად შექმნეს DABstep – ახალი ბენჩმარკი, რომელიც 450-ზე მეტ მონაცემთა ანალიზის ამოცანას მოიცავს. მისი მიზანია ხელოვნური ინტელექტის (AI) უახლესი მოდელების შესაძლებლობების შეფასება მრავალსაფეხურიან აზროვნებაში. კვლევამ აჩვენა, რომ მიუხედავად განვითარებისა, AI აგენტები DABstep-ზე მხოლოდ 16%-იან სიზუსტეს აღწევენ, რაც მიუთითებს ამ სფეროში მნიშვნელოვანი პროგრესის საჭიროებაზე. ბენჩმარკი მოითხოვს, რომ AI მოდელებმა გამოავლინონ ტექნიკური უნარები, დომენური ცოდნა და კრეატიულ
Hugging Face AWS Marketplace-ზე: AI-ის დანერგვის გამარტივება ბიზნესისთვის
Hugging Face-ის AWS Marketplace-ზე ინტეგრაცია აადვილებს კომპანიებისთვის დიდი ენობრივი მოდელების გამოყენებას და ხელოვნური ინტელექტის (AI) დანერგვას. AWS-ის მომხმარებლებს ახლა შეუძლიათ მარტივად გამოიწერონ Hugging Face სერვისები, ხოლო გადახდები ავტომატურად აისახება მათ AWS გადასახადში. ეს ინიციატივა არა მხოლოდ ამარტივებს პროცესს, არამედ სთავაზობს დამატებით უსაფრთხოების ფუნქციებს Enterprise Hub-ის მეშვეობით, რაც ტექნოლოგიას უფრო მეტ დეველოპერსა და ბიზნესს მიაწვდის.
IDEFICS: ღია მულტიმოდალური AI მოდელი გამჭვირვალე კვლევისთვის
IDEFICS, 80 მილიარდი პარამეტრის მულტიმოდალური ხელოვნური ინტელექტის (AI) მოდელი, რომელიც Flamingo-ს ღია წყაროს რეპროდუქციას წარმოადგენს, უკვე ხელმისაწვდომია. მისი შექმნისას დიდი აქცენტი გაკეთდა გამჭვირვალობაზე, გამოყენებულ იქნა მხოლოდ საჯაროდ ხელმისაწვდომი მონაცემები და შეფასდა პოტენციური მიკერძოებები. მოდელი მიზნად ისახავს მულტიმოდალური AI სისტემების სფეროში უფრო ღია კვლევების წახალისებას და მისი დემო ვერსიები Hugging Face Hub-ზეა განთავსებული.
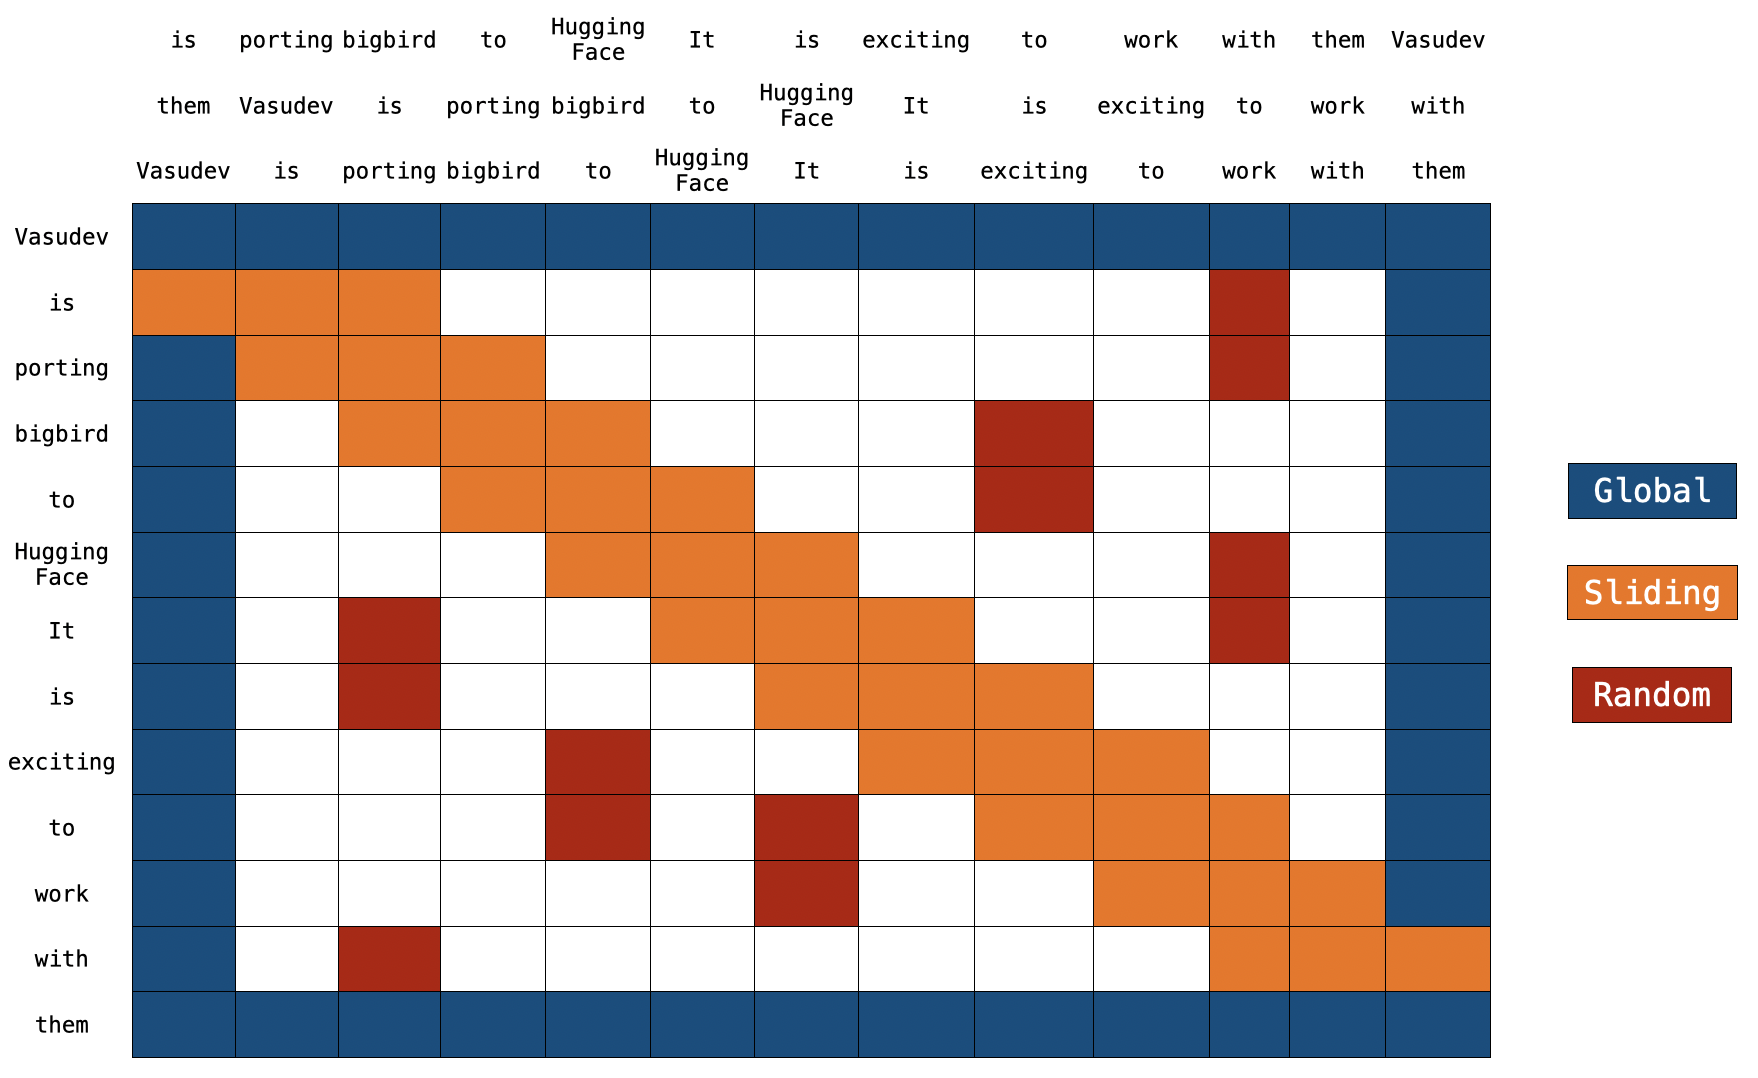
BigBird: ტრანსფორმატორების ახალი ეფექტური მიდგომა გრძელი თანმიმდევრობებისთვის
ტრანსფორმატორული მოდელები ფართოდ გამოიყენება NLP ამოცანებში, თუმცა მათი O(n^2) დროითი და მეხსიერების სირთულე ზღუდავს მათ გამოყენებას გრძელ თანმიმდევრობებზე (n > 512). BigBird, ახალი მოდელი, ამ პრობლემას ბლოკ-სპარსული ყურადღების (block sparse attention) გამოყენებით აგვარებს, რაც საშუალებას აძლევს მას დაამუშაოს თანმიმდევრობები 4096 სიგრძემდე, მნიშვნელოვნად დაბალი გამოთვლითი დანახარჯით, ვიდრე BERT. BigBird-მა მიაღწია საუკეთესო შედეგებს (SOTA) გრძელ დოკუმენტებთან დაკავშირებულ ამოცანებში, როგორიცაა შ
Hugging Face-ის ეკოსისტემაში Code Llama-ს ინტეგრაცია გამოცხადდა: პროგრამირების ახალი ეპოქა
Code Llama, Llama 2-ის საფუძველზე შექმნილი კოდზე სპეციალიზებული ხელოვნური ინტელექტის მოდელების ოჯახი, Hugging Face-ის ეკოსისტემაში ინტეგრირდა. ის პროგრამისტების პროდუქტიულობის გაზრდას ისახავს მიზნად კოდის შევსებით, დოკუმენტაციის გენერირებით და ერთეული ტესტების შექმნით. მოდელები ხელმისაწვდომია 7B, 13B და 34B პარამეტრის ვარიანტებში, მათ შორის Python-ის სპეციალისტი და ინსტრუქციებზე მორგებული ვერსიები, და მხარს უჭერენ 100,000-მდე ტოკენის კონტექსტურ ფანჯარას.
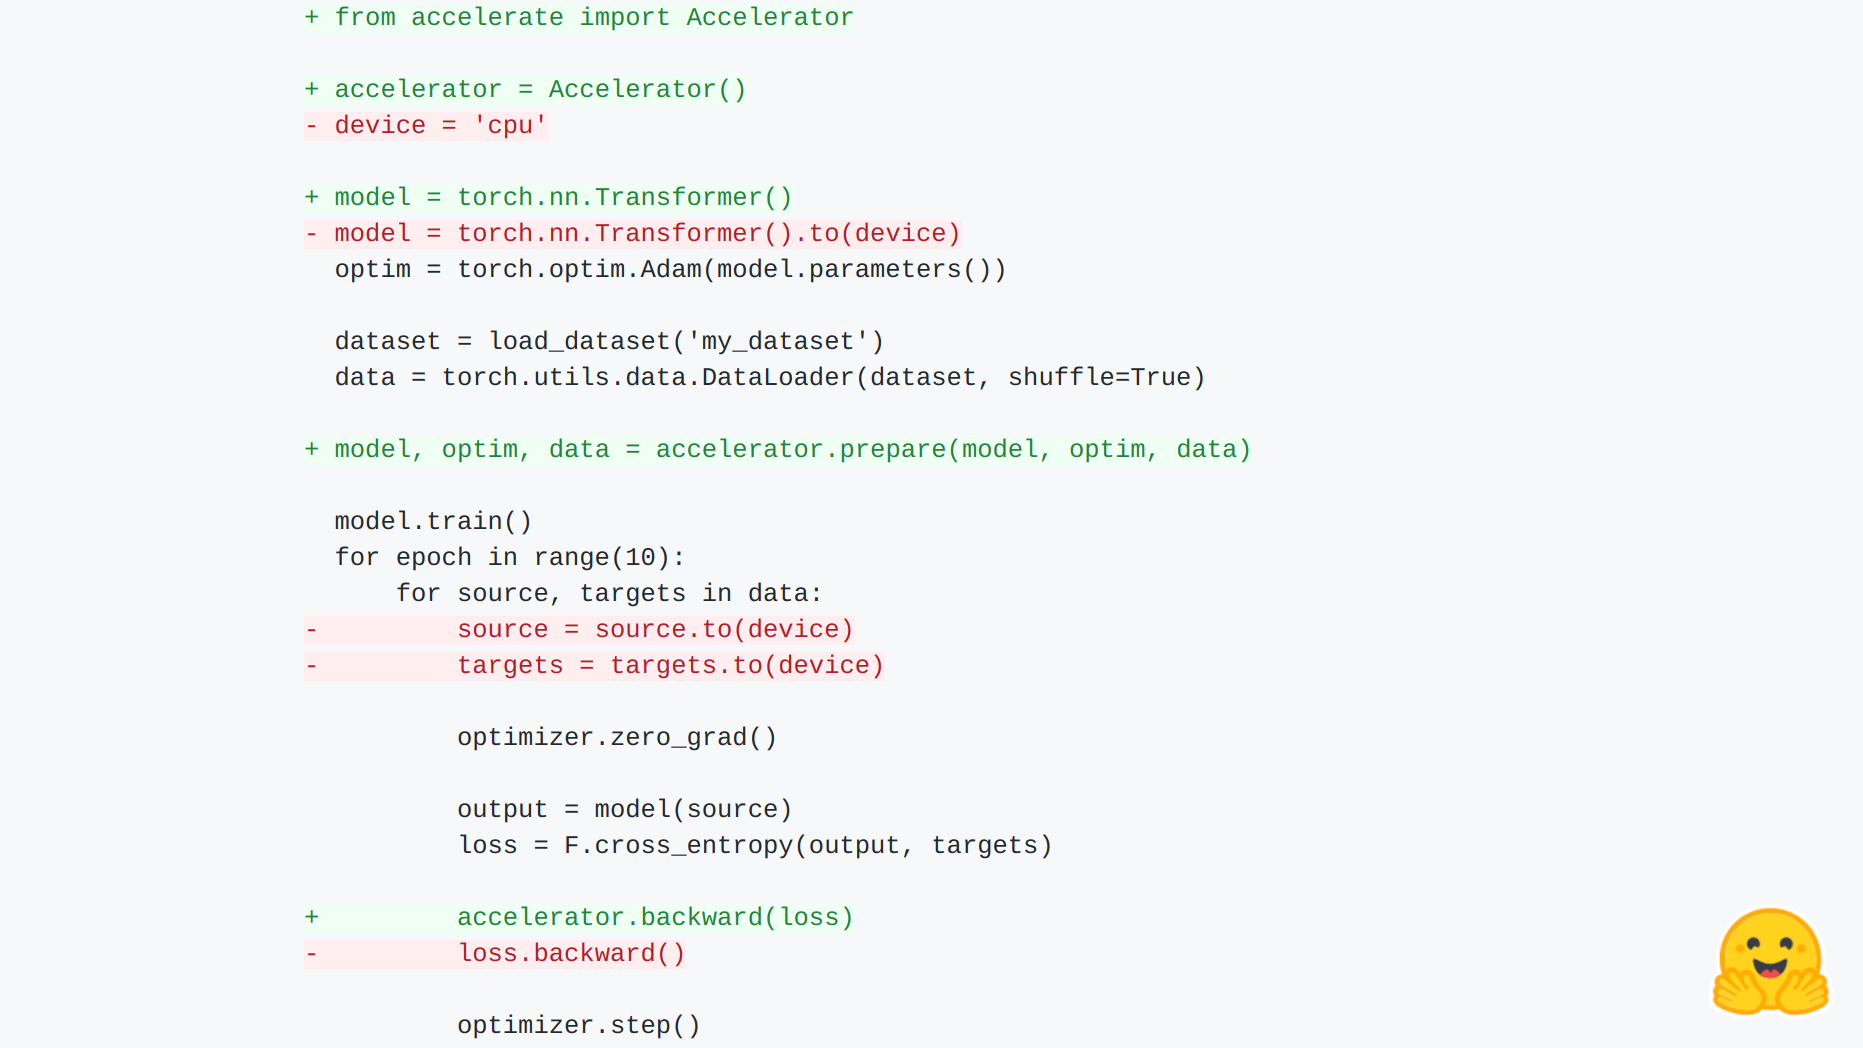
🤗 Accelerate: გაამარტივეთ PyTorch-ის განაწილებული ტრენინგი სრული კონტროლის შენარჩუნებით
🤗 Accelerate არის PyTorch-ის მომხმარებლებისთვის შექმნილი ბიბლიოთეკა, რომელიც ამარტივებს განაწილებული ტრენინგისა და შერეული სიზუსტის გამოყენებას. ის საშუალებას აძლევს მომხმარებლებს, სრულად აკონტროლონ თავიანთი სავარჯიშო ციკლები, თავიდან აიცილონ რთული შაბლონური კოდის წერა და მარტივად გაუშვან სკრიპტები სხვადასხვა მოწყობილობაზე (მრავალ-GPU, TPU) მინიმალური ცვლილებებით. ბიბლიოთეკა აბსტრაგირებს რუტინულ კოდს და უზრუნველყოფს მარტივ API-ს, რაც გაცილებით მოსახერხებელს ხდის რთული ტრენინგის კონფიგურაციებს.

AI მოდელების მასშტაბური ინფერენციის ოპტიმიზაცია: ხარჯი და შეყოვნება
ეს სტატია დეტალურად აღწერს მეთოდოლოგიას ენკოდერული მოდელების გამოყენებით მასშტაბური კლასიფიკაციისა და ემბედინგის ამოცანებისთვის ხარჯებისა და შეყოვნების გამოსათვლელად და ოპტიმიზაციისთვის. განხილულია მოდელების არქიტექტურები, აპარატურული ხარჯების ბენჩმარკინგი და ოპტიმიზაციის ჩარჩო. გამოყენებულია ისეთი ინსტრუმენტები, როგორიცაა Inference Endpoints აპარატურის შერჩევისთვის, Hugging Face Hub განთავსებისთვის, Infinity ინფერენციის სერვერისთვის და Grafana-ს k6 დატვირთვის ტესტირებისთვის. მოცემულია პრაქტიკულ
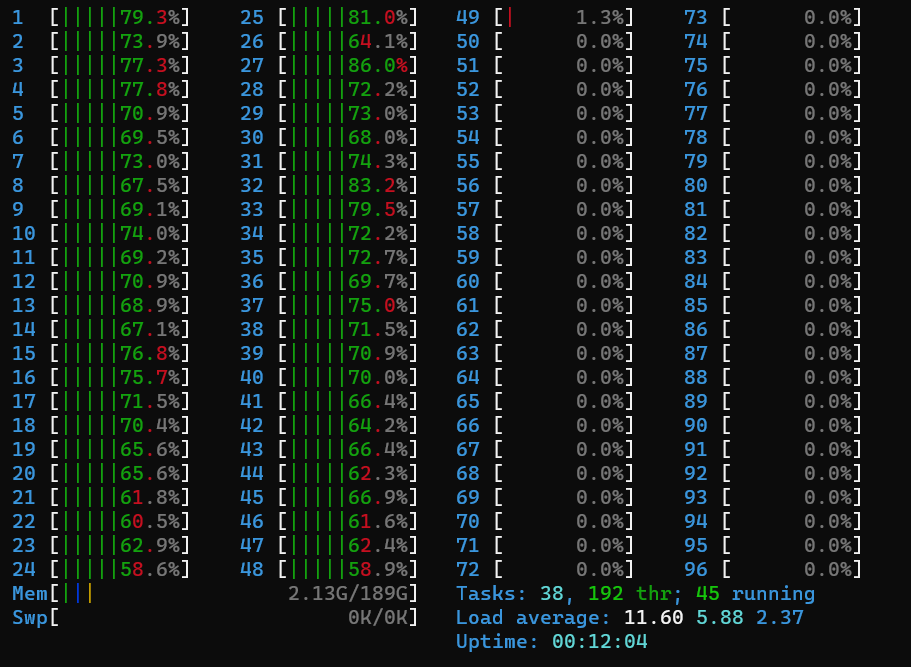
Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.
Hugging Face წარმოგიდგენთ TII-ის Falcon 180B-ს: ღია წყაროს მოდელების უახლესი მიღწევა
Hugging Face სიამაყით წარადგენს TII-ის Falcon 180B-ს – ღია წყაროს უდიდეს და უახლესი ტექნოლოგიების მწვერვალზე მდგომ ენობრივ მოდელს. 180 მილიარდი პარამეტრით და 3.5 ტრილიონ ტოკენზე გაწვრთნილი Falcon 180B ლიდერობს ღია წყაროს მოდელებს შორის და კონკურენციას უწევს ისეთ კომერციულ გიგანტებს, როგორიცაა Google-ის PaLM-2. მოდელი უკვე ხელმისაწვდომია Hugging Face Hub-ზე, რაც მაღალი შესაძლებლობის ხელოვნურ ინტელექტს ფართო საზოგადოებისთვის ხელმისაწვდომს ხდის.