
Fireworks.ai და Hugging Face: ელვისებურად სწრაფი სერვერის გარეშე AI დასკვნა ახლა ხელმისაწვდომია
Fireworks.ai ინტეგრირდა Hugging Face-ის ეკოსისტემაში, რაც მომხმარებლებს საშუალებას აძლევს, ელვისებურად სწრაფად გაუშვან სერვერის გარეშე დასკვნები (serverless inference) საყვარელ AI მოდელებზე. ეს თანამშრომლობა ამარტივებს პროცესს, გთავაზობთ მოქნილ ბილინგის ვარიანტებს და PRO მომხმარებლებისთვის განკუთვნილ უპირატესობებს, მათ შორის ყოველთვიურ კრედიტებს.

„Few-Shot“ სწავლება: GPT-Neo, ბუნებრივი ენის დამუშავება და ეთიკური გამოწვევები
„Few-Shot“ სწავლება მანქანური სწავლების მოდელებს საშუალებას აძლევს, პროგნოზები გააკეთონ ძალიან მცირე რაოდენობის სავარჯიშო მონაცემების გამოყენებით, ტრადიციული „fine-tuning“ მეთოდებისგან განსხვავებით. ის, ძირითადად, კომპიუტერულ მხედველობაში გამოიყენებოდა, თუმცა ახლა უკვე ეფექტურია ბუნებრივი ენის დამუშავებაში (ბედ) დიდ ენობრივ მოდელებთან (მაგ. GPT-Neo), რაც მათ საშუალებას აძლევს, განაზოგადონ ახალი ამოცანები სულ რამდენიმე მაგალითით. თუმცა, ეფექტური „few-shot“ მაგალითების შექმნა და ჰიპერპარამეტრების
Hugging Face-ის SafeCoder: ღია კოდის კოდის ასისტენტი საწარმოებისთვის — სრული კონტროლი და კონფიდენციალურობა
პროგრამული უზრუნველყოფის შეცდომების გამოსწორების მაღალი ღირებულება ხაზს უსვამს ხარისხიანი კოდის მნიშვნელობას. ხელოვნური ინტელექტი გვთავაზობს კოდის გენერაციის პერსპექტიულ გზებს, მაგრამ დახურული კოდის სერვისებს აკლია მორგებადობა და გამჭვირვალობა. Hugging Face-მა წარმოადგინა SafeCoder — ღია კოდის კოდის ასისტენტი საწარმოებისთვის, რომელიც აგებულია StarCoder მოდელებზე. ის უზრუნველყოფს უახლეს მოდელებს, გამჭვირვალობას, სრულ მორგებადობას, IT მოქნილობას და უმაღლეს კონფიდენციალურობას, რაც საშუალებას აძლევს

Google-მა PaliGemma 2 mix წარადგინა: ახალი, დახვეწილი ვიზუალურ-ენობრივი მოდელები
გასულ დეკემბერში Google-მა PaliGemma 2-ის წინასწარ გაწვრთნილი (pt) ვიზუალურ-ენობრივი მოდელები (VLM) გამოუშვა, რომლებიც SigLIP-სა და Gemma 2-ზეა დაფუძნებული. დღეს კომპანია წარმოადგენს PaliGemma 2 mix-ს, რომელიც დახვეწილია ვიზუალურ-ენობრივ ამოცანებზე, მათ შორის OCR-ზე (ოპტიკური სიმბოლოების ამოცნობა), გრძელ და მოკლე წარწერების გენერირებაზე და სხვა. ეს მოდელები განკუთვნილია სპეციფიკურ ამოცანებზე ადაპტირებისთვის და გთავაზობთ სხვადასხვა შესაძლებლობებს, როგორიცაა ობიექტის ამოცნობა და სეგმენტაცია, გაუმჯ
Amazon SageMaker ამარტივებს Hugging Face Transformers-ის დეპლოირებას ახალი Inference DLC-ებითა და ხელსაწყოებით
Amazon SageMaker-მა გამოუშვა Hugging Face Inference DLC-ები და ახალი Inference Toolkit, რაც მნიშვნელოვნად ამარტივებს Hugging Face Transformers მოდელების დეპლოირებას. ეს სიახლე საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ როგორც საკუთარი გაწვრთნილი მოდელები, ისე Hugging Face Model Hub-დან 10,000-ზე მეტი საჯაროდ ხელმისაწვდომი მოდელი, სულ ერთი დამატებითი კოდის ხაზით. SageMaker უზრუნველყოფს საპროდუქციო გარემოსთვის მზა ენდპოინტებს ჩაშენებული მონიტორინგითა და მასშტაბირებადი შესაძლებლობებით.
მოდელების კვანტიზაცია: bitsandbytes-ისა და GPTQ-ის შედარება
ეს სტატია განიხილავს მოდელების კვანტიზაციის ორ ძირითად მიზანს და `transformers` ბიბლიოთეკაში ინტეგრირებულ ორ ძირითად სქემას: `bitsandbytes`-ს და `auto-gptq`-ს. მოცემულია თითოეული მეთოდის დადებითი და უარყოფითი მხარეები, საზოგადოების გამოხმაურების საფუძველზე. ასევე წარმოდგენილია ინფერენციისა და ადაპტერების დაზუსტების ბენჩმარკები სხვადასხვა აპარატურაზე, რაც მომხმარებლებს დაეხმარება ოპტიმალური მიდგომის არჩევაში.
მოდელების კვანტიზაცია: Bitsandbytes-ისა და GPTQ-ის შედარებითი ანალიზი
სტატია განიხილავს ხელოვნური ინტელექტის მოდელების კვანტიზაციის ორ ძირითად მეთოდს, bitsandbytes-სა და auto-gptq-ს, რომლებიც მშობლიურად არის მხარდაჭერილი Transformers ბიბლიოთეკაში. წარმოდგენილია თითოეული მეთოდის უპირატესობები და ნაკლოვანებები, მათ შორის გამოყენების სიმარტივე, კროს-მოდალური თავსებადობა, ადაპტერების ინტეგრაცია, ტექსტის გენერირების სიჩქარე, სერიალიზაციის შესაძლებლობები და ტექნიკური შეზღუდვები. მოცემულია ბენჩმარკის შედეგები ინფერენსისა და ადაპტერების დახვეწის წარმადობის შესადარებლად სხ
Hugging Face spaCy-ის ინტეგრაციით მოდელების გაზიარებასა და გამოყენებას ამარტივებს
Hugging Face-მა და spaCy-იმ განახორციელეს ინტეგრაცია, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ, დააყენონ და გამოიყენონ spaCy-ის კონვეიერები და მოდელები. ახალი ფუნქციონალი მოიცავს ავტომატურ მეტამონაცემების გენერაციას, დასკვნის (Inference) API-ს NER-ისთვის (Named Entity Recognition), ბრაუზერში ინტერაქტიულ ტესტირებას, `pip install`-ის მხარდაჭერას და `spacy-huggingface-hub` ბიბლიოთეკას მოდელების სწრაფი გაზიარებისთვის. ხელმისაწვდომია 60-ზე მეტი კანონიკური მოდელი, და მალე დაემატება ტექსტ

Google-მა SigLIP 2 გამოუშვა: მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ახალი, გაუმჯობესებული თაობა
Google-მა წარმოადგინა SigLIP 2, მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ოჯახის ახალი თაობა. გაფართოებული სწავლების მიზნების წყალობით, რომელიც აუმჯობესებს სემანტიკურ გაგებას, ლოკალიზაციასა და მკვრივ მახასიათებლებს, SigLIP 2 მოდელები მნიშვნელოვნად აღემატება წინამორბედ SigLIP-ს ისეთ ძირითად შესაძლებლობებში, როგორიცაა ნულოვანი კადრის კლასიფიკაცია და გამოსახულება-ტექსტის მოძიება. სიახლეს წარმოადგენს დინამიური რეზოლუციის (naflex) ვარიანტი, რაც მას უფრო მრავალმხრივს ხდის.

FastRTC: ახალი Python ბიბლიოთეკა რეალურ დროში AI აუდიო და ვიდეო აპლიკაციებისთვის
მიუხედავად ხელოვნური ინტელექტის მოდელებისა და დაფინანსების მხრივ სწრაფი განვითარებისა, რეალურ დროში AI აპლიკაციების შექმნა, რომლებიც აუდიო და ვიდეო ნაკადებს ამუშავებენ, განსაკუთრებით Python-ში, კვლავ სირთულეებთანაა დაკავშირებული. FastRTC, ახალი კომუნიკაციის ბიბლიოთეკა Python-ისთვის, შექმნილია სწორედ ამ პროცესის გასამარტივებლად, რაც დეველოპერებს საშუალებას აძლევს მარტივად ააწყონ რეალურ დროში აუდიო და ვიდეო AI აპლიკაციები მხოლოდ Python-ის გამოყენებით.
3D Gaussian Splatting: რევოლუციური ტექნოლოგია 3D გრაფიკაში
3D Gaussian Splatting არის უახლესი რასტერიზაციის ტექნიკა, რომელიც 3D გარემოს წარმოსახვის ახალ სტანდარტებს აწესებს. სამკუთხედების ნაცვლად გაუსიანების გამოყენებით, ის უზრუნველყოფს მაღალი ხარისხის სცენების რეალურ დროში რენდერინგს, რამაც დიდი ყურადღება მიიპყრო კომპიუტერული გრაფიკის სფეროში. სტატია დეტალურად განიხილავს ამ მეთოდის მუშაობის პრინციპებს, მისი მომზადების პროცესს და პოტენციურ გავლენას მომავალ ტექნოლოგიებზე, მათ შორის ინკარნირებული ხელოვნური ინტელექტის კვლევაზე.

ხელოვნური ინტელექტის აგენტების გაგება და გაუმჯობესება: ტრესინგი და შეფასება Arize Phoenix-ით
AI აგენტების შექმნა მხოლოდ დასაწყისია; მათი ქცევის გაგება და ოპტიმიზაცია გადამწყვეტია. ეს სტატია განმარტავს, თუ როგორ ეხმარება ტრესინგი და შეფასება აგენტების მუშაობის გაანალიზებაში, პრობლემების აღმოფხვრაში და ეფექტურობის უზრუნველყოფაში. Arize Phoenix წარმოადგენს ცენტრალიზებულ პლატფორმას ამ პროცესების რეალურ დროში განსახორციელებლად, OpenTelemetry-სა და OpenInference-თან ინტეგრაციით. განხილულია პრაქტიკული ნაბიჯები DuckDuckGo-ს საძიებო ხელსაწყოს მაგალითზე, სადაც LLM-ები, მაგალითად GPT-4o, გამოიყენე
მარტივად შექმენით ინტერაქტიული ML დემოები Gradio-თი Hugging Face Spaces-ზე
ეს სტატია განმარტავს, თუ როგორ უნდა შექმნათ და უმასპინძლოთ ინტერაქტიულ მანქანური სწავლების მოდელების დემოებს Hugging Face Spaces-ზე Gradio-ს გამოყენებით. ის დეტალურად აღწერს პროცესს ინტერფეისების განსაზღვრიდან რთული მოდელების პაიპლაინების განთავსებამდე, ხაზს უსვამს Hugging Face-ის Inference API-სთან ინტეგრაციასა და Gradio Series-ის მოქნილობას.

Hugging Face Hub-ის უსაფრთხოება JFrog-ის სკანერის ინტეგრაციით ძლიერდება
Hugging Face-მა JFrog-ის სკანერი თავის პლატფორმაზე დაამატა, რათა Hugging Face Hub-ზე უსაფრთხოება გააუმჯობესოს. ახალი სკანერი ამცირებს ცრუ დადებით შედეგებს და მოდელის წონებში არსებულ კოდს ღრმად აანალიზებს პოტენციური მავნე გამოყენების გამოსავლენად, განსაკუთრებით ისეთი მოწყვლადი სერიალიზაციის ფორმატებისთვის, როგორიცაა Pickle. ყველა საჯარო მოდელის რეპოზიტორი ავტომატურად დასკანირდება, რაც საზოგადოებას მოდელების უსაფრთხოდ გაზიარებაში ეხმარება.

როგორ შევქმნათ მობილური აპლიკაცია LLM მოდელებთან ლოკალური ჩეთისთვის React Native-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა შექმნათ მობილური აპლიკაცია React Native-ის გამოყენებით, რომელიც საშუალებას მოგცემთ ლოკალურად ესაუბროთ დიდ ენობრივ მოდელებს (LLM). ის გვიჩვენებს, როგორ გადმოწეროთ LLM-ები Hugging Face ჰაბიდან და გაუშვათ ისინი უშუალოდ თქვენს მოწყობილობაზე, llama.rn-ის მეშვეობით GGUF ფაილების ეფექტურად ჩატვირთვით. სტატია მოიცავს გარემოს მომზადებას, მოდელების შერჩევას, პროექტის დაყენებას და აპლიკაციის თავდაპირველ კოდირებას, უზრუნველყოფს რა კონფიდენციალურობასა და მარტ
შექმენით თქვენი საკუთარი ღია კოდის ChatGPT კოდის დაწერის გარეშე Hugging Face-ის ხელსაწყოებით
ეს გაკვეთილი გვიჩვენებს, თუ როგორ შეიძლება შეიქმნას და განთავსდეს ღია კოდის ChatGPT-ის მსგავსი აპლიკაცია Meta-ს LLaMA 2 მოდელის გამოყენებით, რომელიც დახვეწილია ღია კოდის ინსტრუქციების მონაცემთა ნაკრებით, ყოველგვარი კოდის დაწერის გარეშე. სტატია ხაზს უსვამს Hugging Face-ის ინსტრუმენტების (Spaces, AutoTrain, ChatUI) როლს, რათა მანქანური სწავლება ხელმისაწვდომი გახდეს არატექნიკური მომხმარებლებისთვის, რაც გზას უხსნის ხელოვნური ინტელექტის დემოკრატიზებულ მომავალს.
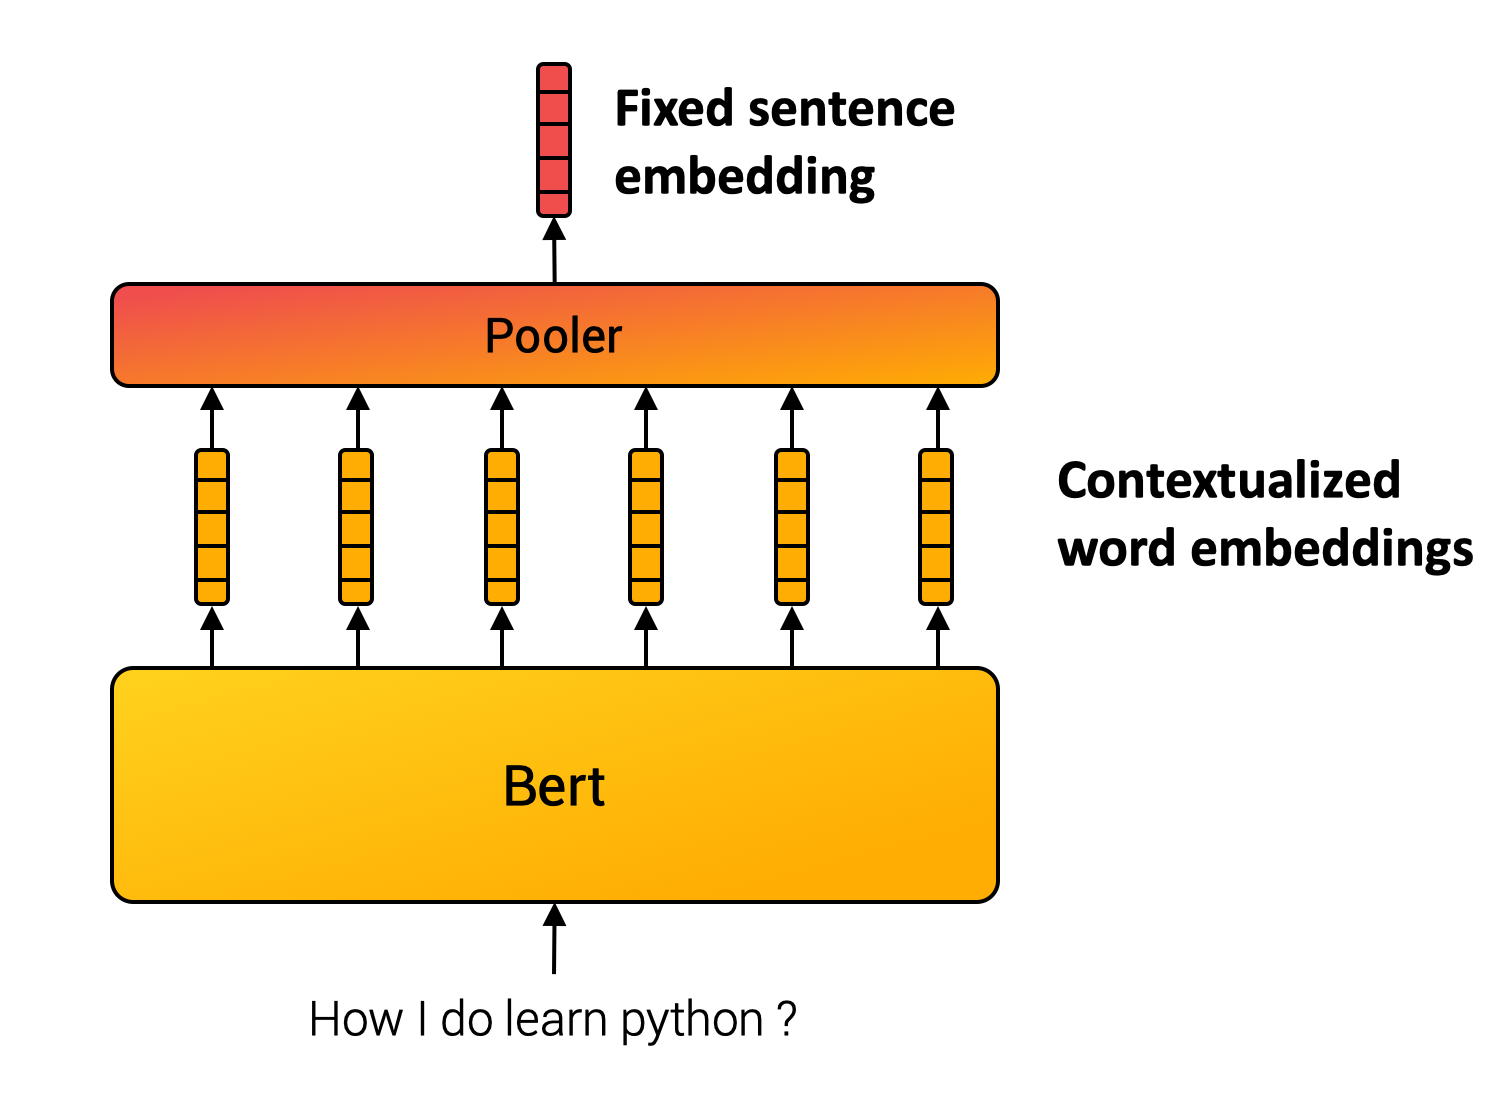
Hugging Face-ის მასშტაბური პროექტი: ხელოვნური ინტელექტის ახალი ეტაპი წინადადებების გაგებაში
Hugging Face-მა, Google-ის JAX/Flax-ის გუნდთან თანამშრომლობით, შეიმუშავა წინადადებების ჩაშენების უახლესი მოდელები პროექტის „Train the Best Sentence Embedding Model Ever with 1B Training Pairs“ ფარგლებში. პროექტი იყენებდა Google-ის 7 TPU v3-8 ერთეულს და ინოვაციურ კონტრასტულ სწავლებას, რათა მსგავსი მნიშვნელობის მქონე წინადადებები ახლო ვექტორებად ასახოს, განსხვავებული მნიშვნელობის მქონე წინადადებები კი – შორეულ ვექტორებად. ეს მიღწევა მნიშვნელოვნად აუმჯობესებს ბუნებრივი ენის დამუშავების (NLP) სისტემ

"OlympicCoder": ხელოვნური ინტელექტის ახალი მოდელები კონკურენტულ პროგრამირებაში გიგანტებს აჭარბებენ
მკვლევრებმა შეიმუშავეს ხელოვნური ინტელექტის მოდელების ახალი ნაკრები, სახელწოდებით „OlympicCoder“, რომელიც სპეციალურად კონკურენტული პროგრამირებისთვის არის შექმნილი. CodeForces-ისა და IOI-ის მორგებულ მონაცემთა ბაზებზე გაწვრთნილი OlympicCoder-32B აჩვენებს უმაღლეს დონის შესრულებას, აჯობა ბევრ მნიშვნელოვნად უფრო დიდ, ღია წყაროს მოდელს კოდის მსჯელობის ამოცანებში. ეს მიღწევა უპასუხებს არსებული მონაცემთა ბაზების შეზღუდვებს, სრულად გადამოწმებადი პრობლემური ნაკრებებისა და დეტალური გადაწყვეტილებების მიწოდე
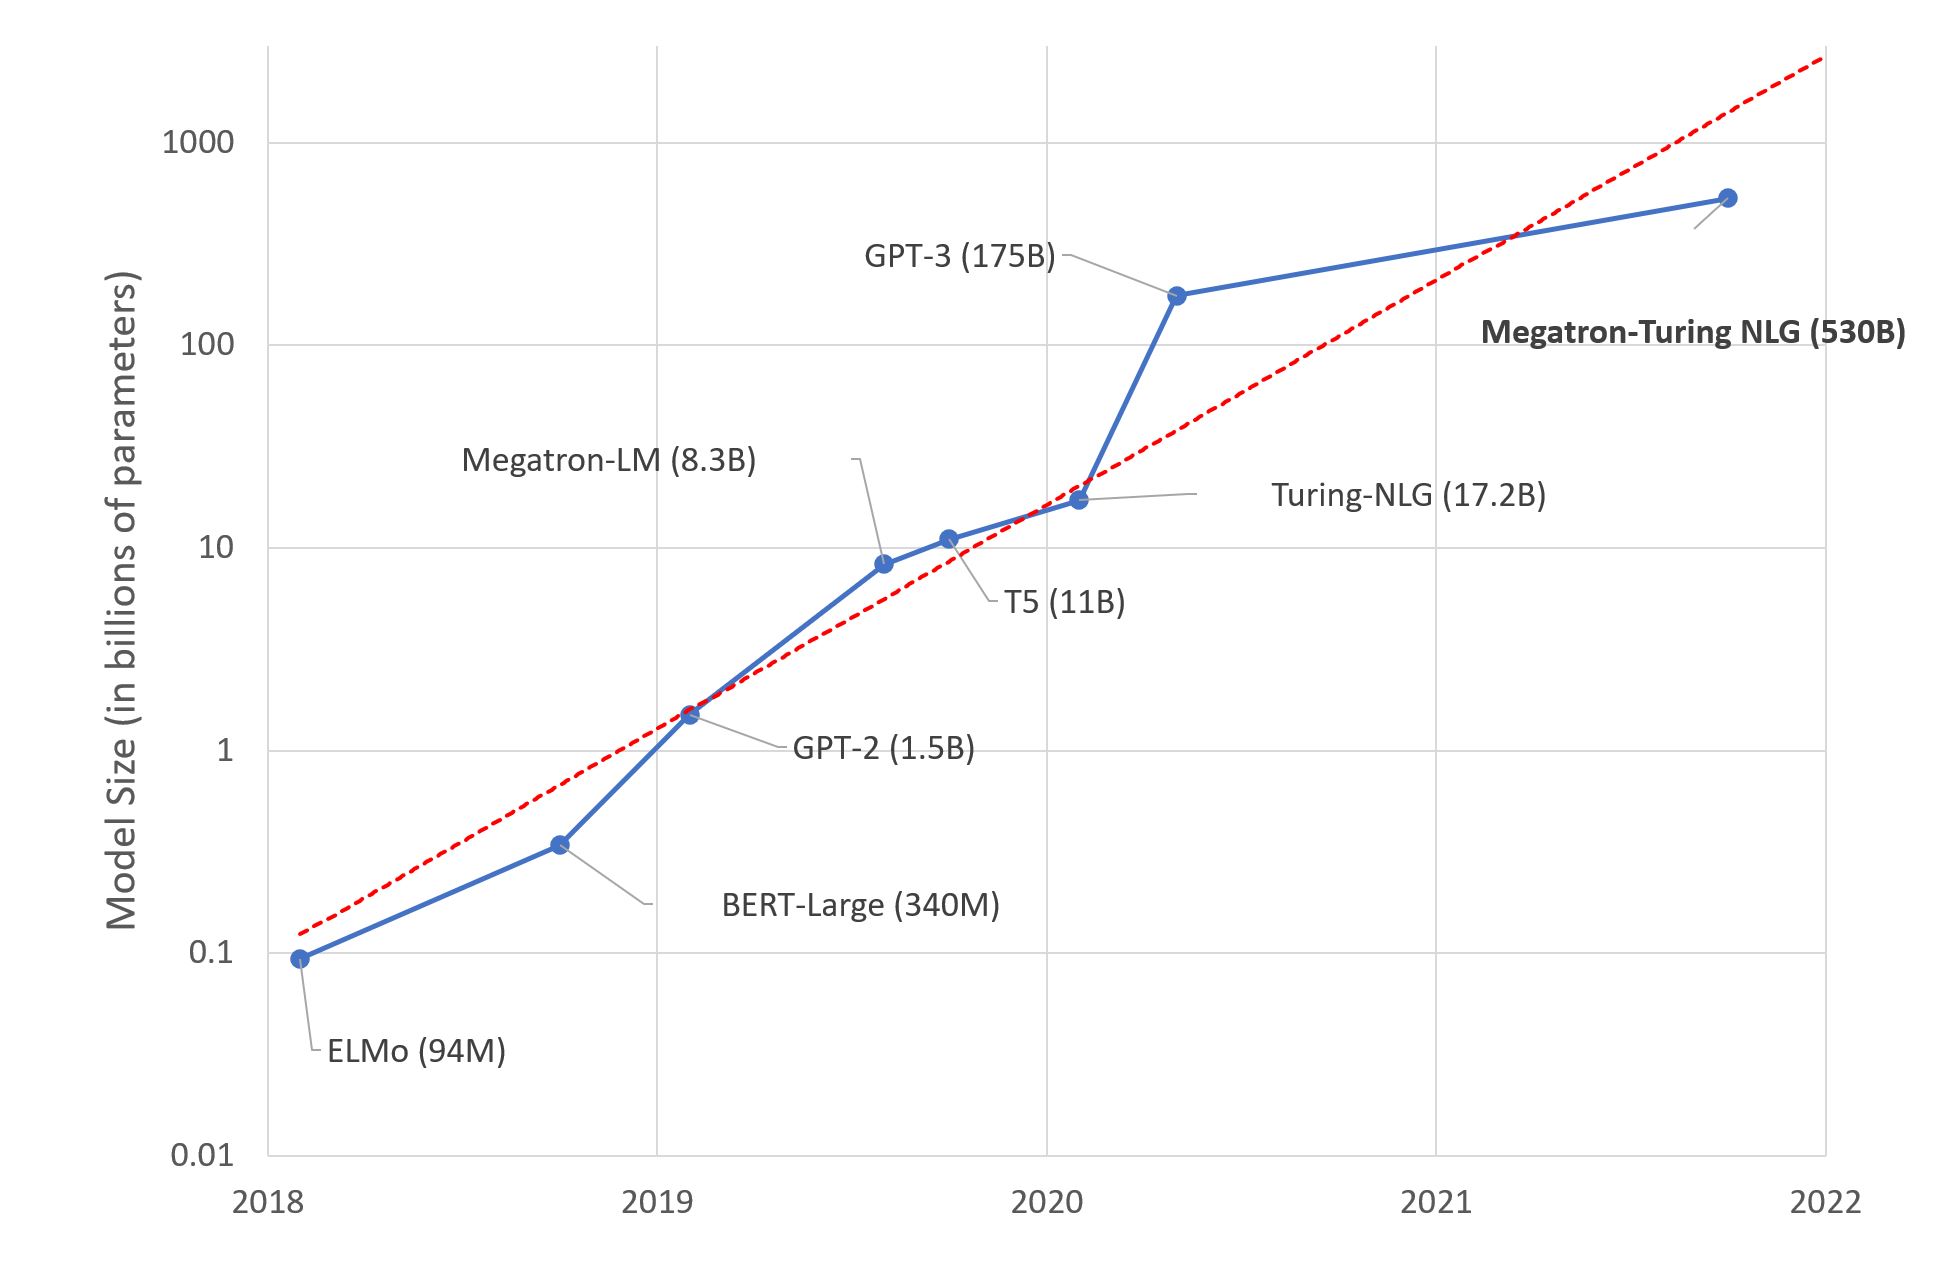
ხელოვნური ინტელექტის მეგა-მოდელები: ღირს კი ეს ხარჯი და ძალისხმევა?
სტატია აანალიზებს ხელოვნური ინტელექტის მეგა-მოდელების ტენდენციას და ეჭვქვეშ აყენებს მათ მიზანშეწონილობას მაღალი დანახარჯების, სირთულისა და გარემოზე ზემოქმედების გამო. ავტორი აღნიშნავს, რომ მიუხედავად ინჟინრული მიღწევებისა, უზარმაზარი მოდელების შექმნა, რომლებიც ადამიანის ტვინის ზომას უახლოვდება, შესაძლოა, გრძელვადიან პერსპექტივაში საუკეთესო მიდგომა არ იყოს. სანაცვლოდ, ის მხარს უჭერს პრაგმატულ გადაწყვეტილებებს, როგორიცაა წინასწარ გაწვრთნილი, უფრო მცირე ზომის მოდელების გამოყენება და მათი დახვეწა (f
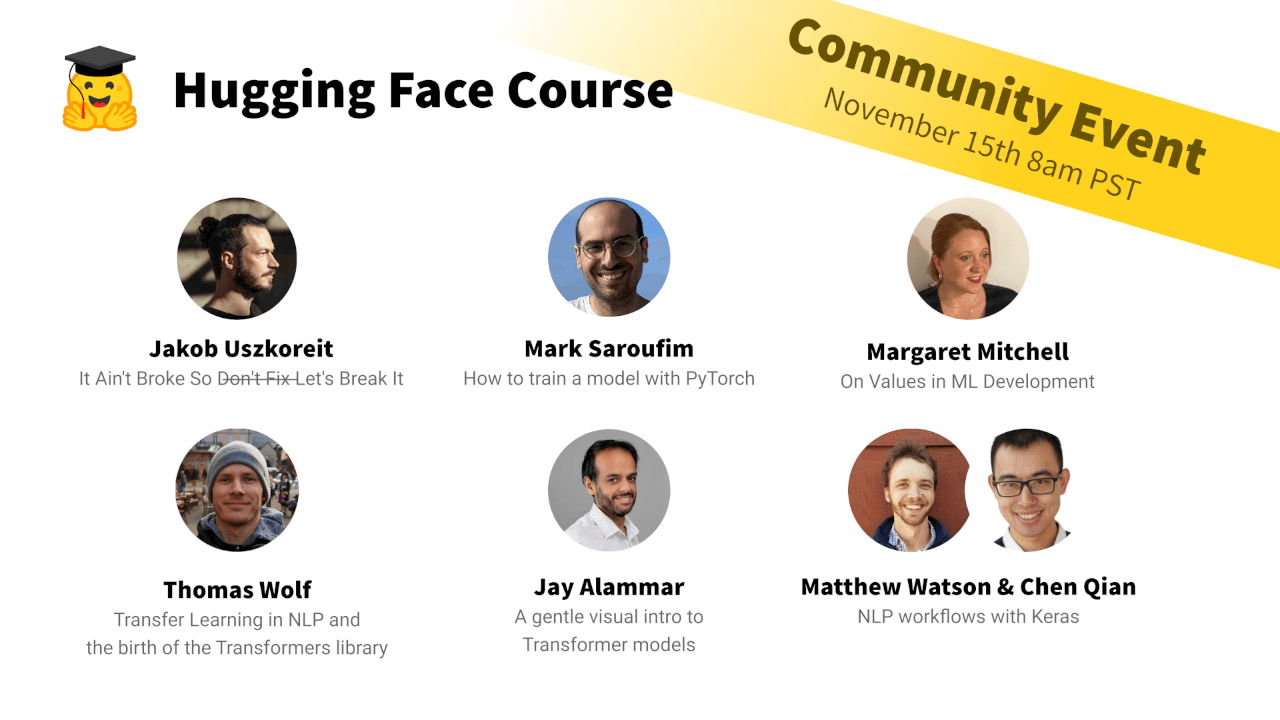
გეპატიჟებით ხელოვნური ინტელექტის საზოგადოებრივ ღონისძიებაზე: წამყვანი ექსპერტების მოხსენებები და პრაქტიკული პროექტები
ამ მასშტაბურ ღონისძიებაზე მონაწილეებს შესაძლებლობა ექნებათ მოუსმინონ ხელოვნური ინტელექტისა და ბუნებრივი ენის დამუშავების (NLP) სფეროს წამყვან ექსპერტებს, მათ შორის HuggingFace-ის თანადამფუძნებელ თომას ვოლფს და ეთიკური AI-ის მკვლევარ მარგარეტ მიტჩელს. ორდღიანი მოხსენებების შემდეგ გაიმართება გუნდური პროექტები მოდელების „დაფაინთუნებაზე“ (fine-tuning), რომელიც დასრულდება ცოცხალი დემონსტრაციებით. AWS აფინანსებს ღონისძიებას Amazon SageMaker-ის მეშვეობით უფასო გამოთვლითი რესურსებით, ხოლო წარმატებული მო

Hugging Face-ის Xet გუნდი: დიდი ნაბიჯი AI მოდელებისა და მონაცემთა საცავების მიგრაციაში
Hugging Face-ის Xet გუნდმა წარმატებით განახორციელა მოდელებისა და მონაცემთა ნაკრებების პირველი საცავების მიგრაცია LFS-დან Xet საცავში. ეს ნაბიჯი, რომელიც Hugging Face-ის Hub-ის ხედვის ნაწილია, მიზნად ისახავს ხელოვნური ინტელექტის დეველოპერებისთვის მასიურ მოდელებსა და მონაცემთა ნაკრებებზე მუშაობის გამარტივებას, უფრო ეფექტურ თანამშრომლობასა და განმეორებითი იტერაციების განხორციელებას. მიგრაციამ Hub-ის ჩამოტვირთვის ტრაფიკის დაახლოებით 6% Xet ინფრასტრუქტურაზე გადაიტანა, რაც ამტკიცებს ახალი სისტემის ეფე

NVIDIA-ს რევოლუციური AI სიახლეები: Cosmos Transfer, Physical AI Dataset და Isaac GR00T N1
NVIDIA-მ წარადგინა ხელოვნური ინტელექტის (AI) სამი მნიშვნელოვანი სიახლე: Cosmos Transfer, რომელიც ზრდის ვირტუალური სამყაროს სცენების გენერირების სიზუსტეს; Physical AI Dataset, ღია კოდის მონაცემთა ნაკრები რობოტიკის ვარჯიშისთვის; და Isaac GR00T N1, მსოფლიოში პირველი ღია ფუნდამენტური მოდელი ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს ინოვაციები მიზნად ისახავს ვირტუალური სამყაროების, რობოტიკისა და ავტონომიური სისტემების განვითარებას.
ხელოვნური ინტელექტის ღია მიდგომების წარმატება: რატომ არის ის სასიცოცხლოდ მნიშვნელოვანი?
ხელოვნური ინტელექტის (AI) განვითარებაში ღია მიდგომები არამხოლოდ უფრო გამჭვირვალე, ადაპტირებადი და მეცნიერულად დასაბუთებულია, არამედ მუდმივად აჭარბებს კომერციული შეთავაზებების წარმადობას. უახლესი მაგალითები, როგორიცაა OlympicCoder-ისა და OLMo 2-ის წარმატებები, ადასტურებს, რომ მძლავრი AI სტრატეგია ღია და კოლაბორაციულ განვითარებას უნდა ეფუძნებოდეს, რათა ხელი შეუწყოს ტექნოლოგიის წარმადობას, დანერგვასა და უსაფრთხოებას. სტატია გვთავაზობს სამ ძირითად რეკომენდაციას AI-ის ტექნიკური და ეკონომიკური წარმატე

PyTorch-ის სწავლების აჩქარება Intel Xeon პროცესორებზე: ღრმა სწავლის ახალი მიდგომა
გრაფიკული პროცესორები (GPUs) დიდი ხანია ღრმა სწავლის მოდელების სწავლების დე ფაქტო არჩევანი იყო. თუმცა, ტრანსფერული სწავლის ზრდა ცვლის თამაშის წესებს. მოდელები ახლა იშვიათად სწავლება ნულიდან უზარმაზარ მონაცემთა ნაკრებებზე; ამის ნაცვლად, ისინი ხშირად ზუსტდება კონკრეტულ (და მცირე) მონაცემთა ნაკრებებზე, რათა შეიქმნას სპეციალიზებული მოდელები, რომლებიც უფრო ზუსტია კონკრეტული ამოცანებისთვის, ვიდრე საბაზისო მოდელი. რადგან ეს სწავლების ამოცანები ბევრად უფრო ხანმოკლეა, CPU-ზე დაფუძნებული კლასტერის გამოყენ