როგორ განათავსოთ AI Comic Factory თქვენს პირად სივრცეში და თავიდან აიცილოთ ლოდინი
AI Comic Factory, აპლიკაცია, რომელმაც ათასობით მომხმარებელი მოიზიდა საკუთარი AI კომიქსების შესაქმნელად, წარმოუდგენლად პოპულარული გახდა. ეს გაკვეთილი გიჩვენებთ, თუ როგორ უნდა მოახდინოთ მისი კლონირება (fork) და კონფიგურაცია, რათა თავიდან აიცილოთ ხანგრძლივი ლოდინის დრო და განათავსოთ აპლიკაცია თქვენს პირად Hugging Face სივრცეში Inference API-ის გამოყენებით. მართალია, არ არის საჭირო ძლიერი ტექნიკური უნარები, მაგრამ რეკომენდებულია API-ების, გარემოს ცვლადების (environment variables) და LLM-ებისა და Sta
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და
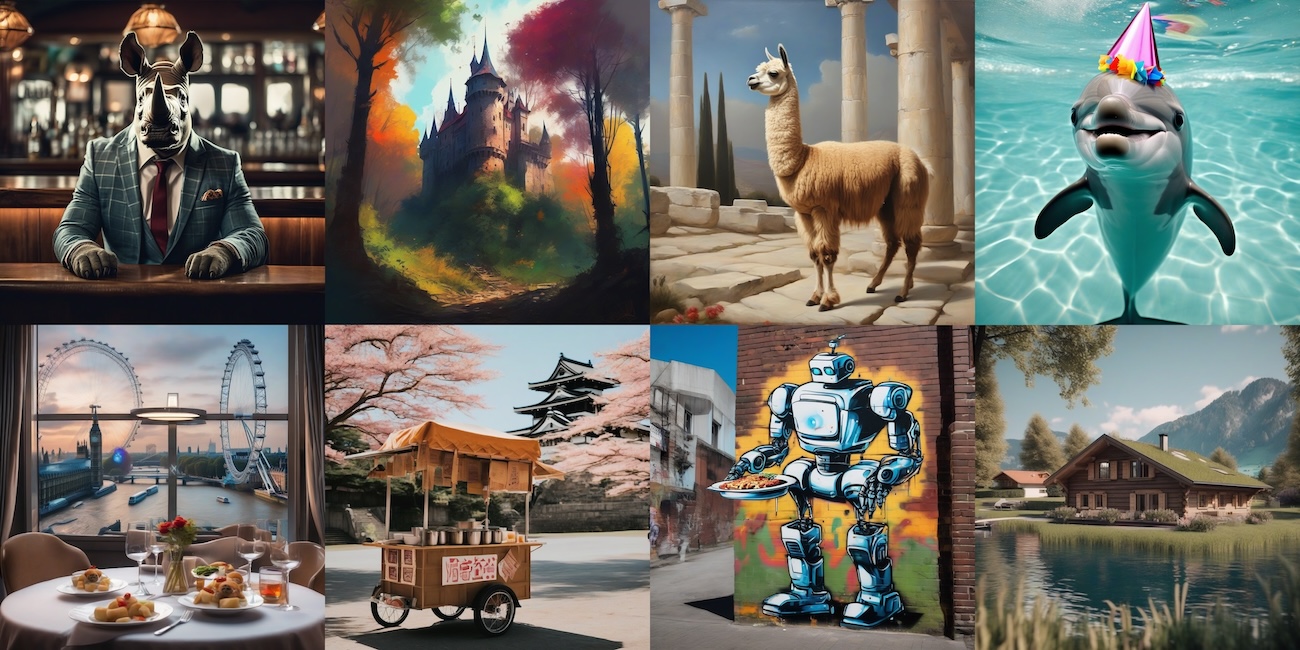
მაღალეფექტური და ხარჯთეფექტური SDXL სერვისინგი JAX-ით Google Cloud TPU v5e-ზე
Google Cloud-ის ახალი TPU v5e, JAX-თან და Diffusers-თან ერთად, შესაძლებელს ხდის დიდი ხელოვნური ინტელექტის მოდელების, მაგალითად SDXL-ის, მაღალპროდუქტიულ და ხარჯთეფექტურ ტრეინინგსა და ინფერენსს. სტატია მიმოიხილავს, თუ როგორ ხდის JIT კომპილაცია და XLA-ზე დაფუძნებული პარალელიზაცია მასშტაბურ გენერაციულ AI-ს ხელმისაწვდომსა და ეფექტურს, წარმოადგენს დემოს და განმარტავს ამ ტექნოლოგიების გამოყენების დეტალებს.

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.

ღია კოდის რევოლუცია კოდირების AI-ში: OlympicCoder 7B აჯობებს წამყვან მოდელებს და მისი ინტეგრაცია IDE-ში
ეს სტატია იკვლევს ღია კოდის ხელოვნური ინტელექტის მოდელების მზარდ პოტენციალს კოდირების ასისტენტების სფეროში, განსაკუთრებით ხაზს უსვამს OlympicCoder 7B-ს. LiveCodeBench-ის შეფასებების მიხედვით, ეს 7B პარამეტრის მქონე ვარიანტი აღემატება ისეთ პოპულარულ მოდელებს, როგორიცაა Claude 3.7 Sonnet და GPT-4o. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ მოდელების, კერძოდ OlympicCoder 7B-ის, ინტეგრირება ინტეგრირებულ განვითარების გარემოში (IDE), როგორიცაა VSCode, LM Studio-ს გამოყენებით ოპტიმალური ლოკალური ინ
Gradio-lite: Gradio აპლიკაციების გაშვება პირდაპირ ბრაუზერში Pyodide-ით
Gradio-lite არის JavaScript ბიბლიოთეკა, რომელიც საშუალებას გაძლევთ გაუშვათ Gradio აპლიკაციები პირდაპირ ვებ ბრაუზერში, Pyodide-ის გამოყენებით (Python runtime WebAssembly-ისთვის). ეს გამორიცხავს სერვერის ინფრასტრუქტურის საჭიროებას, ამარტივებს დეპლოიმენტს, ამცირებს ხარჯებს და უზრუნველყოფს სწრაფ ინტერაქციასა და მონაცემთა დაცვას. სტატიაში აღწერილია Gradio-lite-ის ძირითადი ფუნქციები, აპლიკაციის შექმნა, მრავალფაილიანი პროექტებისა და დამატებითი მოთხოვნების მართვა. განხილულია მისი უპირატესობები, როგორიცა
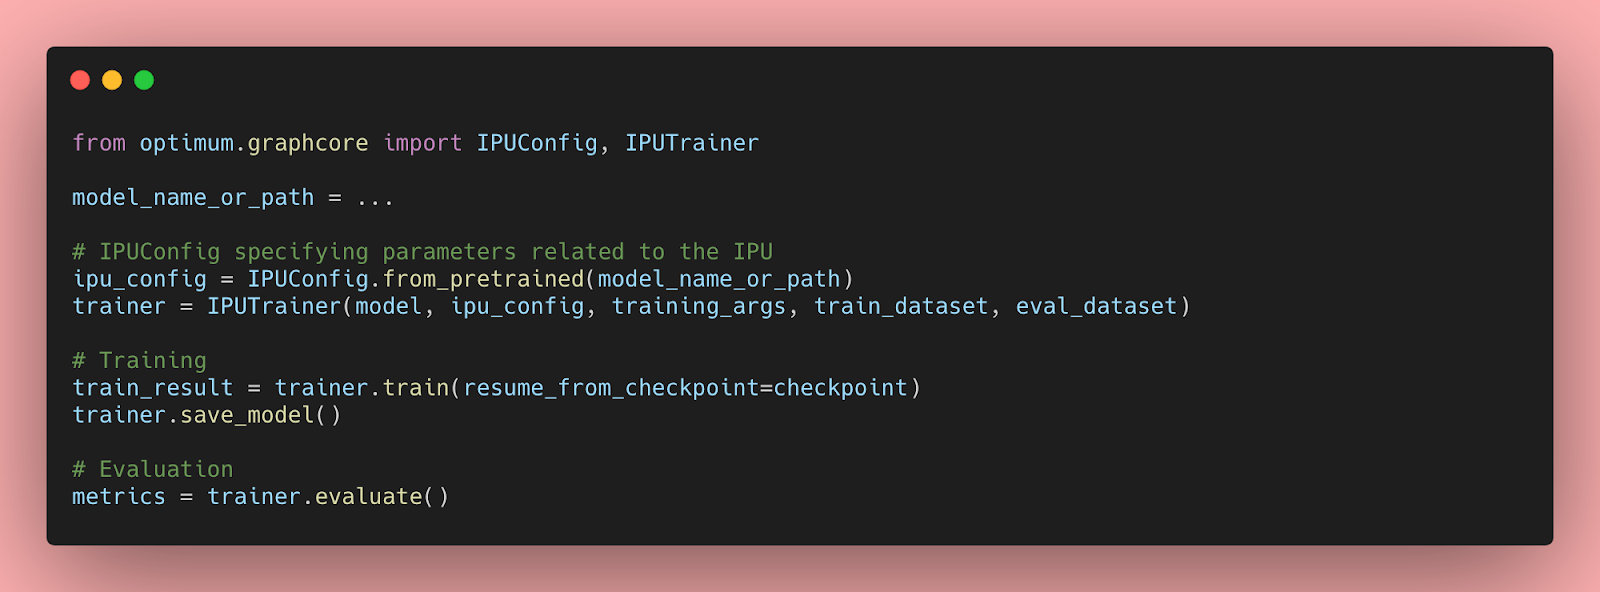
Transformer მოდელების აჩქარება Graphcore IPU-ებზე Hugging Face Optimum-ით
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. Graphcore-სა და Hugging Face-ის პარტნიორობის ფარგლებში, ახლა წარმოდგენილია BERT, როგორც პირველი IPU-ზე ოპტიმიზებული მოდელი, რომელიც განკუთვნილია Graphcore-ის ინტელექტუალური დამუშავების ერთეულისთვის (IPU). ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ Optimum და IPU-ები BERT მოდელების მარტივად გასაწვრთნელად და დასაჩქარებლად, მ
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
Hugging Face: კონფიდენციალური მონაცემების ცენტრალიზებული მართვა Infisical-ით
Hugging Face-ის ინფრასტრუქტურის მრავალღრუბლოვან გარემოში განვითარებასთან ერთად, საინჟინრო გუნდმა მოითხოვა კონფიდენციალური მონაცემების მართვის უფრო მოქნილი, უსაფრთხო და ცენტრალიზებული მეთოდი. HashiCorp Vault-ის მსგავსი გადაწყვეტილებების შეფასების შემდეგ, მათ აირჩიეს Infisical მისი დეველოპერებისთვის მოსახერხებელი სამუშაო პროცესების, მრავალღრუბლოვანი აბსტრაქციისა და უსაფრთხოების მძლავრი შესაძლებლობების გამო. ამ მიგრაციამ მნიშვნელოვნად გააუმჯობესა უსაფრთხოების პოზიცია Kubernetes Operator-თან, CI/CD

Gradio-ს 5-წლიანი გზა: როგორ გახდა ის AI ვებ აპლიკაციების სტანდარტი
5 წლის წინ Stanford-ის მკვლევრებისთვის შექმნილი Gradio დღეს მილიონობით დეველოპერს ეხმარება AI ვებ აპლიკაციების შექმნასა და გაზიარებაში. სტატია მიმოიხილავს Gradio-ს ზრდის სტრატეგიებს, მათ შორის, დაბალდონიანი API-ების განვითარებას მაღალი დონის აბსტრაქციების ნაცვლად, ვიწრო, მზარდ ნიშაზე ფოკუსირებას (ML ვებ აპლიკაციები) და მომხმარებლებისთვის გაზიარების მარტივი მექანიზმების შეთავაზებას.
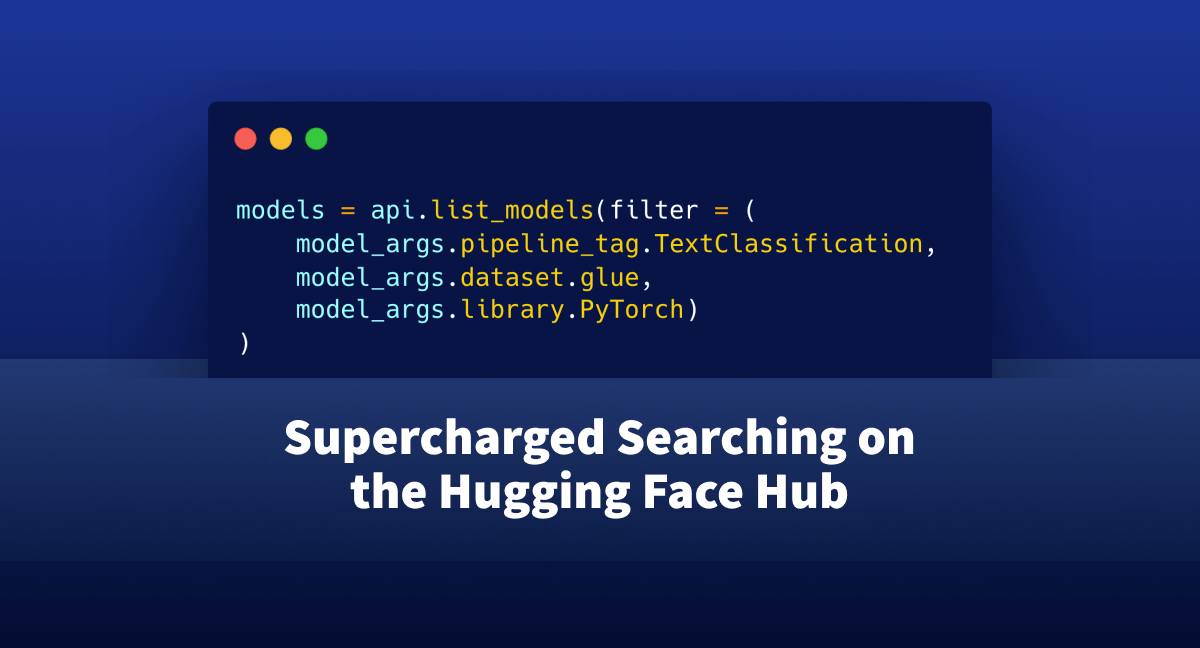
Hugging Face Hub-ის ძიების გამარტივება: პროგრამული ინტერფეისის ახალი შესაძლებლობები
სტატიაში წარმოდგენილია `huggingface_hub` ბიბლიოთეკის ახალი ფუნქციები, `ModelSearchArguments` და `ModelFilter`, რომლებიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე AI მოდელებისა და მონაცემთა ნაკრებების ძიებას პირდაპირ Python-ის ან Jupyter-ის გარემოდან. ეს სიახლე დეველოპერებს საშუალებას აძლევს, არ დატოვონ IDE და ეფექტურად მართონ რთული მოთხოვნები, რაც მნიშვნელოვნად აუმჯობესებს სამუშაო პროცესს.

Visual Salamandra: ახალი თაობის მულტიმოდალური AI ევროპული ენების აქცენტით
ენის ტექნოლოგიების ლაბორატორიამ წარმოადგინა Visual Salamandra, ინოვაციური მულტიმოდალური AI მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან. ეს სისტემა შექმნილია ვიზუალურ და ტექსტურ მონაცემებს შორის ხარვეზის შესავსებად, რის შედეგადაც მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანის საფუძველზე, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტური ინსტრუქციებიდან. Visual Salamandra გამოირჩევა მრავალენოვანი ინკლუზიურობით, განსაკუთრები
შეზღუდული სხივური ძიება: კონტროლი ტექსტის გენერაციის პროცესზე
ეს სტატია განიხილავს ტექსტის გენერაციის გაუმჯობესებულ მეთოდს – შეზღუდულ სხივურ ძიებას (constrained beam search). ჩვეულებრივი სხივური ძიებისგან განსხვავებით, ეს მეთოდი საშუალებას გვაძლევს ზუსტი კონტროლი მოვახდინოთ გენერირებულ გამოსავალზე. ის წყვეტს იმ გამოწვევებს, როდესაც საჭიროა კონკრეტული სიტყვების ან ფრაზების ჩართვა, მრავალი შეზღუდვის დაწესება ან ალტერნატიული სიტყვის ფორმების გათვალისწინება (განმყოფი შეზღუდვები). ამ მიდგომით, ტექსტის გენერაცია ხდება უფრო კონტექსტზე მორგებული და მომხმარებლის მი
Mixtral-ის გამოშვება: ახალი ნახტომი ხელოვნურ ინტელექტში ექსპერტთა ნაზავი (Mixture of Experts) არქიტექტურით
სტატია წარმოგიდგენთ Mixtral-ს, ახალ დიდ ენობრივ მოდელს (LLM), რომელიც იყენებს ექსპერტთა ნაზავის (MoE) არქიტექტურას, აერთიანებს 8 „ექსპერტ“ მოდელს ერთში. ხაზგასმულია Mixtral-ის შთამბეჭდავი წარმადობა, რომელიც აჭარბებს სხვა ღია წვდომის მოდელებს და უტოლდება GPT-3.5-ს MT-Bench ბენჩმარკზე. განმარტებულია მისი რეალური პარამეტრების რაოდენობა (დაახლოებით 45B, არა 56B) და დეტალურად აღწერილია მისი გამოყენება ინფერენციისა და ფაინ-თუნინგისთვის, ასევე Hugging Face-ზე განთავსების შესაძლებლობები.

olmOCR-ის გაუმჯობესება: სრული დოკუმენტის კონტექსტის ამოცნობა სათაურებისა და ქვედა კოლონტიტულების ჩათვლით
olmOCR ხშირად უგულებელყოფს მნიშვნელოვან ინფორმაციას დოკუმენტების სათაურებსა და ქვედა კოლონტიტულებში, რაც მის საწყის სატრენინგო მონაცემთა ბაზის თავისებურებებით იყო განპირობებული. ამ პრობლემის გადასაჭრელად, მკვლევრებმა olmOCR-ის მოდელი დახვეწეს Qwen2.5-VL-72B-Instruct-ის მიერ გენერირებული 8,000 დოკუმენტისგან შემდგარი ახალი მონაცემთა ბაზის გამოყენებით. შედეგად, მოდელი ახლა სრულყოფილად იღებს მთელ კონტენტს, მათ შორის ადრე გამოტოვებულ მონაცემებსაც, რაც გადამწყვეტია ბიზნეს აპლიკაციებისთვის, როგორიცაა ი

Gradio-ს ახალი შესაძლებლობები: LLM ინსტრუმენტების სერვერები Model Context Protocol-ით (MCP)
Gradio, პოპულარული Python ბიბლიოთეკა მანქანური სწავლების ინტერფეისებისთვის, ახლა მხარს უჭერს Model Context Protocol (MCP) სერვერების გაშვებას დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპლიკაციებს საშუალებას აძლევს ფუნქციონირებდნენ როგორც ხელსაწყოები LLM-ებისთვის, რაც მათ სთავაზობს დამატებით შესაძლებლობებს, როგორიცაა გამოსახულების გენერაცია, აუდიო სინთეზი ან კონკრეტული გამოთვლები. სტატია აღწერს, თუ როგორ შეიძლება რამდენიმე ხაზი კოდით Gradio-ს MCP სერვერად გადაქცევა და წარმოადგენს მის
ONNX Runtime მნიშვნელოვნად აჩქარებს SD Turbo-სა და SDXL Turbo-ს NVIDIA GPU-ებზე
SD Turbo და SDXL Turbo, Stable Diffusion-ის სწრაფი, გენერაციული ტექსტიდან გამოსახულების მოდელები, რომლებსაც შეუძლიათ გამოსაყენებელი სურათების გენერირება ერთ ნაბიჯში, ახლა ONNX Runtime-ის მეშვეობით კიდევ უფრო სწრაფი ხდება. ONNX Runtime-ის CUDA და TensorRT შესრულების პროვაიდერებში ოპტიმიზაციებმა გამოიწვია გამტარუნარიანობის 229%-მდე ზრდა SDXL Turbo-სთვის და 120%-მდე SD Turbo-სთვის NVIDIA GPU-ებზე, რაც მნიშვნელოვნად აღემატება PyTorch-ის მაჩვენებლებს. ეს გაუმჯობესება, გარდა შესრულების უპირატესობებისა

ხილვად-ენობრივი მოდელების ტრანსფორმაცია: ბოლო ერთი წლის მიღწევები
სტატია მიმოიხილავს ხილვად-ენობრივი მოდელების (VLMs) განვითარებას ბოლო ერთი წლის განმავლობაში, LLaVA-ს თავდაპირველი წარმატებიდან უფრო მძლავრი, კომპაქტური და მრავალფეროვანი არქიტექტურების გამოჩენამდე. განხილულია ახალი პარადიგმები, როგორიცაა 'ნებისმიერი-ნებისმიერზე' (any-to-any) მოდელები, მულტიმოდალური RAG, მსჯელობის მოდელები და მცირე ზომის VLMs-ის ტენდენცია, რომლებსაც შეუძლიათ სამომხმარებლო მოწყობილობებზე მუშაობა.
მომხმარებელთა მხარდაჭერის ავტომატიზაცია NLP-ის გამოყენებით: უკმაყოფილო კლიენტების იდენტიფიკაცია
წინამდებარე სტატია განმარტავს, თუ როგორ შეიძლება ბუნებრივი ენის დამუშავების (NLP) მოდელების გამოყენება მომხმარებელთა მხარდაჭერის პროცესების ნაწილობრივი ავტომატიზაციისთვის. განხილულია ჰიპოთეტური შემთხვევა, სადაც NLP გამოიყენება განსაკუთრებით უკმაყოფილო მომხმარებლების შეტყობინებების იდენტიფიცირებისა და პრიორიტეტულობისთვის, რაც ზრდის პასუხის ეფექტურობასა და კლიენტების კმაყოფილებას. მოცემულია ნაბიჯები გამოყენების შემთხვევის განსაზღვიდან მონაცემთა ნაკრებებისა და მოდელების შერჩევამდე Hugging Face-ის პ
Hugging Face-ი მანქანურ სწავლებას ყველასთვის ხელმისაწვდომს ხდის: 5 მილიონი ადამიანის განათლების მიზანი
როგორც ღია კოდის კომპანია, რომელიც მანქანური სწავლების დემოკრატიზაციას ახდენს, Hugging Face-ი მიზნად ისახავს 2023 წლის ბოლოსთვის 5 მილიონი ადამიანისთვის მანქანური სწავლების სწავლებას. კომპანიამ უკვე მოამზადა 1000-ზე მეტი სტუდენტი 16 ქვეყნიდან 2022 წლის მარტში და ახლა აფართოებს თავის საგანმანათლებლო ინიციატივებს უფასო ონლაინ კურსებით, ვორქშოფებითა და რესურსებით პედაგოგებისთვის, რათა მანქანური სწავლების პოტენციალი და შეზღუდვები ყველასთვის გასაგები გახადოს.
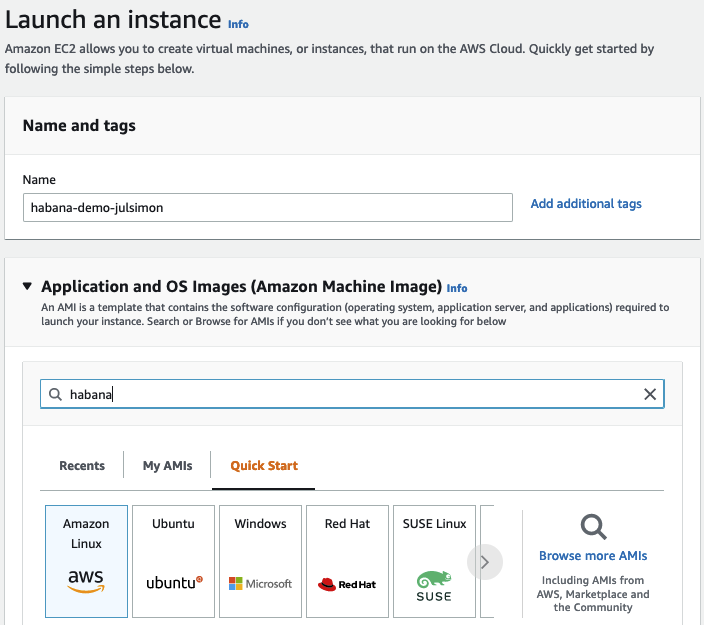
Habana Gaudi-ის ამაჩქარებლები და Transformer-ები: მაღალი წარმადობა და ხარჯთეფექტურობა AWS-ზე
Habana Gaudi-ის ახალი ამაჩქარებლები Amazon EC2 ინსტანციებზე უზრუნველყოფენ 40%-მდე უკეთეს ფასი-წარმადობას მანქანური სწავლის მოდელების, განსაკუთრებით Transformer-ების, წვრთნისთვის, უახლეს GPU-ებთან შედარებით. ეს პოსტი აღწერს, თუ როგორ სწრაფად დავაყენოთ Habana Gaudi ინსტანცია AWS-ზე და დავხვეწოთ BERT მოდელი ტექსტის კლასიფიკაციისთვის, რაც დემონსტრირებას უკეთებს ამ ტექნოლოგიის სიმარტივესა და ხარჯთეფექტურობას.
ღია კოდის LLM-ები აგენტურ სისტემებს აძლიერებენ: Mixtral-მა GPT-3.5-საც კი აჯობა
ღია კოდის დიდი ენობრივი მოდელები (LLM) ახლა მიაღწიეს ისეთ დონეს, რომ შეუძლიათ აგენტური სამუშაო პროცესების მართვა, Mixtral-8x7B-მა კი ტესტებში GPT-3.5-საც კი აჯობა. სტატია წარმოგიდგენთ `smolagents`-ს, ახალ ბიბლიოთეკას აგენტების შესაქმნელად, და განმარტავს, თუ როგორ შეიძლება LLM-ების ინტეგრირება ხელსაწყოებთან „LLM აგენტების“ შესაქმნელად. ის დეტალურად განიხილავს ReAct აგენტების (მსჯელობა + მოქმედება) კონცეფციას, აჩვენებს მათ შექმნას LangChain-ის ChatHuggingFace კლასის გამოყენებით და წარმოადგენს ტესტ

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად