
დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M

Falcon-Arabic: ტექნოლოგიური ინსტიტუტის ახალი ენის მოდელი არაბული ხელოვნური ინტელექტის საზღვრებს ცვლის
არაბთა გაერთიანებული საამიროების ტექნოლოგიური ინოვაციების ინსტიტუტმა (TII) წარმოადგინა Falcon-Arabic, 7 მილიარდი პარამეტრის მრავალენოვანი ენის მოდელი, რომელიც ახალ სტანდარტებს ადგენს არაბული ბუნებრივი ენის დამუშავებისთვის (NLP). Falcon 3 არქიტექტურაზე აგებული, Falcon-Arabic მნიშვნელოვნად აღემატება არსებულ არაბულ LLM-ებს ეფექტურობითა და შესაძლებლობებით, რაც ხელს უწყობს არაბულენოვანი საზოგადოებების სრულ ინტეგრაციას ხელოვნური ინტელექტის რევოლუციაში და უზრუნველყოფს უფრო ბუნებრივ, ინტელექტუალურ და ინ

Dell Enterprise Hub: ხელოვნური ინტელექტის გადაწყვეტილებების სრული ეკოსისტემა საწარმოებისთვის
Dell Enterprise Hub აფართოებს ხელოვნური ინტელექტის გადაწყვეტილებების სპექტრს, სთავაზობს ოპტიმიზებულ მოდელებს (Meta Llama 4, Google Gemma 3) და მზა აპლიკაციებს Dell-ის AI სერვერებისა და AI კომპიუტერებისთვის. პლატფორმა უზრუნველყოფს სწრაფ, ადგილობრივ განთავსებას Docker-ის, Kubernetes-ის და ახალი Dell Pro AI Studio-ს მეშვეობით, ასევე წარმოგიდგენთ `dell-ai` ღია კოდის ბიბლიოთეკას, რაც საწარმოებს საშუალებას აძლევს, ეფექტურად ინტეგრირდნენ გენერაციულ ხელოვნურ ინტელექტთან.
Sempre Health-მა Hugging Face-ის დახმარებით შემომავალი შეტყობინებების 20%-ის ავტომატური დამუშავება დაიწყო
Sempre Health-მა Hugging Face-თან თანამშრომლობით დანერგა ახალი NLP პაიპლაინი, რომელმაც შემომავალი შეტყობინებების ავტომატური კლასიფიცირება და რეაგირება დაიწყო. ამ ინოვაციამ მნიშვნელოვნად გაზარდა ბიზნესის მასშტაბურობა და გუნდის ეფექტურობა, რადგან ახლა ყოველდღიური შეტყობინებების 20%-ზე მეტი სისტემის მიერ ავტომატურად მუშავდება. „ექსპერტთა აჩქარების პროგრამამ“ Sempre Health-ს საშუალება მისცა სწრაფად განეხორციელებინა ეს ცვლილება და შეემცირებინა დაბალღირებული სამუშაო დატვირთვა.
Hugging Face და Argilla: ერთობლივი ძალებით უკეთესი მონაცემთა ბაზებისთვის
Hugging Face და Argilla ერთობლივ ინიციატივას იწყებენ, რათა საზოგადოებას დაეხმარონ მაღალი ხარისხის მონაცემთა ბაზების შექმნაში, განსაკუთრებით ნაკლებად წარმოდგენილი ენებისა და ამოცანებისთვის. პროექტი გულისხმობს ინსტრუმენტების, როგორიცაა Argilla და Hugging Face Spaces, გამოყენებას ანოტაციის პროცესის გასამარტივებლად. მოწვეულნი არიან დაინტერესებული თემები, რათა შეუერთდნენ საწყის კოჰორტას და წვლილი შეიტანონ ხელოვნური ინტელექტის განვითარებაში, კოდირების ცოდნის გარეშეც.

OOM შეცდომები წარსულს ჩაბარდა: დიდი მოდელების ვარჯიში DeepSpeed ZeRO-სა და Accelerate-ით
სტატია განმარტავს, თუ როგორ შეიძლება თავიდან ავიცილოთ მეხსიერების უკმარისობის (OOM) შეცდომები დიდი ხელოვნური ინტელექტის მოდელების ვარჯიშისას. იგი აღწერს DeepSpeed ZeRO ოპტიმიზატორის გამოყენებას Accelerate ბიბლიოთეკასთან ერთად, რაც საშუალებას იძლევა, ეფექტურად გამოვიყენოთ არსებული აპარატურა, გავზარდოთ პაკეტის ზომა და დავაჩქაროთ ვარჯიშის პროცესი. წარმოდგენილია შედარებები DDP-სა და DeepSpeed ZeRO Stage-2-ს შორის, რაც აჩვენებს მნიშვნელოვან გაუმჯობესებას შესრულებაში.
Hugging Face-ი და NVIDIA-ი „ტრენინგს DGX Cloud-ზე“ უშვებენ Enterprise Hub-ის ორგანიზაციებისთვის
Hugging Face-მა NVIDIA-სთან ერთად წარადგინა „ტრენინგი DGX Cloud-ზე“, ახალი სერვისი Hugging Face Hub-ზე, რომელიც განკუთვნილია Enterprise Hub-ის ორგანიზაციებისთვის. ეს პლატფორმა მომხმარებლებს აძლევს მყისიერ წვდომას NVIDIA H100 Tensor Core GPU-ებზე, რათა მარტივად დახვეწონ პოპულარული გენერაციული AI მოდელები, როგორიცაა Llama, Mistral და Stable Diffusion. სერვისი ამარტივებს ხელოვნური ინტელექტის მოდელების წვრთნის პროცესს კოდის გარეშე მუშაობის (no-code) და მოხმარების მიხედვით გადახდის (pay-as-you-go) მო
Twitter-ზე სენტიმენტების ანალიზი: სრული გზამკვლევი
ეს გზამკვლევი წარმოგიდგენთ Twitter-ზე სენტიმენტების ანალიზის ყოვლისმომცველ, ნაბიჯ-ნაბიჯ პროცესს, რომელიც განკუთვნილია როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. ის განმარტავს სენტიმენტების ანალიზის არსს, მის მნიშვნელობას ბიზნესისთვის და გვიჩვენებს, თუ როგორ შეიძლება ისეთი ხელსაწყოების გამოყენება, როგორიცაა Inference API, Zapier და Python-ის ბიბლიოთეკები, რათა ტვიტებიდან ღირებული ინფორმაცია მოვიპოვოთ, მომხმარებელთა უკუკავშირი აღმოვაჩინოთ და ბრენდის ხსენებებს რეალურ დროში დავაკვირდეთ.
კოსმოპედია: უპრეცედენტო სინთეზური მონაცემები დიდი ენობრივი მოდელებისთვის
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) წვრთნისთვის ძვირადღირებული ადამიანური ანოტაციებიდან სინთეზურ მონაცემთა ნაკრებებზე გადასვლას. მიუხედავად იმისა, რომ Microsoft-ის Phi მოდელებმა სინთეზური მონაცემების გამოყენებით შესანიშნავი შედეგები აჩვენეს, მათი შექმნის დეტალები გაუმჟღავნებელი დარჩა. ამ ხარვეზის აღმოსაფხვრელად, წარმოდგენილია კოსმოპედია – უმსხვილესი ღია სინთეზური მონაცემთა ნაკრები (30 მილიონზე მეტი ფაილი, 25 მილიარდი „ტოკენი“), რომელიც გენერირებულია Mixtral-8x7B-Instruct-v0.1-ის მიერ

როგორ გავუშვათ მოწინავე LLM-ები ჩვეულებრივ ლეპტოპზე?
ოდესღაც შეუძლებლად მიჩნეული მაღალეფექტური დიდი ენობრივი მოდელების (LLM) გაშვება ჩვეულებრივ პერსონალურ კომპიუტერებზე დღეს უკვე რეალობაა. სტატია იკვლევს, თუ როგორ ხდის თანამედროვე ტექნოლოგიები, როგორიცაა აპარატურის აჩქარება (მათ შორის Intel Meteor Lake-ის NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია, შესაძლებელს ამ მიღწევას. განხილულია Microsoft-ის Phi-2 მოდელისა და Intel OpenVINO-ს ინტეგრაციის გამოყენება Intel Core Ultra პროცესორზე, რათა LLM-ები ეფექტურად იმუშაოს საშუალო დონის ლეპტოპებზე.
BLOOM: 176 მილიარდი პარამეტრის მოდელის შექმნის საინჟინრო მიღწევები და ტექნოლოგიები
პროექტი, რომელიც Hugging Face-ის თანადამფუძნებელმა თომას ვოლფმა წამოიწყო, მიზნად ისახავდა ერთ-ერთი უდიდესი მრავალენოვანი მოდელის შექმნას და მის ხელმისაწვდომობას ყველასთვის. ეს სტატია ფოკუსირებულია 176 მილიარდი პარამეტრის BLOOM მოდელის წვრთნის საინჟინრო ასპექტებზე, ხაზს უსვამს ექსპერტებისა და კომპანიების ერთობლივ ძალისხმევას. განხილულია ფრანგული სუპერკომპიუტერის Jean Zay გამოყენება და მოწინავე Megatron-DeepSpeed ფრეიმვორკი, რომელიც 3D პარალელიზმს იყენებს ეფექტური წვრთნისთვის.

AI-ის ეფექტურობის რევოლუცია: Hugging Face და AMD Llama 3.1-ს MI300X-ზე აუმჯობესებენ
ყოველდღიურად მილიარდობით AI მოთხოვნის დამუშავება, როგორიცაა ChatGPT-ის მიერ, მოდელის ოპტიმიზაციას გადამწყვეტ მნიშვნელობას ანიჭებს. განსაკუთრებით კრიტიკულია ბირთვის (kernel) დონის ოპტიმიზაცია, რაც ხშირად უგულებელყოფილია მრავალი მოწყობილობისთვის, განსაკუთრებით AMD GPU-ებისთვის. Hugging Face-მა AMD-სთან ითანამშრომლა, რათა შეემუშავებინა ღია წყაროს ოპტიმიზებული ბირთვები Llama 3.1 405B მოდელის მუშაობის გასაუმჯობესებლად FP8 ფორმატში, 8 MI300X GPU-ით აღჭურვილ კვანძზე, VLLM-ის გამოყენებით. ეს პარტნიორობა

Hugging Face-ის MCP სერვერის შექმნა: AI ასისტენტების დაკავშირების გამოცდილება და პროტოკოლის ევოლუცია
Hugging Face-ის გუნდი დეტალურად აღწერს Model Context Protocol (MCP) სერვერის შექმნის პროცესს, რომელიც ხელოვნური ინტელექტის ასისტენტებს გარე სამყაროსთან აკავშირებს. სტატია აანალიზებს პროტოკოლის სწრაფ ევოლუციას, ტრანსპორტის სხვადასხვა ვარიანტს (STDIO, HTTP SSE-ით, ნაკადოვანი HTTP) და იმ ტექნიკურ გადაწყვეტილებებს, რომლებიც Hugging Face-მა მიიღო ოპტიმალური, დინამიური და ადვილად ხელმისაწვდომი hf.co/mcp სერვერის შესაქმნელად. ყურადღება ექცევა უსტატუსო, პირდაპირი პასუხის კონფიგურაციის არჩევანს წარმოების
SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
DuckDB-NSQL-7B: ხელოვნური ინტელექტით SQL შეკითხვების გენერირება მონაცემთა ანალიზისთვის
დეველოპერები და ანალიტიკოსები სულ უფრო მეტად აფასებენ ხელოვნური ინტელექტის (AI) პოტენციალს მონაცემთა ანალიზის გასამარტივებლად. ტრადიციული SQL შეკითხვების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, თუმცა AI-ზე დაფუძნებული გადაწყვეტილებები, როგორიცაა MotherDuck-ისა და Numbers Station-ის DuckDB-NSQL-7B მოდელი, ამ პროცესს არა-დეველოპერებისთვისაც ხელმისაწვდომს ხდის. სტატია დეტალურად აღწერს, თუ როგორ შეუძლია ამ LLM-ს ბუნებრივი ენის გამოყენებით SQL ოპერატორების გენერირება, Hugging Face მონაცემთა ნაკრებებთა

Hugging Face Hub-ი Xet-ზე გადავიდა: უხმაურო ტექნოლოგიური რევოლუცია
Hugging Face Hub-მა წარმატებით და თითქმის შეუმჩნევლად მოახდინა მიგრაცია Xet-ის შენახვის სისტემაზე, რომელსაც დღეისათვის 1 მილიონზე მეტი მომხმარებელი იყენებს. მაისიდან Xet Hub-ზე ახალი მომხმარებლებისა და ორგანიზაციებისთვის ნაგულისხმევად იქცა. მიგრაცია განხორციელდა მომხმარებლის მინიმალური ზემოქმედებით, გუნდის წლების გამოცდილების, კონტენტ-მისამართადი საცავის (CAS) და Rust კლიენტის წყალობით. ძირითადი დიზაინერული გადაწყვეტილებები მოიცავდა სამუშაო პროცესის შენარჩუნებას და Xet-ის არა-მხარდამჭერი კლიენტე
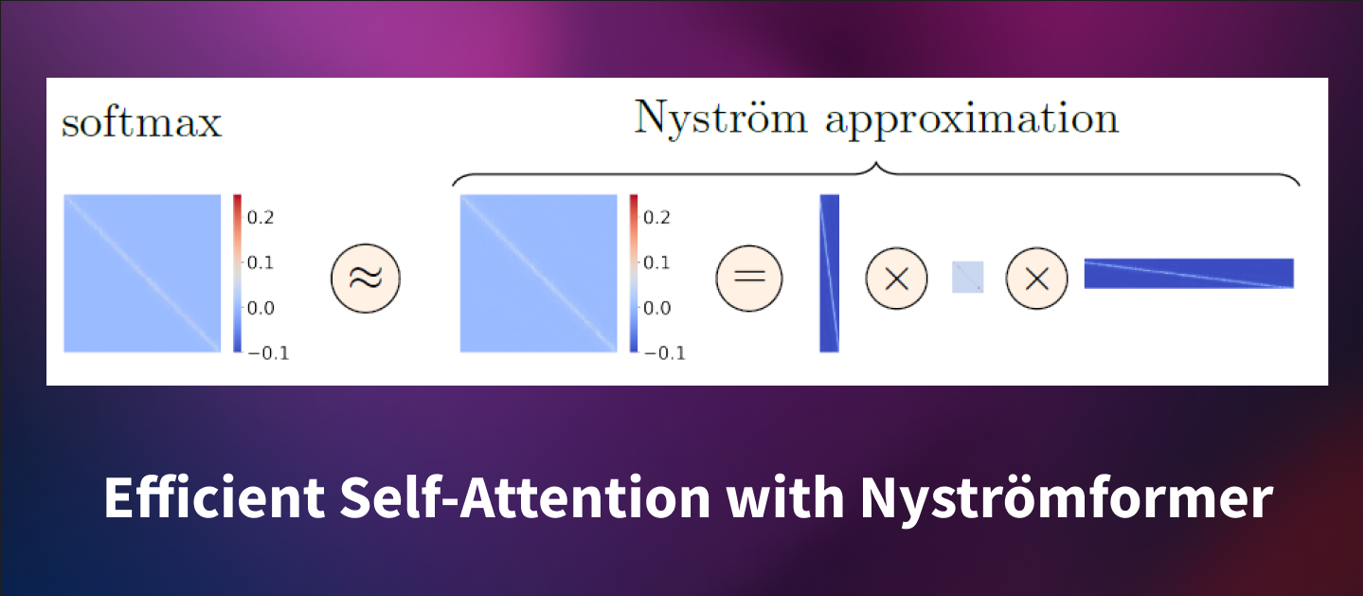
Nyströmformer: ტრანსფორმერების თვითყურადღების მექანიზმის ოპტიმიზაცია ნიუსტრიომის მეთოდით
ტრანსფორმერებმა შთამბეჭდავი შედეგები აჩვენეს ბუნებრივი ენის დამუშავებისა (NLP) და კომპიუტერული ხედვის (CV) ამოცანებში, თუმცა მათი სტანდარტული თვითყურადღების მექანიზმი ხასიათდება O(n²) სირთულით, რაც მის წვრთნას ძვირადღირებულს ხდის გრძელი თანმიმდევრობებისთვის. Nyströmformer წარმოადგენს ეფექტურ ტრანსფორმერულ მოდელს, რომელიც ნიუსტრიომის მეთოდის გამოყენებით სტანდარტულ თვითყურადღებას O(n) სირთულით აპროქსიმირებს. ეს სტატია განმარტავს ნიუსტრიომის მეთოდს და მის ადაპტირებას თვითყურადღების მექანიზმის ოპტიმ
Hugging Face Hub: მანქანური სწავლების პროექტების დაჩქარება და კოლაბორაცია
სტატია განიხილავს მანქანური სწავლების (ML) განვითარების გამოწვევებს, როგორიცაა მოდელების პროდუქტიულ ფაზაში ვერ გადასვლა და თანამშრომლობის სირთულეები. წარმოდგენილია Private Hub-ისა და განსაკუთრებით Hugging Face Hub-ის როლი, როგორც ამ პრობლემების გადაწყვეტა. Hugging Face Hub გთავაზობთ ღია წყაროს პლატფორმას მოდელების, მონაცემთა ნაკრებებისა და აპლიკაციების ფართო კოლექციით, Git-ზე დაფუძნებულ რეპოზიტორიებსა და თანამშრომლობით ხელსაწყოებს ML სამუშაო პროცესების დასაჩქარებლად, კვლევიდან დაწყებული წარმოება

Gradio MCP სერვერების მასშტაბური განახლება: ვერსია 5.38.0-ის ახალი ფუნქციები
Gradio-მ გამოუშვა MCP სერვერების 5.38.0 ვერსია, რომელსაც ემატება მნიშვნელოვანი გაუმჯობესებები. ახლა შესაძლებელია ფაილების პირდაპირი ატვირთვა, AI ამოცანების პროგრესის რეალურ დროში მონიტორინგი, API-ების ავტომატური ინტეგრაცია OpenAPI-ის მეშვეობით, გაუმჯობესებული აუთენტიფიკაცია და ხელსაწყოების აღწერის მორგება. ეს განახლება დეველოპერებს მუშაობას უმარტივებს და ზრდის Gradio აპლიკაციების შესაძლებლობებს.
Hugging Face-ის ტრანსფორმატორები TensorFlow-ის ინჟინრებისთვის: გზამკვლევი
სტატია განიხილავს PyTorch-ის ინჟინრების მიერ TensorFlow-თან მიდგომის ხშირ შეცდომას, კერძოდ, Keras-ის მაღალი დონის API-ის უგულებელყოფას. ხაზგასმულია, რომ Keras-ის გამოყენება TensorFlow-სთან ოპტიმალურია. შემდეგ წარმოდგენილია Hugging Face-ის ტრანსფორმატორები, როგორც ძლიერი ინსტრუმენტები, რომლებიც TensorFlow-ის ინჟინრებს საშუალებას აძლევს, გამოიყენონ უახლესი მოდელები ნაცნობი Keras API-ის მეშვეობით. დეტალურად არის ახსნილი ტრანსფერული სწავლის (transfer learning) კონცეფცია, როგორც ML პრობლემების გადაჭრ

Flux.1-Dev მოდელის ინფერენციის ოპტიმიზაცია LoRA-ს გამოყენებით: 2.3x-მდე სიჩქარის ზრდა
ეს პოსტი დეტალურად განიხილავს Flux.1-Dev ტექსტიდან გამოსახულების გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაციას, განსაკუთრებით LoRA-ების გამოყენებისას. შემოთავაზებულია "ცხელი გაცვლის" (hotswapping) ტექნიკა ხელახალი კომპილაციის თავიდან ასაცილებლად, FP8 კვანტიზაციის უპირატესობები, და სტრატეგიები სამომხმარებლო GPU-ებისთვის, როგორიცაა RTX 4090, CPU-ზე გადმოტვირთვით და T5 ტექსტური ენკოდერის კვანტიზაციით, რაც უზრუნველყოფს 2.3-ჯერადი სიჩქარის ზრდას.

Parquet-ის კონტენტზე დაფუძნებული დანაწილება (CDC) Hugging Face Xet-ზე მონაცემთა ეფექტური შენახვისთვის
Parquet-ის კონტენტზე დაფუძნებული დანაწილება (CDC) უკვე ხელმისაწვდომია PyArrow-სა და Pandas-ში, რაც Parquet ფაილების მაღალეფექტურ დედუპლიკაციას იძლევა ისეთ კონტენტ-მისამართებად საცავ სისტემებზე, როგორიცაა Hugging Face-ის Xet. ეს ინოვაცია მნიშვნელოვნად ამცირებს მონაცემთა გადაცემისა და შენახვის ხარჯებს, რადგან მხოლოდ შეცვლილი მონაცემთა ნაწილები მუშავდება.
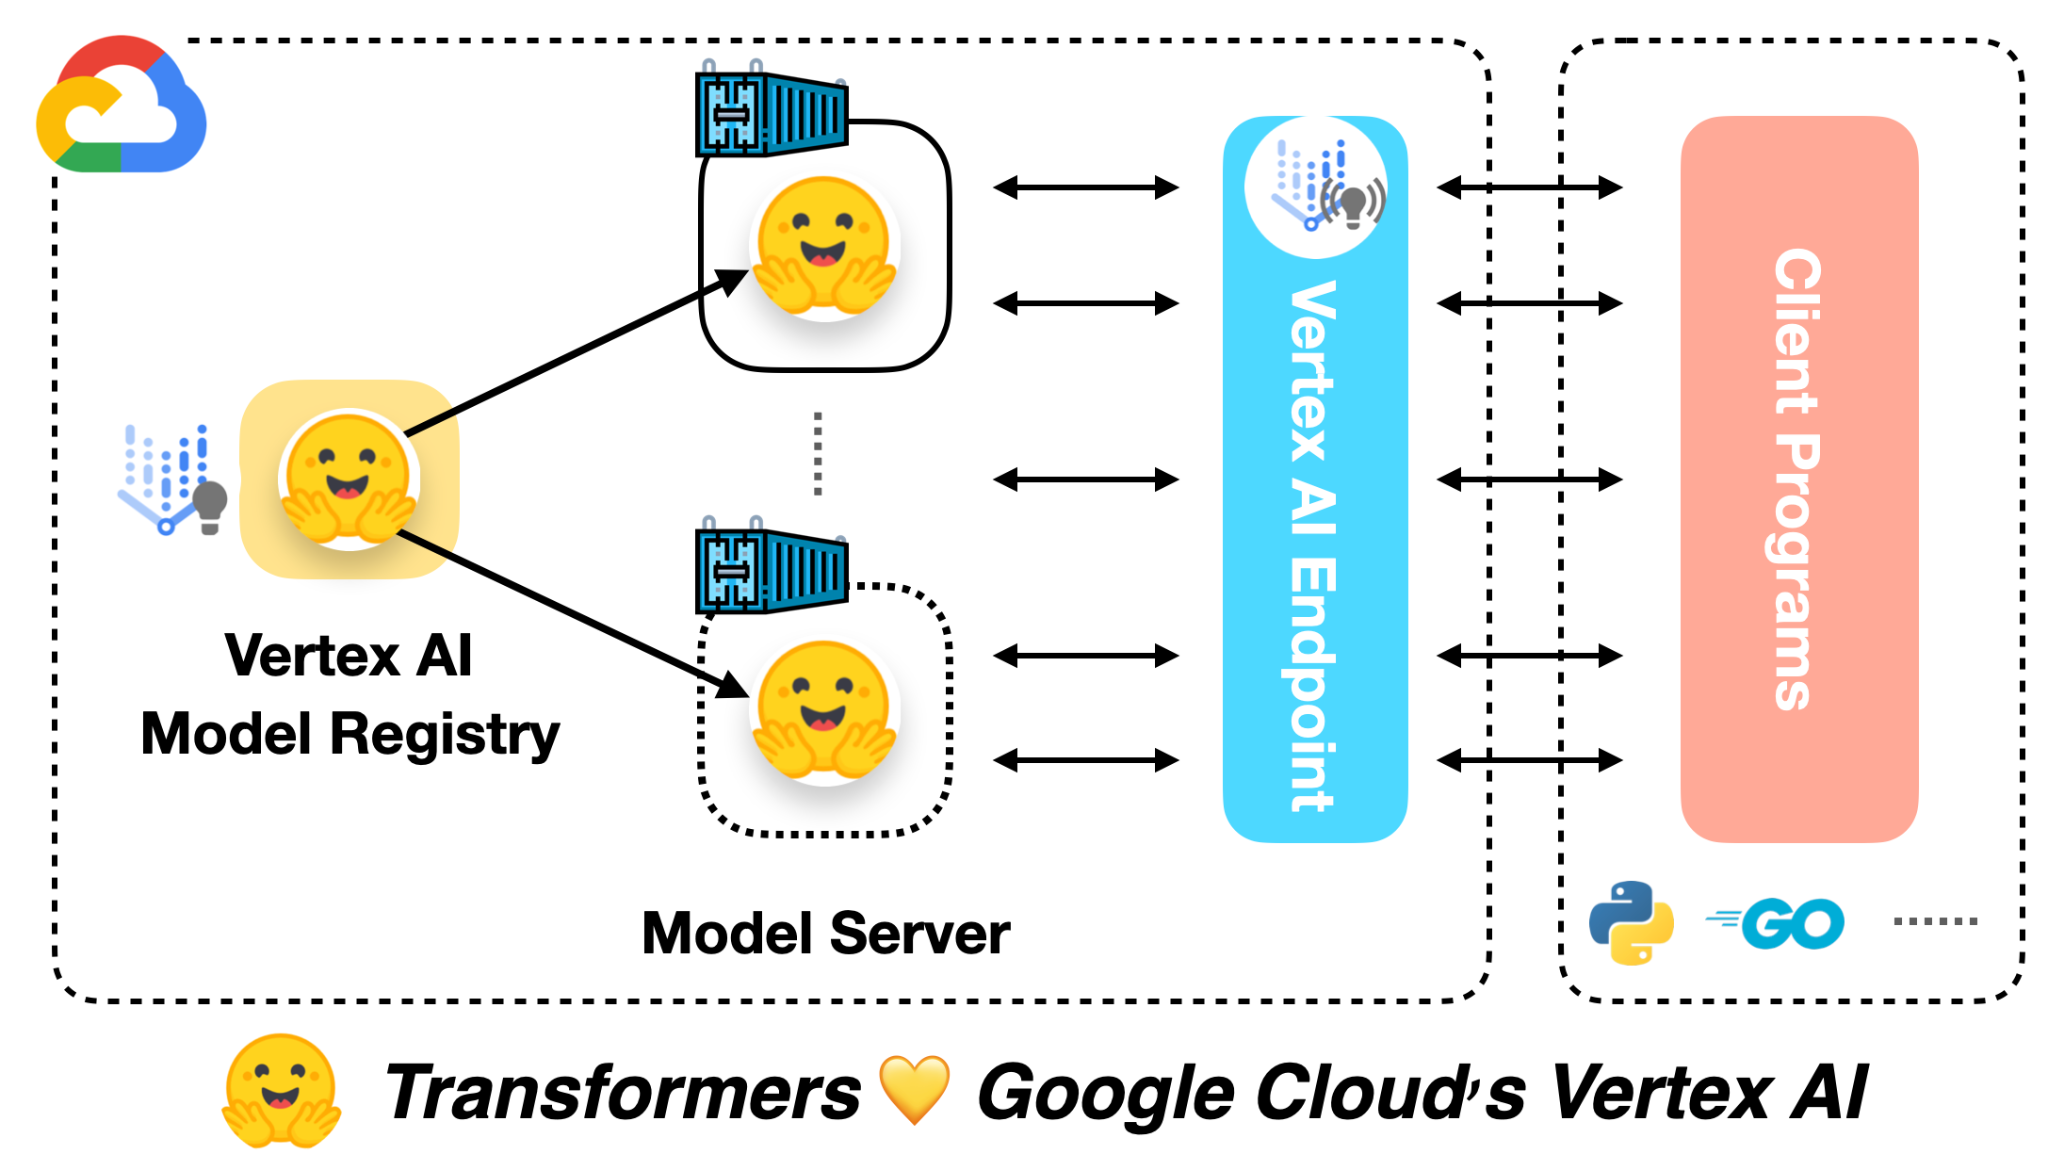
Vertex AI-ის გამოყენება ML მოდელების განლაგებისთვის: დეტალური მიმოხილვა
ეს პუბლიკაცია განიხილავს Google Cloud-ის Vertex AI პლატფორმის შესაძლებლობებს მანქანური სწავლის (ML) მოდელების განლაგებისთვის. ის მოიცავს ისეთ ფუნქციებს, როგორიცაა აუთენტიფიკაცია, ავტომატური სკალირება, მოდელის ვერსიონირება და მონიტორინგი, ასევე TensorFlow მოდელებთან მუშაობის სპეციფიკას. განმარტებულია Vertex AI Model Registry-ის და Endpoint-ის როლი, და მოცემულია განლაგების ნაბიჯ-ნაბიჯ ინსტრუქცია Python SDK-ის გამოყენებით.

Hugging Face-ის ბრძანების ხაზის ინტერფეისი იცვლის სახეს: გაიცანით „hf“
Hugging Face-მა განაახლა თავისი ბრძანების ხაზის ინტერფეისი (CLI), შემოიღო ახალი, გამარტივებული `hf <რესურსი> <მოქმედება>` სინტაქსი, რომელიც ჩაანაცვლებს `huggingface-cli`-ს. ეს ცვლილება მიზნად ისახავს ბრძანებების სტრუქტურის გაუმჯობესებას, მეტი ერგონომიულობის შეთავაზებას და მომავალი ფუნქციებისთვის გზის გაკვალვას. დაინერგა ახალი სერვისი, `hf jobs`, რომელიც მომხმარებლებს საშუალებას აძლევს, გაუშვან სკრიპტები Hugging Face-ის ინფრასტრუქტურაზე. ძველი CLI დროებით ფუნქციონალური დარჩება გადასვლის გასაადვილ