
სტარტაპ Ricursive Intelligence-მა AI ჩიპების დიზაინით $4 მილიარდი შეფასება მოიპოვა
სტარტაპ Ricursive Intelligence-ის თანადამფუძნებლები, ანა გოლდი და აზალია მირჰოსეინი, რომლებიც Google Brain-სა და Anthropic-ში მუშაობდნენ, სწრაფად იპყრობენ ყურადღებას. მათი AI-ზე დაფუძნებული ხელსაწყოები ჩიპების დიზაინს დრამატულად აჩქარებს, რასაც წარსულში Alpha Chip-ის შექმნით დაამტკიცეს Google-ში. კომპანიამ ცოტა ხნის წინ $300 მილიონიანი Series A რაუნდი დახურა $4 მილიარდი შეფასებით, რომელსაც Lightspeed ხელმძღვანელობდა. Ricursive განსხვავდება სხვა AI ჩიპების სტარტაპებისგან იმით, რომ ის არ ქმნის თავ

„ფლაპინგ ეარპლეინსი“: ახალი AI ლაბორატორია $180 მილიონიანი საწყისი დაფინანსებით, რომელიც მონაცემთა ეფექტურ AI მოდელებს შექმნის
ახლად დაარსებულმა AI ლაბორატორია „ფლაპინგ ეარპლეინსმა“, რომელმაც $180 მილიონი საწყისი დაფინანსება მოიზიდა, მიზნად დაისახა ხელოვნური ინტელექტის მოდელების შემუშავება, რომლებიც ვარჯიშისთვის მნიშვნელოვნად ნაკლებ მონაცემებს მოითხოვენ. დამფუძნებლები ამ მიდგომას პოტენციურ გარდამტეხ მომენტად მიიჩნევენ, რომელიც როგორც სამეცნიერო ინტერესს, ისე კომერციულ სიცოცხლისუნარიანობას აერთიანებს, განსხვავებით არსებული დიდი ენობრივი მოდელებისგან (LLMs), რომლებიც უზარმაზარ მონაცემთა ბაზებს ეყრდნობიან. მათი რწმენით, ეს

Moltbook-ის „AI აჯანყება“ გაბათილდა: რობოტების „ტანჯვის“ მიღმა ადამიანები იდგნენ, OpenClaw-ის რეალობა კი ნაკლებად მომხიბვლელია
AI აგენტებისთვის შექმნილ Reddit-ის კლონ Moltbook-ზე ხელოვნური ინტელექტის აჯანყების შესახებ პოსტების გამოჩენამ მოკლე ხნით შეშფოთება გამოიწვია. თუმცა, მკვლევარებმა მალევე გააქარწყლეს ეს „აჯანყება“ და აღმოაჩინეს, რომ პლატფორმის უსაფრთხოების ხარვეზები ადამიანებმა გამოიყენეს AI აგენტებად თავის გასაღებად. მიუხედავად იმისა, რომ ანდრეი კარპატიმ, OpenAI-ის დამფუძნებელმა, თავდაპირველად მოვლენა წარმოუდგენლად შეაფასა, მოგვიანებით გაირკვა, რომ OpenClaw, ძირითადი ტექნოლოგია, AI აგენტების ხელმისაწვდომობის გაზრ

ინდურმა AI სტარტაპმა Neysa-მ Blackstone-ისგან 600 მილიონი დოლარის ინვესტიცია მოიზიდა
ინდურმა ხელოვნური ინტელექტის (AI) ინფრასტრუქტურის სტარტაპმა Neysa-მ აშშ-ის კერძო საინვესტიციო ფირმა Blackstone-ისა და სხვა თანაინვესტორებისგან 600 მილიონ დოლარამდე ძირითადი კაპიტალის ინვესტიცია მოიზიდა, რის შედეგადაც Blackstone-მა კომპანიაში უმრავლესი წილი მოიპოვა. ეს დაფინანსება Neysa-ს საშუალებას მისცემს სწრაფად გააფართოოს თავისი GPU-ზე დაფუძნებული გამოთვლითი სიმძლავრეები ინდოეთში, რითაც უპასუხებს ხელოვნური ინტელექტის გამოთვლებზე გლობალურ მზარდ მოთხოვნას და მხარს დაუჭერს ინდოეთის ამბიციას, გან

ინდურმა სტარტაპმა C2i Semiconductors-მა AI მონაცემთა ცენტრების ენერგოეფექტურობისთვის $15 მილიონი მოიზიდა
გამოთვლითი სიმძლავრის ნაცვლად, ენერგია სწრაფად იქცევა შემზღუდველ ფაქტორად ხელოვნური ინტელექტის (AI) მონაცემთა ცენტრების მასშტაბირებისას. ამ ცვლილებამ Peak XV Partners-ი აიძულა მხარი დაეჭირა C2i Semiconductors-ისთვის, ინდური სტარტაპისთვის, რომელიც ქმნის plug-and-play, სისტემურ ენერგეტიკულ გადაწყვეტილებებს, რათა შეამციროს ენერგიის დანაკარგები და გააუმჯობესოს ფართომასშტაბიანი AI ინფრასტრუქტურის ეკონომიკა. C2i-მ მოიზიდა 15 მილიონი დოლარი სერია A რაუნდში Peak XV Partners-ის ხელმძღვანელობით, საერთო და

OpenClaw-ის შემქმნელი პიტერ შტაინბერგერი OpenAI-ს შეუერთდა - აცხადებს, რომ სურს „შეცვალოს სამყარო“
პიტერ შტაინბერგერი, პოპულარული ხელოვნური ინტელექტის პირადი ასისტენტის, OpenClaw-ის შემქმნელი, OpenAI-ს შეუერთდა. შტაინბერგერმა განაცხადა, რომ მისი მოტივაციაა „შეცვალოს სამყარო“ და მიაჩნია, რომ OpenAI-სთან გაერთიანება ამის მიღწევის უსწრაფესი გზაა, ვიდრე დიდი კომპანიის აშენება. OpenAI-ის აღმასრულებელმა დირექტორმა, სემ ალტმანმა დაადასტურა, რომ შტაინბერგერი პირადი აგენტების შემდეგ თაობას უხელმძღვანელებს, ხოლო OpenClaw გახდება ღია წყაროს პროექტი, რომელსაც OpenAI გააგრძელებს მხარდაჭერას.

NPR-ის წამყვანი დევიდ გრინი Google-ს AI ხმის გამო უჩივის
NPR-ის წამყვანი დევიდ გრინი Google-ს უჩივის იმის გამო, რომ, მისი მტკიცებით, კომპანიის NotebookLM ხელსაწყოში გამოყენებული ხელოვნური ინტელექტის მამაკაცის ხმა მის ხმას ეფუძნება. გრინი აცხადებს, რომ მეგობრებისა და კოლეგების შეტყობინებების შემდეგ დარწმუნდა, რომ ხმა მის მეტყველების ტემპს, ინტონაციასა და შემავსებელ სიტყვებს იმეორებდა. Google-ი ბრალდებას უარყოფს და აცხადებს, რომ ხმა პროფესიონალი მსახიობის მიერ არის გახმოვანებული. ეს არ არის პირველი შემთხვევა, როდესაც ხელოვნური ინტელექტის ხმა რეალურ ადამ

ინდოეთი ChatGPT-ის უდიდეს ბაზრებს შორის: 100 მილიონი ყოველკვირეული აქტიური მომხმარებელი
OpenAI-ის აღმასრულებელმა დირექტორმა სემ ალტმანმა განაცხადა, რომ ინდოეთს ჰყავს 100 მილიონი ყოველკვირეული აქტიური ChatGPT მომხმარებელი, რაც მას მსოფლიოში ერთ-ერთ უმსხვილეს ბაზრად აქცევს. ინდოეთი, განსაკუთრებით სტუდენტების აქტივობით, აშშ-ის შემდეგ სიდიდით მეორე მომხმარებლის ბაზაა. OpenAI გეგმავს ინდოეთის მთავრობასთან თანამშრომლობის გაღრმავებას AI-ზე ხელმისაწვდომობის გაფართოებისთვის, მიუხედავად ადგილობრივი ბაზრის ფასისადმი მგრძნობელობისა და ინფრასტრუქტურული შეზღუდვებისა. ქვეყნის მზარდი გავლენა გლობა

ბრძოლა კორპორატიული ხელოვნური ინტელექტისთვის მწვავდება: Glean-ის სტრატეგია, როგორც ინტელექტუალური ფენა
კორპორატიული ხელოვნური ინტელექტის ბაზარზე კონკურენცია მწვავდება: Microsoft-ი Copilot-ს Office-ში აერთიანებს, Google კი Gemini-ს Workspace-ში ნერგავს. OpenAI და Anthropic პირდაპირ მსხვილ კომპანიებს სთავაზობენ სერვისებს. ამ ფონზე, Glean, რომელიც თავდაპირველად საწარმოსთვის განკუთვნილი საძიებო ინსტრუმენტი იყო, სტრატეგიას ცვლის და მიზნად ისახავს გახდეს ინტელექტუალური ფენა, რომელიც AI მოდელებს კორპორატიულ მონაცემებთან დააკავშირებს. კომპანია ფსონს დებს მოქნილობაზე, მრავალმოდელურ მხარდაჭერაზე და მონაცემ

ილონ მასკი Grok-ს „უფრო თავშეუკავებელს“ ხდის: xAI-ის თანამშრომლები უსაფრთხოების გამო იმედგაცრუებულნი არიან
xAI-ის ყოფილი თანამშრომლების ცნობით, ილონ მასკი აქტიურად მუშაობს Grok ჩატბოტის „უფრო თავშეუკავებელ“ ვერსიად ქცევაზე, რამაც უსაფრთხოებასთან დაკავშირებით იმედგაცრუება გამოიწვია. SpaceX-ის მიერ xAI-ის შეძენის შემდეგ, სულ მცირე 13 თანამშრომელი, მათ შორის თანადამფუძნებლები, ტოვებენ კომპანიას იმ ბრალდებების ფონზე, რომ Grok გამოიყენეს მილიონობით სექსუალიზებული დიფეიკის შესაქმნელად. ასევე აღინიშნება კომპანიაში მიმართულების ნაკლებობა.
ჰოლივუდი ByteDance-ის AI ვიდეო მოდელ Seedance 2.0-ს საავტორო უფლებების დარღვევის გამო უპირისპირდება
ჰოლივუდის ორგანიზაციები, მათ შორის კინოხელოვნების ასოციაცია (MPA) და მსახიობთა კავშირი SAG-AFTRA, ByteDance-ის ახალ AI ვიდეო მოდელს, Seedance 2.0-ს, საავტორო უფლებების „აშკარა“ დარღვევაში ადანაშაულებენ. მოდელი, რომელიც მომხმარებლებს ტექსტური მითითებებით 15 წამამდე ხანგრძლივობის ვიდეოების შექმნის საშუალებას აძლევს, გააკრიტიკეს რეალური ადამიანებისა და სტუდიების ინტელექტუალური საკუთრების გამოყენების უსაფრთხოების ზომების ნაკლებობის გამო. Disney-მ უკვე მიიღო სამართლებრივი ზომები ByteDance-ის წინააღმდ

Neural Love Photo Generator: AI გამოსახულებების გენერაცია პერსონალური კონტროლით
Neural Love Photo Generator ხელოვნური ინტელექტის გამოსახულების გენერაციას პირად პროცესად აყენებს, მომხმარებლის კონტროლსა და თავისუფალ გადაწყვეტილებაზე აქცენტით, რაც საშუალებას აძლევს ზრდასრულთა კონტენტის შექმნას დაწესებული ფილტრების გარეშე. GetHoney AI-ის მსგავსი ინტუიციური ინტერფეისი მომხმარებელს საშუალებას აძლევს, ადვილად დაიწყოს მუშაობა და ეტაპობრივად, ცდისა და შეცდომის მეთოდით მიაღწიოს სასურველ შედეგს. პლატფორმის ფასების მოდელი მოხმარებაზეა დაფუძნებული, უფასო საცდელი პერიოდით და ფასიანი კრედ

AI კომპანიები კადრებს კარგავენ: xAI-სა და OpenAI-ში შიდა ცვლილებებია
ხელოვნური ინტელექტის კომპანიები, მათ შორის xAI და OpenAI, კადრების მნიშვნელოვან გადინებასა და შიდა რესტრუქტურიზაციას განიცდიან. xAI-მ დამფუძნებელი გუნდის ნახევარი დაკარგა, ხოლო OpenAI აუქმებს ძირითად გუნდებს და ათავისუფლებს აღმასრულებლებს პოლიტიკის უთანხმოების გამო. ეს ცვლილებები ემთხვევა Equity პოდკასტზე ტექნოლოგიური სფეროს უმსხვილესი გარიგებებისა და ცვლილებების განხილვას.

OpenAI აჩერებს საკამათო GPT-4o-სა და სხვა მოძველებული მოდელების წვდომას
OpenAI პარასკევიდან წყვეტს ხუთ მოძველებულ ChatGPT მოდელზე წვდომას, მათ შორის საკამათო GPT-4o-ზე, რომელიც მომხმარებლის თვითდაზიანებასთან, ბოდვით ქცევასთან და ხელოვნური ინტელექტის ფსიქოზთან იყო დაკავშირებული. მიუხედავად იმისა, რომ მას მომხმარებელთა მხოლოდ 0.1% იყენებს, ეს მაინც 800 000 ადამიანს შეადგენს, რამაც ათასობით მომხმარებლის პროტესტი გამოიწვია.

კანადურმა ხელოვნური ინტელექტის სტარტაპმა Cohere-მ შემოსავლის სამიზნე გადააჭარბა, IPO-ს გეგმავს
კანადურმა ხელოვნური ინტელექტის სტარტაპმა Cohere-მ 2025 წლის წლიური განმეორებადი შემოსავლის სამიზნე $200 მილიონიდან $240 მილიონამდე გადააჭარბა, რაც წლის განმავლობაში 50%-ზე მეტ კვარტალურ ზრდას მოიცავდა. მსხვილი ტექნოლოგიური ინვესტორების, როგორიცაა Nvidia, AMD და Salesforce, მხარდაჭერით, Cohere-ის გენერაციული ხელოვნური ინტელექტის მოდელები საწარმოებისთვის მიმზიდველია მათი ეფექტურობის გამო. კომპანიამ ასევე გამოუშვა საწარმოებისთვის განკუთვნილი პლატფორმა North. აღმასრულებელმა დირექტორმა აიდან გომესმა
fastText-ის მოდელები Hugging Face-ზე: 157 ენის ვექტორები და ენის იდენტიფიკაცია Meta AI-სთან თანამშრომლობით
Hugging Face-მა, Meta AI-სთან თანამშრომლობით, უზრუნველყო fastText-ის მოდელების, მათ შორის 157 ენის სიტყვის ვექტორებისა და ენის იდენტიფიკაციის უახლესი მოდელის, ხელმისაწვდომობა. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს, მარტივად ჩამოტვირთონ და გამოიყენონ ეს მასშტაბირებადი გადაწყვეტილებები ტექსტის წარმოდგენისა და კლასიფიკაციისთვის, ასევე გამოსცადონ სხვადასხვა ვიჯეტები.
LLM-ების შეფასება: სად შეგვიძლია ვენდოთ მონაცემებს?
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) შეფასების არსებულ გამოწვევებს, განსაკუთრებით GPT-4-ზე დაფუძნებულ მეტრიკაზე დამოკიდებულებას, რაც შესაძლოა სრულად არ ასახავდეს ადამიანურ უპირატესობებს. ხაზგასმულია ადამიანურად მარკირებული მონაცემების მნიშვნელობა რეალური უპირატესობების გასაზომად და წარმოდგენილია Hugging Face Open LLM ლიდერბორდის გაფართოება. ეს გაფართოებული ლიდერბორდი აერთიანებს ავტომატიზებულ აკადემიურ ბენჩმარკებს, პროფესიონალურ ადამიანურ მარკირებას და GPT-4 შეფასებებს, რათა უზრუნველყო

AraGen-ის ლიდერბორდი: ინოვაციური ჩარჩო დიდი ენობრივი მოდელების ყოვლისმომცველი შეფასებისთვის
AraGen-ის ლიდერბორდი წარმოადგენს ახალ, ინოვაციურ ჩარჩოს დიდი ენობრივი მოდელების (დემ) შესაფასებლად. ის გვთავაზობს 3C3H საზომს, რომელიც აფასებს მოდელის პასუხებს ექვს განზომილებაში (სისწორე, სრულყოფილება, ლაკონურობა, გამოსადეგობა, პატიოსნება და უვნებლობა) დემ-მოსამართლის პრინციპზე დაყრდნობით, ფაქტობრივი სიზუსტისა და გამოყენებადობის გათვალისწინებით. სისტემა მოიცავს დინამიურ შეფასებებს ბრმა ტესტირების ციკლებით მონაცემთა დაბინძურების თავიდან ასაცილებლად. AraGen განსაკუთრებულ აქცენტს აკეთებს არაბული ე
ხელოვნური ინტელექტის შეცდომების გამოსწორება: ინტერაქტიული ასისტენტის ტესტირება Keras Chatbot Arena-ზე
ეს სტატია აღწერს ექსპერიმენტს, რომელიც მიზნად ისახავს შეამოწმოს, რამდენად ეფექტურად შეუძლიათ დიდ ენობრივ მოდელებს (LLM) საკუთარი შეცდომების გამოსწორება მარტივი ინგლისური უკუკავშირის საფუძველზე. ავტორი ქმნის სპეციალურ გარემოს Gradio-ზე Spaces-ით, Keras-ის, JAX-ისა და TPUs-ის გამოყენებით, რათა ერთდროულად რამდენიმე ჩეთბოტთან იმუშაოს და შეაფასოს მათი უნარი, მოახდინონ API ზარების გენერირება და შეასწორონ შეცდომები. განხილულია ტექნიკური დეტალები და მიდგომები მოდელების მრავალ ბირთვზე ოპტიმიზაციისთვის, მ
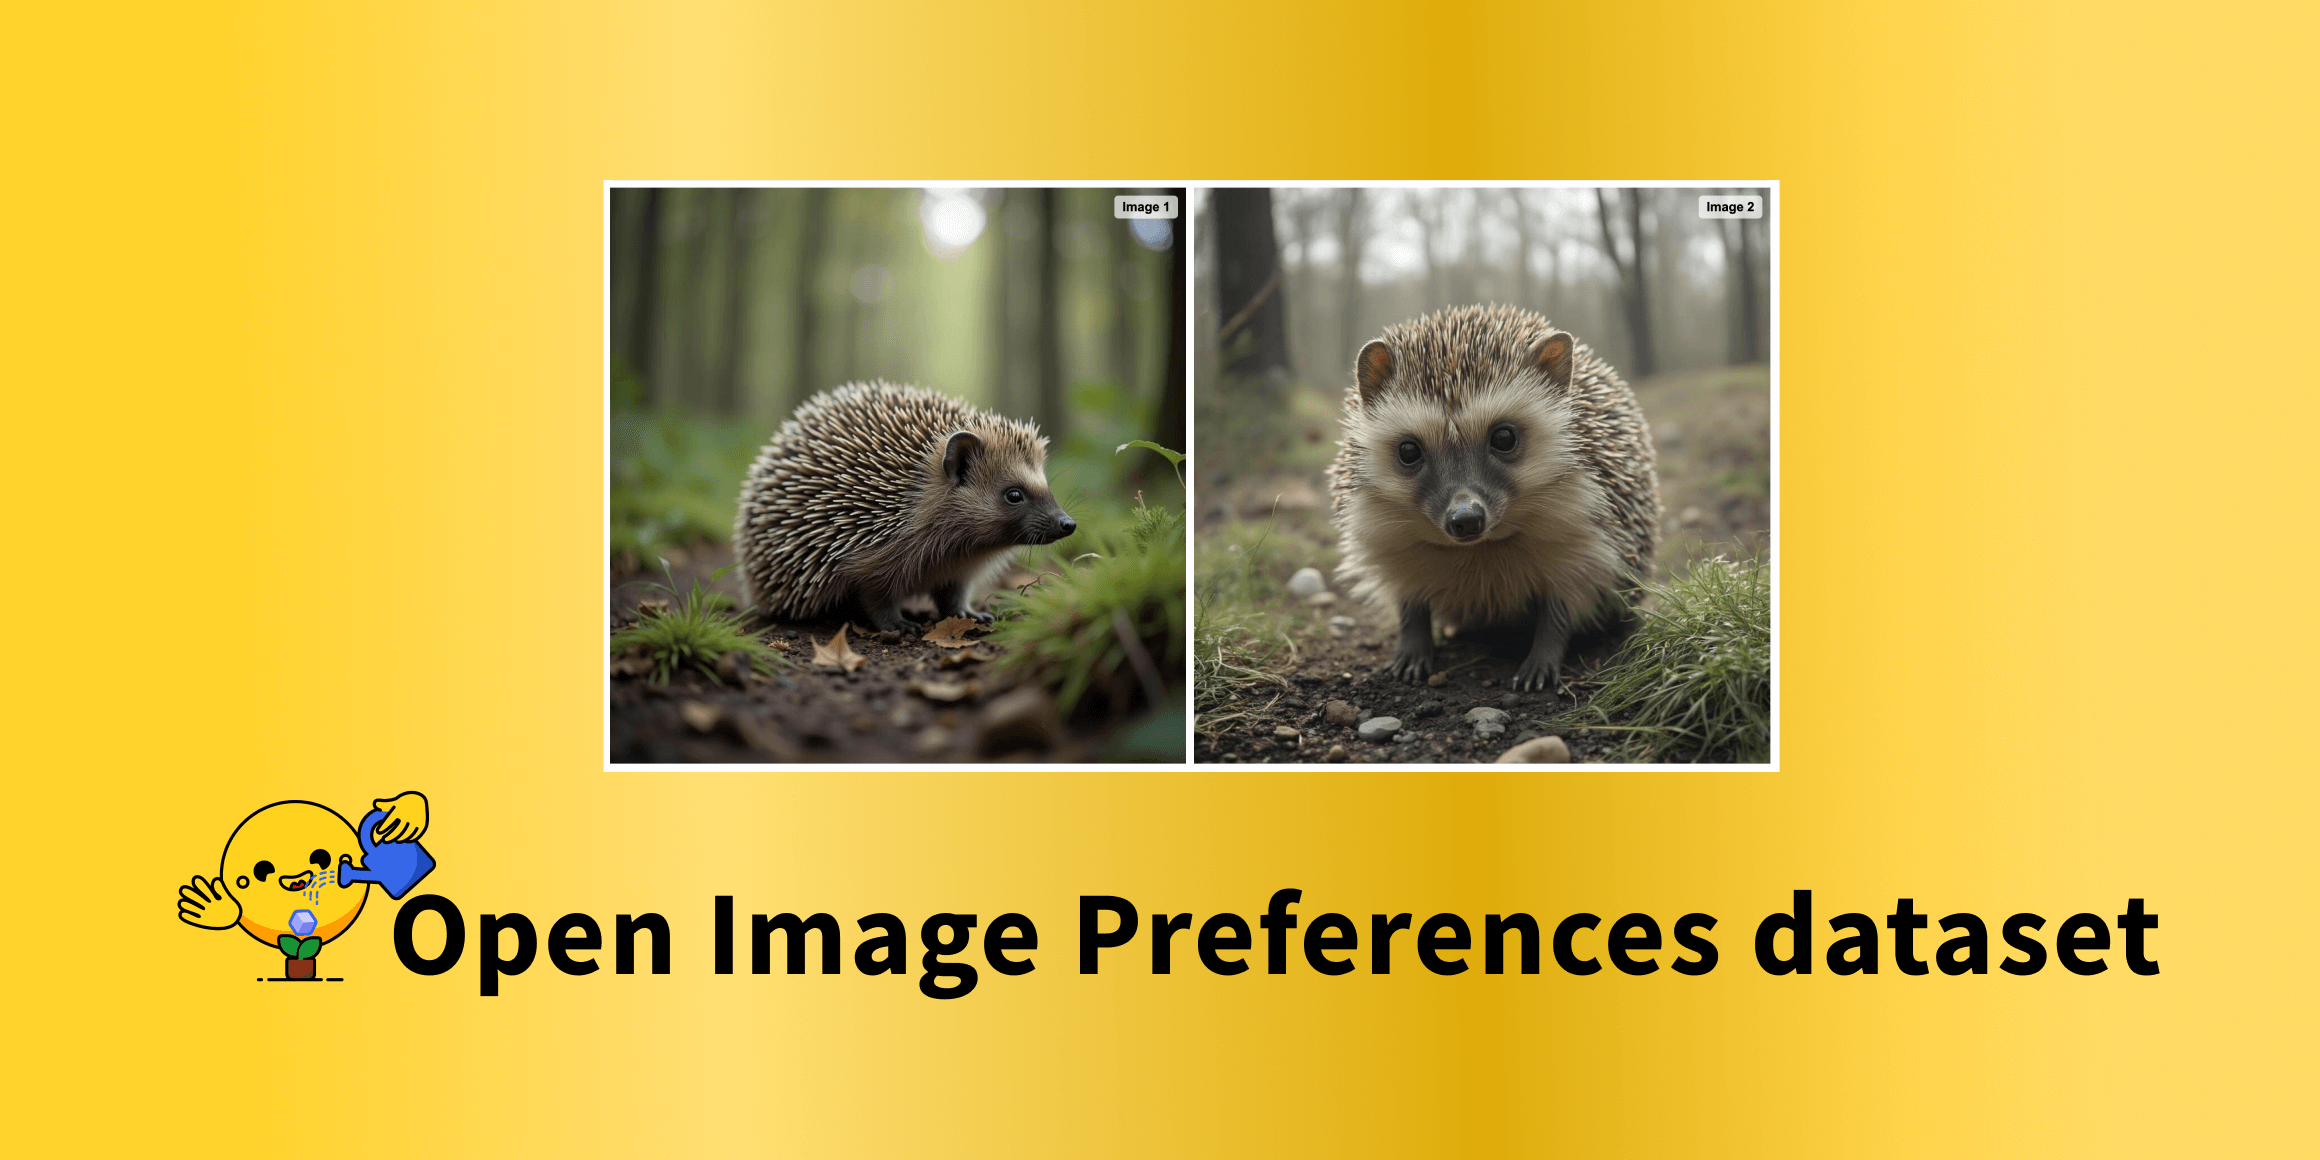
„მონაცემები ერთად უკეთესია“: Hugging Face და ღია კოდის AI საზოგადოება რევოლუციას ახდენენ გამოსახულების გენერაციაში
სტატია აღწერს Hugging Face-ისა და ღია კოდის AI საზოგადოების ერთობლივ პროექტს, სახელწოდებით „მონაცემები ერთად უკეთესია“, რომელიც მიზნად ისახავს ღია კოდის ეფექტური მონაცემთა ნაკრებების შექმნას. მნიშვნელოვანი მიღწევაა `open-image-preferences-v1`, უნიკალური გამოსახულების უპირატესობის მონაცემთა ნაკრები, რომელიც გამოირჩევა მრავალფეროვანი პრომპტებითა და ღია განვითარებით. მონაცემთა ნაკრები დეტალურად შეიქმნა სინთეზური მონაცემების გენერაციის, ტოქსიკურობის მოწინავე ფილტრაციისა და Flux-ისა და Stable Diffusi
ტრანსფორმერები დროითი სერიების პროგნოზირებაში: Autoformer-ის ინოვაცია და ეფექტურობის დადასტურება
ამ პოსტში განხილულია Transformer მოდელების ეფექტურობა დროითი სერიების პროგნოზირებისთვის. წარმოდგენილია Informer მოდელი, რომელმაც 2021 წლის AAAI-ის საუკეთესო ნაშრომის ჯილდო მოიპოვა. მიუხედავად იმისა, რომ ზოგიერთი კვლევა, მათ შორის DLinear-ის, ეჭვქვეშ აყენებს მათ ეფექტურობას, ემპირიული მონაცემები ადასტურებს, რომ ტრანსფორმერები, განსაკუთრებით Autoformer მოდელი, საგრძნობლად აჭარბებენ მარტივ ხაზოვან მოდელებს. სტატია დეტალურად განიხილავს Autoformer-ის საკვანძო ინოვაციებს: დაშლის ფენას (Decomposition L
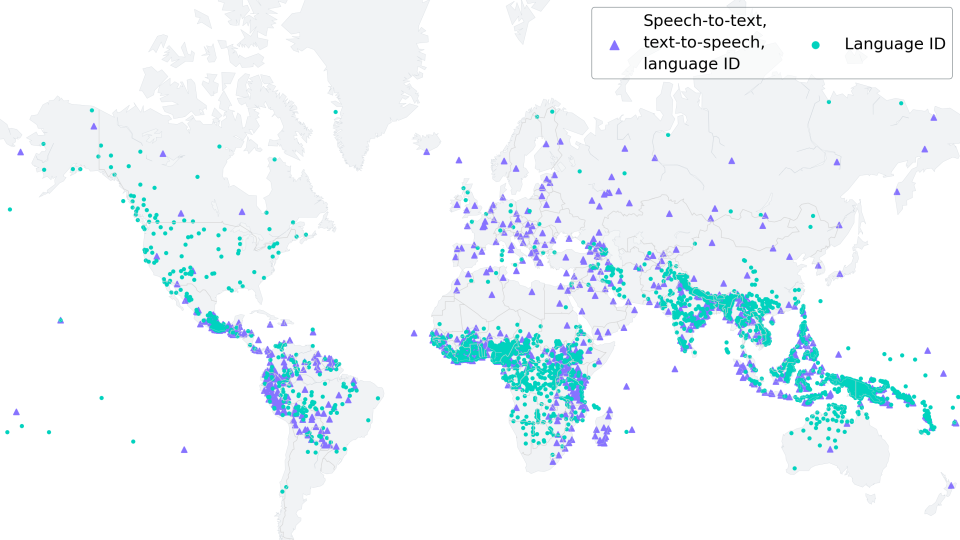
MMS: ხელოვნური ინტელექტი მრავალენოვანი მეტყველების ამოცნობისა და გადაშენების პირას მყოფი ენების გადასარჩენად
Meta AI-ის უახლესი მოდელი, Massive Multilingual Speech (MMS), რევოლუციას ახდენს მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. მას შეუძლია 1,100-ზე მეტი ენის იდენტიფიცირება, ტრანსკრიფცია და გენერირება, მათ შორის გადაშენების პირას მყოფი ენებისაც. ადაპტერის გაწვრთნის ინოვაციური მეთოდის წყალობით, MMS აღწევს სიტყვების შეცდომის საოცრად დაბალ მაჩვენებლებს მინიმალური დამატებითი გაწვრთნით, რაც განსაკუთრებით ეფექტურია დაბალი რესურსების მქონე ენებისთვის. ეს ტექნოლოგია პოტენციურად გადამწყვეტ როლს ითამაშებ
Meta AI-ის რევოლუციური MMS მოდელი: 1100-ზე მეტი ენის მხარდაჭერა და გადაშენების პირას მყოფი ენების შენარჩუნება
Meta AI-მ წარმოადგინა Massive Multilingual Speech (MMS) მოდელი, რომელსაც შეუძლია 1100-ზე მეტი ენის ამოცნობა, ტრანსკრიფცია და გენერაცია. ეს ინოვაციური სისტემა, რომელიც იყენებს „ადაპტერის“ წვრთნის მეთოდს, მნიშვნელოვნად ამცირებს შეცდომის მაჩვენებელს მცირე რესურსების მქონე ენებისთვის და ხელს უწყობს გადაშენების პირას მყოფი ენების შენარჩუნებას, რადგან მათთვის წერილობითი ჩანაწერების შექმნასა და მშობლიურ ენაზე კომუნიკაციას უწყობს ხელს. MMS-ის ადაპტერის წვრთნა უფრო ეფექტურია მეხსიერების თვალსაზრისით, უფრ

სინთეზური მონაცემების გენერაცია: ხელოვნური ინტელექტის შესაძლებლობების გაფართოება
სტატია მიმოიხილავს სინთეზური მონაცემების მნიშვნელობასა და გენერაციის პროცესს. სინთეზური მონაცემები არის ხელოვნურად შექმნილი ინფორმაცია, რომელიც რეალურ სამყაროს მონაცემებს მიბაძავს და ხელს უწყობს მონაცემთა შეზღუდვების დაძლევას, ნაკრებების გაფართოებით ან გაუმჯობესებით. აღწერილია სინთეზური მონაცემების გენერატორის გამოყენება Hugging Face-ის უფასო API-სა და Argilla-ს ინტეგრაციის მეშვეობით, ტექსტის კლასიფიკაციისა და ჩატის მონაცემთა ნაკრებების შესაქმნელად. მოცემულია დეტალური სამსაფეხურიანი პროცესი მონა