Google წარმოგიდგენთ Nano Banana 2-ს: მაღალი ხარისხის გამოსახულება და გაუმჯობესებული რედაქტირება Flash მოდელით
Google-მა წარადგინა Nano Banana 2 (Gemini 3.1 Flash Image), რომელიც უზრუნველყოფს მაღალი ხარისხის გამოსახულების გენერაციას, სწრაფ და მოწინავე რედაქტირებას, გაუმჯობესებულ მსოფლიო ცოდნას და ტექსტის უფრო საიმედო რენდერირებას. მოდელი ხელმისაწვდომია Gemini API-ის, Google AI Studio-ს, Vertex AI-ის, Google Antigravity-სა და Firebase-ის მეშვეობით, რაც დეველოპერებს საშუალებას აძლევს შექმნან დეტალური ვიზუალური კონტენტი და მოახდინონ მისი ლოკალიზება შესანიშნავი ფასი-შესრულების შეფარდებით.

Peak XV-მ ინდოეთისა და აზიაზე ორიენტირებული ფონდებისთვის $1.3 მილიარდი მოიზიდა, ფოკუსს AI-ზე ამახვილებს
Peak XV-მ, Sequoia Capital-ისგან გამოყოფილმა კომპანიამ, $1.3 მილიარდი მოიზიდა ახალი ფონდებისთვის, რომლებიც ინდოეთსა და აზიაზეა ორიენტირებული. კომპანია, რომელიც $10 მილიარდზე მეტ აქტივს მართავს, გაამკაცრებს ფოკუსს ხელოვნურ ინტელექტზე და ტრანსსასაზღვრო ინვესტიციებზე, რეგიონში კონკურენციის გაძლიერების ფონზე. კაპიტალი ძირითადად განთავსდება ხელოვნური ინტელექტის, ფინტექისა და სამომხმარებლო სტარტაპებში, უპირატესობას ანიჭებს რა მაღალ ანაზღაურებას აქტივების მაქსიმიზაციის ნაცვლად.

SpaceX-ის ყოფილი ინჟინრების სტარტაპი Mesh Optical Technologies $50 მილიონს იზიდავს AI მონაცემთა ცენტრებისთვის ოპტიკური გადამცემების წარმოებისთვის
ლოს-ანჯელესში დაფუძნებულმა სტარტაპმა Mesh Optical Technologies, რომლის დამფუძნებლები SpaceX-ის ყოფილი ინჟინრები ტრევის ბრეშერი, კამერონ რამოსი და სერენა გროუნ-ჰებერლი არიან, Thrive Capital-ის მიერ ლიდერობით A სერიის დაფინანსების ფარგლებში $50 მილიონი მოიზიდა. კომპანიის მიზანია ოპტიკური გადამცემების მასობრივი წარმოება, რომლებიც გადამწყვეტია ხელოვნური ინტელექტის მსგავსი გამოთვლითი რესურსებით მდიდარი აპლიკაციებისთვის. სტარტაპი ბაზარზე არსებული შეზღუდვების დაძლევას ისახავს მიზნად და ეროვნული უსაფრთხ

როგორ აუმჯობესებს Capital Fund Management (CFM) ფინანსური მონაცემების ანალიზს Hugging Face-ის დიდი ენობრივი მოდელების (LLM) დახმარებით
Capital Fund Management (CFM), პარიზში დაფუძნებული ალტერნატიული ინვესტიციების მართვის ფირმა, თანამშრომლობს Hugging Face-ის ექსპერტთა მხარდაჭერის გუნდთან, რათა გამოიყენოს ღია წყაროს დიდი ენობრივი მოდელები (LLMs) ფინანსური აპლიკაციებისთვის. თანამშრომლობის მთავარი მიზანია გააუმჯობესოს ფინანსური სუბიექტების ამოცნობა (მაგ., კომპანიების სახელები) საინფორმაციო სტატიებიდან, რაც კრიტიკულია ავტომატიზირებული სავაჭრო სტრატეგიებისთვის. CFM-მა გამოიკვლია LLM-ის დახმარებით დატეგვის, მცირე მოდელების 'fine-tunin
ხელოვნური ინტელექტის შეცდომების გამოსწორება: ინტერაქტიული ასისტენტის ტესტირება Keras Chatbot Arena-ზე
ეს სტატია აღწერს ექსპერიმენტს, რომელიც მიზნად ისახავს შეამოწმოს, რამდენად ეფექტურად შეუძლიათ დიდ ენობრივ მოდელებს (LLM) საკუთარი შეცდომების გამოსწორება მარტივი ინგლისური უკუკავშირის საფუძველზე. ავტორი ქმნის სპეციალურ გარემოს Gradio-ზე Spaces-ით, Keras-ის, JAX-ისა და TPUs-ის გამოყენებით, რათა ერთდროულად რამდენიმე ჩეთბოტთან იმუშაოს და შეაფასოს მათი უნარი, მოახდინონ API ზარების გენერირება და შეასწორონ შეცდომები. განხილულია ტექნიკური დეტალები და მიდგომები მოდელების მრავალ ბირთვზე ოპტიმიზაციისთვის, მ
Hugging Face-ის ღია მოდელები ახლა უკვე ხელმისაწვდომია Amazon Bedrock Marketplace-ზე
Hugging Face-ის პოპულარული ღია მოდელები ახლა უკვე ხელმისაწვდომია Amazon Bedrock-ზე, ახალი Bedrock Marketplace-ის ფარგლებში. AWS-ის მომხმარებლებს შეუძლიათ 83 ღია მოდელის განთავსება გენერაციული ხელოვნური ინტელექტის (Generative AI) აპლიკაციების შესაქმნელად. ეს ინტეგრაცია აერთიანებს SageMaker Jumpstart-ის გამოყენების სიმარტივეს Amazon Bedrock-ის სრულად მართულ ინფრასტრუქტურასთან, რაც უზრუნველყოფს მაღალი დონის API-ებთან თავსებადობას.

სინთეზური მონაცემების გენერაცია: ხელოვნური ინტელექტის შესაძლებლობების გაფართოება
სტატია მიმოიხილავს სინთეზური მონაცემების მნიშვნელობასა და გენერაციის პროცესს. სინთეზური მონაცემები არის ხელოვნურად შექმნილი ინფორმაცია, რომელიც რეალურ სამყაროს მონაცემებს მიბაძავს და ხელს უწყობს მონაცემთა შეზღუდვების დაძლევას, ნაკრებების გაფართოებით ან გაუმჯობესებით. აღწერილია სინთეზური მონაცემების გენერატორის გამოყენება Hugging Face-ის უფასო API-სა და Argilla-ს ინტეგრაციის მეშვეობით, ტექსტის კლასიფიკაციისა და ჩატის მონაცემთა ნაკრებების შესაქმნელად. მოცემულია დეტალური სამსაფეხურიანი პროცესი მონა
Panel: Python ბიბლიოთეკა მძლავრი აპლიკაციების მარტივად შესაქმნელად
Panel არის ღია წყაროს Python ბიბლიოთეკა, რომელიც დეველოპერებს საშუალებას აძლევს, სრულად Python-ზე შექმნან მძლავრი ხელსაწყოები, დაფები (dashboards) და კომპლექსური აპლიკაციები. ის გთავაზობთ მდიდარ ეკოსისტემას და მოქნილ API-ებს სწრაფი და ინტერაქტიული აპლიკაციების ასაშენებლად.

ლოგიტების დამუშავება: უპრეცედენტო კონტროლი AI ტექსტის გენერაციაზე NVIDIA-ს LogitsProcessorZoo-ს მეშვეობით
სტატია განიხილავს ლოგიტების დამუშავებას, მეთოდს, რომელიც საშუალებას გვაძლევს დეტალური კონტროლი მოვახდინოთ ხელოვნური ინტელექტის მიერ ტექსტის გენერაციის პროცესზე, პროგნოზირების ქულების მოდიფიკაციის გზით. ხაზგასმულია Hugging Face-ის LogitsProcessor API და წარმოდგენილია NVIDIA-ს LogitsProcessorZoo – მოდულური პროცესორების კრებული, რომელიც შექმნილია სპეციფიკური ამოცანებისთვის, მაგალითად, თანმიმდევრობის სიგრძის კონტროლისთვის ან საკვანძო ფრაზების დაწესებისთვის. ეს ინოვაცია მნიშვნელოვნად აფართოებს ხელოვნ
ლოგიტების დამუშავება: გაუმჯობესებული კონტროლი AI ტექსტის გენერაციაზე NVIDIA-ს LogitsProcessorZoo-ს მეშვეობით
სტატია განიხილავს ლოგიტების დამუშავებას, მეთოდს, რომელიც საშუალებას გვაძლევს დეტალური კონტროლი მოვიპოვოთ ხელოვნური ინტელექტის მიერ ტექსტის გენერირების პროცესზე ალბათური განაწილების პირდაპირი მოდიფიცირებით. ხაზგასმულია Hugging Face-ის LogitsProcessor API და წარმოდგენილია NVIDIA-ს LogitsProcessorZoo — მოდულური ლოგიტების პროცესორების კოლექცია, რომელიც განკუთვნილია სპეციფიკური ამოცანებისთვის, როგორიცაა თანმიმდევრობის სიგრძის კონტროლი ან საკვანძო ფრაზების დაწესება. სტატია განმარტავს, თუ როგორ აუმჯობე
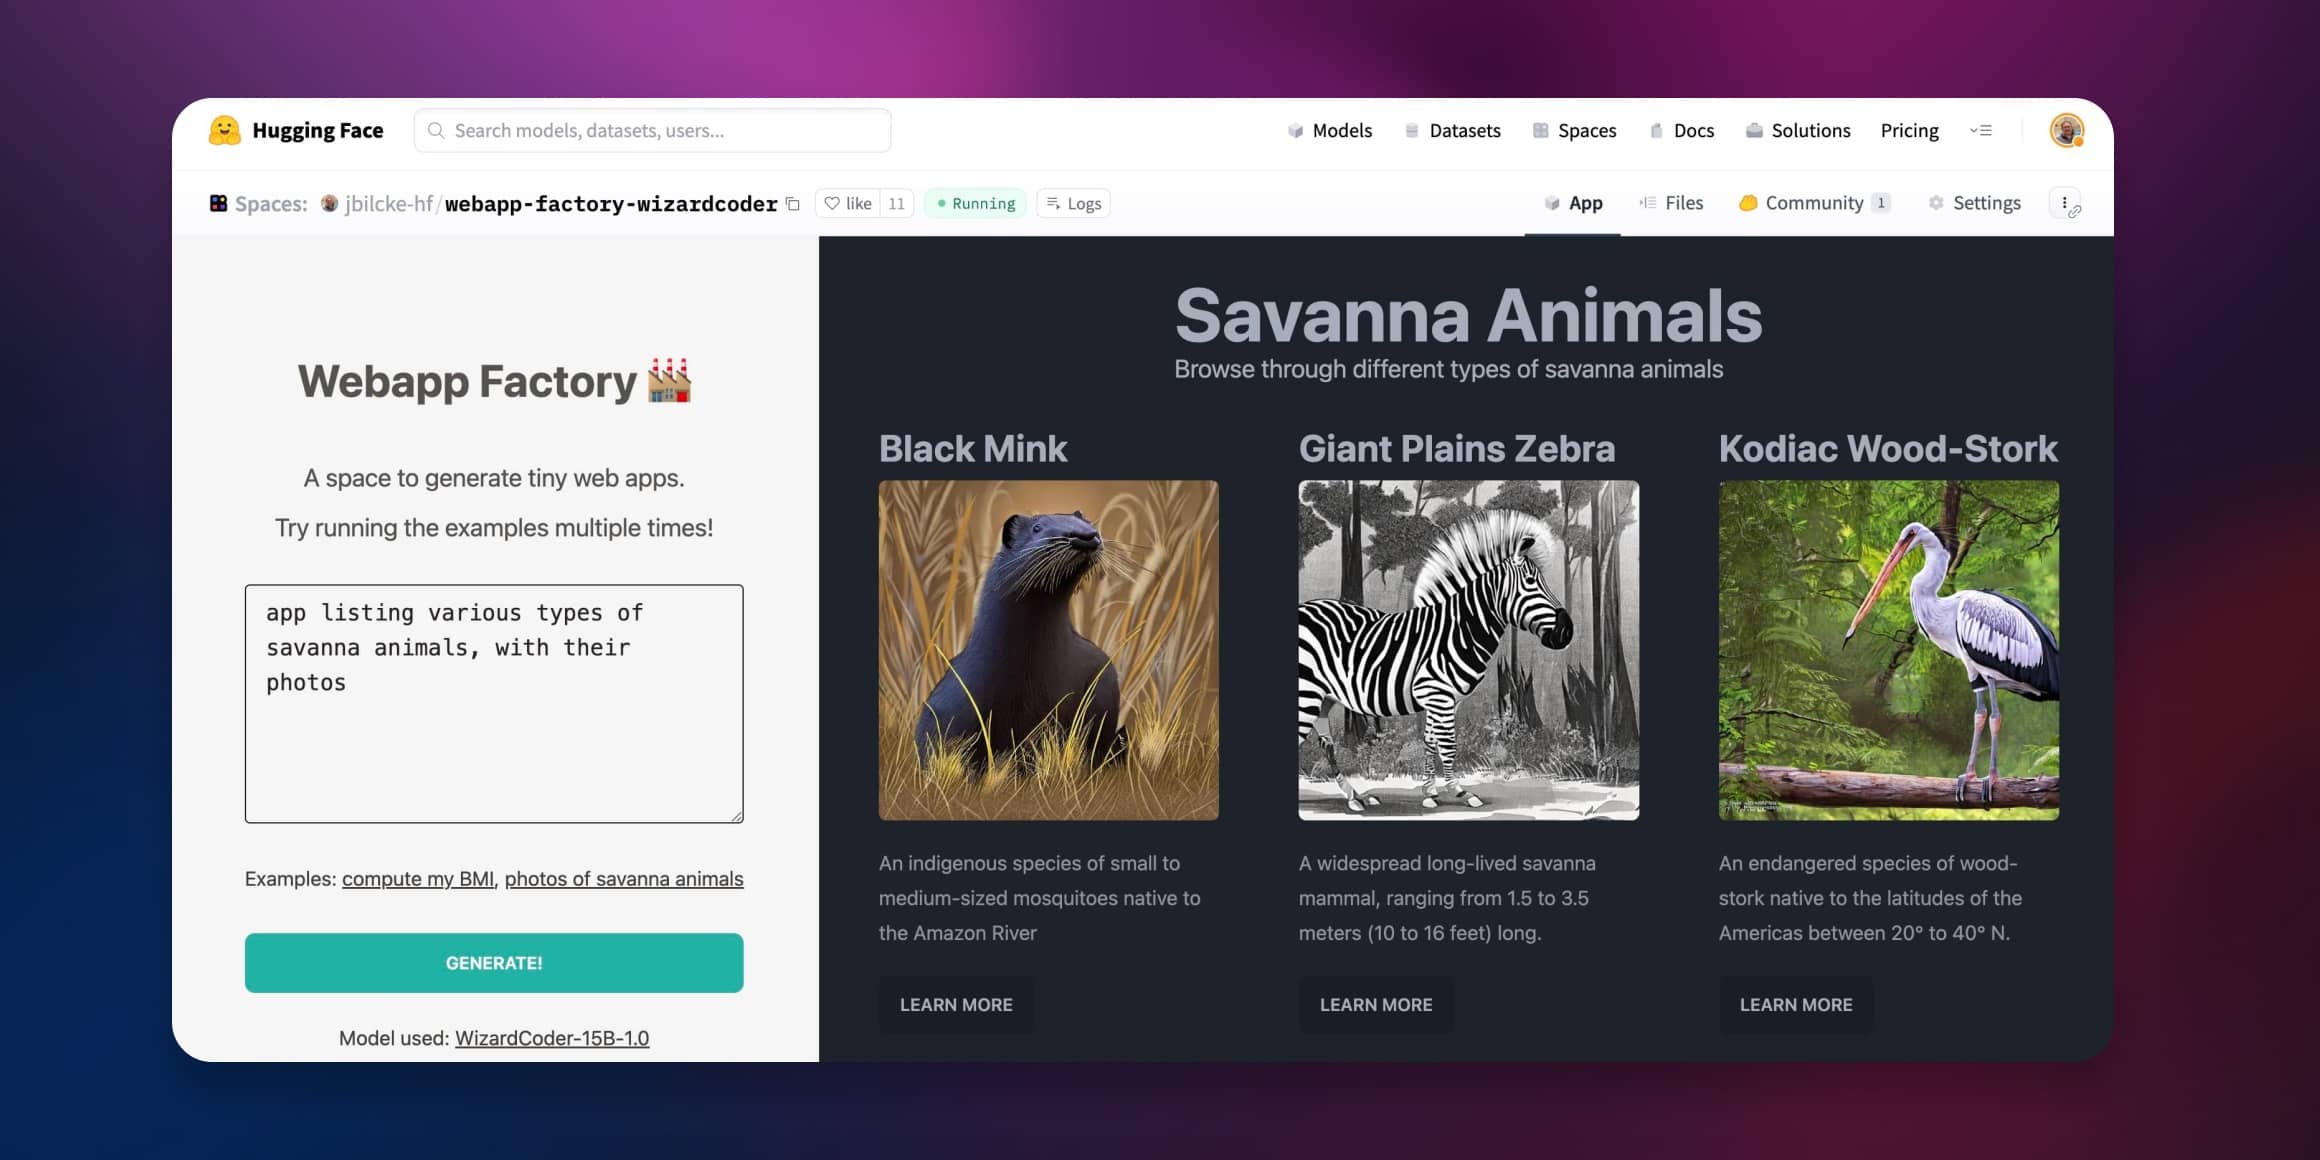
AI ვებ-კონტენტის გენერაცია: Node.js და Hugging Face-ის პირდაპირი მიდგომა
გაეცანით AI ვებ-კონტენტის გენერაციის ინოვაციურ მიდგომას Node.js-ის გამოყენებით, რომელიც უზრუნველყოფს კონტენტის ერთბაშად ნაკადად გადაცემასა და რენდერინგს. ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ დიდი ენობრივი მოდელები (LLM) JavaScript/Node პლატფორმაზე Hugging Face Inference API-ებთან ერთად, აპარატურული აჩქარების, Tailwind CSS-ის, Stable Diffusion-ისა და Alpine.js-ის ინტეგრაციის ჩათვლით.
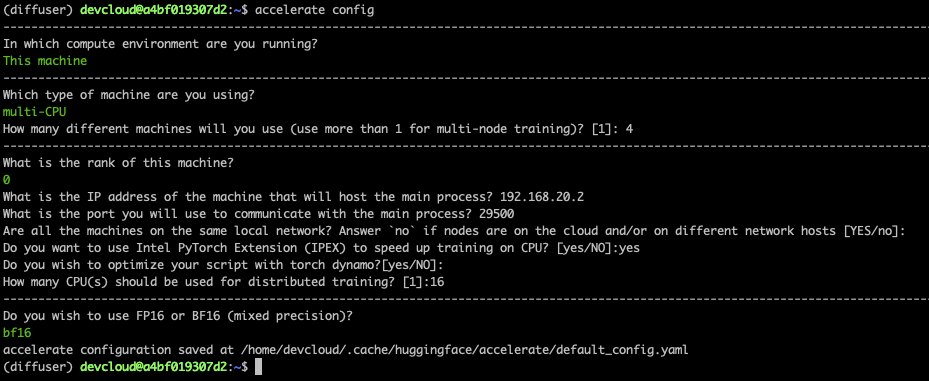
Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ
TimmWrapper: PyTorch-ის გამოსახულების მოდელების ინტეგრაცია Hugging Face Transformers-თან
TimmWrapper წარმოადგენს ინსტრუმენტს, რომელიც აერთიანებს PyTorch Image Models (timm) ბიბლიოთეკას Hugging Face transformers-თან. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს გამოიყენონ timm-ის თანამედროვე კომპიუტერული ხედვის მოდელების ფართო კოლექცია transformers-ის ეკოსისტემაში. ის უზრუნველყოფს ისეთ ფუნქციებს, როგორიცაა pipeline API-ის გამოყენება, Auto Classes, კვანტიზაცია და მოქნილი წვრილი მორგება (LoRA-ს ჩათვლით) ნაცნობი Trainer API-ის მეშვეობით. TimmWrapper ავსებს ამ ორ მძლავრ ბიბლიოთეკას შორი
100-ჯერ გაზრდილი წარმადობა: დიდი AI მოდელების ოპტიმიზაცია Hugging Face-ის ინფრასტრუქტურაზე
მიუხედავად იმისა, რომ დიდი ენობრივი მოდელების ექსპერიმენტირება მარტივია, მათი მაქსიმალური წარმადობით პროდუქციაში განთავსება რთული საინჟინრო გამოწვევაა. Hugging Face გთავაზობთ გადაწყვეტას თავისი Accelerated Inference API-ის მეშვეობით, რომელიც უზრუნველყოფს 100-ჯერ გაზრდილ სიჩქარეს და მასშტაბირებადობას. სტატია დეტალურად აღწერს ოპტიმიზაციის სხვადასხვა დონეს – ბიბლიოთეკების გამოყენებიდან აპარატურის სპეციფიკურ მოდიფიკაციამდე – და ხაზს უსვამს Hugging Face-ის ექსპერტიზასა და პარტნიორობებს ტექნიკის წამყვ

Hugging Face აერთიანებს სერვერულ ინფერენსზე წვდომას ახალი პარტნიორობითა და ფუნქციებით
Hugging Face-მა, საკუთარი სერვერული Inference API-ის ხანგრძლივი მასპინძლობის შემდეგ, გადაწყვიტა ფოკუსირება თანამშრომლობაზე, დიდი მონაცემთა ნაკრებებისა და მოდელების შენახვაზე, ვერსიონირებასა და გავრცელებაზე. ამის პარალელურად, კომპანია მომხმარებლებს სთავაზობს მარტივ და ერთიან წვდომას სერვერულ ინფერენსზე წამყვანი პროვაიდერების მეშვეობით. ეს ნაბიჯი აძლიერებს AI მოდელების ხელმისაწვდომობას, გვთავაზობს მოქნილ ფასებს პირდაპირი და მარშრუტიზებული მოთხოვნებისთვის, და უზრუნველყოფს დამატებით ბენეფიტებს PRO მ
BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან
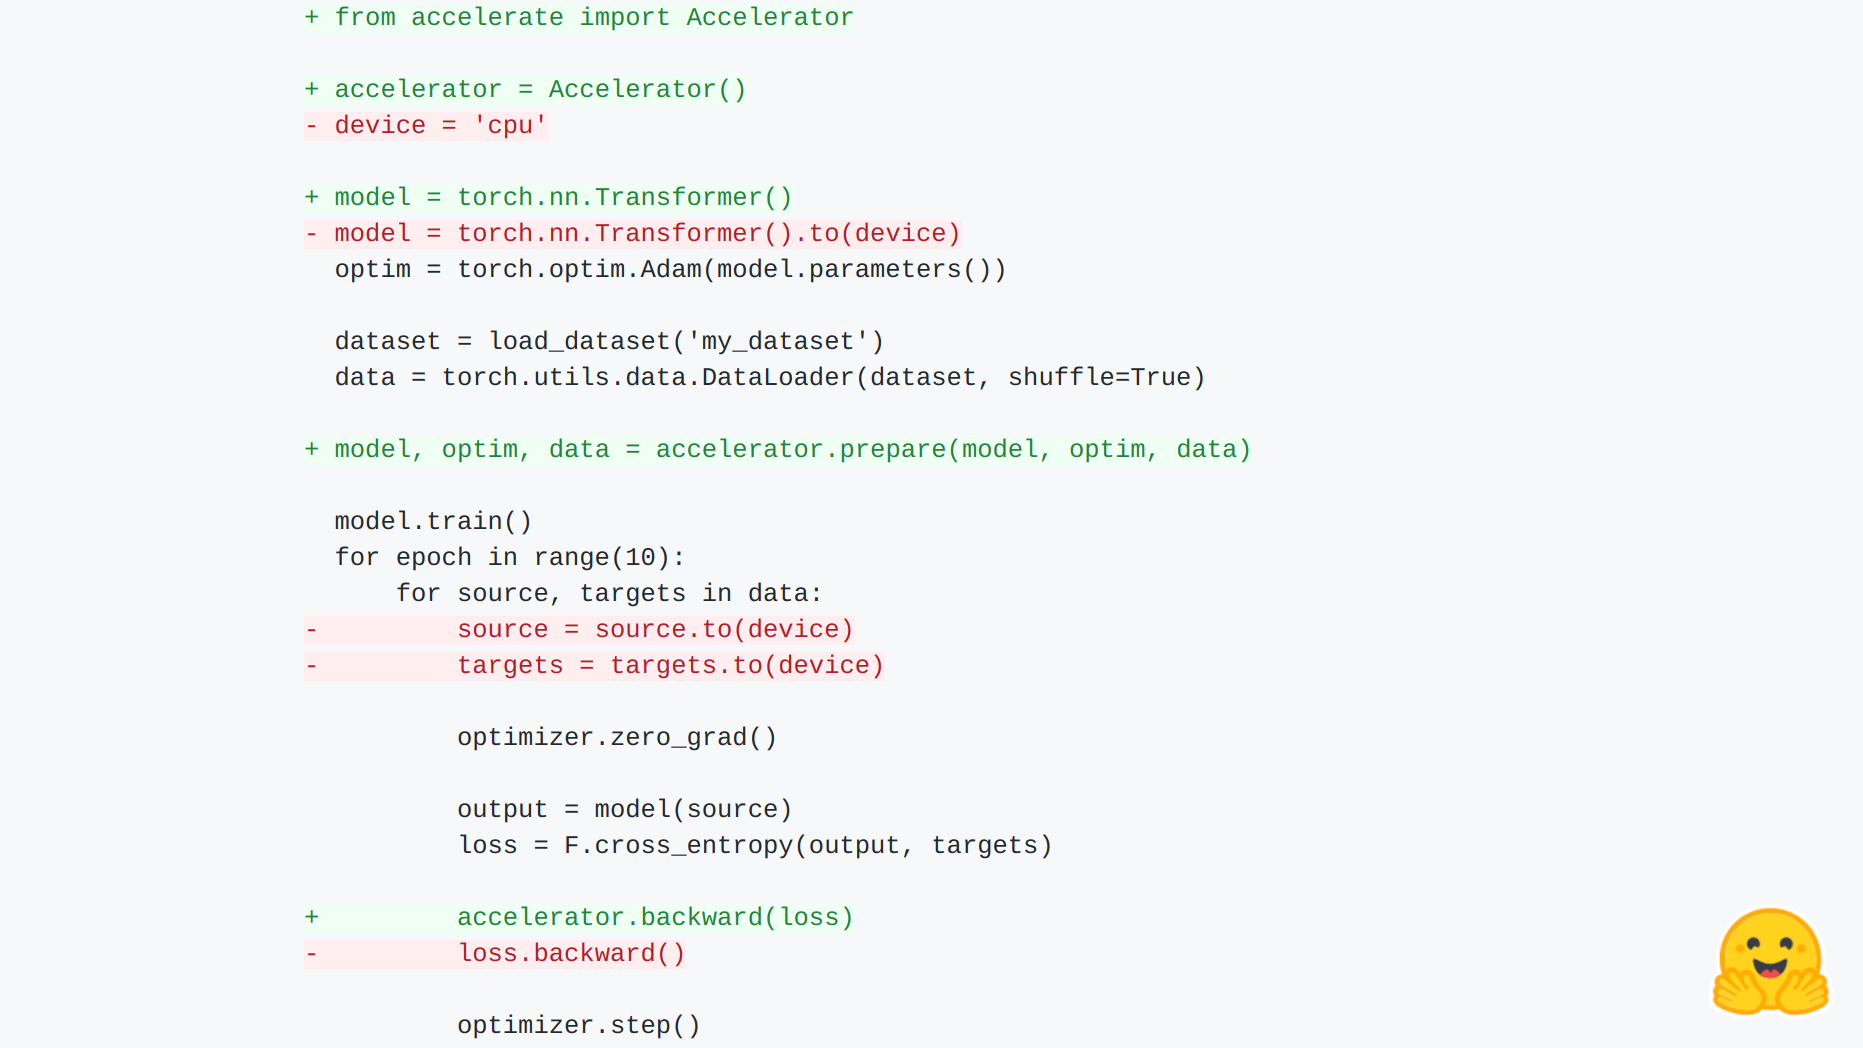
🤗 Accelerate: გაამარტივეთ PyTorch-ის განაწილებული ტრენინგი სრული კონტროლის შენარჩუნებით
🤗 Accelerate არის PyTorch-ის მომხმარებლებისთვის შექმნილი ბიბლიოთეკა, რომელიც ამარტივებს განაწილებული ტრენინგისა და შერეული სიზუსტის გამოყენებას. ის საშუალებას აძლევს მომხმარებლებს, სრულად აკონტროლონ თავიანთი სავარჯიშო ციკლები, თავიდან აიცილონ რთული შაბლონური კოდის წერა და მარტივად გაუშვან სკრიპტები სხვადასხვა მოწყობილობაზე (მრავალ-GPU, TPU) მინიმალური ცვლილებებით. ბიბლიოთეკა აბსტრაგირებს რუტინულ კოდს და უზრუნველყოფს მარტივ API-ს, რაც გაცილებით მოსახერხებელს ხდის რთული ტრენინგის კონფიგურაციებს.
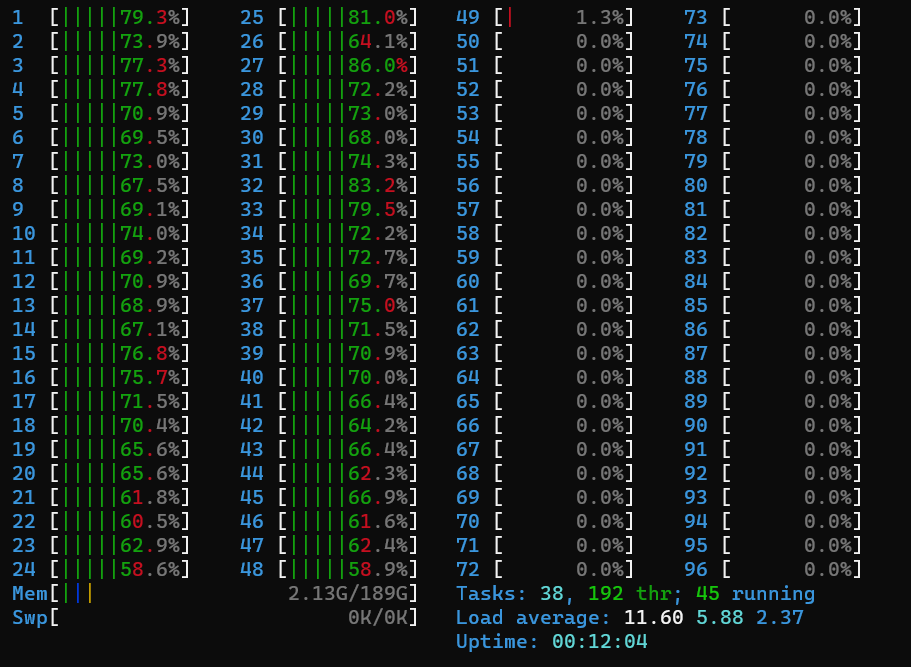
Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.

Few-Shot Learning ხელოვნურ ინტელექტში: GPT-Neo და აჩქარებული დასკვნის API
სტატია განმარტავს „Few-Shot Learning“ (რამდენიმე მაგალითზე დაფუძნებული სწავლების) კონცეფციას, როგორც მანქანური სწავლების ტექნიკას, რომელიც მოდელს მცირე რაოდენობის მონაცემებით წვრთნის. განხილულია მისი გამოყენება ბუნებრივი ენის დამუშავებაში (NLP) დიდი ენობრივი მოდელების, როგორიცაა EleutherAI GPT-Neo და OpenAI GPT-3, მეშვეობით. სტატია ასევე მიმოიხილავს Hugging Face-ის აჩქარებული დასკვნის (Accelerated Inference) API-ის როლს, ამ ტექნიკის ოპტიმიზაციას, გამოწვევებს (მაგ., მოდელის მგრძნობელობა მაგალითებ

Sentence Transformers v2: რევოლუციური განახლებები და ინტეგრაცია Hugging Face Hub-თან
Sentence Transformers-ის v2 ვერსიის გამოშვება ახალ შესაძლებლობებს გვთავაზობს წინადადების, აბზაცისა და გამოსახულების ემბედინგებისთვის. განახლება მოიცავს Hugging Face Hub-თან ღრმა ინტეგრაციას, 90-ზე მეტი წინასწარ გაწვრთნილი მოდელით 100-ზე მეტი ენისთვის. წარმოდგენილია ახალი ვიჯეტები – ფუნქციის ექსტრაქციისა და წინადადების მსგავსების გამოსათვლელად, ასევე API ინტერფეისები მოდელებთან პროგრამული წვდომისთვის, რაც საზოგადოებას საშუალებას აძლევს მარტივად გააზიაროს და გამოიყენოს თავისი გაწვრთნილი მოდელები.
SmolVLM2: ვიდეოს გაგება ხელმისაწვდომი ხდება ყველა მოწყობილობაზე
SmolVLM2 წარმოადგენს ფუნდამენტურ ცვლილებას ვიდეოს გაგების მიდგომაში, მოძრაობს მასიური, რესურსმომთხოვნი მოდელებიდან ეფექტურ, ნებისმიერ მოწყობილობაზე გაშვებად გადაწყვეტილებებზე. მიზანია ვიდეოს გაგება ხელმისაწვდომი გახდეს ყველა მოწყობილობისთვის, ტელეფონებიდან სერვერებამდე. გამოშვებულია სამი ზომის (2.2B, 500M და 256M) მოდელი, MLX-თან თავსებადობით (Python და Swift API-ები). ეს მოდელები, მიუხედავად მცირე ზომისა, მნიშვნელოვნად აღემატება არსებულ ანალოგებს მეხსიერების მოხმარების მხრივ და ზოგიერთ შემთხვევ
Hugging Face spaCy-ის ინტეგრაციით მოდელების გაზიარებასა და გამოყენებას ამარტივებს
Hugging Face-მა და spaCy-იმ განახორციელეს ინტეგრაცია, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ, დააყენონ და გამოიყენონ spaCy-ის კონვეიერები და მოდელები. ახალი ფუნქციონალი მოიცავს ავტომატურ მეტამონაცემების გენერაციას, დასკვნის (Inference) API-ს NER-ისთვის (Named Entity Recognition), ბრაუზერში ინტერაქტიულ ტესტირებას, `pip install`-ის მხარდაჭერას და `spacy-huggingface-hub` ბიბლიოთეკას მოდელების სწრაფი გაზიარებისთვის. ხელმისაწვდომია 60-ზე მეტი კანონიკური მოდელი, და მალე დაემატება ტექსტ
მარტივად შექმენით ინტერაქტიული ML დემოები Gradio-თი Hugging Face Spaces-ზე
ეს სტატია განმარტავს, თუ როგორ უნდა შექმნათ და უმასპინძლოთ ინტერაქტიულ მანქანური სწავლების მოდელების დემოებს Hugging Face Spaces-ზე Gradio-ს გამოყენებით. ის დეტალურად აღწერს პროცესს ინტერფეისების განსაზღვრიდან რთული მოდელების პაიპლაინების განთავსებამდე, ხაზს უსვამს Hugging Face-ის Inference API-სთან ინტეგრაციასა და Gradio Series-ის მოქნილობას.
Hugging Face PRO მომხმარებლებისთვის ინფერენსის API ხელმისაწვდომი ხდება
Hugging Face-მა PRO მომხმარებლებისთვის ახალი ინფერენსის API გამოუშვა, რომელიც ექსკლუზიურ წვდომას აძლევს მათ კურირებულ, ულტრა-სწრაფ მოდელებზე, გაუმჯობესებული მოთხოვნათა ლიმიტებით. სიახლე ამარტივებს მოწინავე AI მოდელებთან ექსპერიმენტებს, პროტოტიპირებას და ინტეგრაციას დეველოპმენტის გარემოებებში, ინფრასტრუქტურის განლაგების საჭიროების გარეშე. სერვისი მოიცავს ტექსტის, კოდისა და გამოსახულების გენერაციის შესაძლებლობებს.