
OpenAI აჩერებს საკამათო GPT-4o-სა და სხვა მოძველებული მოდელების წვდომას
OpenAI პარასკევიდან წყვეტს ხუთ მოძველებულ ChatGPT მოდელზე წვდომას, მათ შორის საკამათო GPT-4o-ზე, რომელიც მომხმარებლის თვითდაზიანებასთან, ბოდვით ქცევასთან და ხელოვნური ინტელექტის ფსიქოზთან იყო დაკავშირებული. მიუხედავად იმისა, რომ მას მომხმარებელთა მხოლოდ 0.1% იყენებს, ეს მაინც 800 000 ადამიანს შეადგენს, რამაც ათასობით მომხმარებლის პროტესტი გამოიწვია.

ილონ მასკი xAI-ს თანადამფუძნებლების წასვლაზე: „ეს ნებაყოფლობითი არ იყო“ რეორგანიზაციის ფონზე
ილონ მასკმა თავისი ხელოვნური ინტელექტის კომპანია xAI-დან თანამშრომლების, მათ შორის ექვსი თანადამფუძნებლის, მნიშვნელოვან გადინებაზე ისაუბრა. შიდა შეხვედრაზე მან განაცხადა, რომ ეს წასვლა კომპანიის რეორგანიზაციას უკავშირდებოდა, რომლის მიზანიც შესრულების სიჩქარის გაუმჯობესებაა და რომ ეს ნებაყოფლობითი არ იყო, არამედ კომპანიის მზარდ მასშტაბებთან შეუსაბამობა გამოიწვია. ეს ხდება იმ ფონზე, როდესაც xAI-ს Grok AI-სთან დაკავშირებული დაპირისპირებები, მარეგულირებელი შემოწმებები და დაგეგმილი IPO ელის, თავად მა

კანადურმა ხელოვნური ინტელექტის სტარტაპმა Cohere-მ შემოსავლის სამიზნე გადააჭარბა, IPO-ს გეგმავს
კანადურმა ხელოვნური ინტელექტის სტარტაპმა Cohere-მ 2025 წლის წლიური განმეორებადი შემოსავლის სამიზნე $200 მილიონიდან $240 მილიონამდე გადააჭარბა, რაც წლის განმავლობაში 50%-ზე მეტ კვარტალურ ზრდას მოიცავდა. მსხვილი ტექნოლოგიური ინვესტორების, როგორიცაა Nvidia, AMD და Salesforce, მხარდაჭერით, Cohere-ის გენერაციული ხელოვნური ინტელექტის მოდელები საწარმოებისთვის მიმზიდველია მათი ეფექტურობის გამო. კომპანიამ ასევე გამოუშვა საწარმოებისთვის განკუთვნილი პლატფორმა North. აღმასრულებელმა დირექტორმა აიდან გომესმა

AI-ის შიში და პროდუქტიულობა: ექსპერტები რჩევებს იძლევიან, როგორ დავძლიოთ შფოთვა
თანამშრომლებს შორის AI-ის მიმართ შფოთვა იზრდება სამუშაო ადგილების დაკარგვის შიშისა და დაპირებული სარგებლის ნაკლებობის გამო. თუმცა, ექსპერტები აცხადებენ, რომ ხელოვნური ინტელექტის ეფექტიანი დანერგვა ზრდის პროდუქტიულობას, ათავისუფლებს დროს ღირებული ამოცანებისთვის და აძლიერებს ადამიანურ კავშირებს. მნიშვნელოვანია AI-ს აღქმა, როგორც ზრდისა და განვითარების შესაძლებლობად, და არა როგორც საფრთხედ, რათა დაძლიოთ შიში და სრულად გამოიყენოთ მისი პოტენციალი.

ხელოვნურმა ინტელექტმა CUDA ქერნელების წერა ისწავლა: ახალი უნარი GPU პროგრამირებას ამარტივებს
შემუშავდა ხელოვნური ინტელექტის აგენტის ახალი უნარი, რომელიც კოდირების აგენტებს ასწავლის საწარმოო დონის CUDA ქერნელების შექმნას. ამ უნარის გამოყენებით, Claude-მა და Codex-მა წარმატებით დაწერეს ფუნქციური ქერნელები diffusers-ის კონვეიერისა და transformers-ის მოდელისთვის, მოახდინეს მათი სწორი ინტეგრაცია PyTorch-თან და ჩაატარეს წარმადობის ტესტები, რაც ადასტურებს პროცესის სრულ ავტომატიზაციას.

ხელოვნური ინტელექტის კოდირების ხელსაწყოები: დაპირება და რეალობა არაპროგრამისტის თვალით
გენერაციული ხელოვნური ინტელექტის კოდირების ხელსაწყოები, როგორიცაა Cursor და Replit, მნიშვნელოვან წარმატებას აღწევს საწარმოებში, რადგანაც მათ შეუძლიათ პროგრამისტების შრომა მნიშვნელოვნად შეამცირონ. ამ სტატიაში ავტორი, რომელსაც პროგრამირების მცირე ცოდნა აქვს, ცდილობს შექმნას აპლიკაცია ამ ხელსაწყოების გამოყენებით. ის აღწერს როგორც დადებით მხარეებს – ავტომატურ დავალებებსა და ბუნებრივი ენის გამოყენებით მუშაობას – ასევე გამოწვევებს, როგორიცაა ბრძანების ხაზთან მუშაობის აუცილებლობა, ღრუბლოვანი სერვისების
ხელოვნური ინტელექტის დეტექციის ბაზრის აღმავლობა და გამოწვევები 2025 წელს
გენერაციული ხელოვნური ინტელექტის სწრაფი განვითარების ფონზე, მნიშვნელოვნად იზრდება ადამიანის მიერ შექმნილი კონტენტის იდენტიფიცირების საჭიროება. ეს სტატია მიმოიხილავს ხელოვნური ინტელექტის დეტექციის ინსტრუმენტების ევოლუციას, ბაზრის მიმდინარე მდგომარეობას 2025 წელს, მათ ზრდას, დანერგვას, სიზუსტეს, ფასებსა და გამოყენებას. განხილულია ინდუსტრიის გამოწვევები, ინსტიტუციონალიზაციის პროცესი და სამომავლო ტენდენციები, რომლებიც მიმართულია უფრო ინტეგრირებული და მრავალმოდალური გადაწყვეტილებებისკენ, სადაც საიმედ

ანდროიდის რჩევა: როგორ გაათავისუფლოთ 10 გბ-მდე მეხსიერება AICore-ის გამორთვით
ZDNET დეტალურად განმარტავს თავის სარედაქციო პრინციპებს, ხაზს უსვამს ტესტირების, კვლევისა და დამოუკიდებელი მიმოხილვების მნიშვნელობას სანდო რეკომენდაციების უზრუნველსაყოფად. შემდეგ სტატია სთავაზობს პრაქტიკულ რჩევას Android ტელეფონის მომხმარებლებს, კერძოდ Google Pixel-ის მფლობელებს: როგორ გაათავისუფლოთ 10 გბ-მდე მეხსიერება AICore ფუნქციის გამორთვით. AICore პასუხისმგებელია ხელოვნური ინტელექტის (AI) მოდელებზე, როგორიცაა Gemini Nano, რომლებიც დიდ ადგილს იკავებენ და მოიხმარენ სისტემურ მეხსიერებასა და ბა

ხელოვნური ინტელექტის განვითარებას გამოთვლითი სიმძლავრე განაპირობებს და არა „საიდუმლო სოუსი“, აჩვენებს MIT-ის კვლევა
მასაჩუსეტსის ტექნოლოგიური ინსტიტუტის (MIT) მკვლევართა კვლევამ, რომელიც 809 დიდ ენობრივ მოდელს (LLM) მოიცავდა, აჩვენა, რომ მოდელების წარმადობის ზრდას ძირითადად განაპირობებს წვრთნისთვის გამოყენებული გამოთვლითი სიმძლავრის მოცულობა. დასკვნის თანახმად, ალგორითმული ინოვაციები ან კომპანიების უნიკალური „საიდუმლო სოუსი“ გაცილებით ნაკლებ გავლენას ახდენს, რაც ხაზს უსვამს გამოთვლით რესურსებზე მუდმივი წვდომის კრიტიკულ მნიშვნელობას ხელოვნური ინტელექტის სფეროში ლიდერობის შესანარჩუნებლად.

Samsung თებერვლის Unpacked ღონისძიებას ადასტურებს: Galaxy S სერია და გაუმჯობესებული AI მოდის
Samsung-მა სან-ფრანცისკოში დაადასტურა Unpacked ღონისძიება 25 თებერვალს, სადაც წარმოადგენს ახალ Galaxy S სერიას ხელოვნური ინტელექტის ინტეგრაციით და One UI 8.5-ს. მოსალოდნელია Galaxy S26 მოდელები, კამერის განახლებები და წინასწარი შეკვეთის წამახალისებელი შეთავაზებები.

Hugging Face-ის ინფრასტრუქტურის განახლება მონაცემთა გადაცემის გამოწვევების დასაძლევად
სტატია აღწერს Hugging Face-ის ინფრასტრუქტურის მასშტაბურ განახლებას, რომელიც მიზნად ისახავს მონაცემთა ატვირთვისა და ჩამოტვირთვის არსებული შეზღუდვების დაძლევას. ამჟამინდელი სისტემა, რომელიც AWS S3-სა და CloudFront-ს ეყრდნობა, ვეღარ აკმაყოფილებს მზარდი ზომის ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების მოთხოვნებს. ახალი არქიტექტურა წარმოადგენს კონტენტზე მისამართირებულ საცავს (Content-Addressed Store - CAS), რომელიც ფაილებს ბაიტის დონეზე ამუშავებს, რაც საშუალებას იძლევა ოპტიმიზაციის, გადა
ევროკავშირის AI აქტი: რა უნდა იცოდნენ ღია კოდის AI სისტემების შემქმნელებმა
ევროკავშირის ხელოვნური ინტელექტის აქტი (AI Act) შესაძლოა გავრცელდეს ღია კოდის AI სისტემებსა და მოდელებზე, სპეციფიკური წესებით, რომლებიც დამოკიდებულია მოდელის ტიპსა და მის გამოშვებაზე. უმეტეს შემთხვევაში, ვალდებულებები მოიცავს მკაფიო დოკუმენტაციის მიწოდებას, მოდელის შესახებ ინფორმაციის გასამჟღავნებლად ხელსაწყოების დამატებას განთავსებისას და არსებული საავტორო უფლებებისა და კონფიდენციალურობის წესების დაცვას. საბედნიეროდ, ამ პრაქტიკის უმეტესობა უკვე გავრცელებულია ღია კოდის სივრცეში, და Hugging Face
AMD Hugging Face-ის აპარატურის პარტნიორი ხდება: ახალი ეტაპი ხელოვნური ინტელექტის განვითარებაში
ტექნოლოგიურმა გიგანტებმა Hugging Face-მა და AMD-მ გამოაცხადეს სტრატეგიული პარტნიორობა, რომელიც მიზნად ისახავს უახლესი ტრანსფორმატორული მოდელების ოპტიმიზაციას AMD-ის ცენტრალურ პროცესორებსა (CPUs) და გრაფიკულ პროცესორებზე (GPUs). ეს თანამშრომლობა მნიშვნელოვნად გააფართოებს ღრმა სწავლისთვის ხელმისაწვდომი აპარატურის არჩევანს, შეამცირებს ხარჯებს და დააწესებს ახალ სტანდარტებს ხელოვნური ინტელექტის (AI) გამოთვლებში.
ხელოვნური ინტელექტის შეცდომების გამოსწორება: ინტერაქტიული ასისტენტის ტესტირება Keras Chatbot Arena-ზე
ეს სტატია აღწერს ექსპერიმენტს, რომელიც მიზნად ისახავს შეამოწმოს, რამდენად ეფექტურად შეუძლიათ დიდ ენობრივ მოდელებს (LLM) საკუთარი შეცდომების გამოსწორება მარტივი ინგლისური უკუკავშირის საფუძველზე. ავტორი ქმნის სპეციალურ გარემოს Gradio-ზე Spaces-ით, Keras-ის, JAX-ისა და TPUs-ის გამოყენებით, რათა ერთდროულად რამდენიმე ჩეთბოტთან იმუშაოს და შეაფასოს მათი უნარი, მოახდინონ API ზარების გენერირება და შეასწორონ შეცდომები. განხილულია ტექნიკური დეტალები და მიდგომები მოდელების მრავალ ბირთვზე ოპტიმიზაციისთვის, მ
კონტენტის პოლიტიკის განახლება: ხელოვნური ინტელექტი, თანხმობა და თანამშრომლობა
ჩვენი განახლებული კონტენტის პოლიტიკა ეხება ხელოვნური ინტელექტისა და მანქანური სწავლების სირთულეებს, ხაზს უსვამს პასუხისმგებლობით განვითარებას, მომხმარებლის უფლებებსა და თანხმობის კრიტიკულ როლს. ის ხელს უწყობს საზოგადოების თანამშრომლობას და ასახავს ძალისხმევას უსაფრთხო, გამჭვირვალე პლატფორმის შესანარჩუნებლად ტექნოლოგიურ და სამართლებრივ მიღწევებთან ადაპტირებისას.
Core ML-ის ოპტიმიზაცია: Apple-ის მოწყობილობებზე AI მოდელების მუშაობის ახალი დონე
Core ML-ის უახლესი გაუმჯობესებები მნიშვნელოვნად აჩქარებს ხელოვნური ინტელექტის (AI) მოდელების, მათ შორის Stable Diffusion-ისა და დიდი ენის მოდელების, მუშაობას Apple-ის მოწყობილობებზე. ეს ოპტიმიზაციები, რომელიც მოიცავს 6-ბიტიან პალეტიზაციას და ml-stable-diffusion რეპოზიტორიუმის განახლებას, უზრუნველყოფს მონაცემთა ნაკლებ გადაცემას, მეტ კონფიდენციალურობას და ხარჯების დაზოგვას, რაც დეველოპერებს აძლევს საშუალებას, შექმნან უფრო ეფექტური აპლიკაციები უშუალოდ მოწყობილობაზე.
Hugging Face-ის ღია მოდელები ახლა უკვე ხელმისაწვდომია Amazon Bedrock Marketplace-ზე
Hugging Face-ის პოპულარული ღია მოდელები ახლა უკვე ხელმისაწვდომია Amazon Bedrock-ზე, ახალი Bedrock Marketplace-ის ფარგლებში. AWS-ის მომხმარებლებს შეუძლიათ 83 ღია მოდელის განთავსება გენერაციული ხელოვნური ინტელექტის (Generative AI) აპლიკაციების შესაქმნელად. ეს ინტეგრაცია აერთიანებს SageMaker Jumpstart-ის გამოყენების სიმარტივეს Amazon Bedrock-ის სრულად მართულ ინფრასტრუქტურასთან, რაც უზრუნველყოფს მაღალი დონის API-ებთან თავსებადობას.
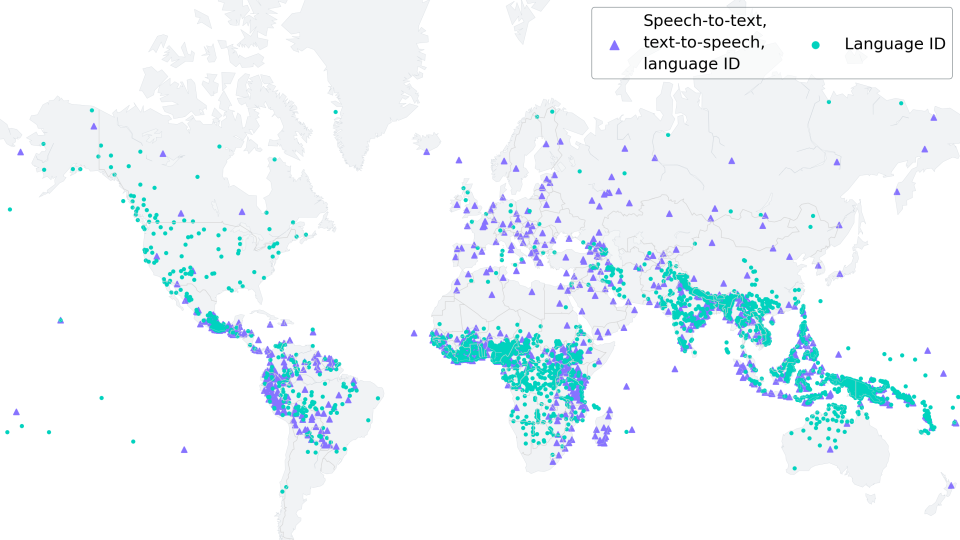
MMS: ხელოვნური ინტელექტი მრავალენოვანი მეტყველების ამოცნობისა და გადაშენების პირას მყოფი ენების გადასარჩენად
Meta AI-ის უახლესი მოდელი, Massive Multilingual Speech (MMS), რევოლუციას ახდენს მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. მას შეუძლია 1,100-ზე მეტი ენის იდენტიფიცირება, ტრანსკრიფცია და გენერირება, მათ შორის გადაშენების პირას მყოფი ენებისაც. ადაპტერის გაწვრთნის ინოვაციური მეთოდის წყალობით, MMS აღწევს სიტყვების შეცდომის საოცრად დაბალ მაჩვენებლებს მინიმალური დამატებითი გაწვრთნით, რაც განსაკუთრებით ეფექტურია დაბალი რესურსების მქონე ენებისთვის. ეს ტექნოლოგია პოტენციურად გადამწყვეტ როლს ითამაშებ

სინთეზური მონაცემების გენერაცია: ხელოვნური ინტელექტის შესაძლებლობების გაფართოება
სტატია მიმოიხილავს სინთეზური მონაცემების მნიშვნელობასა და გენერაციის პროცესს. სინთეზური მონაცემები არის ხელოვნურად შექმნილი ინფორმაცია, რომელიც რეალურ სამყაროს მონაცემებს მიბაძავს და ხელს უწყობს მონაცემთა შეზღუდვების დაძლევას, ნაკრებების გაფართოებით ან გაუმჯობესებით. აღწერილია სინთეზური მონაცემების გენერატორის გამოყენება Hugging Face-ის უფასო API-სა და Argilla-ს ინტეგრაციის მეშვეობით, ტექსტის კლასიფიკაციისა და ჩატის მონაცემთა ნაკრებების შესაქმნელად. მოცემულია დეტალური სამსაფეხურიანი პროცესი მონა
Hugging Face-ი აშშ-ის ვაჭრობის დეპარტამენტს ხელოვნური ინტელექტის ანგარიშვალდებულების შესახებ რეკომენდაციებს წარუდგენს
12 ივნისს, Hugging Face-მა აშშ-ის ვაჭრობის დეპარტამენტს (NTIA) ხელოვნური ინტელექტის ანგარიშვალდებულების პოლიტიკის შესახებ თავისი პასუხი წარუდგინა. კომპანია ხაზს უსვამს დოკუმენტაციისა და გამჭვირვალობის მნიშვნელობას, ასევე დაინტერესებული მხარეების სრულ ექსპერტიზაზე დაყრდნობის აუცილებლობას. Hugging Face-ის მისიაა „კარგი მანქანური სწავლების დემოკრატიზაცია“, რაც გულისხმობს სისტემების მარტივ გაგებას, შეფასებას და კრიტიკას ყველა დაინტერესებული მხარისთვის.

აგენტური AI-ის პოტენციალის განბლოკვა CPU-ზე: Intel Xeon და AMX-ის როლი
აგენტური ხელოვნური ინტელექტი (AI) AI-ის განვითარების შემდეგ ეტაპად მიიჩნევა, რომელიც LLM-ების მსჯელობის შესაძლებლობებს კონტექსტის ღრმა გაგებასთან აკავშირებს. თუმცა, არსებობს გამოწვევა 'მასპინძელი-აქსელერატორი' ტრაფიკის ზედმეტი დატვირთვის მხრივ, რადგან სისტემებში სულ უფრო მეტი CPU-ზე მომუშავე ხელსაწყო ინტეგრირდება. ამ პრობლემის გადასაჭრელად, მუშავდება მცირე ენობრივი მოდელები (SLM) და CPU-ები, როგორიცაა Intel Xeon-ის მე-4 და მე-5 თაობა, რომლებიც ინტეგრირებულ AMX ტექნოლოგიას გვთავაზობენ AI მუშაობის

ფალკონ3: ხელოვნური ინტელექტის მოდელების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
„ფალკონ3“ წარმოადგენს ხელოვნური ინტელექტის მოდელების ახალ ოჯახს, რომელიც წინა ვერსიების ბუნებრივ ევოლუციას ასახავს. ახალი იტერაცია ფოკუსირებულია მეცნიერების, მათემატიკისა და კოდის შესაძლებლობების გაფართოებაზე, აჩვენებს მაღალ წარმადობას საერთო საორიენტაციო ტესტებზე და მოიცავს ხუთ ძირითად მოდელს ინოვაციური არქიტექტურით. მოდელები გამოქვეყნებულია Falcon LLM ლიცენზიით, რაც ხელს უწყობს ხელოვნური ინტელექტის ხელმისაწვდომობას და თანამშრომლობას, ხოლო 2025 წლის იანვარში მოსალოდნელია მულტიმოდალური შესაძლებლ

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი
ტექსტიდან გამოსახულების გენერირების ხელოვნური ინტელექტის მოდელების მიკერძოება: გამოწვევები და გადაწყვეტის გზები
ეს სტატია ღრმად იკვლევს ტექსტიდან გამოსახულების გენერირების (TTI) ხელოვნური ინტელექტის მოდელებში არსებული მიკერძოების კომპლექსურ პრობლემას. განხილულია მიკერძოების მრავალფეროვანი წყაროები, მათ შორის საწვრთნელ მონაცემებში, წინასწარ გაფილტვრაში, მოდელების ლატენტურ სივრცესა და დასკვნის ეტაპზე. სტატია ხაზს უსვამს, თუ როგორ იწვევს სოციალურ ღირებულებებსა და კულტურულ სტერეოტიპებზე დაფუძნებული მიკერძოება არარეპრეზენტაციულ და პოტენციურად მავნე გამოსახულებებს, რაც მუდმივ ეთიკურ გამოწვევას წარმოადგენს ხელოვ