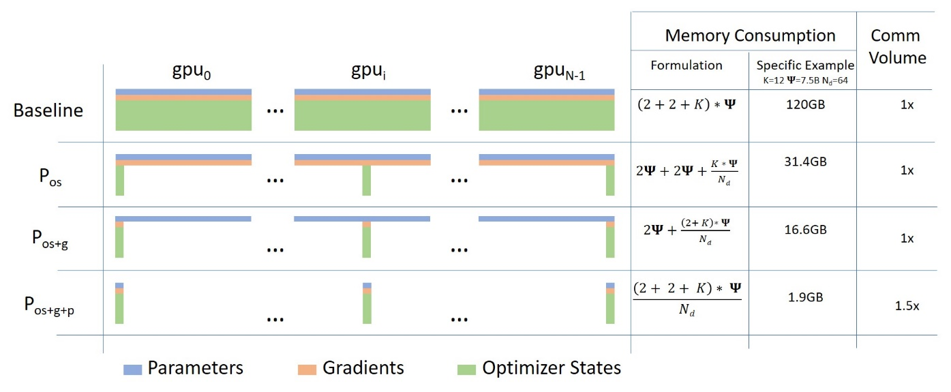
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.
Hugging Face წარმოგიდგენთ SafeCoder-ს: უსაფრთხო, თვით-ჰოსტინგით AI პროგრამისტს საწარმოებისთვის
Hugging Face-ის SafeCoder მიზნად ისახავს პროგრამული უზრუნველყოფის შემუშავების პროდუქტიულობის გაზრდას საწარმოებში, სრულად შესაბამისი, თვით-ჰოსტინგითა და უსაფრთხო AI კოდის ასისტენტის შეთავაზებით. გადაწყვეტა ეფუძნება ღია კოდის მოდელებს, როგორიცაა StarCoder, და უზრუნველყოფს მონაცემთა კონფიდენციალურობასა და იურიდიულ შესაბამისობას, რადგან კომპანიებს საშუალებას აძლევს, საკუთარ ინფრასტრუქტურაზე დაახვეწონ LLM-ები, მესამე მხარესთან კოდის გაზიარების გარეშე.
Hugging Face-ის ეკოსისტემაში Code Llama-ს ინტეგრაცია გამოცხადდა: პროგრამირების ახალი ეპოქა
Code Llama, Llama 2-ის საფუძველზე შექმნილი კოდზე სპეციალიზებული ხელოვნური ინტელექტის მოდელების ოჯახი, Hugging Face-ის ეკოსისტემაში ინტეგრირდა. ის პროგრამისტების პროდუქტიულობის გაზრდას ისახავს მიზნად კოდის შევსებით, დოკუმენტაციის გენერირებით და ერთეული ტესტების შექმნით. მოდელები ხელმისაწვდომია 7B, 13B და 34B პარამეტრის ვარიანტებში, მათ შორის Python-ის სპეციალისტი და ინსტრუქციებზე მორგებული ვერსიები, და მხარს უჭერენ 100,000-მდე ტოკენის კონტექსტურ ფანჯარას.
Hugging Face Hub: მონაცემთა გადაცემის და შენახვის ოპტიმიზაცია დედუპლიკაციის ახალი მიდგომებით
Hugging Face Hub-ზე ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების სწრაფი ზრდა მოითხოვს ეფექტურ მონაცემთა მართვას. სტატია აღწერს, თუ როგორ უმკლავდება Xet გუნდი გამოწვევებს, რომლებიც დაკავშირებულია დედუპლიკაციასთან, ტრადიციული მიდგომების შეზღუდვებთან და მასშტაბირებადობასთან. ნაცვლად იმისა, რომ ფოკუსირება მხოლოდ მცირე ბლოკების დედუპლიკაციაზე მოხდეს, რაც ინფრასტრუქტურას გადატვირთავს, Xet გუნდმა შეიმუშავა ინოვაციური, ბლოკებზე დაფუძნებული მიდგომა Rust-ში დაწერილი xet-core და hf_xet ინტეგრაცი
Hugging Face-ის ზაფხულის განახლებები: ივნისი, ივლისი, აგვისტო
ეს პოსტი აჯამებს Hugging Face-ის ივნის-აგვისტოს განახლებებს, მათ შორის საჯარო მოდელების რეპოზიტორიების 10,000-დან 16,000-მდე ზრდას. წარმოდგენილია ახალი ფუნქციები, როგორიცაა „Spaces“ ML დემო აპლიკაციების ჰოსტინგისთვის, ნივთების „მოწონების“ შესაძლებლობა, TensorBoard-ის ინტეგრაცია, შეფასების მეტრიკები, რომლებიც დაკავშირებულია Papers With Code-თან, ახალი ვიჯეტები სხვადასხვა ML ამოცანებისთვის (აუდიო, სტრუქტურირებული მონაცემები, გამოსახულება), გაუმჯობესებული დოკუმენტაცია, რეპოზიტორიების გადატანა/გადარ
როგორ განავითარა Rocket Money-მ ტრანზაქციების კლასიფიკაციის AI სისტემა: Regex-დან BERT-ამდე და Hugging Face-მდე
Rocket Money (ყოფილი Truebill) მომხმარებლებს ფინანსური კეთილდღეობის გაუმჯობესებაში ეხმარება ტრანზაქციების კლასიფიკაციის გზით. თავდაპირველად, კომპანია რეგულარულ გამოსახულებებს (regex) იყენებდა, თუმცა მომხმარებელთა ზრდასთან ერთად, სისტემას მასშტაბირების პრობლემები შეექმნა. ამ გამოწვევის საპასუხოდ, Rocket Money-მ მიმართა მანქანური სწავლის (ML) გადაწყვეტილებებს და ნულიდან ააწყო შიდა სისტემა, რომელიც BERT მოდელების ოჯახს იყენებს. მოდელების წარმატებული ოფლაინ ტესტირების შემდეგ, კომპანია შეუდგა საწარმო
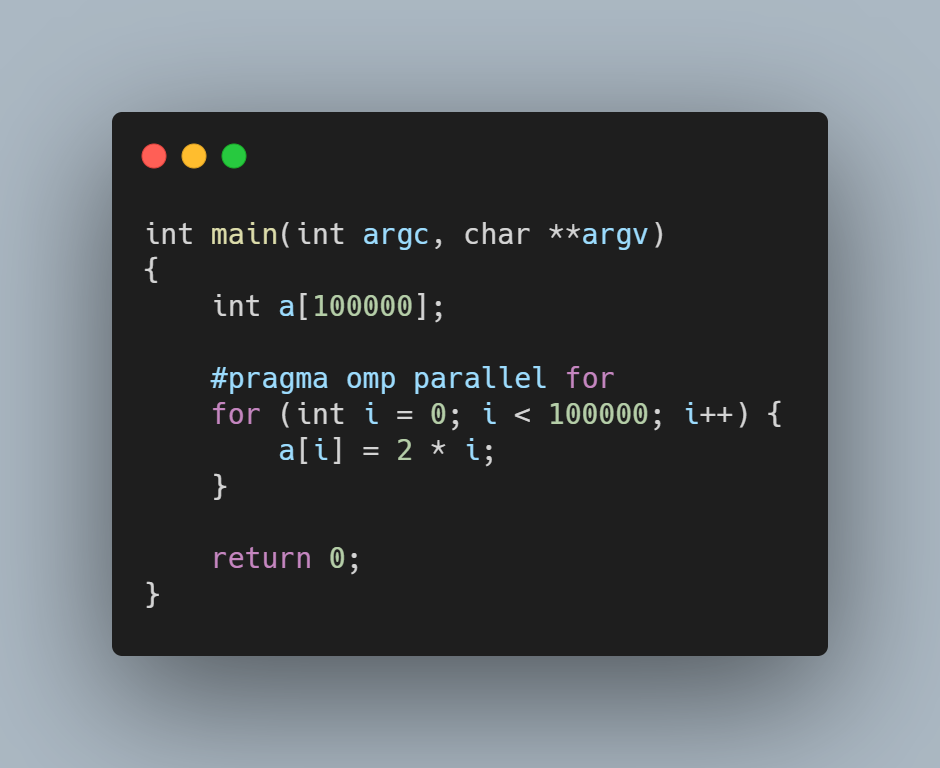
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და

PyTorch-ის სწავლების აჩქარება Intel Xeon პროცესორებზე: ღრმა სწავლის ახალი მიდგომა
გრაფიკული პროცესორები (GPUs) დიდი ხანია ღრმა სწავლის მოდელების სწავლების დე ფაქტო არჩევანი იყო. თუმცა, ტრანსფერული სწავლის ზრდა ცვლის თამაშის წესებს. მოდელები ახლა იშვიათად სწავლება ნულიდან უზარმაზარ მონაცემთა ნაკრებებზე; ამის ნაცვლად, ისინი ხშირად ზუსტდება კონკრეტულ (და მცირე) მონაცემთა ნაკრებებზე, რათა შეიქმნას სპეციალიზებული მოდელები, რომლებიც უფრო ზუსტია კონკრეტული ამოცანებისთვის, ვიდრე საბაზისო მოდელი. რადგან ეს სწავლების ამოცანები ბევრად უფრო ხანმოკლეა, CPU-ზე დაფუძნებული კლასტერის გამოყენ

Gradio-ს მონაცემთა ცხრილის მასშტაბური განახლება: ახალი ფუნქციები და გაუმჯობესებები
Gradio-მ გამოუშვა მონაცემთა ცხრილის კომპონენტის მნიშვნელოვანი განახლება, რომელშიც 70-ზე მეტი საკითხი დაფიქსირდა და მრავალი ახალი ფუნქცია დაემატა. მათ შორისაა მრავალუჯრედიანი მონიშვნა, სვეტების მიმაგრება, კოპირების ახალი ღილაკი, სრული ეკრანის რეჟიმი, კლავიატურის გაუმჯობესებული ნავიგაცია, ძიების და ფილტრაციის ფუნქციები. განახლება მიზნად ისახავს მომხმარებლის გამოცდილების გაუმჯობესებას და ხელმისაწვდომობის გაზრდას. Gradio-ს უახლესი ვერსია უკვე ხელმისაწვდომია და მისი განახლება შესაძლებელია `pip instal
LoRA მოდელების ინფერენსის ოპტიმიზაცია ხელოვნურ ინტელექტში: სიჩქარე და ეფექტურობა
ამ ბლოგში დეტალურად განვიხილავთ, თუ როგორ შევძელით საჯარო Diffusion მოდელებზე დაფუძნებული საჯარო LoRA-ებისთვის ინფერენსის სიჩქარის მკვეთრი გაზრდა. ამან მოგვცა რესურსების დაზოგვისა და მომხმარებლისთვის უფრო სწრაფი და უკეთესი გამოცდილების შეთავაზების საშუალება. ჩვენ შევამცირეთ გაშვების საწყისი დრო 25 წამიდან 3 წამამდე, ხოლო მომხმარებლის მოთხოვნებზე პასუხის დრო 35 წამიდან 13 წამამდე. ამჟამად, ასობით განსხვავებული LoRA-ს ინფერენსს ვუზრუნველყოფთ 5-ზე ნაკლები A10G GPU-ით. განვიხილავთ LoRA ტექნიკის არსს
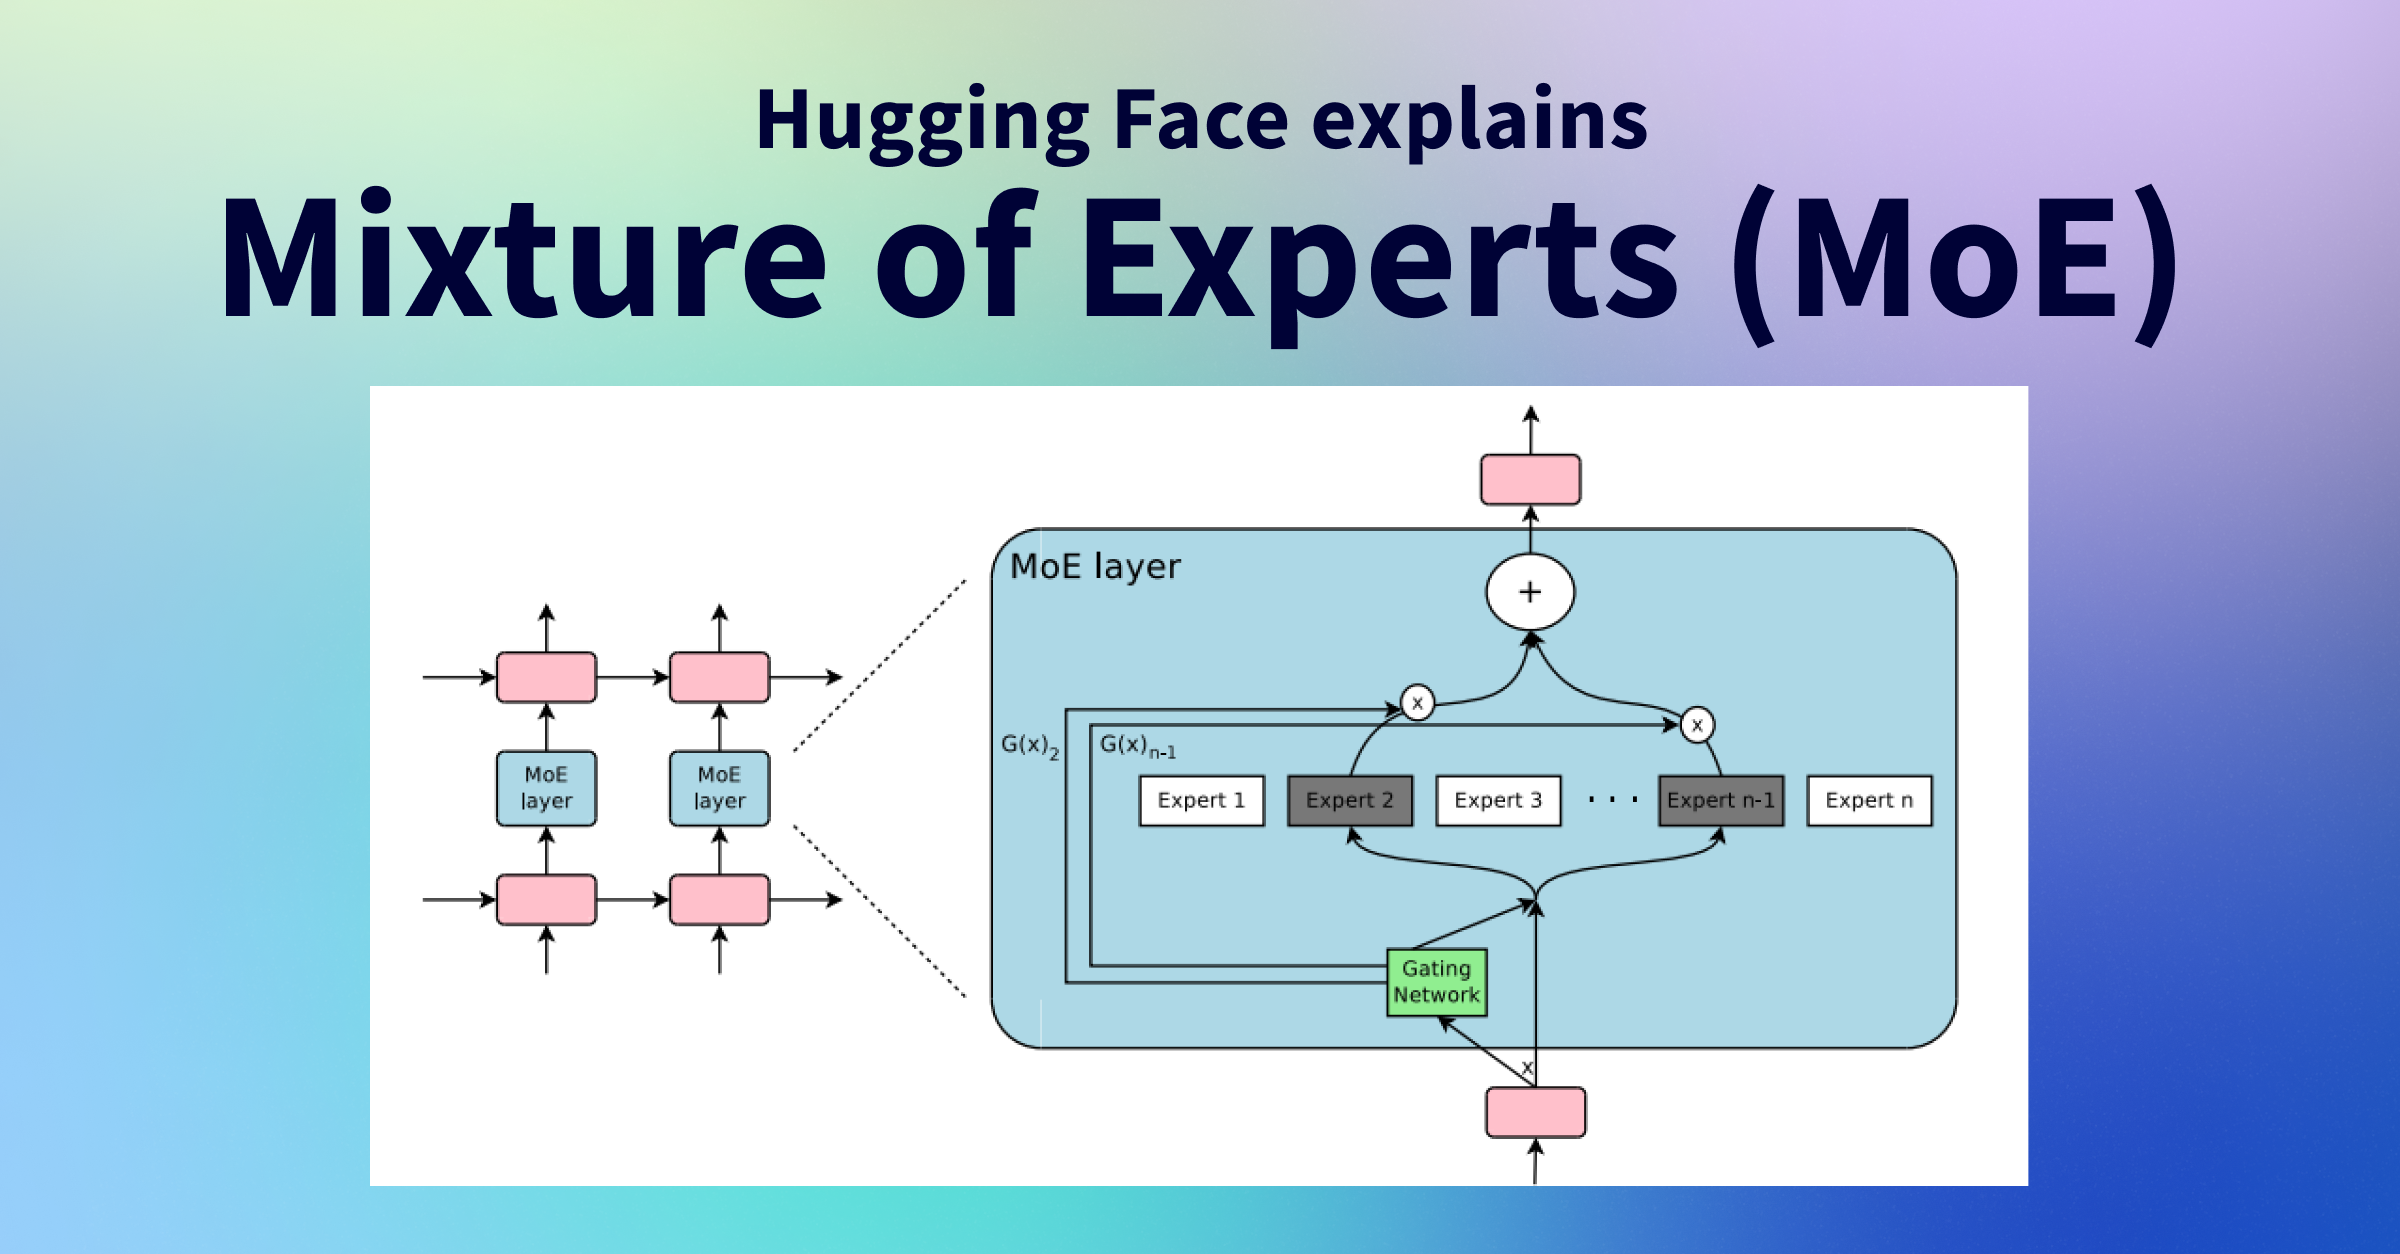
ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი
ONNX Runtime მნიშვნელოვნად აჩქარებს SD Turbo-სა და SDXL Turbo-ს NVIDIA GPU-ებზე
SD Turbo და SDXL Turbo, Stable Diffusion-ის სწრაფი, გენერაციული ტექსტიდან გამოსახულების მოდელები, რომლებსაც შეუძლიათ გამოსაყენებელი სურათების გენერირება ერთ ნაბიჯში, ახლა ONNX Runtime-ის მეშვეობით კიდევ უფრო სწრაფი ხდება. ONNX Runtime-ის CUDA და TensorRT შესრულების პროვაიდერებში ოპტიმიზაციებმა გამოიწვია გამტარუნარიანობის 229%-მდე ზრდა SDXL Turbo-სთვის და 120%-მდე SD Turbo-სთვის NVIDIA GPU-ებზე, რაც მნიშვნელოვნად აღემატება PyTorch-ის მაჩვენებლებს. ეს გაუმჯობესება, გარდა შესრულების უპირატესობებისა
Fastai-სა და Hugging Face Hub-ის ინტეგრაცია: ღრმა სწავლის მოდელების გაზიარება ერთი კლიკით
Hugging Face-ი სიამაყით აცხადებს fastai-სთან ინტეგრაციას, რაც fastai-ს პრაქტიკოსებს საშუალებას აძლევს, ერთი ხაზის პითონის კოდით ატვირთონ და გააზიარონ ღრმა სწავლის მოდელები Hugging Face Hub-ზე. ეს ნაბიჯი მიზნად ისახავს მანქანური სწავლის დემოკრატიზაციას, წინასწარ გაწვრთნილი მოდელების ჩათვლით, და ხელს უწყობს ღია კოდის საზოგადოების ზრდასა და თანამშრომლობას.
Hugging Face-მა C სერიის დაფინანსებით 100 მილიონი დოლარი მოიზიდა: ხელოვნური ინტელექტის მომავლისკენ
Hugging Face-მა, ხელოვნური ინტელექტის წამყვანმა პლატფორმამ, 100 მილიონი დოლარის დაფინანსება მოიზიდა C სერიის ფარგლებში, Lux Capital-ის ხელმძღვანელობით, Sequoia-სა და Coatue-ის მნიშვნელოვანი მონაწილეობით. კომპანია, რომელიც 2018 წლიდან მასშტაბურ ზრდას განიცდის, განაგრძობს მანქანური სწავლების დემოკრატიზაციას ღია წყაროს, გამჭვირვალობისა და თანამშრომლობის პრინციპებზე დაყრდნობით, რათა ხელი შეუწყოს პასუხისმგებლიან ხელოვნურ ინტელექტს და გაუმკლავდეს სფეროს გამოწვევებს.
Hugging Face-ის ფელოუშიპის პროგრამა: ღია წყაროს კონტრიბუტორების მხარდაჭერა და გავლენის გაზრდა
Hugging Face-ის ფელოუშიპის პროგრამა მიზნად ისახავს ღია წყაროს მანქანური სწავლების კონტრიბუტორების გაძლიერებას. პროგრამა სთავაზობს რესურსებს, აღიარებას და დამხმარე საზოგადოებას, რათა მონაწილეებმა გაზარდონ თავიანთი გავლენა და განახორციელონ ის პროექტები, რაზეც ყოველთვის ოცნებობდნენ. ფელოუშიპი მხარს უჭერს მრავალფეროვნებას და მიესალმება ნებისმიერი წარმომავლობის მქონე პირებს, ხაზს უსვამს ინდივიდუალურ წვლილს სფეროს დემოკრატიზაციაში.

Xeon პროცესორებზე წარმადობის მნიშვნელოვანი ზრდა ჩაშენებული მოდელების ოპტიმიზაციით Optimum Intel-ისა და fastRAG-ის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ მივაღწიოთ წარმადობის მნიშვნელოვან ზრდას Intel Xeon-ზე დაფუძნებულ CPU-ებზე, ოპტიმიზებული ჩაშენების (embedding) მოდელების ინტეგრირებით არსებულ RAG კონვეიერებში fastRAG-ის გამოყენებით. განხილულია Optimum Intel ბიბლიოთეკის როლი მოდელების დასაჩქარებლად, ისეთი ტექნიკების გამოყენებით, როგორიცაა დაბალბიტიანი კვანტიზაცია და Intel-ის სპეციფიკური გაფართოებების (AVX-512, VNNI, AMX) გამოყენება. სტატია ყურადღებას ამახვილებს BGE მოდელებზე და წარმოგიდგენთ ნაბიჯ-ნაბიჯ სახელმძღ

Hugging Face-ისა და AMD-ის გარღვევა AI მოდელების ოპტიმიზაციაში MI300X-ზე
Hugging Face-მა და AMD-მ ითანამშრომლეს, რათა მნიშვნელოვნად გაეუმჯობესებინათ ხელოვნური ინტელექტის მოდელების, კერძოდ Llama 3.1 405B-ის ინფერენსის შესრულება AMD MI300X GPU-ებზე. პროექტი ფოკუსირებულია დაბალი დონის კერნელების ოპტიმიზაციაზე, რაც გადამწყვეტია მილიარდობით პარამეტრის მქონე მოდელებისთვის. ამ თანამშრომლობის შედეგად შეიქმნა ღია კოდის მორგებული კერნელები, რომლებმაც მნიშვნელოვანი სიჩქარის ზრდა აჩვენეს, განსაკუთრებით AMD-ის აპარატურისთვის, რომელიც ხშირად იგნორირებულია კერნელის დეველოპერების მი

Flux.1-Dev მოდელის ინფერენციის ოპტიმიზაცია LoRA-ს გამოყენებით: 2.3x-მდე სიჩქარის ზრდა
ეს პოსტი დეტალურად განიხილავს Flux.1-Dev ტექსტიდან გამოსახულების გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაციას, განსაკუთრებით LoRA-ების გამოყენებისას. შემოთავაზებულია "ცხელი გაცვლის" (hotswapping) ტექნიკა ხელახალი კომპილაციის თავიდან ასაცილებლად, FP8 კვანტიზაციის უპირატესობები, და სტრატეგიები სამომხმარებლო GPU-ებისთვის, როგორიცაა RTX 4090, CPU-ზე გადმოტვირთვით და T5 ტექსტური ენკოდერის კვანტიზაციით, რაც უზრუნველყოფს 2.3-ჯერადი სიჩქარის ზრდას.
როგორ აძლიერებს Intel-ი RAG აპლიკაციებს OPEA პლატფორმაზე: Gaudi 2 და Xeon CPU-ები
ინფორმაციის მოძიებით გაძლიერებული გენერაცია (RAG) კრიტიკულად მნიშვნელოვანია დიდი ენობრივი მოდელებისთვის (LLM) ახალი ცოდნის ინკორპორირებისთვის, რაც აუმჯობესებს წარმადობასა და უსაფრთხოებას. Intel, OPEA პლატფორმის ფარგლებში, დეველოპერებს სთავაზობს სრულყოფილ გადაწყვეტილებებს RAG აპლიკაციების შესაქმნელად და ოპტიმიზაციისთვის. სტატია დეტალურად აღწერს Intel Gaudi 2 AI ამაჩქარებლებისა და Xeon CPU-ების როლს საწარმოო წარმადობის მნიშვნელოვნად გაზრდაში. ასევე განხილულია LangChain ფრეიმვორკის გამოყენება RAG ა

Bloom მოდელის ოპტიმიზაცია: გზა 5x შეყოვნების შემცირებამდე და 50x გამტარუნარიანობამდე
ამ სტატიაში განხილულია Bloom-ის დიდი ენობრივი მოდელის (LLM) ოპტიმიზაციის პროცესი, რამაც გამოიწვია ინფერენციის შეყოვნების 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. აღწერილია გამოწვევები, მათ შორის მოდელის `transformers` ბიბლიოთეკაში პორტირება, მკაცრი ტესტირების ნაკრების შექმნა, მონაცემთა სხვადასხვა ტიპებთან (bfloat16 vs float16) მუშაობა და ტენზორული პარალელიზმის საკითხები. საბოლოოდ, განიხილება ისეთი გადაწყვეტილებები, როგორიცაა `Megatron-Deepspeed` ტრენინგისთვის, მცირე მოდელების გამოყენე
BLOOM მოდელის ოპტიმიზაცია: 5-ჯერ შემცირებული ლატენტურობა და 50-ჯერ გაზრდილი გამტარუნარიანობა
ამ სტატიაში აღწერილია BLOOM მოდელის ინფერენსის სიჩქარის გაუმჯობესების რთული, მაგრამ წარმატებული პროცესი, რამაც გამოიწვია ლატენტურობის 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. განხილულია მოდელის „ტრანსფორმერების“ ბიბლიოთეკასთან ადაპტაციის, ტესტირებისა და განაწილებული ინფერენსისთვის მომზადების ეტაპები, გამოწვევები და გადაწყვეტილებები.
TII Falcon 2-ს წარმოგიდგენთ: მცირე ზომის, მაღალეფექტური მრავალმოდალური AI მოდელები ღია კოდის საზოგადოებისთვის
TII უშვებს Falcon 2 მოდელების ახალ თაობას, რომელიც გამიზნულია ღია კოდის საზოგადოებისთვის გაუმჯობესებული შესრულების, მრავალმოდალური მხარდაჭერისა და უფრო დაბალი გამოთვლითი ხარჯების მქონე მცირე ზომის მოდელების მიწოდებაზე. ეს ინიციატივა მიზნად ისახავს AI-ის გამოყენებადობის გაზრდას და ახალი აპლიკაციების შემუშავების წახალისებას. Falcon 2 მოიცავს არა მხოლოდ ენობრივ (LLM), არამედ ვიზუალურ-ენობრივ (VLM) მოდელებსაც, რომლებსაც გამოსახულებების გაგება შეუძლიათ. მოდელი გაწვრთნილია ვრცელ მრავალენოვან მონაცემთა

AI კონტენტის გამჭვირვალობა: Hugging Face აადვილებს წყლის ნიშნების დამატებას
Hugging Face წარმოგიდგენთ მარტივ გზას ხელოვნური ინტელექტის მიერ გენერირებულ კონტენტზე ხილული წყლის ნიშნების დასამატებლად Gradio-ს გამოყენებით. ეს ინიციატივა მიზნად ისახავს AI-გენერირებული სურათების, ვიდეოების, აუდიოსა და ტექსტების იდენტიფიცირების სირთულის დაძლევას, გამჭვირვალობის გაზრდას და მომხმარებლებისთვის ნდობის ამაღლებას. კომპანია დეველოპერულ საზოგადოებას მოუწოდებს, მიიღონ ეს პრაქტიკა პოტენციური კანონმდებლობის თავიდან ასაცილებლად.

Transformers-ის დოკუმენტაციის მასშტაბური განახლება: რატომ გახდა ის აუცილებელი
Transformers-ის ბიბლიოთეკის დოკუმენტაცია, რომელიც თავდაპირველად მანქანური სწავლების ინჟინრებსა და მკვლევრებზე იყო მორგებული, ხელოვნური ინტელექტის (AI) სწრაფი განვითარების ფონზე მოუწესრიგებელი და მოძველებული გახდა. მიმდინარეობს მასშტაბური რედიზაინი, რათა დოკუმენტაცია გახდეს კოდზე ორიენტირებული, გადაწყვეტილებებისკენ მიმართული და მომხმარებელზე მორგებული, განსაკუთრებით კი დეველოპერებისთვის. მიზანია, უზრუნველყოს მისი ზრდა და ადაპტაცია მომავალ საჭიროებებთან, სიხისტე კი მოქნილობით ჩანაცვლდეს.