Hugging Face-ი და Graphcore-ი AI-ის ოპტიმიზაციისთვის პარტნიორობენ IPU-ებზე Transformer მოდელების განვითარებით
Hugging Face-ის ახალი აპარატურის პარტნიორის პროგრამა Graphcore-ის სისტემების მომხმარებელ დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ IPU-ებისთვის ოპტიმიზებული უახლესი Transformer მოდელები. ეს თანამშრომლობა მიზნად ისახავს ხელოვნური ინტელექტის აპლიკაციების დაჩქარებას, მაღალი წარმადობისა და ეფექტურობის უზრუნველყოფით ისეთ სფეროებში, როგორიცაა ბუნებრივი ენის დამუშავება (NLP), კომპიუტერული ხედვა და სხვა.
ობიექტის ამოცნობის ლიდერბორდი: მეტრული მაჩვენებლების გაგება და კრიტიკული შეფასება
Hugging Face Hub-მა გამოაქვეყნა ობიექტის ამოცნობის ლიდერბორდი, რომელიც აფასებს მოდელებს სხვადასხვა მეტრიკის საფუძველზე, როგორიცაა „კვეთა გაერთიანებაზე“ (IoU), „საშუალო სიზუსტე“ (AP) და „საშუალო გახსენება“ (AR). ეს ბლოგი დეტალურად განიხილავს მოდელების შეფასების მეთოდებს, განმარტავს გამოყენებულ მეტრიკას და მიზნად ისახავს შეფასებისას წარმოშობილი სირთულეების გამარტივებას, რათა მომხმარებლებს შეეძლოთ მოდელის მუშაობის კრიტიკულად შეფასება. ასევე ახსნილია ობიექტის ამოცნობის კონცეფცია, მისი აპლიკაციები და

Hugging Face და IISc/ARTPARK ინდოეთის ლინგვისტური მრავალფეროვნების მხარდასაჭერად Vaani მონაცემთა ნაკრებს აფართოებენ
Hugging Face-ისა და IISc/ARTPARK-ის პარტნიორობა მიზნად ისახავს Vaani მონაცემთა ნაკრების ხელმისაწვდომობისა და გამოყენებადობის გაუმჯობესებას, რაც ხელს შეუწყობს AI სისტემების განვითარებას ინდოეთის მრავალფეროვანი ენების უკეთ გასაგებად. Project Vaani, რომელიც 2022 წელს IISc/ARTPARK-მა და Google-მა დაიწყეს, არის პიონერული ინიციატივა ღია კოდის მრავალმოდალური მონაცემთა ნაკრების შესაქმნელად, რომელიც ინდოეთის ლინგვისტურ მრავალფეროვნებას ასახავს. ამ მონაცემთა ნაკრებს უკვე მოიცავს 54 ენას და მოიცავს სპონტან
Hugging Face-ის სიახლეები: ივნისი, ივლისი, აგვისტო
ბოლო თვეებში Hugging Face Hub მნიშვნელოვნად გაფართოვდა, დაინერგა „Spaces“ მანქანური სწავლების დემო აპლიკაციებისთვის, ასევე დაემატა ახალი ფუნქციები, როგორიცაა რეპოზიტორების მოწონება, TensorBoard-ის ინტეგრაცია და შეფასების დეტალური მეტრიკა. დაინერგა ახალი ვიჯეტები სხვადასხვა ხელოვნური ინტელექტის მოდელებისთვის (ტექსტი, აუდიო, გამოსახულება). პლატფორმამ გააუმჯობესა დოკუმენტაცია, რეპოზიტორების მართვა და გამოუშვა უფასო ონლაინ კურსი. დიდი საზოგადოებრივი ღონისძიება, რომელშიც 800-მდე მონაწილე იყო ჩართული,
Hugging Face-ის ზაფხულის განახლებები: ივნისი, ივლისი, აგვისტო
ეს პოსტი აჯამებს Hugging Face-ის ივნის-აგვისტოს განახლებებს, მათ შორის საჯარო მოდელების რეპოზიტორიების 10,000-დან 16,000-მდე ზრდას. წარმოდგენილია ახალი ფუნქციები, როგორიცაა „Spaces“ ML დემო აპლიკაციების ჰოსტინგისთვის, ნივთების „მოწონების“ შესაძლებლობა, TensorBoard-ის ინტეგრაცია, შეფასების მეტრიკები, რომლებიც დაკავშირებულია Papers With Code-თან, ახალი ვიჯეტები სხვადასხვა ML ამოცანებისთვის (აუდიო, სტრუქტურირებული მონაცემები, გამოსახულება), გაუმჯობესებული დოკუმენტაცია, რეპოზიტორიების გადატანა/გადარ
მარტივად შექმენით ინტერაქტიული ML დემოები Gradio-თი Hugging Face Spaces-ზე
ეს სტატია განმარტავს, თუ როგორ უნდა შექმნათ და უმასპინძლოთ ინტერაქტიულ მანქანური სწავლების მოდელების დემოებს Hugging Face Spaces-ზე Gradio-ს გამოყენებით. ის დეტალურად აღწერს პროცესს ინტერფეისების განსაზღვრიდან რთული მოდელების პაიპლაინების განთავსებამდე, ხაზს უსვამს Hugging Face-ის Inference API-სთან ინტეგრაციასა და Gradio Series-ის მოქნილობას.
როგორ განავითარა Rocket Money-მ ტრანზაქციების კლასიფიკაციის AI სისტემა: Regex-დან BERT-ამდე და Hugging Face-მდე
Rocket Money (ყოფილი Truebill) მომხმარებლებს ფინანსური კეთილდღეობის გაუმჯობესებაში ეხმარება ტრანზაქციების კლასიფიკაციის გზით. თავდაპირველად, კომპანია რეგულარულ გამოსახულებებს (regex) იყენებდა, თუმცა მომხმარებელთა ზრდასთან ერთად, სისტემას მასშტაბირების პრობლემები შეექმნა. ამ გამოწვევის საპასუხოდ, Rocket Money-მ მიმართა მანქანური სწავლის (ML) გადაწყვეტილებებს და ნულიდან ააწყო შიდა სისტემა, რომელიც BERT მოდელების ოჯახს იყენებს. მოდელების წარმატებული ოფლაინ ტესტირების შემდეგ, კომპანია შეუდგა საწარმო
Rocket Money-ის რევოლუცია ტრანზაქციების კლასიფიკაციაში: AI-ის დანერგვა და Hugging Face-ის სტრატეგიული არჩევანი
პირადი ფინანსების აპლიკაცია Rocket Money-მ, მომხმარებელთა მზარდი ბაზისა და გამოწერის ეკონომიკის ბუმის ფონზე, ტრანზაქციების კლასიფიკაციისა და გამყიდველების იდენტიფიცირების სისტემა განავითარა. კომპანია რეგულარულ გამოსახულებებზე (regex) დაფუძნებული სისტემიდან მანქანური სწავლების (ML) უფრო დახვეწილ მიდგომაზე (BERT მოდელები) გადავიდა. ტრადიციულ ML გადაწყვეტებთან დაკავშირებული სირთულეების და შიდა სისტემის აშენების შემდეგ, Rocket Money-მ წარმატებით მოახდინა BERT მოდელების ინტეგრაცია. მოდელების განსათავ
Streamlit Hugging Face Spaces-ში: ML მოდელებისა და მონაცემთა ვიზუალიზაცია
ეს სტატია განმარტავს, თუ როგორ გამოიყენოთ Streamlit Hugging Face Spaces-თან ერთად მანქანური სწავლების მოდელების დემოების შესაქმნელად და მონაცემთა ნაკრებების ვიზუალიზაციისთვის. ის მოიცავს მოდელების ჰოსტინგს, ინტერფეისის აგებას, მონაცემთა სტრიმინგსა და ვიზუალიზაციის კომპონენტების გამოყენებას, მაგალითად, „Write with Transformer“-ის რეპლიკაციით.
Hugging Face PRO მომხმარებლებისთვის ინფერენსის API ხელმისაწვდომი ხდება
Hugging Face-მა PRO მომხმარებლებისთვის ახალი ინფერენსის API გამოუშვა, რომელიც ექსკლუზიურ წვდომას აძლევს მათ კურირებულ, ულტრა-სწრაფ მოდელებზე, გაუმჯობესებული მოთხოვნათა ლიმიტებით. სიახლე ამარტივებს მოწინავე AI მოდელებთან ექსპერიმენტებს, პროტოტიპირებას და ინტეგრაციას დეველოპმენტის გარემოებებში, ინფრასტრუქტურის განლაგების საჭიროების გარეშე. სერვისი მოიცავს ტექსტის, კოდისა და გამოსახულების გენერაციის შესაძლებლობებს.

Hugging Face Hub-ის უსაფრთხოება JFrog-ის სკანერის ინტეგრაციით ძლიერდება
Hugging Face-მა JFrog-ის სკანერი თავის პლატფორმაზე დაამატა, რათა Hugging Face Hub-ზე უსაფრთხოება გააუმჯობესოს. ახალი სკანერი ამცირებს ცრუ დადებით შედეგებს და მოდელის წონებში არსებულ კოდს ღრმად აანალიზებს პოტენციური მავნე გამოყენების გამოსავლენად, განსაკუთრებით ისეთი მოწყვლადი სერიალიზაციის ფორმატებისთვის, როგორიცაა Pickle. ყველა საჯარო მოდელის რეპოზიტორი ავტომატურად დასკანირდება, რაც საზოგადოებას მოდელების უსაფრთხოდ გაზიარებაში ეხმარება.
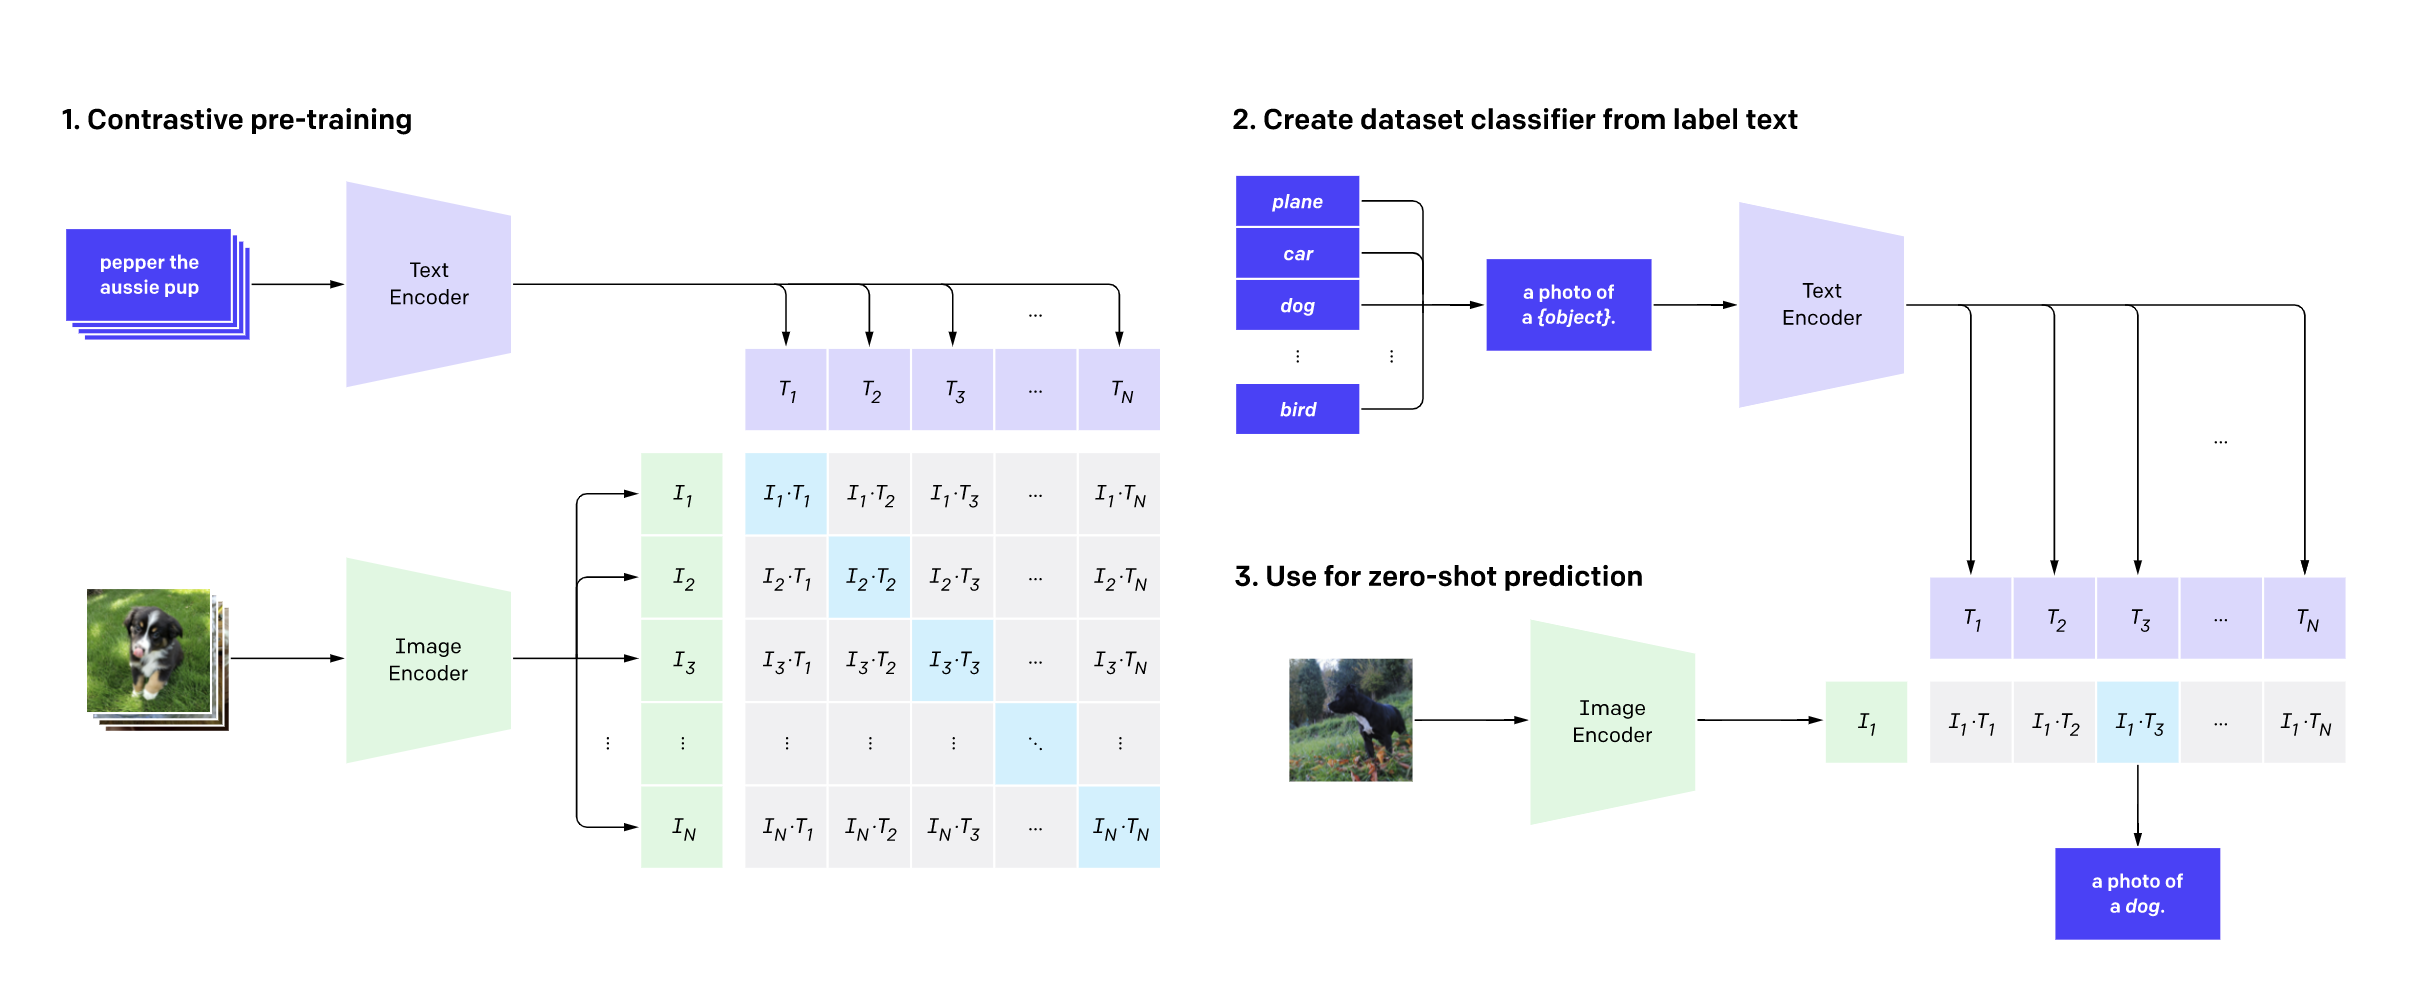
CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ
ახალი ბენჩმარკი: Llama 2-ის განლაგების ოპტიმალური სტრატეგიები Amazon SageMaker-ზე
დიდი ენობრივი მოდელების (დემ) განლაგება გამოწვევებთან არის დაკავშირებული მათი გამოთვლითი მოთხოვნებისა და დაყოვნების საჭიროებების გამო. ამ პრობლემის გადასაჭრელად, შემუშავდა ყოვლისმომცველი ბენჩმარკი, რომელმაც შეაფასა Llama 2-ის 60-ზე მეტი განლაგების კონფიგურაცია Amazon SageMaker-ზე Hugging Face-ის დემ დასკვნის კონტეინერის გამოყენებით. კვლევამ მიზნად დაისახა ოპტიმალური სტრატეგიების მოძიება კომპანიებისთვის, რათა დააბალანსონ ხარჯები, გამტარუნარიანობა და დაყოვნება Llama 2-ის სხვადასხვა ზომისა და Amazo
Llama 2-ის განლაგების ბენჩმარკინგი Amazon SageMaker-ზე: ოპტიმალური სტრატეგიები წარმადობისა და ხარჯთეფექტურობისთვის
დიდი ენობრივი მოდელების (LLM) განლაგება, როგორიცაა Llama 2, კომპლექსური გამოწვევაა. Amazon Web Services-მა ჩაატარა მასშტაბური ბენჩმარკინგი, შეაფასა Llama 2-ის 60-ზე მეტი კონფიგურაცია Amazon SageMaker-ზე, Hugging Face LLM დასკვნის კონტეინერის გამოყენებით. კვლევამ გააანალიზა შეყოვნება და გამტარობა Llama 2-ის სხვადასხვა ზომისა და EC2 ინსტანციების მიხედვით, რათა შეემუშავებინა ოპტიმალური რეკომენდაციები ხარჯთეფექტურობის, მაქსიმალური გამტარობისა და მინიმალური შეყოვნებისთვის. ძირითადი აღმოჩენები მოიცავს

როგორ შევქმნათ მობილური აპლიკაცია LLM მოდელებთან ლოკალური ჩეთისთვის React Native-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა შექმნათ მობილური აპლიკაცია React Native-ის გამოყენებით, რომელიც საშუალებას მოგცემთ ლოკალურად ესაუბროთ დიდ ენობრივ მოდელებს (LLM). ის გვიჩვენებს, როგორ გადმოწეროთ LLM-ები Hugging Face ჰაბიდან და გაუშვათ ისინი უშუალოდ თქვენს მოწყობილობაზე, llama.rn-ის მეშვეობით GGUF ფაილების ეფექტურად ჩატვირთვით. სტატია მოიცავს გარემოს მომზადებას, მოდელების შერჩევას, პროექტის დაყენებას და აპლიკაციის თავდაპირველ კოდირებას, უზრუნველყოფს რა კონფიდენციალურობასა და მარტ
მობილური AI ჩატბოტი: LLM-ების ლოკალურად გაშვება React Native-ით
ეს დეტალური გზამკვლევი აღწერს, თუ როგორ შევქმნათ React Native მობილური აპლიკაცია, რომელიც მომხმარებლებს საშუალებას აძლევს, პირადულ გარემოში, ლოკალურად ესაუბრონ ხელოვნური ინტელექტის დიდ ენობრივ მოდელებს (LLM). სტატია მოიცავს მოდელების შერჩევის კრიტერიუმებს, განვითარების გარემოს კონფიგურაციასა და აპლიკაციის საწყის ეტაპებს, `llama.rn`-ის ეფექტური გამოყენებით GGUF ფაილების ჩასატვირთად Hugging Face Hub-იდან.
შექმენით თქვენი საკუთარი ღია კოდის ChatGPT კოდის დაწერის გარეშე Hugging Face-ის ხელსაწყოებით
ეს გაკვეთილი გვიჩვენებს, თუ როგორ შეიძლება შეიქმნას და განთავსდეს ღია კოდის ChatGPT-ის მსგავსი აპლიკაცია Meta-ს LLaMA 2 მოდელის გამოყენებით, რომელიც დახვეწილია ღია კოდის ინსტრუქციების მონაცემთა ნაკრებით, ყოველგვარი კოდის დაწერის გარეშე. სტატია ხაზს უსვამს Hugging Face-ის ინსტრუმენტების (Spaces, AutoTrain, ChatUI) როლს, რათა მანქანური სწავლება ხელმისაწვდომი გახდეს არატექნიკური მომხმარებლებისთვის, რაც გზას უხსნის ხელოვნური ინტელექტის დემოკრატიზებულ მომავალს.
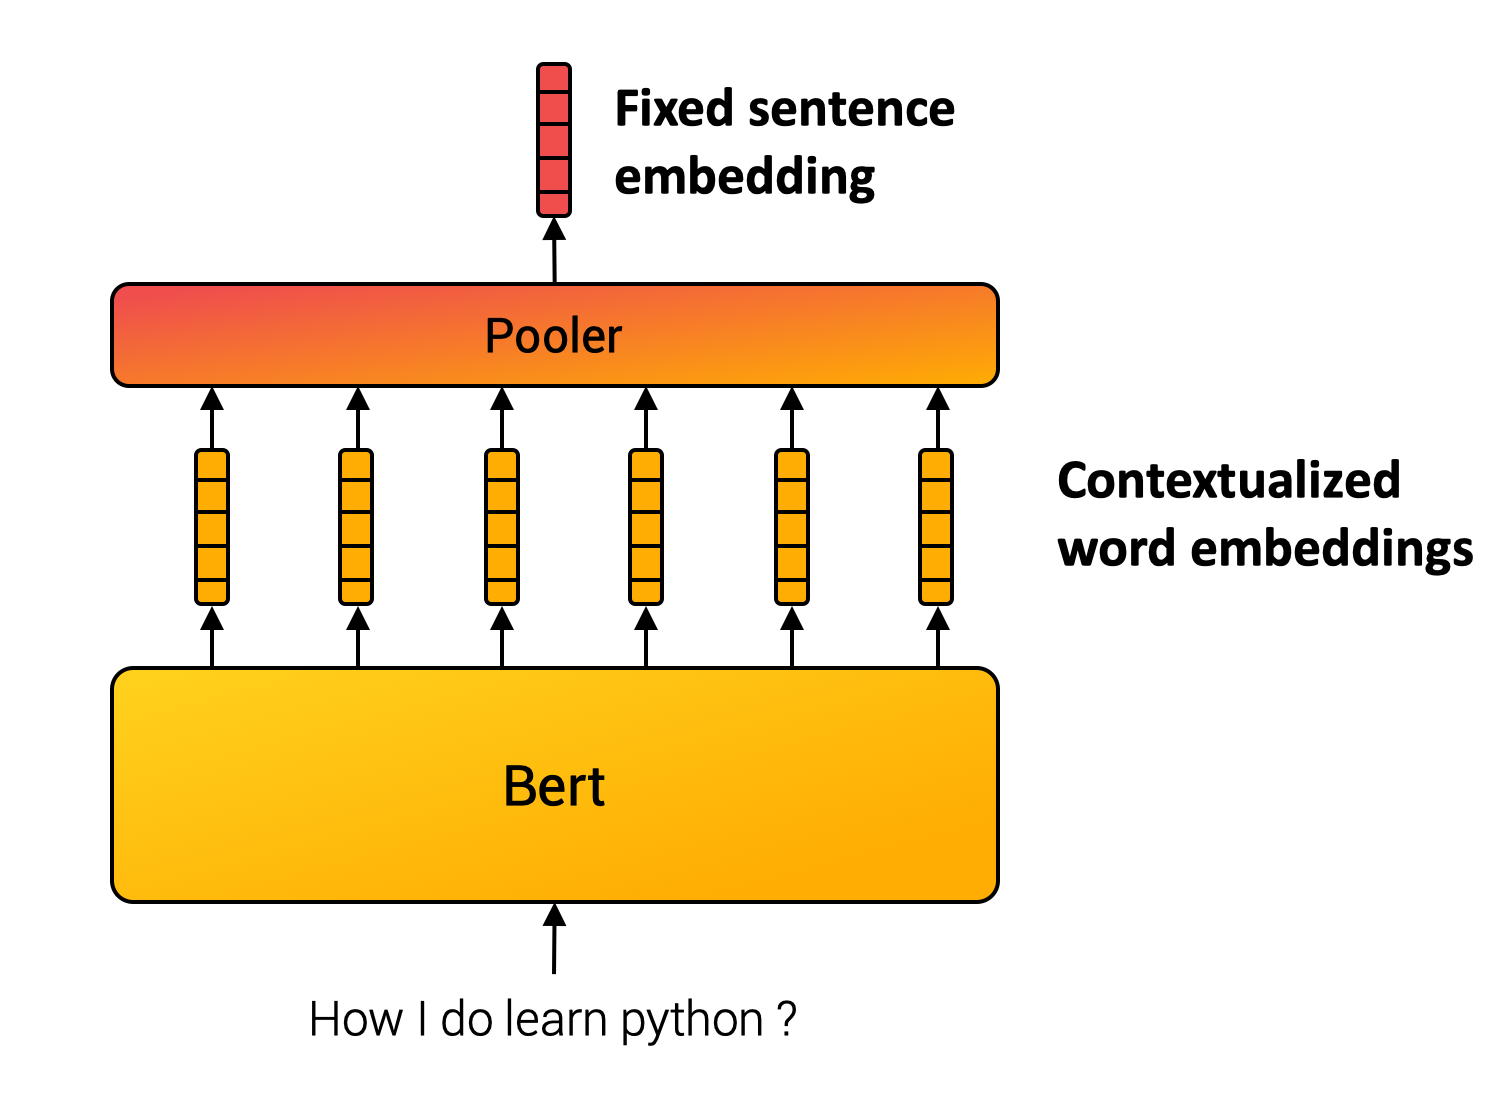
Hugging Face-ის მასშტაბური პროექტი: ხელოვნური ინტელექტის ახალი ეტაპი წინადადებების გაგებაში
Hugging Face-მა, Google-ის JAX/Flax-ის გუნდთან თანამშრომლობით, შეიმუშავა წინადადებების ჩაშენების უახლესი მოდელები პროექტის „Train the Best Sentence Embedding Model Ever with 1B Training Pairs“ ფარგლებში. პროექტი იყენებდა Google-ის 7 TPU v3-8 ერთეულს და ინოვაციურ კონტრასტულ სწავლებას, რათა მსგავსი მნიშვნელობის მქონე წინადადებები ახლო ვექტორებად ასახოს, განსხვავებული მნიშვნელობის მქონე წინადადებები კი – შორეულ ვექტორებად. ეს მიღწევა მნიშვნელოვნად აუმჯობესებს ბუნებრივი ენის დამუშავების (NLP) სისტემ

Hugging Face-ის მუშაობა ხელოვნური ინტელექტის ეთიკაზე: რეგულაციების ფორმირება და ღიაობის ხელშეწყობა
Hugging Face დეტალურად აღწერს თავის ფართომასშტაბიან მუშაობას ხელოვნური ინტელექტის ეთიკის სფეროში, მათ შორის ევროკავშირის, დიდი ბრიტანეთისა და აშშ-ის კანონმდებლებთან თანამშრომლობას მომავალი რეგულაციების ჩამოსაყალიბებლად. კომპანია ხაზს უსვამს ღიაობის, ანგარიშვალდებულებისა და დემოკრატიზაციისადმი თავის ერთგულებას საჯარო გამოსვლებით, კვლევებითა და ახალი რესურსებით, რითაც ხაზგასმულია ადამიანური ღირებულებების ცენტრალური როლი პასუხისმგებლიანი ხელოვნური ინტელექტის განვითარებაში. ასევე აღინიშნება გუნდის მ

Google-მა Gemma 3 წარადგინა: მულტიმოდალური ხელოვნური ინტელექტის მოდელების ახალი თაობა
Google-მა გამოუშვა Gemma 3, Gemma მოდელების ოჯახის ახალი ვერსია. ეს მოდელები, რომელთა პარამეტრების რაოდენობა 1 მილიარდიდან 27 მილიარდამდე მერყეობს, მხარს უჭერს 140-ზე მეტ ენას, შეუძლია როგორც გამოსახულებების, ისე ტექსტის დამუშავება, აქვს 128k ტოკენამდე კონტექსტური ფანჯარა და ინტეგრირებულია Hugging Face-ის ეკოსისტემასთან. Gemma 3-ის მოდელები, განსაკუთრებით Gemma-3-27B-IT, ეტალონურ ტესტებში აჭარბებს Gemma 2-27B IT-სა და Gemini 1.5-Pro-ს, რაც Google-ის ღია წონის დიდი ენობრივი მოდელების უახლეს მიღწე
როგორ განათავსოთ AI Comic Factory თქვენს პირად სივრცეში და თავიდან აიცილოთ ლოდინი
AI Comic Factory, აპლიკაცია, რომელმაც ათასობით მომხმარებელი მოიზიდა საკუთარი AI კომიქსების შესაქმნელად, წარმოუდგენლად პოპულარული გახდა. ეს გაკვეთილი გიჩვენებთ, თუ როგორ უნდა მოახდინოთ მისი კლონირება (fork) და კონფიგურაცია, რათა თავიდან აიცილოთ ხანგრძლივი ლოდინის დრო და განათავსოთ აპლიკაცია თქვენს პირად Hugging Face სივრცეში Inference API-ის გამოყენებით. მართალია, არ არის საჭირო ძლიერი ტექნიკური უნარები, მაგრამ რეკომენდებულია API-ების, გარემოს ცვლადების (environment variables) და LLM-ებისა და Sta

Hugging Face-ის Xet გუნდი: დიდი ნაბიჯი AI მოდელებისა და მონაცემთა საცავების მიგრაციაში
Hugging Face-ის Xet გუნდმა წარმატებით განახორციელა მოდელებისა და მონაცემთა ნაკრებების პირველი საცავების მიგრაცია LFS-დან Xet საცავში. ეს ნაბიჯი, რომელიც Hugging Face-ის Hub-ის ხედვის ნაწილია, მიზნად ისახავს ხელოვნური ინტელექტის დეველოპერებისთვის მასიურ მოდელებსა და მონაცემთა ნაკრებებზე მუშაობის გამარტივებას, უფრო ეფექტურ თანამშრომლობასა და განმეორებითი იტერაციების განხორციელებას. მიგრაციამ Hub-ის ჩამოტვირთვის ტრაფიკის დაახლოებით 6% Xet ინფრასტრუქტურაზე გადაიტანა, რაც ამტკიცებს ახალი სისტემის ეფე
ჩატის მოდელების ეფექტურობის გასაღები: ფორმატის მნიშვნელობა და Jinja შაბლონები
ეს სტატია განმარტავს, თუ რამდენად კრიტიკულია ჩატის ფორმატის შეხამება იმ ფორმატთან, რომელზეც ხელოვნური ინტელექტის მოდელები იყო გაწვრთნილი. არასწორი ფორმატის გამოყენება იწვევს მუშაობის სერიოზულ, ჩუმ გაუარესებას. Hugging Face-ის ტოკენიზატორების ახალი `chat_template` ატრიბუტი, რომელიც Jinja შაბლონებს იყენებს, მიზნად ისახავს ამ პრობლემის გადაჭრას საუბრების სწორად ფორმატირებით, რითაც უზრუნველყოფს მოდელის ოპტიმალურ მუშაობას და ხელს უშლის „განაწილების ცვლილებას“.

ONNX Runtime Hugging Face-ის მოდელების მუშაობას აუმჯობესებს
ONNX Runtime არის კროს-პლატფორმული ინსტრუმენტი, რომელიც აჩქარებს მანქანური სწავლების მოდელებს, განსაკუთრებით ONNX-ის მხარდაჭერით. Hugging Face-ზე, ღია კოდის პლატფორმაზე, 130 000-ზე მეტი ასეთი მოდელია, მათ შორის დიდი ენობრივი (LLM) და ღრუბლოვანი მოდელები, რომლებსაც შეუძლიათ მნიშვნელოვნად გააუმჯობესონ მუშაობა ONNX Runtime-ის მეშვეობით. მაგალითად, whisper-tiny მოდელის დაჩქარება PyTorch-თან შედარებით 74.30%-მდე ეფექტურობას იძლევა. ONNX Runtime მჭიდროდ თანამშრომლობს Hugging Face-თან 90-ზე მეტი არქიტე