Meta AI-ის რევოლუციური MMS მოდელი: 1100-ზე მეტი ენის მხარდაჭერა და გადაშენების პირას მყოფი ენების შენარჩუნება
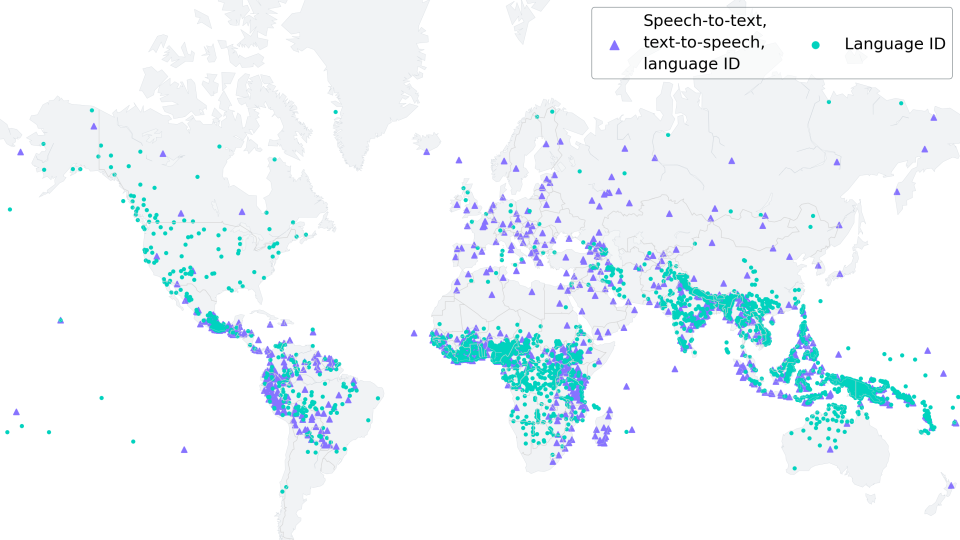
Meta AI-მ წარმოადგინა Massive Multilingual Speech (MMS) მოდელი, რომელსაც შეუძლია 1100-ზე მეტი ენის ამოცნობა, ტრანსკრიფცია და გენერაცია. ეს ინოვაციური სისტემა, რომელიც იყენებს „ადაპტერის“ წვრთნის მეთოდს, მნიშვნელოვნად ამცირებს შეცდომის მაჩვენებელს მცირე რესურსების მქონე ენებისთვის და ხელს უწყობს გადაშენების პირას მყოფი ენების შენარჩუნებას, რადგან მათთვის წერილობითი ჩანაწერების შექმნასა და მშობლიურ ენაზე კომუნიკაციას უწყობს ხელს. MMS-ის ადაპტერის წვრთნა უფრო ეფექტურია მეხსიერების თვალსაზრისით, უფრ
Habana Gaudi2-ის რეკორდული სისწრაფე BridgeTower-ის დახვეწისას: A100-ზე 2.5-ჯერ, H100-ზე 1.4-ჯერ სწრაფი
უახლესი კვლევის მიხედვით, Habana Gaudi2-ზე Optimum Habana v1.7-ის გამოყენებით, შესაძლებელია BridgeTower ხედვა-ენის მოდელის დახვეწის პროცესის მნიშვნელოვნად დაჩქარება. ეს მიღწევა, რომელიც A100-თან შედარებით 2.5-ჯერ, ხოლო H100-თან შედარებით 1.4-ჯერ ზრდის სისწრაფეს, ეფუძნება აპარატურულად აჩქარებულ მონაცემთა ჩატვირთვას. ეს ტექნიკები ნებისმიერ სხვა სამუშაო დატვირთვასაც ესადაგება, სადაც მონაცემთა ჩატვირთვა წარმოადგენს შეფერხებას, რაც ხედვის მოდელებისთვის ხშირია.
AI ვებ-კონტენტის გენერაცია: Node.js და Hugging Face-ის პირდაპირი მიდგომა
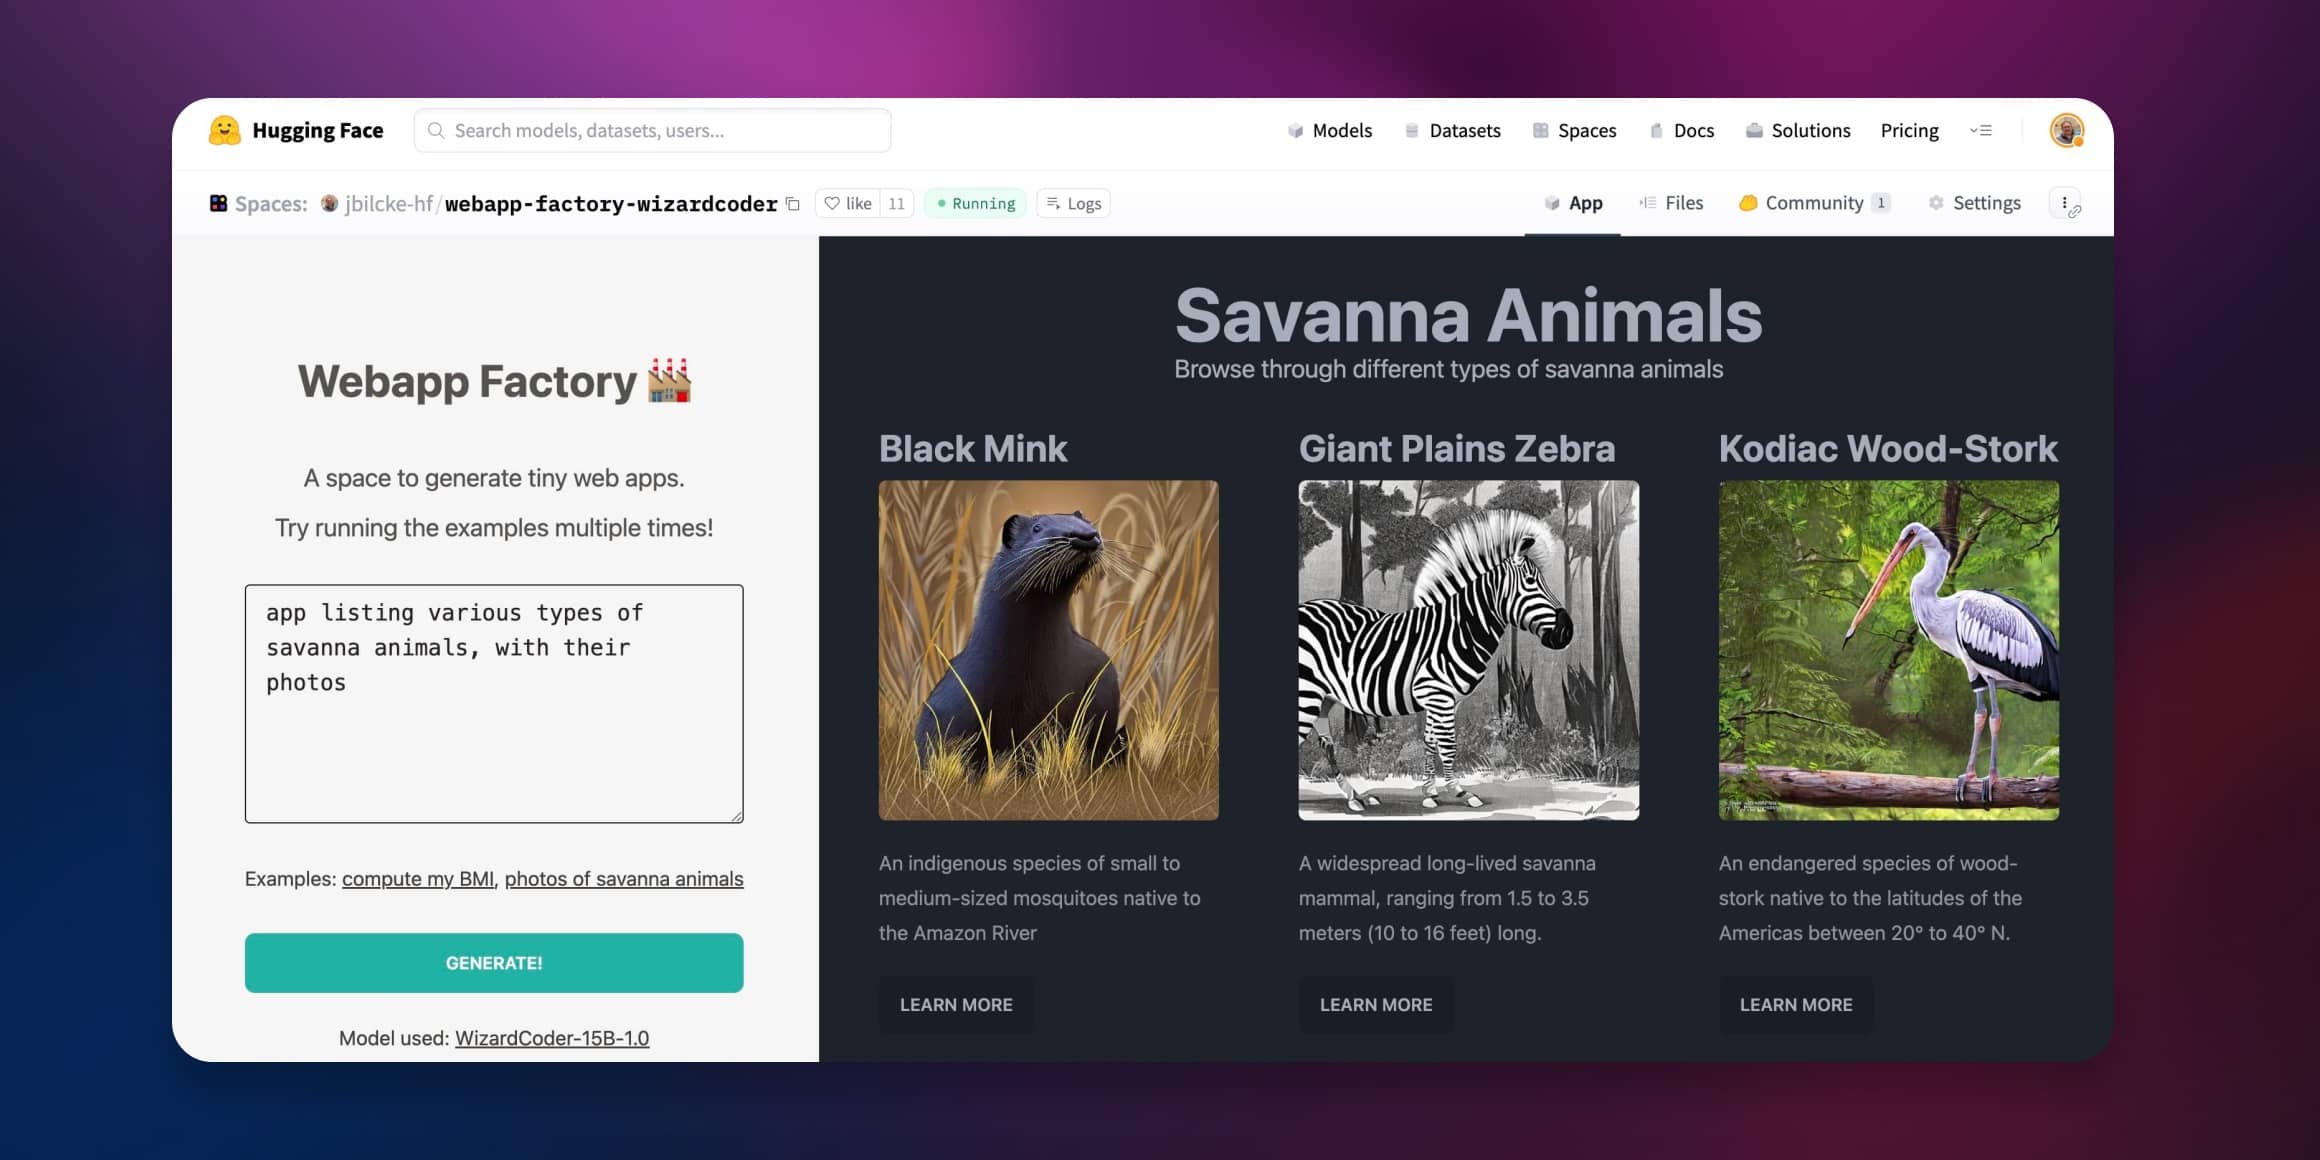
გაეცანით AI ვებ-კონტენტის გენერაციის ინოვაციურ მიდგომას Node.js-ის გამოყენებით, რომელიც უზრუნველყოფს კონტენტის ერთბაშად ნაკადად გადაცემასა და რენდერინგს. ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ დიდი ენობრივი მოდელები (LLM) JavaScript/Node პლატფორმაზე Hugging Face Inference API-ებთან ერთად, აპარატურული აჩქარების, Tailwind CSS-ის, Stable Diffusion-ისა და Alpine.js-ის ინტეგრაციის ჩათვლით.

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერების გამოყენებას PyTorch-ში
ეს სტატია დეტალურად განიხილავს, თუ როგორ უნდა მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია, გაგება და ოპტიმიზაცია PyTorch-ში ტრენინგის დროს. ის ეტაპობრივად ხსნის მეხსიერების განაწილებას მოდელის შექმნის, შეყვანის ტენზორების, Forward/Backward გავლისა და ოპტიმიზატორის ნაბიჯებისთვის, დეტალური მაგალითებისა და პროფაილინგის ხელსაწყოების გამოყენებით. გაანალიზებულია როგორც გამარტივებული, ასევე რეალური LLM-ის ტრენინგის მეხსიერების პროფილი.
როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერებას PyTorch-ში
ეს გაკვეთილი ეტაპობრივად განმარტავს, თუ როგორ მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია და გაგება PyTorch-ში ტრენინგის დროს. ის მოიცავს მეხსიერების მოთხოვნების შეფასებას, გამოყენების ოპტიმიზაციას PyTorch-ის პროფილის ხელსაწყოების მეშვეობით და დეტალურ ანალიზს იმის შესახებ, თუ როგორ იქცევა მეხსიერება მოდელის შექმნის, წინსვლის, უკუგადაცემის და ოპტიმიზატორის ნაბიჯების განმავლობაში, მათ შორის დიდი ენობრივი მოდელების (LLM) რეალურ სცენარებში.
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.
როგორ შევქმნათ AI-ზე დაფუძნებული ხატვის თამაში ბრაუზერში: Quick, Draw!-ის შთაგონებით
გაეცანით დეტალურ სახელმძღვანელოს, თუ როგორ უნდა შექმნათ ხელოვნური ინტელექტზე დაფუძნებული ხატვის თამაში, რომელიც Google-ის „Quick, Draw!“-ით არის შთაგონებული. პროექტი გვიჩვენებს, როგორ მივაღწიოთ რეალურ დროში, წამში 60-ზე მეტ პროგნოზს, მოდელის ბრაუზერში გაშვებით, Transformers.js-ის, MobileViT მოდელისა და Web Workers-ის გამოყენებით. სტატია მოიცავს მოდელის მომზადებას, ONNX-ში კონვერტაციას და React აპლიკაციის აგებას.

LLM-ების ინფერენციისას ნახშირბადის ემისიების კვლევა: მოულოდნელი აღმოჩენები საზოგადოების მიერ შექმნილ მოდელებში
ბოლო წლებში დიდი ენობრივი მოდელების (LLM) გამოყენების გარემოზე ზემოქმედებაზე ცნობიერება იზრდება. ეს სტატია იკვლევს LLM-ების ინფერენციის ფაზაში ნახშირბადის ემისიებს, წარმოადგენს Open LLM Leaderboard-ში ემისიის შეფასებების ინტეგრაციას და მოულოდნელ აღმოჩენებს, მაგალითად, რომ საზოგადოების მიერ მორგებული მოდელები (community fine-tunes) ხშირად უფრო ნახშირბადეფექტურია, ვიდრე ოფიციალური მოდელები. განხილულია ემისიების ცვლილებები სხვადასხვა მოდელის ტიპისა და ზომის მიხედვით, რაც მიზნად ისახავს მომხმარებლებ
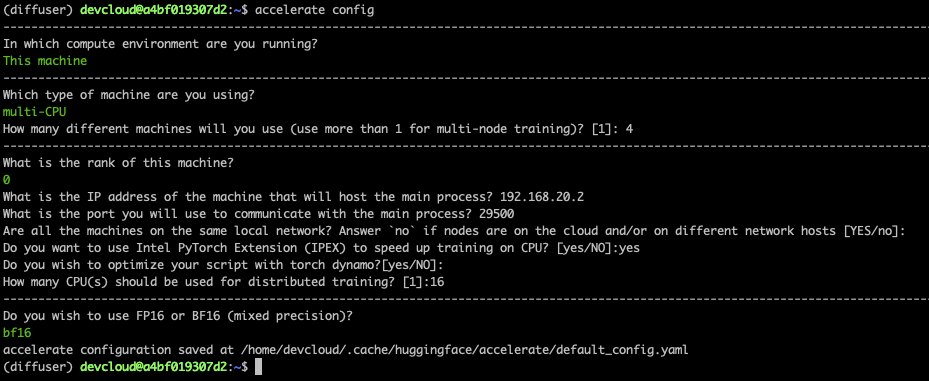
Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ
vdr-2b-multi-v1: მრავალენოვანი ჩაშენების მოდელი ვიზუალური დოკუმენტების ეფექტური მოძიებისთვის
Hugging Face-ის მიერ წარდგენილია vdr-2b-multi-v1, მრავალენოვანი ჩაშენების მოდელი, რომელიც განკუთვნილია ვიზუალური დოკუმენტების მოძიებისთვის სხვადასხვა ენასა და დომენში. ეს მოდელი აკოდირებს დოკუმენტის გვერდის სქრინშოტებს მკვრივ ერთვექტორულ წარმოდგენებად, რაც შესაძლებელს ხდის ვიზუალურად მდიდარი მრავალენოვანი დოკუმენტების ძიებას და მოთხოვნას OCR-ის, მონაცემთა ამოღების კონვეიერების ან დანაწილების გარეშე. იგი აგებულია MrLight/dse-qwen2-2b-mrl-v1-ზე და გაწვრთნილია ვრცელ, თვითშექმნილ მონაცემთა ბაზაზე. L

ახალი მეთოდი სტატიკური ემბედინგის მოდელების საწვრთნელად: 100-400-ჯერ უფრო სწრაფი CPU-ზე
ეს ბლოგპოსტი წარმოგიდგენთ მეთოდს სტატიკური ემბედინგის მოდელების საწვრთნელად, რომლებიც CPU-ზე 100-400-ჯერ უფრო სწრაფად მუშაობენ, ვიდრე უახლესი მოდელები, ხარისხის უმეტესი ნაწილის შენარჩუნებით. ეს ხსნის უამრავ საინტერესო გამოყენების შესაძლებლობას, მათ შორის მოწყობილობაზე და ბრაუზერში გაშვებას, Edge Computing-ს, დაბალენერგეტიკულ და ჩაშენებულ აპლიკაციებს. ჩვენ გამოვიყენეთ ეს მიდგომა ორი უკიდურესად ეფექტური ემბედინგის მოდელის მოსამზადებლად: sentence-transformers/static-retrieval-mrl-en-v1 ინგლისური ინ
Meta-მ Llama 2 გამოუშვა: ღია წვდომის დიდი ენობრივი მოდელი კომერციული გამოყენებისთვის, Hugging Face-ის ინტეგრაციით
Meta-მ წარმოადგინა Llama 2, თანამედროვე, ღია წვდომის დიდი ენობრივი მოდელების ოჯახი, რომელიც 7B-დან 70B პარამეტრამდე მერყეობს და ხელმისაწვდომია კომერციული გამოყენებისთვის. Hugging Face სრულად უჭერს მხარს გამოშვებას ყოვლისმომცველი ინტეგრაციით, რაც დეველოპერებს საშუალებას აძლევს მარტივად გამოიყენონ, გაუშვან ინფერენცია და დახვეწონ მოდელები. Llama 2-Chat ვერსიები, რომლებიც ოპტიმიზებულია დიალოგისთვის, ChatGPT-ის მსგავს შესრულებას აჩვენებს სარგებლიანობისა და უსაფრთხოების ბენჩმარკებზე.
Hugging Face და FriendliAI AI მოდელების განთავსების გასაუმჯობესებლად პარტნიორობენ
Hugging Face და FriendliAI აცხადებენ სტრატეგიული პარტნიორობის შესახებ, რომელიც მიზნად ისახავს დეველოპერებისთვის AI მოდელების განთავსებისა და მართვის პროცესის გამარტივებას. ინტეგრაცია FriendliAI Endpoints-ს Hugging Face Hub-ში აერთიანებს, რაც უზრუნველყოფს მაღალეფექტურ, ეკონომიურ ინფერენციის ინფრასტრუქტურას. ეს ნაბიჯი AI ინოვაციებს უფრო ხელმისაწვდომსა და ეფექტურს გახდის მსოფლიოს მასშტაბით, ოპტიმიზებული GPU გამოყენებით და ინფრასტრუქტურის მართვის სირთულეების შემცირებით.
smolagents: ვიზუალური მხარდაჭერა და აგენტური ბრაუზერი
ჩვენ smolagents-ს დავუმატეთ ვიზუალური მხარდაჭერა, რაც ხსნის ვიზუალური ენობრივი მოდელების (VLM) გამოყენების შესაძლებლობას აგენტურ პაიპლაინებში მშობლიური ინტეგრაციით. ეს სიახლე მნიშვნელოვნად აუმჯობესებს ისეთ შესაძლებლობებს, როგორიცაა ვებ-დათვალიერება, სადაც ვიზუალური კონტენტი სრულად ვერ აღდგება მხოლოდ ტექსტის ამოღებით. ეს განახლება აგენტებს ნამდვილ სუპერძალას ანიჭებს, რის შედეგადაც მათ შეუძლიათ, მაგალითად, სრულ ავტონომიაში იმოძრაონ ვებ-სივრცეში.
როგორ შევქმნათ PS1-ის სტილის 3D აქტივები გენერაციული ხელოვნური ინტელექტის გამოყენებით
ეს სტატია გთავაზობთ პრაქტიკულ სახელმძღვანელოს, თუ როგორ უნდა მოხდეს გენერაციული ხელოვნური ინტელექტის ინტეგრირება PlayStation 1-ის სტილის 3D აქტივების შექმნაში თამაშებისთვის. ის განმარტავს, თუ რატომ არის ეს სტილი იდეალური არსებული text-to-3D მოდელების დაბალი ხარისხისთვის და გვიჩვენებს ნაბიჯ-ნაბიჯ პროცესს Shap-E-სა და Blender-ის (Dream Textures-თან ერთად) გამოყენებით, ტექსტიდან გამოსაყენებელი დაბალხარისხოვანი 3D მოდელის მისაღებად. სტატია ხაზს უსვამს ამ მეთოდის პოტენციალს უსასრულო დაბალხარისხოვანი

ხელოვნური ინტელექტის ვიდეო გენერაციის მოდელები: მიმდინარე მდგომარეობა და ოპტიმიზაციის გზები
ღია კოდის პროექტებში ვიდეოს გენერაციის მოდელების სწრაფი განვითარება შეინიშნება, რამაც შეიძლება გამოიწვიოს „Stable Diffusion მომენტის“ განმეორება ვიდეო საზოგადოებაში. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, მათ შეზღუდვებს (კერძოდ, მოძრაობის ხარისხს, თანმიმდევრულობასა და კონსისტენტურობას დროის განმავლობაში) და არქიტექტურულ თავისებურებებს, როგორიცაა 3D ვიდეო ტოკენების დამუშავება. ყურადღება ექცევა Diffusers-ის გუნდის მიერ შემოთავაზებულ მეხსიერების ოპტიმიზაციის ტექნი
ენკოდერ-დეკოდერ მოდელების ეფექტური წვრთნა: წინასწარ გაწვრთნილი კომპონენტების გამოყენების უპირატესობები
ახალი კვლევა გვთავაზობს ენკოდერ-დეკოდერ მოდელების წვრთნის ინოვაციურ მეთოდს, რომელიც მნიშვნელოვნად ამცირებს გამოთვლით ხარჯებს. BERT-ისა და GPT2-ის მსგავსი წინასწარ გაწვრთნილი ენკოდერის ან/და დეკოდერის კომპონენტების გამოყენებით, შესაძლებელია მაღალხარისხიანი შედეგების მიღწევა თანმიმდევრობა-თანმიმდევრობაზე ამოცანებში, როგორიცაა ტექსტის შეჯამება და მანქანური თარგმანი, სრული წინასწარი წვრთნის გარეშე. ეს მიდგომა ხელს უწყობს ხელოვნური ინტელექტის განვითარებას მცირე რესურსების მქონე გუნდებისთვისაც.
LLM-ების კონფიდენციალურობისა და ინტელექტუალური საკუთრების დაცვა: Zama-ს გადაწყვეტა ჰომომორფული დაშიფვრით
დიდი ენობრივი მოდელების (LLM) ფართო გამოყენების მიუხედავად, მომხმარებლის მონაცემთა კონფიდენციალურობის საკითხი კვლავ გადაუჭრელ პრობლემად რჩება, რადგან არსებობს სენსიტიური ინფორმაციის LLM სერვისის მიმწოდებელთან გაჟონვის რისკი. Zama გვთავაზობს ინოვაციურ გადაწყვეტას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით, რომელიც საშუალებას აძლევს LLM-ებს, იმუშაონ დაშიფრულ მონაცემებზე. ეს მეთოდი იცავს როგორც მომხმარებლის კონფიდენციალურობას, ასევე მოდელის ინტელექტუალურ საკუთრებას, პროგნოზების ხარისხის შენარჩუ
100-ჯერ გაზრდილი წარმადობა: დიდი AI მოდელების ოპტიმიზაცია Hugging Face-ის ინფრასტრუქტურაზე
მიუხედავად იმისა, რომ დიდი ენობრივი მოდელების ექსპერიმენტირება მარტივია, მათი მაქსიმალური წარმადობით პროდუქციაში განთავსება რთული საინჟინრო გამოწვევაა. Hugging Face გთავაზობთ გადაწყვეტას თავისი Accelerated Inference API-ის მეშვეობით, რომელიც უზრუნველყოფს 100-ჯერ გაზრდილ სიჩქარეს და მასშტაბირებადობას. სტატია დეტალურად აღწერს ოპტიმიზაციის სხვადასხვა დონეს – ბიბლიოთეკების გამოყენებიდან აპარატურის სპეციფიკურ მოდიფიკაციამდე – და ხაზს უსვამს Hugging Face-ის ექსპერტიზასა და პარტნიორობებს ტექნიკის წამყვ
Hugging Face Hub-ის მონაცემთა ნაკრებების მეტამონაცემების გაუმჯობესება მანქანური სწავლების საშუალებით
Hugging Face Hub, როგორც მანქანური სწავლების რესურსების ცენტრალური საცავი, აუმჯობესებს მონაცემთა ნაკრებების მეტამონაცემებს ხელოვნური ინტელექტის გამოყენებით. ახალი ინიციატივის ფარგლებში, მანქანური სწავლების ალგორითმები ამოიცნობენ ენას იმ მონაცემთა ნაკრებებში, რომლებსაც არ აქვთ ენის მეტამონაცემები, ხოლო ავტომატიზებული „ბიბლიოთეკარი-ბოტები“ ამ ინფორმაციას მეტამონაცემებში დაამატებენ. ეს პროექტი მიზნად ისახავს რესურსების მოძიების გაადვილებას და Hub-ზე წარმოდგენილი ენობრივი მიკერძოებების უკეთ გაგებას.
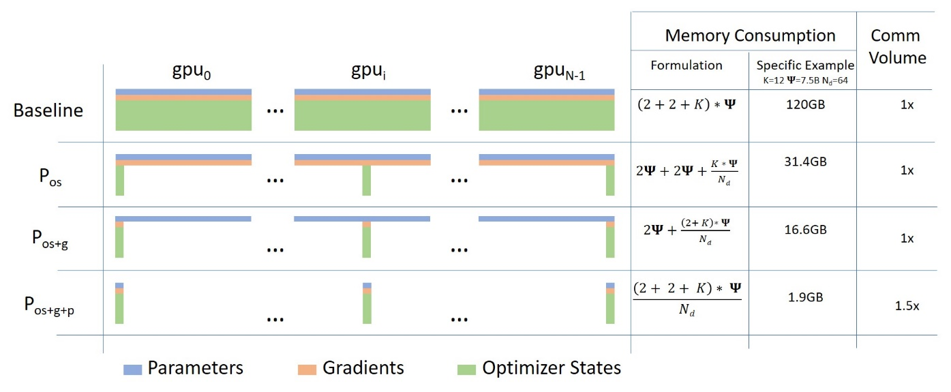
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.
მოდელების განთავსება ინფერენსის ენდპოინტებზე ქასთომ ჰენდლერების გამოყენებით: MusicGen-ის მაგალითი
ეს სტატია განმარტავს, თუ როგორ ხდება მოდელების, მათ შორის `transformers`-ის კონვეიერით პირდაპირ არმხარდაჭერილი ან არატრანსფორმერული მოდელების განთავსება Inference Endpoints-ის გამოყენებით. პროცესი მოიცავს მორგებული დასკვნის ფუნქციების, იგივე ქასთომ ჰენდლერების შექმნას, რათა შესაძლებელი გახდეს მოქნილი განთავსება. MusicGen-ის მაგალითზე დეტალურად არის აღწერილი `handler.py` და `requirements.txt` ფაილების შექმნა და ენდპოინტის კონფიგურაცია.

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ
BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან