LLM-ების ინტეგრაცია Swift აპლიკაციებში Core ML-ის გამოყენებით: დეველოპერების სახელმძღვანელო
მანქანური სწავლება (ML) პროგრამული უზრუნველყოფის შექმნის ახალ გზებს ხსნის, განსაკუთრებით Swift დეველოპერებისთვის, რომლებსაც სურთ ხელოვნური ინტელექტის ფუნქციების ინტეგრირება თავიანთ აპლიკაციებში. ეს სტატია წარმოგიდგენთ Core ML-ზე დაფუძნებულ ინსტრუმენტებსა და დეტალურ სახელმძღვანელოს, თუ როგორ უნდა გაუშვათ დიდი ენობრივი მოდელები (LLM), როგორიცაა Llama 2, Mac-ზე. პროექტი მოუწოდებს დეველოპერებს, შეერთდნენ და წვლილი შეიტანონ ამ ინიციატივის ერთობლივ გაუმჯობესებაში, რათა დააჩქარონ ხელოვნური ინტელექტის შ

ხელოვნური ინტელექტი ხელოვნებაში: ღია კოდის მოდელების გარდამტეხი წელი (2024-ის მიღწევები და 2025-ის მოლოდინები)
ბოლო რამდენიმე წელი, განსაკუთრებით კი 2024, გარდამტეხი აღმოჩნდა ხელოვნური ინტელექტის (AI) ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნებითი გამოყენების კუთხით. ამ მიმოხილვაში განვიხილავთ 2024 წლის მთავარ მიღწევებს, როგორიცაა DiT არქიტექტურის და Flux.1-ის გამოჩენა, პერსონალიზაციის ტექნიკების გაუმჯობესება და „ნულოვანი ოპტიმიზაციის“ მეთოდების აღმასვლა გამოსახულების გენერაციაში. სტატია ასევე მიმოიხილავს ვიდეოს გენერაციის სფეროში არსებულ გამოწვევებს და 2025 წლის მოლოდინებს, რომელიც AI და ხელოვნე
პირდაპირი უპირატესობის ოპტიმიზაცია (DPO) LLM-ების დახვეწას ამარტივებს
ეს სტატია წარმოგიდგენთ პირდაპირი უპირატესობის ოპტიმიზაციის (DPO) მეთოდს, რომელიც მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესს. ტრადიციული გაძლიერებითი სწავლისგან ადამიანის უკუკავშირით (RLHF) განსხვავებით, DPO გამორიცხავს ჯილდოს მოდელის შექმნის კომპლექსურ საფეხურს და RL ოპტიმიზაციას, პირდაპირ ახდენს ენობრივი მოდელის ოპტიმიზაციას უპირატესობის მონაცემებზე, ბინარული კროს-ენტროპიის დანაკარგის გამოყენებით. ეს მიდგომა ვარჯიშს უფრო ეფექტურს და ნაკლებად პრობლემურს ხდის, რაც შეს

Deepseek R1-ის 'აჰა მომენტი' და მისი ხელახლა შექმნა GRPO-სა და Countdown თამაშის მეშვეობით
Deepseek R1-ის გამოშვებამ ინდუსტრია შეძრა, რადგან ის არის ღია მოდელი, რომელიც OpenAI-ის o1-ს ეჯიბრება კომპლექსური მსჯელობის ამოცანებში. მოდელი გამოირჩევა „აჰა მომენტით“ – თვითვერიფიკაციის უნარით ადამიანური ჩარევის გარეშე. ეს ბლოგ პოსტი მიზნად ისახავს ამ უნიკალური ქცევის ხელახლა შექმნას Group Relative Policy Optimization (GRPO) და Countdown თამაშის გამოყენებით, დისტრიბუციულ ტრენინგზე ფოკუსირებით Deepspeed-ისა და vLLM-ის მეშვეობით.
RAG მოდელების გაუმჯობესება: Ray-ის ინტეგრაცია სწრაფი განაწილებული დახვეწისთვის
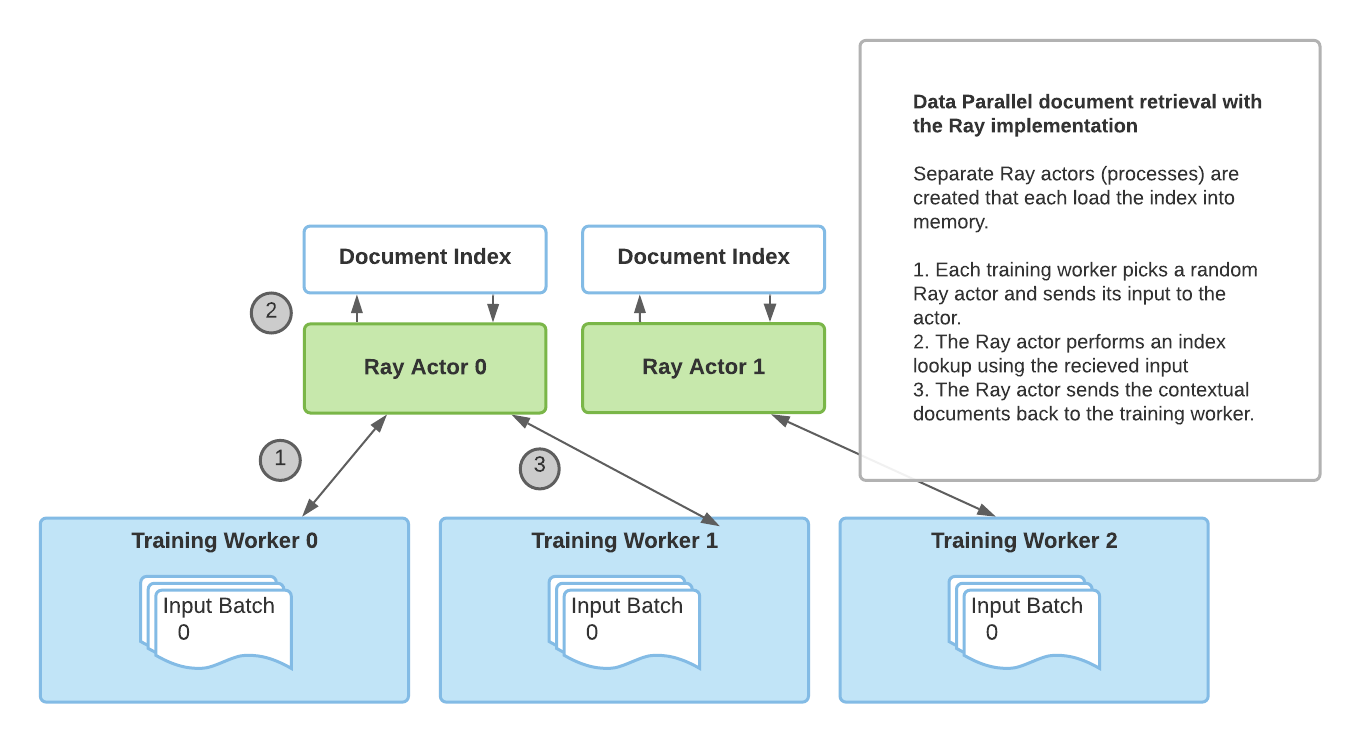
სტატია მიმოიხილავს RAG (Retrieval Augmented Generation) მოდელებს, რომლებიც კონტექსტურ დოკუმენტებს გარე წყაროებიდან იძიებენ შედეგების გენერაციისთვის. ის ხაზს უსვამს დოკუმენტების მოძიების პროცესის სირთულესა და მასშტაბირებადობის გამოწვევებს `torch.distributed` იმპლემენტაციის დროს. წარმოდგენილია Ray-ზე დაფუძნებული ახალი გადაწყვეტა, რომელიც მნიშვნელოვნად აუმჯობესებს მოძიების სიჩქარესა და RAG მოდელების დახვეწის მასშტაბირებადობას Huggingface Transformers ბიბლიოთეკაში. აღწერილია Ray-ის გამოყენების უპირა
RAG მოდელების გაძლიერება Ray-ის საშუალებით: განაწილებული ინფორმაციის მოძიების სიჩქარის გაორმაგება
სტატია განიხილავს RAG (Retrieval Augmented Generation) მოდელების მუშაობის პრინციპებს, რომლებიც კონტექსტური დოკუმენტების მოძიებით აუმჯობესებენ გენერაციის ხარისხს. წარმოდგენილია წინა იმპლემენტაციის (torch.distributed) შეზღუდვები და შემოთავაზებულია ახალი, გაუმჯობესებული მიდგომა Ray ბიბლიოთეკის გამოყენებით. Ray-ზე დაფუძნებული განაწილებული მოძიების იმპლემენტაცია არა მხოლოდ 2-ჯერ ზრდის მოძიების სიჩქარეს, არამედ აუმჯობესებს მოდელების დაზუსტებული კონფიგურაციის (fine-tuning) მასშტაბირებადობას და ხსნის Py
ნერვული ქსელების აგება და გამართვა: ჰაიპის მიღმა
სტატია მიმოიხილავს ნერვული ქსელების, მათ შორის GPT-3-ის, ირგვლივ არსებულ დიდ აჟიოტაჟს და უპირისპირებს მას ამ ტექნოლოგიების რეალურ შექმნასა და გამართვასთან დაკავშირებულ სირთულეებს. ავტორი გვთავაზობს პრაქტიკულ, სისტემატურ მიდგომას ნერვული ქსელების დიზაინისა და დებაგინგისთვის, ხაზს უსვამს მონაცემთა სიღრმისეული ანალიზის, მარტივი ბაზისური მოდელების გამოყენებისა და დეტალური ტესტირების მნიშვნელობას, განსაკუთრებით Hugging Face-ში მუშაობის გამოცდილებიდან გამომდინარე.
Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.

Physical Intelligence-ი წარმოგიდგენთ π0-ს და π0-FAST-ს: რობოტების მრავალმხრივი კონტროლისთვის
კომპანია Physical Intelligence-მა შექმნა π0 და π0-FAST – პროტოტიპული გენერალისტი რობოტ მოდელები, რომლებიც მიზნად ისახავს ხელოვნურ ინტელექტსა და ფიზიკურ სამყაროს შორის არსებული უფსკრულის ამოვსებას. ეს ხედვა-ენა-მოქმედების (VLA) მოდელები, რომლებიც გაწვრთნილია მრავალფეროვან რობოტულ მონაცემებზე, გამოირჩევიან მრავალმხრივი კონტროლით სხვადასხვა ამოცანასა და რობოტის ტიპებზე, ნაკადის შესაბამისობის (flow matching) მეთოდის გამოყენებით ეფექტური, რეალურ დროში მოქმედების გენერაციისთვის. ისინი სძლევენ ტრადიციუ
Wav2Vec2: ახალი ეპოქა მეტყველების ავტომატურ ამოცნობაში
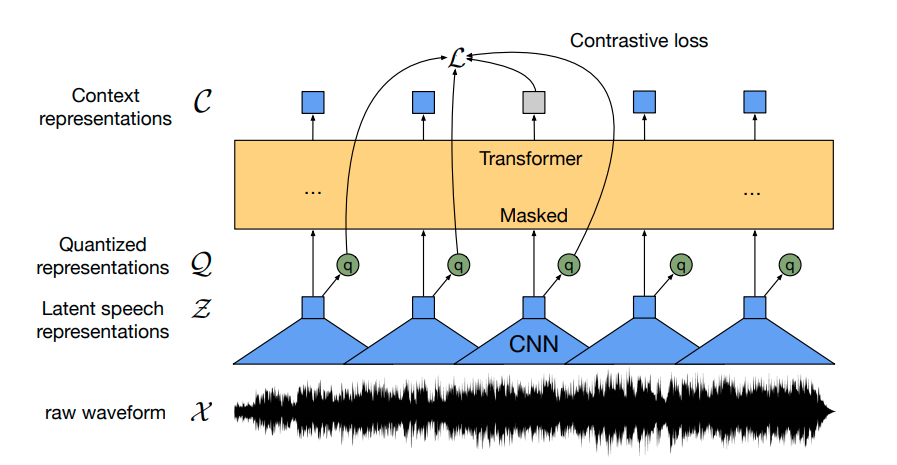
Wav2Vec2 წარმოადგენს ინოვაციურ მოდელს, რომელიც იყენებს კონტრასტულ წინასწარ წვრთნას 50 000 საათზე მეტი არადანიშნული მეტყველების მონაცემებიდან მძლავრი წარმოდგენების შესასწავლად. BERT-ის მსგავსად, ის ნიღბავს ფუნქციის ვექტორებს კონტექსტუალიზებული წარმოდგენების მისაღებად. მოდელმა აჩვენა კონკურენტული შედეგები თანამედროვე ავტომატური მეტყველების ამოცნობის (ASR) სისტემებთან, მინიმალური, სულ რაღაც 10 წუთის, დანიშნულ მონაცემებზე დამატებითი წვრთნის შემდეგ. ეს სტატია დეტალურად განმარტავს Wav2Vec2-ის წინასწარ
Wav2Vec2: გარღვევა მეტყველების ამოცნობაში მინიმალური მარკირებული მონაცემებით
Wav2Vec2, რევოლუციური ხელოვნური ინტელექტის მოდელი, სწავლობს მეტყველების მძლავრ წარმოდგენებს დიდი მოცულობის არამარკირებული აუდიო მონაცემებიდან, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მეთოდის გამოყენებით. მან აჩვენა უპრეცედენტო შედეგები ავტომატური მეტყველების ამოცნობის (ASR) სფეროში, მიაღწია უმაღლეს დონეს მაშინაც კი, როდესაც დამატებითი ვარჯიში (fine-tuning) ხდება სულ რაღაც 10 წუთის მარკირებულ მეტყველების მონაცემებზე. ეს მას ქმნის მაღალეფექტურ გადაწყვეტილებად ძლიერი ASR სისტემების შესაქმნელად, რ
მომხმარებელთა შეფასებების სენტიმენტური ანალიზის მიკროსერვისის შექმნა Google Cloud-ზე
სტატია აღწერს მიკროსერვისის შექმნის პროცესს, რომელიც Discord-ში დატოვებულ მომხმარებელთა შეფასებებს ავტომატურად აანალიზებს და მათ პოზიტიურ ან ნეგატიურ შინაარსს განსაზღვრავს. ავტორი განიხილავს საწყის სირთულეებს მოდელის ჩატვირთვისა (როგორიცაა .h5 ფაილის ტიპის გაგება) და შესაბამისი ღრუბლოვანი პლატფორმის შერჩევისას (AI-Platform Prediction, App Engine, Cloud Run). საბოლოოდ, წარმოადგენს Cloud Run-სა და PyTorch-ზე დაფუძნებულ, Docker-ის გამოყენებით განხორციელებულ გადაწყვეტას, რომელიც ოპტიმიზირებულია მეხს
Hugging Face-ისა და Amazon-ის სტრატეგიული პარტნიორობა: უახლესი ML მოდელების გამოყენების გამარტივება SageMaker-ში
Hugging Face-მა და Amazon-მა სტრატეგიული პარტნიორობა გამოაცხადეს, რათა კომპანიებისთვის უახლესი მანქანური სწავლების (ML) მოდელების გამოყენება და NLP ფუნქციების სწრაფად დანერგვა გაამარტივონ. Hugging Face Amazon Web Services-ს (AWS) სასურველ ღრუბლოვან პროვაიდერად ირჩევს. ამ თანამშრომლობის პირველი ნაბიჯი Hugging Face-ის ახალი ღრმა სწავლების კონტეინერების (DLCs) შეთავაზებაა, რაც Amazon SageMaker-ში Transformer მოდელების გაწვრთნას უპრეცედენტოდ ამარტივებს.
Hugging Face და Amazon სტრატეგიულ პარტნიორობას აცხადებენ ხელოვნური ინტელექტისა და NLP განვითარების დასაჩქარებლად
Hugging Face-მა და Amazon-მა სტრატეგიული პარტნიორობის შესახებ განაცხადეს, რომლის მიზანია კომპანიებისთვის უახლესი მანქანური სწავლის მოდელების გამოყენების გამარტივება და მოწინავე ბუნებრივი ენის დამუშავების (NLP) ფუნქციების უფრო სწრაფად მიწოდება. პარტნიორობის ფარგლებში, Hugging Face იყენებს Amazon Web Services-ს (AWS) როგორც სასურველ ღრუბლოვან პროვაიდერს. თანამშრომლობის პირველი ნაბიჯი არის Hugging Face-ის ახალი ღრმა სწავლის კონტეინერების (DLCs) წარდგენა, რაც მნიშვნელოვნად გაამარტივებს Transformer მ
Hugging Face-მა AutoGPTQ ინტეგრირება მოახდინა Transformers-ში: ხელმისაწვდომი დიდი ენობრივი მოდელები
Hugging Face-მა თავის Transformers ბიბლიოთეკაში AutoGPTQ-ის ინტეგრირებით, დიდი მანქანური სწავლის მოდელების ხელმისაწვდომობა მნიშვნელოვნად გაზარდა. ეს მომხმარებლებს საშუალებას აძლევს, მოდელების 8-დან 2-ბიტამდე სიზუსტით კვანტიზაცია და გაშვება შეძლონ GPTQ ალგორითმის გამოყენებით, მინიმალური სიზუსტის დაკარგვით და გაუმჯობესებული წარმადობით. ინტეგრაცია ხელმისაწვდომია როგორც Nvidia, ასევე RoCm-ზე მომუშავე AMD GPU-ებისთვის, რაც LLM-ების ოპტიმიზაციას უფრო ფართო აუდიტორიისთვის ხდის შესაძლებელს.
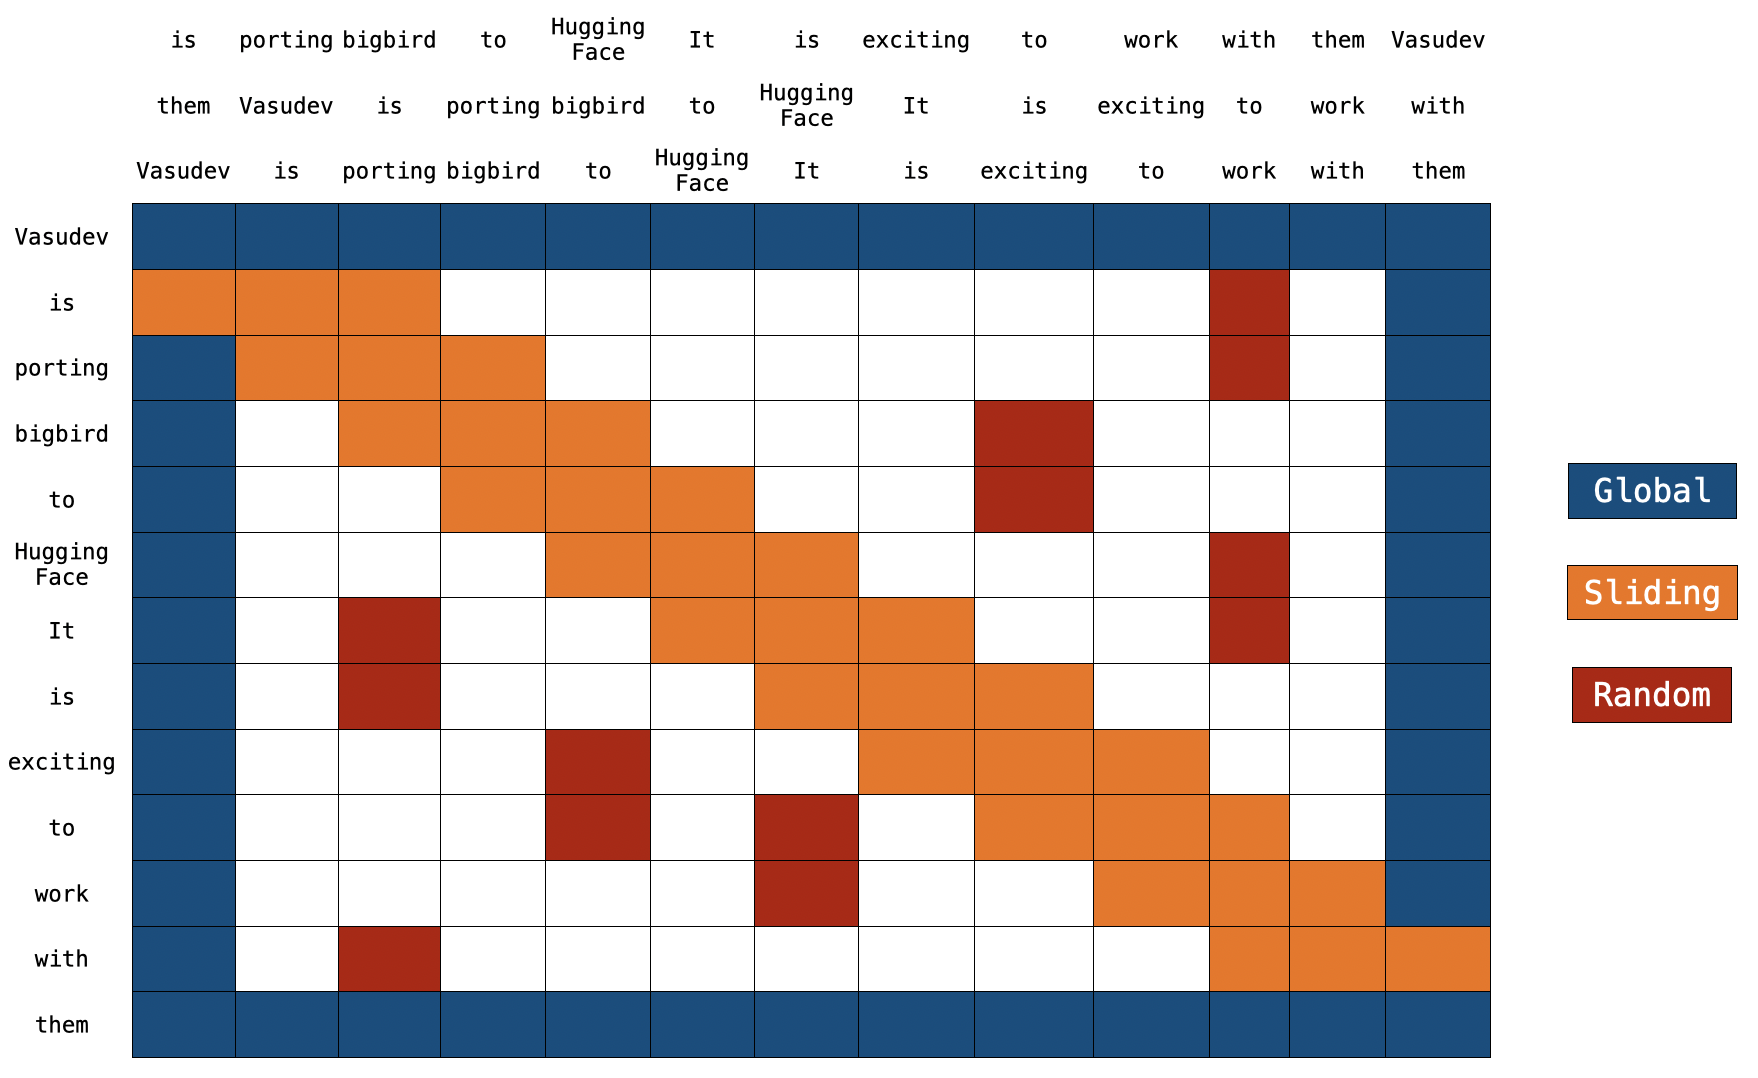
BigBird: ტრანსფორმატორების ახალი ეფექტური მიდგომა გრძელი თანმიმდევრობებისთვის
ტრანსფორმატორული მოდელები ფართოდ გამოიყენება NLP ამოცანებში, თუმცა მათი O(n^2) დროითი და მეხსიერების სირთულე ზღუდავს მათ გამოყენებას გრძელ თანმიმდევრობებზე (n > 512). BigBird, ახალი მოდელი, ამ პრობლემას ბლოკ-სპარსული ყურადღების (block sparse attention) გამოყენებით აგვარებს, რაც საშუალებას აძლევს მას დაამუშაოს თანმიმდევრობები 4096 სიგრძემდე, მნიშვნელოვნად დაბალი გამოთვლითი დანახარჯით, ვიდრე BERT. BigBird-მა მიაღწია საუკეთესო შედეგებს (SOTA) გრძელ დოკუმენტებთან დაკავშირებულ ამოცანებში, როგორიცაა შ
უსაფრთხოების გაუმჯობესება: Git ავტორიზაცია Hugging Face-ზე გადადის ტოკენებსა და SSH კლავიშებზე
Hugging Face-ის მომხმარებლებმა Git ოპერაციებისთვის პაროლის ნაცვლად უნდა გამოიყენონ პირადი წვდომის ტოკენები ან SSH კლავიშები 2023 წლის 1 ოქტომბრამდე. ეს ცვლილება მიზნად ისახავს პლატფორმის უსაფრთხოების მნიშვნელოვნად გაუმჯობესებას.

ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნა: ახალი ინსტრუმენტები საზოგადოებისთვის
ამ სტატიაში განვიხილავთ ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნისთვის შემუშავებულ ახალ ინსტრუმენტებს, რომლებიც მიზნად ისახავს ამ პროცესის გამარტივებას, სურათების გენერაციის მსგავსად. წარმოდგენილია ღია კოდის სკრიპტები მცირე მასშტაბისთვის და video2dataset დიდი მასშტაბისთვის. დეტალურად აღიწერება მონაცემთა დამუშავების 3-ეტაპიანი კონვეიერი, ფილტრაციის სტრატეგიები (მათ შორის pwatermark-ისა და ესთეტიკური ქულების გამოყენებით) და მათი გავლენა ვიდეო გენერაციის მოდელების ხარისხზე. მიზანია, საზოგადოებას
AI აუდიო გენერაცია: AudioLDM 2-ის სიჩქარის რეკორდი - 10 წამი 1 წამში
AudioLDM 2, ტექსტიდან აუდიოს გენერირების ხელოვნური ინტელექტის მძლავრი მოდელი, ადრე გამოირჩეოდა ნელი მუშაობით, 10-წამიანი აუდიოს შესაქმნელად 30 წამზე მეტი სჭირდებოდა. ახალი ბლოგ პოსტი დეტალურად აღწერს, თუ როგორ იქნა მიღწეული ინფერენციის დროის 10-ჯერ შემცირება, კოდისა და მოდელის ოპტიმიზაციების, მათ შორის ნახევრად ზუსტი გამოთვლებისა და Flash Attention-ის გამოყენებით. შედეგად, შესაძლებელია 10-წამიანი აუდიო ნიმუშის გენერირება მხოლოდ 1 წამში, ხარისხის მინიმალური გაუარესებით, Hugging Face Diffusers ბიბ

AI მოდელების მასშტაბური ინფერენციის ოპტიმიზაცია: ხარჯი და შეყოვნება
ეს სტატია დეტალურად აღწერს მეთოდოლოგიას ენკოდერული მოდელების გამოყენებით მასშტაბური კლასიფიკაციისა და ემბედინგის ამოცანებისთვის ხარჯებისა და შეყოვნების გამოსათვლელად და ოპტიმიზაციისთვის. განხილულია მოდელების არქიტექტურები, აპარატურული ხარჯების ბენჩმარკინგი და ოპტიმიზაციის ჩარჩო. გამოყენებულია ისეთი ინსტრუმენტები, როგორიცაა Inference Endpoints აპარატურის შერჩევისთვის, Hugging Face Hub განთავსებისთვის, Infinity ინფერენციის სერვერისთვის და Grafana-ს k6 დატვირთვის ტესტირებისთვის. მოცემულია პრაქტიკულ
Fetch-მა ქვითრების სკანირების სიზუსტე 200%-ით გაზარდა AWS-ის მანქანური სწავლისა და Hugging Face-ის გამოყენებით
Fetch-მა, მომხმარებლის ჩართულობისა და ჯილდოების კომპანიამ, მნიშვნელოვნად გააუმჯობესა ქვითრების სკანირების აპლიკაციის სიჩქარე და სიზუსტე, Amazon Web Services-ზე (AWS) მანქანური სწავლების პაიპლაინის ოპტიმიზაციით, Hugging Face-ისა და Amazon SageMaker-ის გამოყენებით. ამ ცვლილებამ დოკუმენტის აღქმის მოდელის სიზუსტე 200%-ით გაზარდა და ნელი სკანირებისთვის დაყოვნება 50%-ით შეამცირა, რამაც დააჩქარა ჯილდოების დამუშავება და გაზარდა პარტნიორების ნდობა.

„Few-Shot“ სწავლება: GPT-Neo, ბუნებრივი ენის დამუშავება და ეთიკური გამოწვევები
„Few-Shot“ სწავლება მანქანური სწავლების მოდელებს საშუალებას აძლევს, პროგნოზები გააკეთონ ძალიან მცირე რაოდენობის სავარჯიშო მონაცემების გამოყენებით, ტრადიციული „fine-tuning“ მეთოდებისგან განსხვავებით. ის, ძირითადად, კომპიუტერულ მხედველობაში გამოიყენებოდა, თუმცა ახლა უკვე ეფექტურია ბუნებრივი ენის დამუშავებაში (ბედ) დიდ ენობრივ მოდელებთან (მაგ. GPT-Neo), რაც მათ საშუალებას აძლევს, განაზოგადონ ახალი ამოცანები სულ რამდენიმე მაგალითით. თუმცა, ეფექტური „few-shot“ მაგალითების შექმნა და ჰიპერპარამეტრების
მოდელების კვანტიზაცია: Bitsandbytes-ისა და GPTQ-ის შედარებითი ანალიზი
სტატია განიხილავს ხელოვნური ინტელექტის მოდელების კვანტიზაციის ორ ძირითად მეთოდს, bitsandbytes-სა და auto-gptq-ს, რომლებიც მშობლიურად არის მხარდაჭერილი Transformers ბიბლიოთეკაში. წარმოდგენილია თითოეული მეთოდის უპირატესობები და ნაკლოვანებები, მათ შორის გამოყენების სიმარტივე, კროს-მოდალური თავსებადობა, ადაპტერების ინტეგრაცია, ტექსტის გენერირების სიჩქარე, სერიალიზაციის შესაძლებლობები და ტექნიკური შეზღუდვები. მოცემულია ბენჩმარკის შედეგები ინფერენსისა და ადაპტერების დახვეწის წარმადობის შესადარებლად სხ

როგორ დავხვეწოთ Llama 2 70B PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკები და გამოწვევების გადაჭრა
ეს ბლოგპოსტი დეტალურად განიხილავს Llama 2 70B მოდელის დახვეწას PyTorch FSDP-ის გამოყენებით. სტატია ფოკუსირებულია ძირითად გამოწვევებზე, როგორიცაა CPU RAM-ის გადატვირთვა, შუალედური ჩეკპოინტების შენახვის სირთულეები და VRAM-ის მოხმარების ოპტიმიზაცია. წარმოდგენილია გადაწყვეტები Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მეშვეობით, ასევე განხილულია Accelerate-ის გამოყენება SLURM-თან ერთად. მოცემულია საჭირო რესურსები და კონფიგურაციები შედეგების რეპროდუცირებისთვის.