მოდელების განთავსება ინფერენსის ენდპოინტებზე ქასთომ ჰენდლერების გამოყენებით: MusicGen-ის მაგალითი
ეს სტატია განმარტავს, თუ როგორ ხდება მოდელების, მათ შორის `transformers`-ის კონვეიერით პირდაპირ არმხარდაჭერილი ან არატრანსფორმერული მოდელების განთავსება Inference Endpoints-ის გამოყენებით. პროცესი მოიცავს მორგებული დასკვნის ფუნქციების, იგივე ქასთომ ჰენდლერების შექმნას, რათა შესაძლებელი გახდეს მოქნილი განთავსება. MusicGen-ის მაგალითზე დეტალურად არის აღწერილი `handler.py` და `requirements.txt` ფაილების შექმნა და ენდპოინტის კონფიგურაცია.
ტრანსფორმერული მოდელები წარმოებაში: გამოწვევები და Optimum-ის გადაწყვეტა
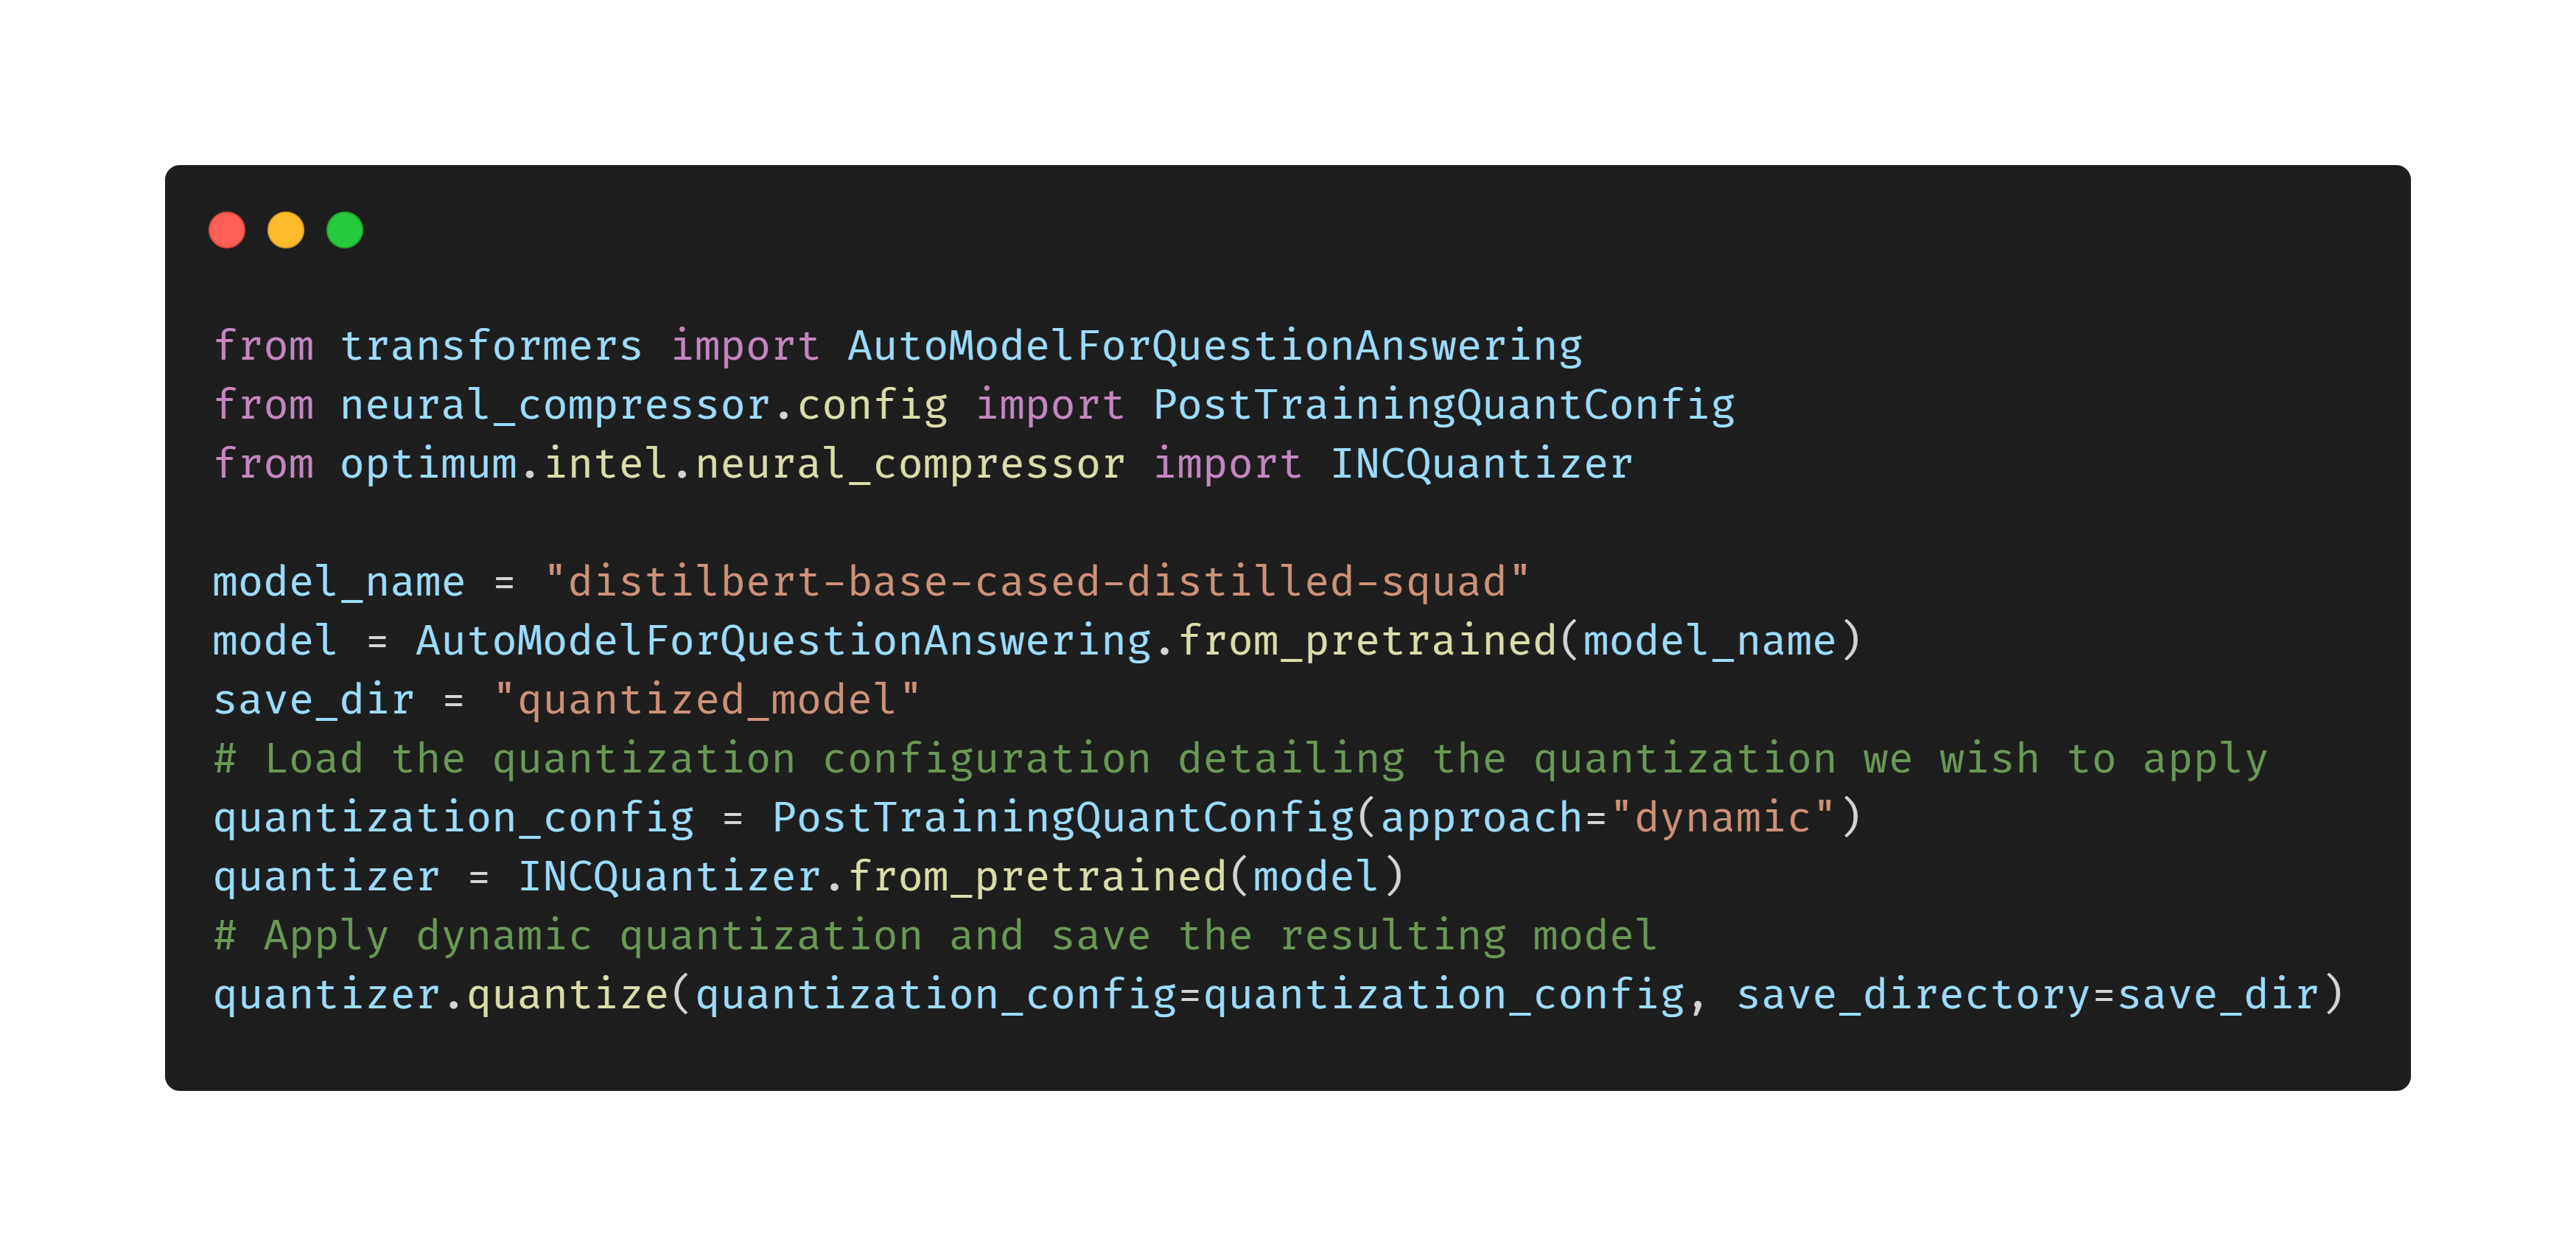
ტრანსფორმერული მოდელები, რომლებიც თანამედროვე ხელოვნური ინტელექტის განუყოფელი ნაწილია, ფართოდ გამოიყენება ტექნოლოგიური გიგანტების მიერ ისეთ სფეროებში, როგორიცაა ავტოპილოტი, ენის დამუშავება და ვიზუალური ამოცნობა. თუმცა, ამ მასიური მოდელების ეფექტურად წარმოებაში დანერგვა სერიოზულ გამოწვევებს აწყდება, განსაკუთრებით იმ გუნდებისთვის, რომლებსაც არ გააჩნიათ შეუზღუდავი რესურსები. Hugging Face-ის ახალი ღია კოდის ბიბლიოთეკა Optimum, Intel® Neural Compressor-თან თანამშრომლობით, მიზნად ისახავს ამ პროცესის გ
Hugging Face Infinity: ტრანსფორმერული მოდელების ოპტიმალური განთავსება Intel Xeon CPU-ებზე
Hugging Face Infinity არის კონტეინერიზებული გადაწყვეტა, რომელიც საშუალებას აძლევს კომპანიებს ეფექტურად განათავსონ ტრანსფორმერული მოდელები წარმოებაში დაბალი ლატენტურობითა და მაღალი გამტარუნარიანობით. ეს ბლოგ პოსტი წარმოადგენს დეტალურ წარმადობის შედეგებს Infinity-ის უახლესი თაობის Intel Xeon CPU-ებზე გაშვებისას (კერძოდ, Ice Lake-ზე დაფუძნებული EC2 C6i ინსტანსებზე), რაც უზრუნველყოფს ოპტიმალურ ღირებულებას, ეფექტურობასა და ლატენტურობას თქვენი Transformer-ის განთავსებისთვის.
Wav2Vec2: ტრანსფორმერული მოდელების შეზღუდვების დაძლევა ხანგრძლივი აუდიო ფაილების დამუშავებისას
Wav2Vec2, როგორც ტრანსფორმერული მოდელი, აწყდება თანმიმდევრობის სიგრძის შეზღუდვებს, რაც იწვევს პრობლემებს დიდ აუდიო ფაილებთან მუშაობისას. ტრადიციული დაყოფის მეთოდები ხშირად ამცირებს შედეგების ხარისხს კონტექსტის დაკარგვის გამო. ეს სტატია განმარტავს, თუ როგორ იძლევა Wav2Vec2-ის CTC სტრუქტურა საშუალებას, განხორციელდეს მდგრადი მეტყველების ამოცნობა ძალიან დიდ ფაილებზე, „striding“ ტექნიკის გამოყენებით. ასევე განხილულია ენის მოდელების (LM) ინტეგრაცია WER მაჩვენებლის გასაუმჯობესებლად და მოდელის გამოყენებ

ხელოვნური ინტელექტი: გამოსახულებების ტოკენიზაცია და ViT მოდელების წვრთნა
ეს სტატია განმარტავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია წინადადებების მსგავსად, რაც მათ საშუალებას აძლევს, დამუშავდეს ტრანსფორმერული მოდელებით. დეტალურად არის აღწერილი 🤗 datasets-ის გამოყენებით მონაცემთა მომზადება, ViTImageProcessor-ის ინტეგრირება და წინასწარ გაწვრთნილი ViT მოდელების დაზუსტება. მიმოხილულია ტრენინგის კონფიგურაციის, შეფასების მეტრიკების განსაზღვრისა და ეფექტური წვრთნის კონვეიერის აგების პროცესები, რაც მნიშვნელოვან წინსვლას წარმოადგენს გამოსახულების კლასიფიკაციის ამოცანებშ
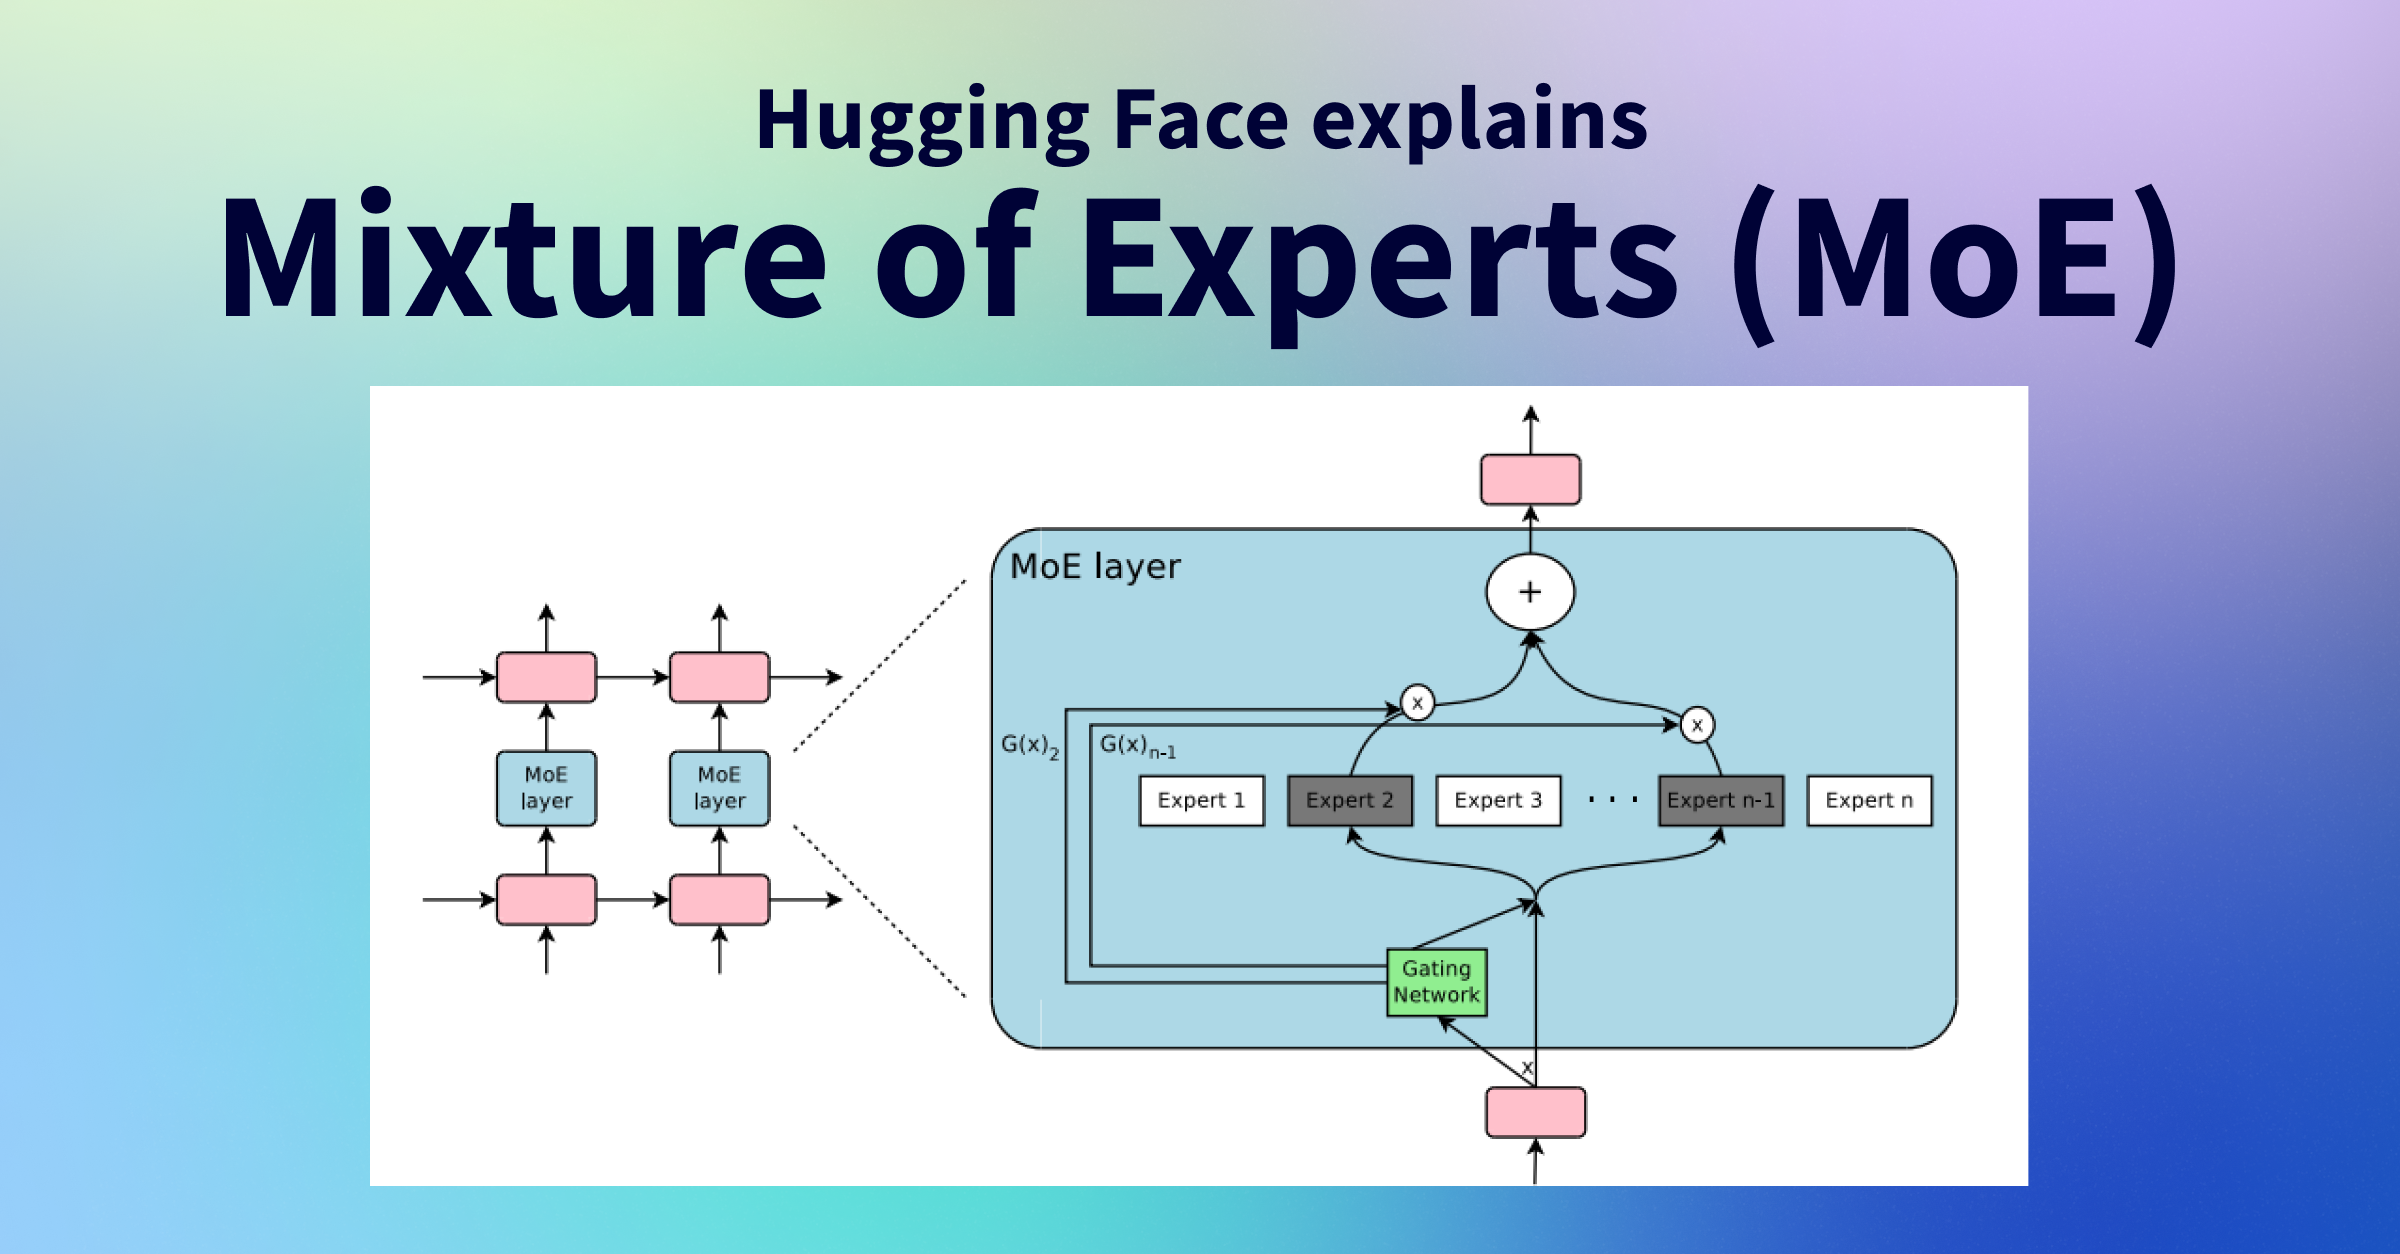
ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი
Habana Labs და Hugging Face-ი თანამშრომლობენ ტრანსფორმერული მოდელების ტრენინგის დასაჩქარებლად
Habana Labs, ღრმა სწავლის პროცესორების პიონერი, და Hugging Face, ტრანსფორმერული მოდელების ცენტრალური პლატფორმა, აცხადებენ პარტნიორობის შესახებ, რომლის მიზანია მაღალი ხარისხის ტრანსფორმერული მოდელების სწავლების პროცესის გამარტივება, დაჩქარება და გაიაფება. Habana-ს SynapseAI პროგრამული პაკეტის Hugging Face Optimum-ის ღია კოდის ბიბლიოთეკასთან ინტეგრაცია საშუალებას მისცემს მონაცემთა მეცნიერებსა და მანქანური სწავლების ინჟინრებს, ეფექტურად გამოიყენონ Habana Gaudi პროცესორები, შეამცირონ ხარჯები და გაზა
Hugging Face და AMD აძლიერებენ ხელოვნური ინტელექტის განვითარებას AMD GPU-ებზე
Hugging Face-ი და AMD-ი აცხადებენ მნიშვნელოვან პროგრესს AMD GPU-ებზე დიდი ენობრივი მოდელების (LLM) მხარდაჭერაში, რაც უზრუნველყოფს ტრანსფორმერული მოდელების უწყვეტ გაშვებას კოდის შეცვლის გარეშე. დამატებითი აჩქარების ინსტრუმენტები, როგორიცაა ONNX, Optimum-Benchmark და DeepSpeed, უკვე მხარდაჭერილია. კომპანიები ასევე ხელს უწყობენ დეველოპერებს PC AI კონკურსის ფარგლებში ინოვაციური AI აპლიკაციების შექმნაში AMD Ryzen AI-ით აღჭურვილ კომპიუტერებზე.

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.
Megatron-LM: დიდი ტრანსფორმერული მოდელების ოპტიმიზებული წვრთნა NVIDIA GPU-ებზე
ეს სტატია განიხილავს Megatron-LM-ს, NVIDIA-ს მძლავრ ფრეიმვორკს დიდი ტრანსფორმერული მოდელების წინა-წვრთნისთვის. მიუხედავად იმისა, რომ ის დამწყებთათვის შეიძლება რთული იყოს, Megatron-LM უაღრესად ოპტიმიზებულია GPU-ებზე წვრთნისთვის და გვთავაზობს მნიშვნელოვან აჩქარებას ისეთი მექანიზმების წყალობით, როგორიცაა ეფექტური DataLoader, Kernel Fusion და Fused AdamW. სტატიაში მოცემულია დეტალური გზამკვლევი GPT2 მოდელის წვრთნისთვის, მათ შორის გარემოს დაყენება, მონაცემთა წინასწარი დამუშავება და წვრთნის პარამეტრები
Intel-ი და Hugging Face-ი Optimum Intel-ში OpenVINO-ს ინტეგრაციას აცხადებენ ტრანსფორმერული მოდელების დასაჩქარებლად
Intel-მა და Hugging Face-მა OpenVINO ინტეგრირეს Optimum Intel-ში, რაც დეველოპერებს საშუალებას აძლევს, მარტივად დააჩქარონ ტრანსფორმერული მოდელები Intel-ის სხვადასხვა პროცესორზე. ეს ინტეგრაცია უზრუნველყოფს ეფექტურ ინფერენსსა და კვანტიზაციას OpenVINO ნერვული ქსელების შეკუმშვის ფრეიმვორკის (NNCF) გამოყენებით, მნიშვნელოვნად ამცირებს მოდელის ზომასა და შეყოვნებას სიზუსტის მინიმალური დაკარგვით.
Intel-ი და Hugging Face-ი OpenVINO-ს Optimum Intel-ში აერთიანებენ AI მოდელების დასაჩქარებლად
Intel-მა და Hugging Face-მა გამოაცხადეს Intel OpenVINO-ს Optimum Intel-ში ინტეგრაციის შესახებ, რაც ტრანსფორმერული მოდელების სწრაფ და ეფექტურ ინფერენსს შესაძლებელს ხდის Intel-ის პროცესორებზე. სიახლე მოიცავს მოდელების კვანტიზაციას ზომის შემცირებისა და პროგნოზირების დაყოვნების გაუმჯობესებისთვის, ასევე მოცემულია ვიზუალური ტრანსფორმერის (ViT) გამოყენების პრაქტიკული მაგალითი. დეველოპერებს მოუწოდებენ, გამოიკვლიონ ახალი შესაძლებლობები.