
ხელოვნურმა ინტელექტმა CUDA ქერნელების წერა ისწავლა: ახალი უნარი GPU პროგრამირებას ამარტივებს
შემუშავდა ხელოვნური ინტელექტის აგენტის ახალი უნარი, რომელიც კოდირების აგენტებს ასწავლის საწარმოო დონის CUDA ქერნელების შექმნას. ამ უნარის გამოყენებით, Claude-მა და Codex-მა წარმატებით დაწერეს ფუნქციური ქერნელები diffusers-ის კონვეიერისა და transformers-ის მოდელისთვის, მოახდინეს მათი სწორი ინტეგრაცია PyTorch-თან და ჩაატარეს წარმადობის ტესტები, რაც ადასტურებს პროცესის სრულ ავტომატიზაციას.
როგორ შევქმნათ AI-ზე დაფუძნებული ხატვის თამაში ბრაუზერში: Quick, Draw!-ის შთაგონებით
გაეცანით დეტალურ სახელმძღვანელოს, თუ როგორ უნდა შექმნათ ხელოვნური ინტელექტზე დაფუძნებული ხატვის თამაში, რომელიც Google-ის „Quick, Draw!“-ით არის შთაგონებული. პროექტი გვიჩვენებს, როგორ მივაღწიოთ რეალურ დროში, წამში 60-ზე მეტ პროგნოზს, მოდელის ბრაუზერში გაშვებით, Transformers.js-ის, MobileViT მოდელისა და Web Workers-ის გამოყენებით. სტატია მოიცავს მოდელის მომზადებას, ONNX-ში კონვერტაციას და React აპლიკაციის აგებას.

ახალი მეთოდი სტატიკური ემბედინგის მოდელების საწვრთნელად: 100-400-ჯერ უფრო სწრაფი CPU-ზე
ეს ბლოგპოსტი წარმოგიდგენთ მეთოდს სტატიკური ემბედინგის მოდელების საწვრთნელად, რომლებიც CPU-ზე 100-400-ჯერ უფრო სწრაფად მუშაობენ, ვიდრე უახლესი მოდელები, ხარისხის უმეტესი ნაწილის შენარჩუნებით. ეს ხსნის უამრავ საინტერესო გამოყენების შესაძლებლობას, მათ შორის მოწყობილობაზე და ბრაუზერში გაშვებას, Edge Computing-ს, დაბალენერგეტიკულ და ჩაშენებულ აპლიკაციებს. ჩვენ გამოვიყენეთ ეს მიდგომა ორი უკიდურესად ეფექტური ემბედინგის მოდელის მოსამზადებლად: sentence-transformers/static-retrieval-mrl-en-v1 ინგლისური ინ
TimmWrapper: PyTorch-ის გამოსახულების მოდელების ინტეგრაცია Hugging Face Transformers-თან
TimmWrapper წარმოადგენს ინსტრუმენტს, რომელიც აერთიანებს PyTorch Image Models (timm) ბიბლიოთეკას Hugging Face transformers-თან. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს გამოიყენონ timm-ის თანამედროვე კომპიუტერული ხედვის მოდელების ფართო კოლექცია transformers-ის ეკოსისტემაში. ის უზრუნველყოფს ისეთ ფუნქციებს, როგორიცაა pipeline API-ის გამოყენება, Auto Classes, კვანტიზაცია და მოქნილი წვრილი მორგება (LoRA-ს ჩათვლით) ნაცნობი Trainer API-ის მეშვეობით. TimmWrapper ავსებს ამ ორ მძლავრ ბიბლიოთეკას შორი
ტრანსფორმერზე დაფუძნებული ენკოდერ-დეკოდერის მოდელები: არქიტექტურისა და ინფერენციის სიღრმისეული მიმოხილვა
ეს ბლოგ-პოსტი დეტალურად განმარტავს, თუ როგორ ამუშავებენ ტრანსფორმერზე დაფუძნებული ენკოდერ-დეკოდერის არქიტექტურის მოდელები მიმდევრობა-მიმდევრობაზე ამოცანებს. განხილულია მათემატიკური მოდელი და მისი გამოყენება ინფერენციაში, NLP-ში მიმდევრობა-მიმდევრობაზე მოდელების ისტორიულ კონტექსტთან ერთად. იგი ყოფს ტრანსფორმერის არქიტექტურას ენკოდერისა და დეკოდერის ნაწილებად, გვაწვდის ვიზუალურ მასალას და აკავშირებს თეორიას 🤗Transformers-ის პრაქტიკულ გამოყენებასთან. სტატია მოკლედ მიმოიხილავს ნეირონული ენკოდერ-დეკო
მოწინავე ჰიპერპარამეტრების ოპტიმიზაცია Hugging Face Transformers-თან და Ray Tune-თან ერთად
მანქანური სწავლების მოდელების ეფექტურობის გასაუმჯობესებლად აუცილებელია ჰიპერპარამეტრების დარეგულირება, თუმცა ხშირად მას სათანადო ყურადღება არ ექცევა. Hugging Face Transformers-ის 3.1 ვერსიაში Hugging Face Transformers-მა და Ray Tune-მა გააერთიანეს ძალები, რათა შემოგვთავაზონ მარტივი, მაგრამ მძლავრი ინტეგრაცია. ეს გადაწყვეტა უზრუნველყოფს მოწინავე ოპტიმიზაციის ალგორითმებზე მარტივ წვდომას, როგორიცაა PBT, HyperBand და ბაიესური ოპტიმიზაცია, რაც მნიშვნელოვნად აუმჯობესებს მოდელების მუშაობას და ინარჩუნებ
მაღალი ხარისხის მთარგმნელის ადაპტირება: გამოწვევები და პროცესი
სტატია დეტალურად აღწერს Facebook FAIR-ის WMT19-ის ახალი ამბების მთარგმნელობითი სისტემის `transformers` ბიბლიოთეკასთან ადაპტირების (porting) პროცესს. პროექტის მიზანი იყო მაღალი ხარისხის მთარგმნელის ადაპტირება, რისთვისაც თავდაპირველი სისტემის დეტალური შესწავლა გახდა საჭირო. ავტორი განიხილავს პროექტის კომპლექსურობის დაძლევას მცირე ამოცანებად დაყოფით, წინასწარ გაწვრთნილი en-ru/ru-en მოდელებთან მუშაობის უპირატესობებს და ლექსიკონების განსხვავებების (გაერთიანებული vs. ცალკეული) დამუშავების თავისებურებე
მოდელების განთავსება ინფერენსის ენდპოინტებზე ქასთომ ჰენდლერების გამოყენებით: MusicGen-ის მაგალითი
ეს სტატია განმარტავს, თუ როგორ ხდება მოდელების, მათ შორის `transformers`-ის კონვეიერით პირდაპირ არმხარდაჭერილი ან არატრანსფორმერული მოდელების განთავსება Inference Endpoints-ის გამოყენებით. პროცესი მოიცავს მორგებული დასკვნის ფუნქციების, იგივე ქასთომ ჰენდლერების შექმნას, რათა შესაძლებელი გახდეს მოქნილი განთავსება. MusicGen-ის მაგალითზე დეტალურად არის აღწერილი `handler.py` და `requirements.txt` ფაილების შექმნა და ენდპოინტის კონფიგურაცია.
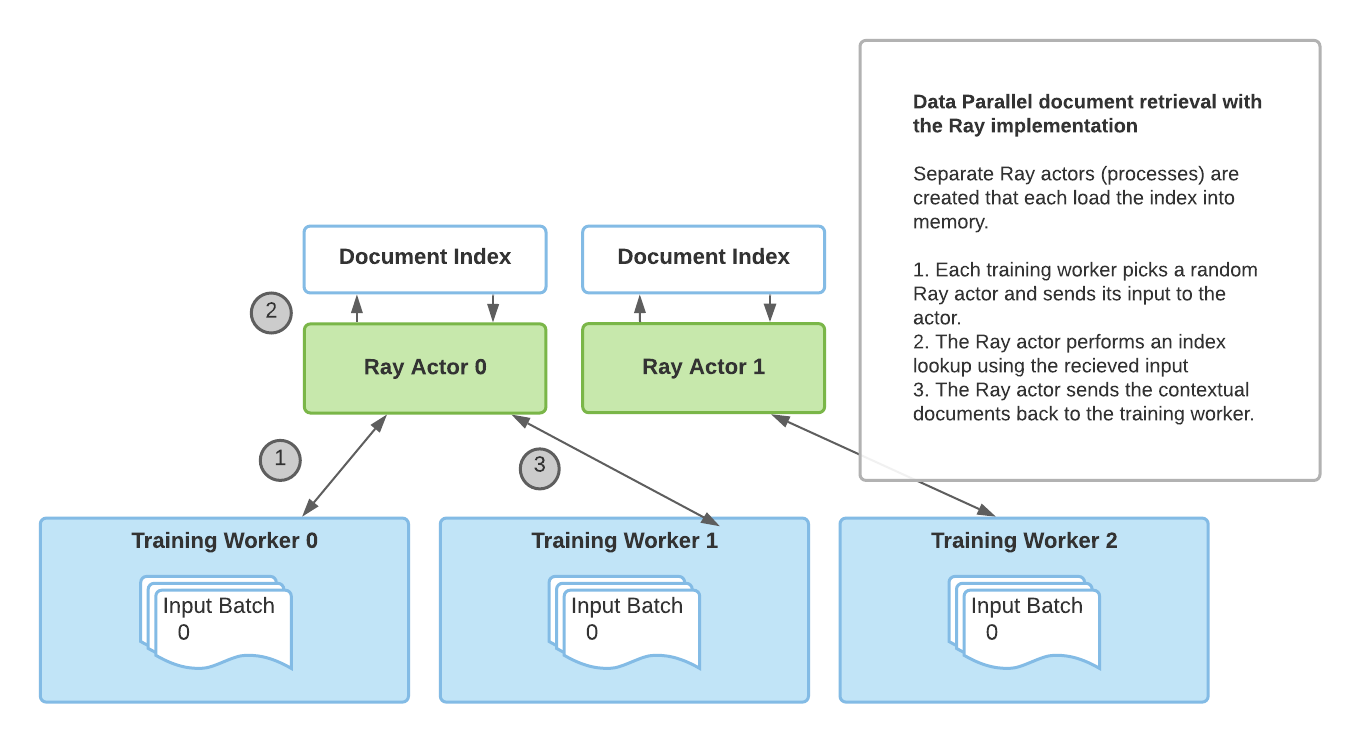
RAG მოდელების გაუმჯობესება: Ray-ის ინტეგრაცია სწრაფი განაწილებული დახვეწისთვის
სტატია მიმოიხილავს RAG (Retrieval Augmented Generation) მოდელებს, რომლებიც კონტექსტურ დოკუმენტებს გარე წყაროებიდან იძიებენ შედეგების გენერაციისთვის. ის ხაზს უსვამს დოკუმენტების მოძიების პროცესის სირთულესა და მასშტაბირებადობის გამოწვევებს `torch.distributed` იმპლემენტაციის დროს. წარმოდგენილია Ray-ზე დაფუძნებული ახალი გადაწყვეტა, რომელიც მნიშვნელოვნად აუმჯობესებს მოძიების სიჩქარესა და RAG მოდელების დახვეწის მასშტაბირებადობას Huggingface Transformers ბიბლიოთეკაში. აღწერილია Ray-ის გამოყენების უპირა
Bark TTS მოდელის ოპტიმიზაცია Hugging Face ეკოსისტემით: მეხსიერება და ინფერენსის გაუმჯობესება
ეს სტატია წარმოგიდგენთ 'Bark' ტექსტიდან მეტყველებად გარდამქმნელი (TTS) მოდელის ოპტიმიზაციის პრაქტიკულ სახელმძღვანელოს Hugging Face-ის 'Transformers', 'Optimum' და 'Accelerate' ბიბლიოთეკების გამოყენებით. დეტალურად განიხილება მეხსიერების მოხმარების შემცირებისა და ინფერენსის სიჩქარის გაუმჯობესების სამი მარტივი მეთოდი, მათ შორის 'Better Transformer' და 'Flash Attention'. ასევე ნაჩვენებია ოპტიმიზებული და არაოპტიმიზებული მოდელების წარმადობის შედარებისა და ბენჩმარკინგის პროცესი.
Hugging Face-მა AutoGPTQ ინტეგრირება მოახდინა Transformers-ში: ხელმისაწვდომი დიდი ენობრივი მოდელები
Hugging Face-მა თავის Transformers ბიბლიოთეკაში AutoGPTQ-ის ინტეგრირებით, დიდი მანქანური სწავლის მოდელების ხელმისაწვდომობა მნიშვნელოვნად გაზარდა. ეს მომხმარებლებს საშუალებას აძლევს, მოდელების 8-დან 2-ბიტამდე სიზუსტით კვანტიზაცია და გაშვება შეძლონ GPTQ ალგორითმის გამოყენებით, მინიმალური სიზუსტის დაკარგვით და გაუმჯობესებული წარმადობით. ინტეგრაცია ხელმისაწვდომია როგორც Nvidia, ასევე RoCm-ზე მომუშავე AMD GPU-ებისთვის, რაც LLM-ების ოპტიმიზაციას უფრო ფართო აუდიტორიისთვის ხდის შესაძლებელს.
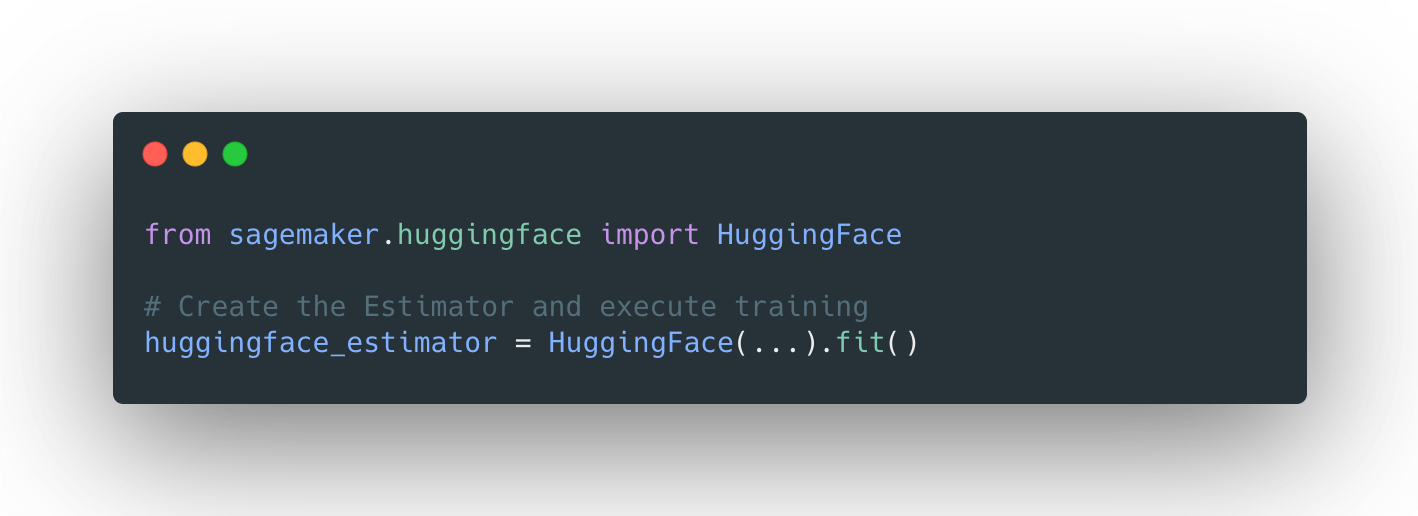
Hugging Face Transformers-ისა და AWS SageMaker-ის ინტეგრაცია: მარტივი და სწრაფი AI მოდელების ტრენინგი
Hugging Face-ისა და AWS SageMaker-ის გუნდებმა ერთობლივად შექმნეს Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები, რაც მნიშვნელოვნად აჩქარებს Transformers-ზე დაფუძნებული მოდელების ტრენინგს. ახალი HuggingFace estimator-ის წყალობით SageMaker Python SDK-ში, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ეს ინტეგრაცია დეტალურად აღწერილია ბლოგ-პოსტში, რომელიც მოიცავს დაწყების მაგალითებსა და დოკუმენტაციას. სტატია განმარტავს, თუ როგორ ხდება Facebook-ის BART-large-cnn მოდელის დახვეწა Samsum მ

Sentence Transformers v2: რევოლუციური განახლებები და ინტეგრაცია Hugging Face Hub-თან
Sentence Transformers-ის v2 ვერსიის გამოშვება ახალ შესაძლებლობებს გვთავაზობს წინადადების, აბზაცისა და გამოსახულების ემბედინგებისთვის. განახლება მოიცავს Hugging Face Hub-თან ღრმა ინტეგრაციას, 90-ზე მეტი წინასწარ გაწვრთნილი მოდელით 100-ზე მეტი ენისთვის. წარმოდგენილია ახალი ვიჯეტები – ფუნქციის ექსტრაქციისა და წინადადების მსგავსების გამოსათვლელად, ასევე API ინტერფეისები მოდელებთან პროგრამული წვდომისთვის, რაც საზოგადოებას საშუალებას აძლევს მარტივად გააზიაროს და გამოიყენოს თავისი გაწვრთნილი მოდელები.
Amazon SageMaker ამარტივებს Hugging Face Transformers-ის დეპლოირებას ახალი Inference DLC-ებითა და ხელსაწყოებით
Amazon SageMaker-მა გამოუშვა Hugging Face Inference DLC-ები და ახალი Inference Toolkit, რაც მნიშვნელოვნად ამარტივებს Hugging Face Transformers მოდელების დეპლოირებას. ეს სიახლე საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ როგორც საკუთარი გაწვრთნილი მოდელები, ისე Hugging Face Model Hub-დან 10,000-ზე მეტი საჯაროდ ხელმისაწვდომი მოდელი, სულ ერთი დამატებითი კოდის ხაზით. SageMaker უზრუნველყოფს საპროდუქციო გარემოსთვის მზა ენდპოინტებს ჩაშენებული მონიტორინგითა და მასშტაბირებადი შესაძლებლობებით.
მოდელების კვანტიზაცია: bitsandbytes-ისა და GPTQ-ის შედარება
ეს სტატია განიხილავს მოდელების კვანტიზაციის ორ ძირითად მიზანს და `transformers` ბიბლიოთეკაში ინტეგრირებულ ორ ძირითად სქემას: `bitsandbytes`-ს და `auto-gptq`-ს. მოცემულია თითოეული მეთოდის დადებითი და უარყოფითი მხარეები, საზოგადოების გამოხმაურების საფუძველზე. ასევე წარმოდგენილია ინფერენციისა და ადაპტერების დაზუსტების ბენჩმარკები სხვადასხვა აპარატურაზე, რაც მომხმარებლებს დაეხმარება ოპტიმალური მიდგომის არჩევაში.
მოდელების კვანტიზაცია: Bitsandbytes-ისა და GPTQ-ის შედარებითი ანალიზი
სტატია განიხილავს ხელოვნური ინტელექტის მოდელების კვანტიზაციის ორ ძირითად მეთოდს, bitsandbytes-სა და auto-gptq-ს, რომლებიც მშობლიურად არის მხარდაჭერილი Transformers ბიბლიოთეკაში. წარმოდგენილია თითოეული მეთოდის უპირატესობები და ნაკლოვანებები, მათ შორის გამოყენების სიმარტივე, კროს-მოდალური თავსებადობა, ადაპტერების ინტეგრაცია, ტექსტის გენერირების სიჩქარე, სერიალიზაციის შესაძლებლობები და ტექნიკური შეზღუდვები. მოცემულია ბენჩმარკის შედეგები ინფერენსისა და ადაპტერების დახვეწის წარმადობის შესადარებლად სხ

როგორ დავხვეწოთ Llama 2 70B PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკები და გამოწვევების გადაჭრა
ეს ბლოგპოსტი დეტალურად განიხილავს Llama 2 70B მოდელის დახვეწას PyTorch FSDP-ის გამოყენებით. სტატია ფოკუსირებულია ძირითად გამოწვევებზე, როგორიცაა CPU RAM-ის გადატვირთვა, შუალედური ჩეკპოინტების შენახვის სირთულეები და VRAM-ის მოხმარების ოპტიმიზაცია. წარმოდგენილია გადაწყვეტები Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მეშვეობით, ასევე განხილულია Accelerate-ის გამოყენება SLURM-თან ერთად. მოცემულია საჭირო რესურსები და კონფიგურაციები შედეგების რეპროდუცირებისთვის.
Llama 2 70B-ის დახვეწა PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკა და გამოწვევების გადაწყვეტა
ამ ბლოგ-პოსტში განხილულია Llama 2 70B მოდელის დახვეწის პროცესი PyTorch FSDP-ის გამოყენებით, Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მოშველიებით. დეტალურად არის აღწერილი FSDP-ის მოქმედების პრინციპი, რომელიც ოპტიმიზატორის მდგომარეობებს, გრადიენტებსა და პარამეტრებს მოწყობილობებს შორის ანაწილებს. ასევე, განხილულია ძირითადი გამოწვევები, როგორიცაა CPU RAM-ის მაღალი მოთხოვნები, შუალედური საკონტროლო წერტილების ნელი შენახვა და NCCL Timeout შეცდომები. სტატია გვთავაზობს გადაწყვეტებს ტრე
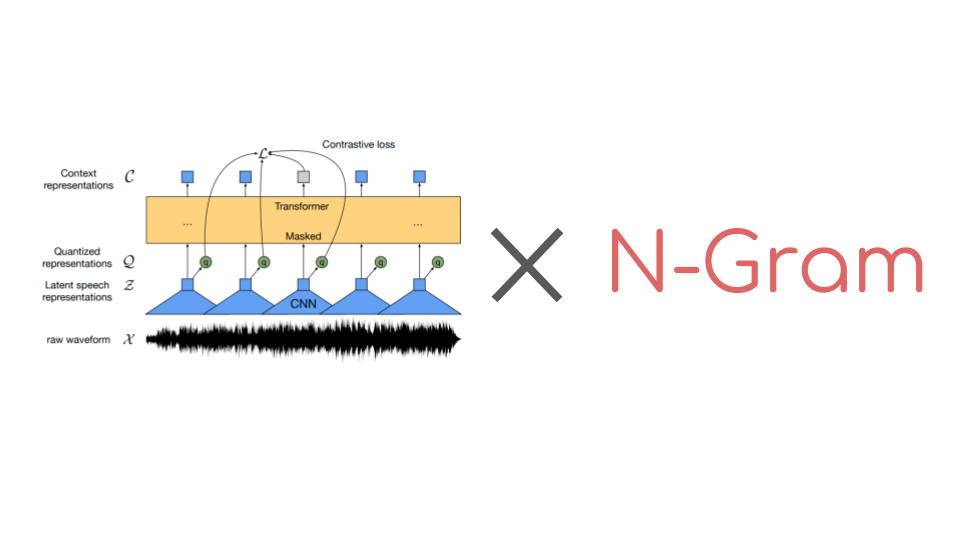
Wav2Vec2: ენობრივი მოდელების ინტეგრაცია ზუსტი მეტყველების ამოცნობისთვის
ეს სტატია განმარტავს, თუ როგორ უნდა დავაზუსტოთ Wav2Vec2 მოდელები მეტყველების ამოცნობისთვის და მნიშვნელოვნად გავაუმჯობესოთ ტრანსკრიფციის სიზუსტე ენობრივი მოდელის (LM) ინტეგრაციით. აღწერილია Connectionist Temporal Classification (CTC) ალგორითმის გამოყენება და დეტალურადაა განხილული pyctcdecode ბიბლიოთეკისა და 🤗 Transformers-ის საშუალებით n-გრამული ენობრივი მოდელის შექმნისა და Wav2Vec2 ჩეკპოინტთან შერწყმის ნაბიჯ-ნაბიჯ პროცესი, განსაკუთრებით ხაზგასმულია გაუმჯობესება მოკლე სასწავლო მონაცემთა ნაკრებებზ

გამოსახულებების ტოკენიზაცია და ViT მოდელების დახვეწა გამოსახულების კლასიფიკაციისთვის
ეს სტატია განიხილავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია ტრანსფორმატორის მოდელებისთვის, ნატურალური ენის დამუშავების (NLP) ამოცანების ანალოგიით. დეტალურად არის აღწერილი 🤗 datasets-ისა და 🤗 transformers-ის გამოყენებით ViT (Vision Transformer) მოდელის წინასწარი წვრთნა და დახვეწა გამოსახულების კლასიფიკაციის ამოცანებისთვის. მოცემულია ინსტრუქციები მონაცემთა ჩამოტვირთვის, დამუშავების, გამოსახულების ტრანსფორმაციებისა და წვრთნის კონვეიერის დაყენების შესახებ, მათ შორის ისეთი კომპონენტების, როგორიც

Hugging Face AMD Instinct GPU-ების სრულყოფილ მხარდაჭერას აცხადებს ხელოვნური ინტელექტის მოდელებისთვის
AMD-ის უახლესი Instinct MI300 სერიის ამაჩქარებლების მოახლოებულ გამოშვებასთან ერთად, Hugging Face აძლიერებს AMD GPU-ების მხარდაჭერას, რაც მომხმარებლებს საშუალებას აძლევს, გაუშვან Transformers-ის ყველა მოდელი და ამოცანა კოდის ყოველგვარი ცვლილების გარეშე. თანამშრომლობა მოიცავს ინტეგრირებულ ტესტირებას, გარემოსდაცვითი კვალის მინიმიზაციას და მნიშვნელოვან წარმადობის გაუმჯობესებას, განსაკუთრებით დიდი ენობრივი მოდელებისთვის და ტექსტის გენერირების ინფერენციისთვის (TGI), სადაც AMD Instinct MI250 GPU აჭარბე
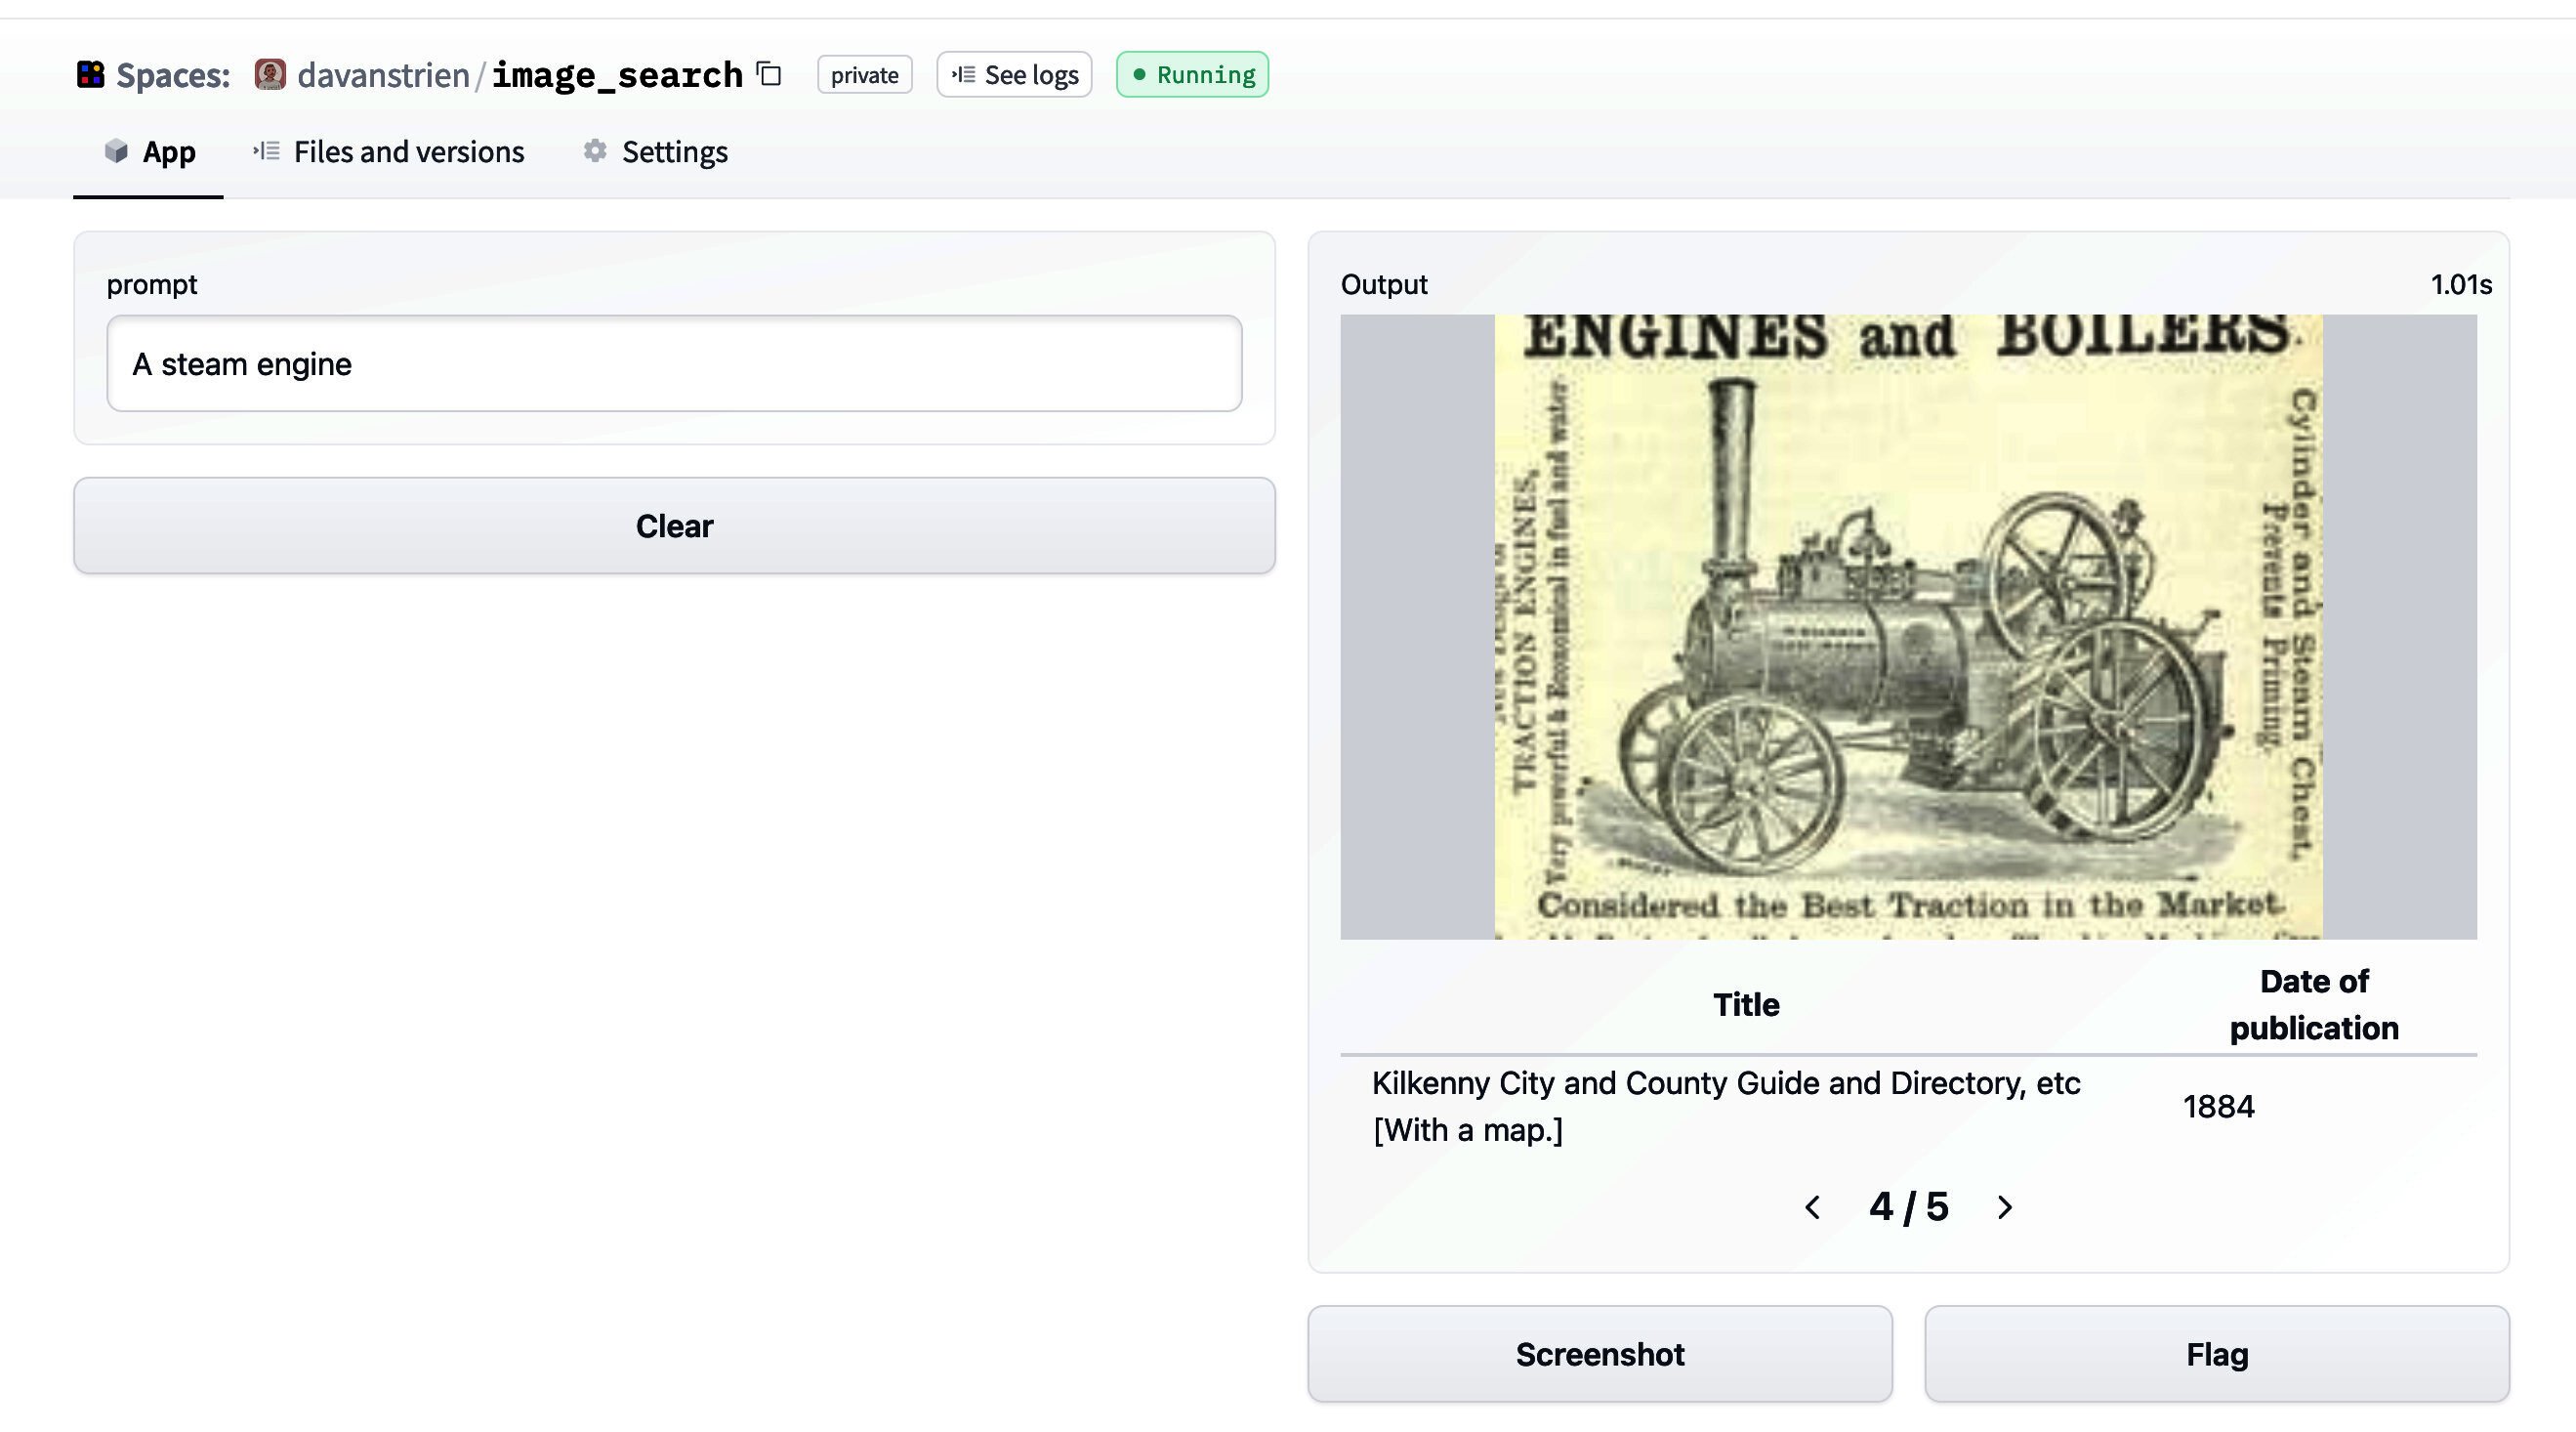
`datasets` ბიბლიოთეკა: ახალი შესაძლებლობები სურათების ძიებისთვის
თავდაპირველად ტექსტურ მონაცემებთან ასოცირებული `datasets` ბიბლიოთეკა ახლა გაძლიერებულ მხარდაჭერას გვთავაზობს აუდიო და სურათებისთვის. ეს სტატია განიხილავს, თუ როგორ შეიძლება `datasets`-ის, `sentence_transformers`-ისა და `faiss`-ის გაერთიანებით სურათების საძიებო აპლიკაციის შექმნა, ბრიტანეთის ბიბლიოთეკის ციფრული კოლექციიდან მიღებული სურათების მაგალითზე.

BERT-ისა და ტრანსფორმერების დაჩქარება AWS Inferentia-ს მეშვეობით: სრულფასოვანი გზამკვლევი
ტრანსფორმერებზე დაფუძნებული მოდელები ხელოვნურ ინტელექტში სულ უფრო ფართოდ გამოიყენება, თუმცა მათი ზომა და სირთულე დიდმასშტაბიანი ამოცანებისთვის გამოწვევას წარმოადგენს. AWS ამ პრობლემას Inferentia ჩიპით აგვარებს, რომელიც სპეციალურად ოპტიმიზირებულია ინფერენციისთვის, უზრუნველყოფს ხარჯების 80%-მდე შემცირებას და 2.3-ჯერ მეტ გამტარუნარიანობას. ეს სტატია განმარტავს, თუ როგორ შეიძლება Hugging Face Transformers-ის, Amazon SageMaker-ისა და AWS Inferentia-ს კომბინაციით BERT-ის ინფერენციის დაჩქარება ტექსტის
Hugging Face-ი Decision Transformer-ს აინტეგრირებს: ახალი მიდგომა გაძლიერებით სწავლებაში
Hugging Face-მა Decision Transformer, ოფლაინ გაძლიერებითი სწავლის (Offline Reinforcement Learning) მეთოდი, თავის 🤗 transformers ბიბლიოთეკასა და Hugging Face Hub-ში ინტეგრირება მოახდინა. ეს ინტეგრაცია მნიშვნელოვან ნაბიჯს წარმოადგენს Deep Reinforcement Learning-ის (Deep RL) სფეროში ხელმისაწვდომობის გასაუმჯობესებლად. Decision Transformer წარმოადგენს პარადიგმის ცვლას, სადაც ტრადიციული RL მეთოდების ნაცვლად გამოიყენება მიმდევრობის მოდელირების ალგორითმი სასურველი შედეგის მისაღწევად მომავალი მოქმედებები