შექმენით თქვენი საკუთარი ღია კოდის ChatGPT კოდის დაწერის გარეშე Hugging Face-ის ხელსაწყოებით
ეს გაკვეთილი გვიჩვენებს, თუ როგორ შეიძლება შეიქმნას და განთავსდეს ღია კოდის ChatGPT-ის მსგავსი აპლიკაცია Meta-ს LLaMA 2 მოდელის გამოყენებით, რომელიც დახვეწილია ღია კოდის ინსტრუქციების მონაცემთა ნაკრებით, ყოველგვარი კოდის დაწერის გარეშე. სტატია ხაზს უსვამს Hugging Face-ის ინსტრუმენტების (Spaces, AutoTrain, ChatUI) როლს, რათა მანქანური სწავლება ხელმისაწვდომი გახდეს არატექნიკური მომხმარებლებისთვის, რაც გზას უხსნის ხელოვნური ინტელექტის დემოკრატიზებულ მომავალს.

Yaak-ი და LeRobot-ი L2D-ს, მსოფლიოში უდიდეს მულტიმოდალურ მონაცემთა ბაზას, წარადგენენ რობოტიკის ხელოვნური ინტელექტისთვის
კომპანია Yaak-მა, 🤗-ის LeRobot გუნდთან თანამშრომლობით, გამოაცხადა Learning to Drive (L2D) — მსოფლიოში უდიდესი მულტიმოდალური მონაცემთა ბაზა. L2D მიზნად ისახავს რობოტიკის ხელოვნური ინტელექტის პოტენციალის განბლოკვას ავტონომიური მართვის სფეროში, განსაკუთრებული მხარდაჭერით LeRobot-ის ტრენინგის პაიპლაინებისთვის. მონაცემთა ბაზა მოიცავს რეალურ მართვის სცენარებს 60 ელექტრომობილიდან, რომლებსაც გერმანიის 30 ქალაქში ავტოსკოლები მართავდნენ. ის განასხვავებს ექსპერტისა და სტუდენტის მართვის პოლიტიკებს, ბუნებრივ
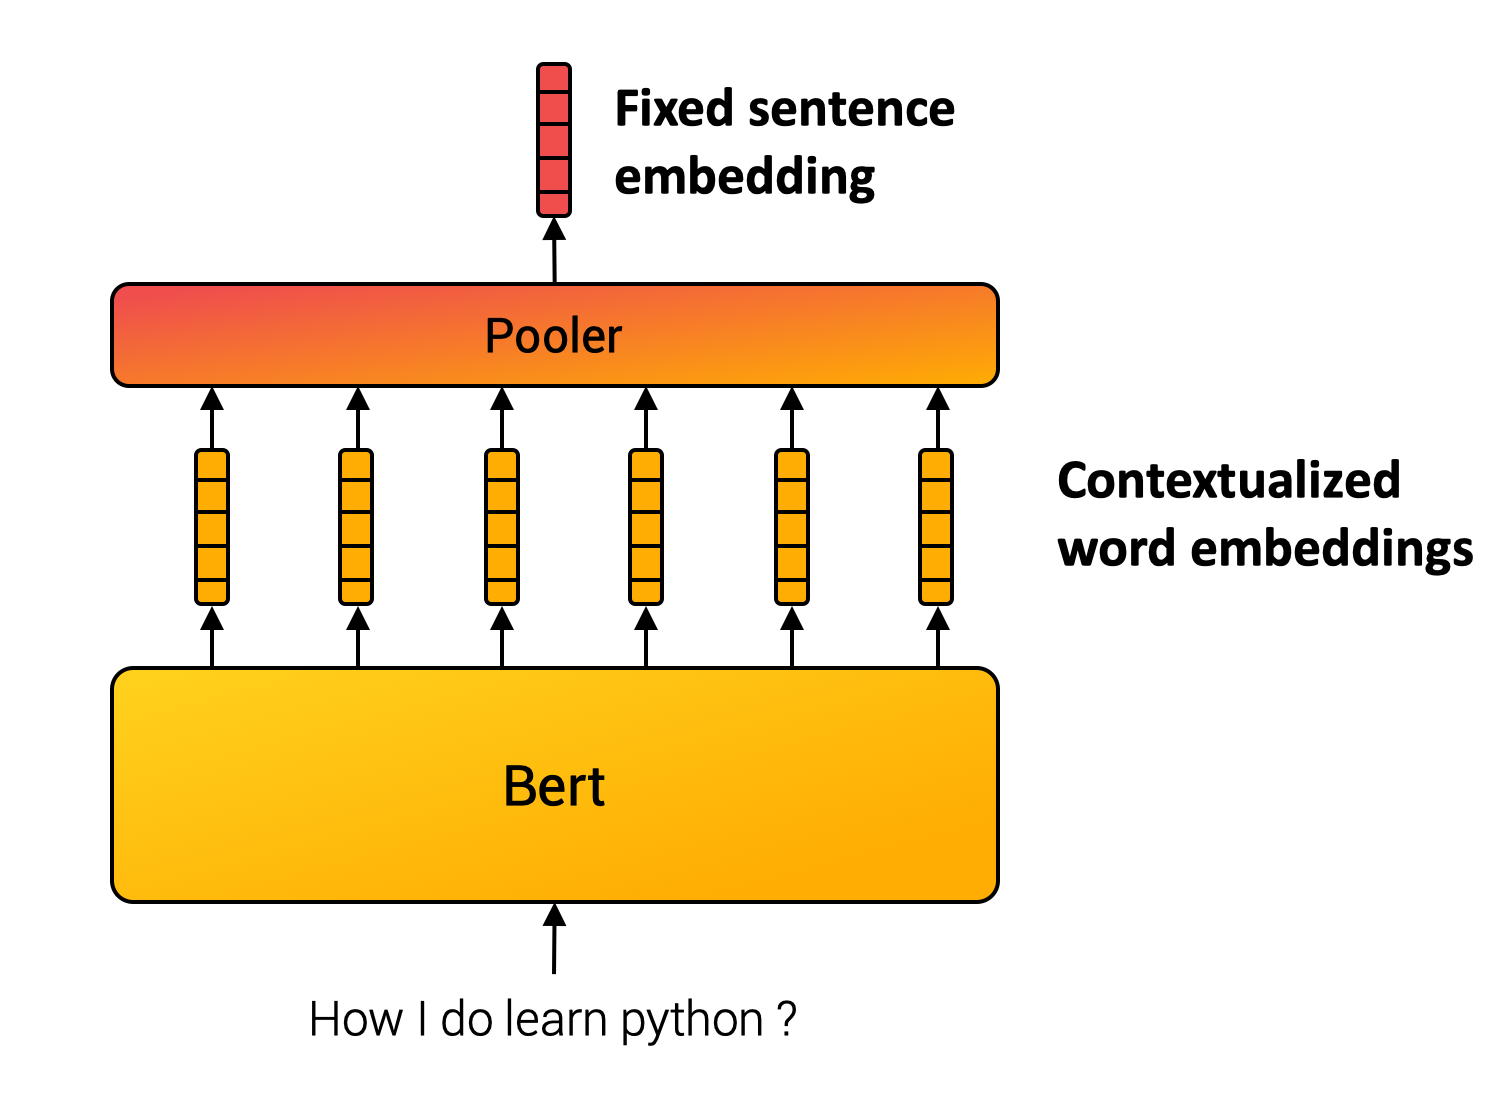
Hugging Face-ის მასშტაბური პროექტი: ხელოვნური ინტელექტის ახალი ეტაპი წინადადებების გაგებაში
Hugging Face-მა, Google-ის JAX/Flax-ის გუნდთან თანამშრომლობით, შეიმუშავა წინადადებების ჩაშენების უახლესი მოდელები პროექტის „Train the Best Sentence Embedding Model Ever with 1B Training Pairs“ ფარგლებში. პროექტი იყენებდა Google-ის 7 TPU v3-8 ერთეულს და ინოვაციურ კონტრასტულ სწავლებას, რათა მსგავსი მნიშვნელობის მქონე წინადადებები ახლო ვექტორებად ასახოს, განსხვავებული მნიშვნელობის მქონე წინადადებები კი – შორეულ ვექტორებად. ეს მიღწევა მნიშვნელოვნად აუმჯობესებს ბუნებრივი ენის დამუშავების (NLP) სისტემ
გაძლიერებითი სწავლის (RL) გამოყენება დიფუზიური მოდელების გასაუმჯობესებლად: DDPO-ს როლი ხელოვნური ინტელექტის მიერ შექმნილი გამოსახულებების ადამიანურ პრეფერენციებთან შესაბამისობაში
სტატია განიხილავს, თუ როგორ ხდება დიფუზიური მოდელების (მაგ. DALL-E 2, Stable Diffusion) ოპტიმიზაცია გაძლიერებითი სწავლის (RL) გამოყენებით, რათა მათ მიერ გენერირებული გამოსახულებები უკეთესად შეესაბამებოდეს ადამიანის პრეფერენციებსა და ესთეტიკას. ის მიმოიხილავს "შესაბამისობის პრობლემას" ხელოვნურ ინტელექტში და წარმოაჩენს Denoising Diffusion Policy Optimization (DDPO) მეთოდს, როგორც ეფექტურ გადაწყვეტას. DDPO, რომელიც იყენებს პოლიტიკის გრადიენტულ მეთოდებს (PPO) და დენოიზინგის პროცესს მარკოვის გადაწყვე

"OlympicCoder": ხელოვნური ინტელექტის ახალი მოდელები კონკურენტულ პროგრამირებაში გიგანტებს აჭარბებენ
მკვლევრებმა შეიმუშავეს ხელოვნური ინტელექტის მოდელების ახალი ნაკრები, სახელწოდებით „OlympicCoder“, რომელიც სპეციალურად კონკურენტული პროგრამირებისთვის არის შექმნილი. CodeForces-ისა და IOI-ის მორგებულ მონაცემთა ბაზებზე გაწვრთნილი OlympicCoder-32B აჩვენებს უმაღლეს დონის შესრულებას, აჯობა ბევრ მნიშვნელოვნად უფრო დიდ, ღია წყაროს მოდელს კოდის მსჯელობის ამოცანებში. ეს მიღწევა უპასუხებს არსებული მონაცემთა ბაზების შეზღუდვებს, სრულად გადამოწმებადი პრობლემური ნაკრებებისა და დეტალური გადაწყვეტილებების მიწოდე
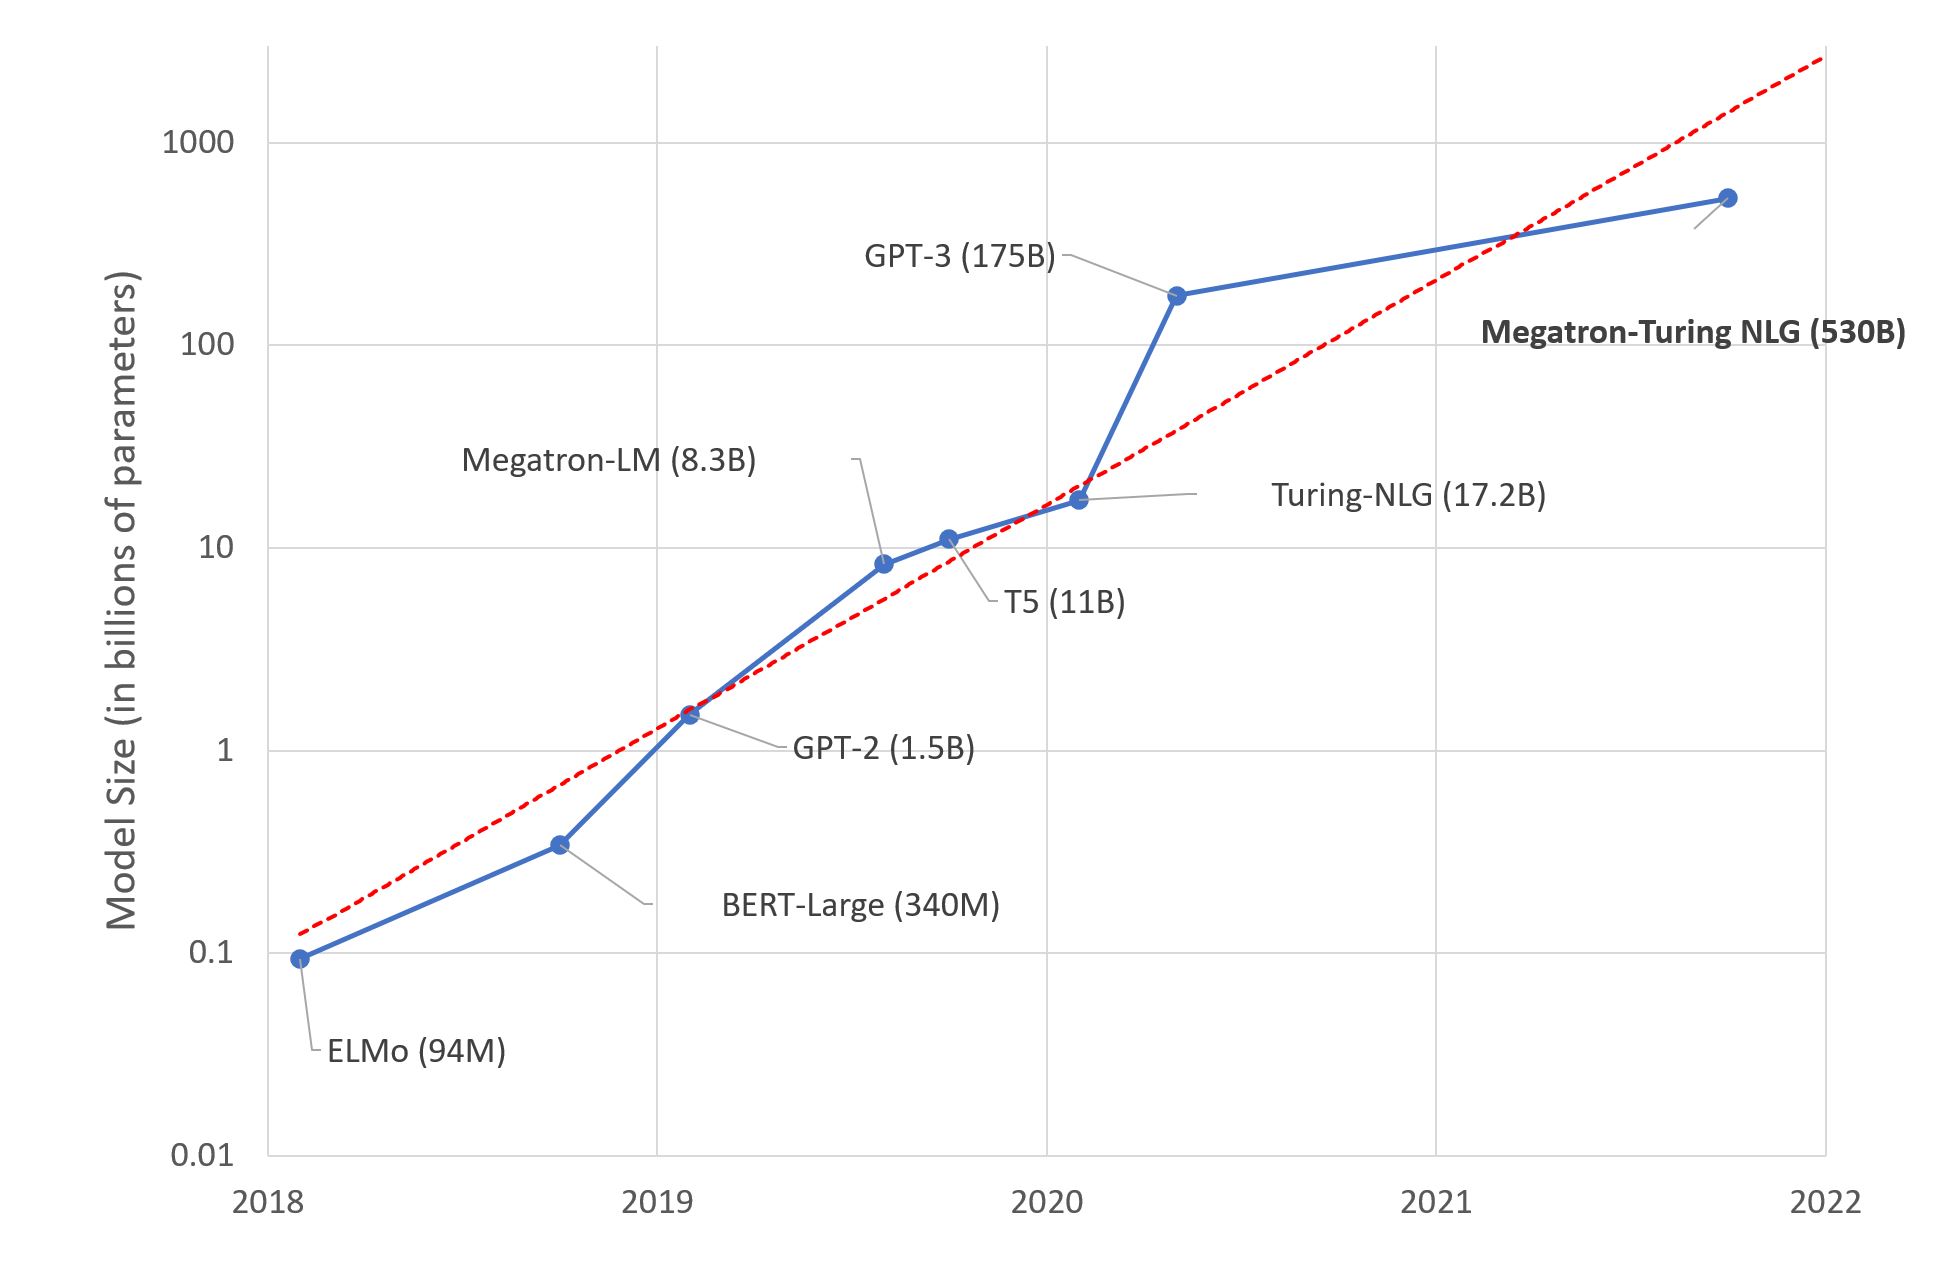
ხელოვნური ინტელექტის მეგა-მოდელები: ღირს კი ეს ხარჯი და ძალისხმევა?
სტატია აანალიზებს ხელოვნური ინტელექტის მეგა-მოდელების ტენდენციას და ეჭვქვეშ აყენებს მათ მიზანშეწონილობას მაღალი დანახარჯების, სირთულისა და გარემოზე ზემოქმედების გამო. ავტორი აღნიშნავს, რომ მიუხედავად ინჟინრული მიღწევებისა, უზარმაზარი მოდელების შექმნა, რომლებიც ადამიანის ტვინის ზომას უახლოვდება, შესაძლოა, გრძელვადიან პერსპექტივაში საუკეთესო მიდგომა არ იყოს. სანაცვლოდ, ის მხარს უჭერს პრაგმატულ გადაწყვეტილებებს, როგორიცაა წინასწარ გაწვრთნილი, უფრო მცირე ზომის მოდელების გამოყენება და მათი დახვეწა (f

Hugging Face-ის მუშაობა ხელოვნური ინტელექტის ეთიკაზე: რეგულაციების ფორმირება და ღიაობის ხელშეწყობა
Hugging Face დეტალურად აღწერს თავის ფართომასშტაბიან მუშაობას ხელოვნური ინტელექტის ეთიკის სფეროში, მათ შორის ევროკავშირის, დიდი ბრიტანეთისა და აშშ-ის კანონმდებლებთან თანამშრომლობას მომავალი რეგულაციების ჩამოსაყალიბებლად. კომპანია ხაზს უსვამს ღიაობის, ანგარიშვალდებულებისა და დემოკრატიზაციისადმი თავის ერთგულებას საჯარო გამოსვლებით, კვლევებითა და ახალი რესურსებით, რითაც ხაზგასმულია ადამიანური ღირებულებების ცენტრალური როლი პასუხისმგებლიანი ხელოვნური ინტელექტის განვითარებაში. ასევე აღინიშნება გუნდის მ

Google-მა Gemma 3 წარადგინა: მულტიმოდალური ხელოვნური ინტელექტის მოდელების ახალი თაობა
Google-მა გამოუშვა Gemma 3, Gemma მოდელების ოჯახის ახალი ვერსია. ეს მოდელები, რომელთა პარამეტრების რაოდენობა 1 მილიარდიდან 27 მილიარდამდე მერყეობს, მხარს უჭერს 140-ზე მეტ ენას, შეუძლია როგორც გამოსახულებების, ისე ტექსტის დამუშავება, აქვს 128k ტოკენამდე კონტექსტური ფანჯარა და ინტეგრირებულია Hugging Face-ის ეკოსისტემასთან. Gemma 3-ის მოდელები, განსაკუთრებით Gemma-3-27B-IT, ეტალონურ ტესტებში აჭარბებს Gemma 2-27B IT-სა და Gemini 1.5-Pro-ს, რაც Google-ის ღია წონის დიდი ენობრივი მოდელების უახლეს მიღწე
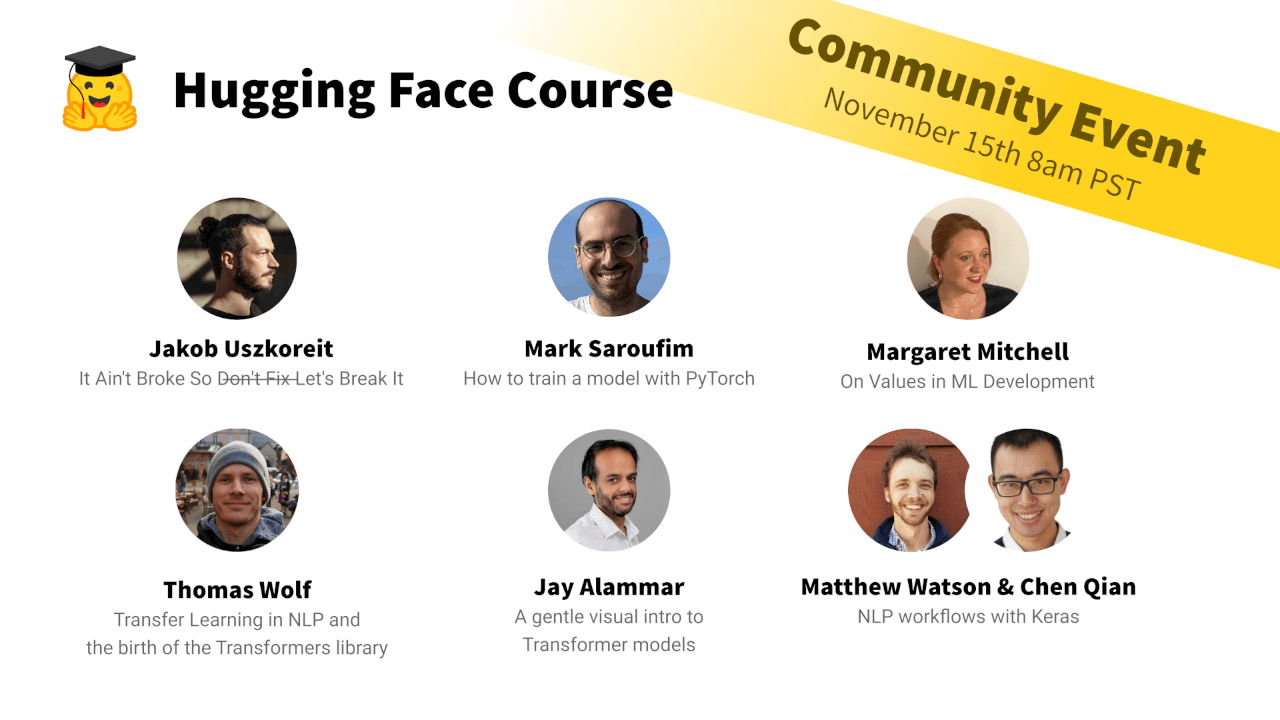
გეპატიჟებით ხელოვნური ინტელექტის საზოგადოებრივ ღონისძიებაზე: წამყვანი ექსპერტების მოხსენებები და პრაქტიკული პროექტები
ამ მასშტაბურ ღონისძიებაზე მონაწილეებს შესაძლებლობა ექნებათ მოუსმინონ ხელოვნური ინტელექტისა და ბუნებრივი ენის დამუშავების (NLP) სფეროს წამყვან ექსპერტებს, მათ შორის HuggingFace-ის თანადამფუძნებელ თომას ვოლფს და ეთიკური AI-ის მკვლევარ მარგარეტ მიტჩელს. ორდღიანი მოხსენებების შემდეგ გაიმართება გუნდური პროექტები მოდელების „დაფაინთუნებაზე“ (fine-tuning), რომელიც დასრულდება ცოცხალი დემონსტრაციებით. AWS აფინანსებს ღონისძიებას Amazon SageMaker-ის მეშვეობით უფასო გამოთვლითი რესურსებით, ხოლო წარმატებული მო

Hugging Face-ის Xet გუნდი: დიდი ნაბიჯი AI მოდელებისა და მონაცემთა საცავების მიგრაციაში
Hugging Face-ის Xet გუნდმა წარმატებით განახორციელა მოდელებისა და მონაცემთა ნაკრებების პირველი საცავების მიგრაცია LFS-დან Xet საცავში. ეს ნაბიჯი, რომელიც Hugging Face-ის Hub-ის ხედვის ნაწილია, მიზნად ისახავს ხელოვნური ინტელექტის დეველოპერებისთვის მასიურ მოდელებსა და მონაცემთა ნაკრებებზე მუშაობის გამარტივებას, უფრო ეფექტურ თანამშრომლობასა და განმეორებითი იტერაციების განხორციელებას. მიგრაციამ Hub-ის ჩამოტვირთვის ტრაფიკის დაახლოებით 6% Xet ინფრასტრუქტურაზე გადაიტანა, რაც ამტკიცებს ახალი სისტემის ეფე
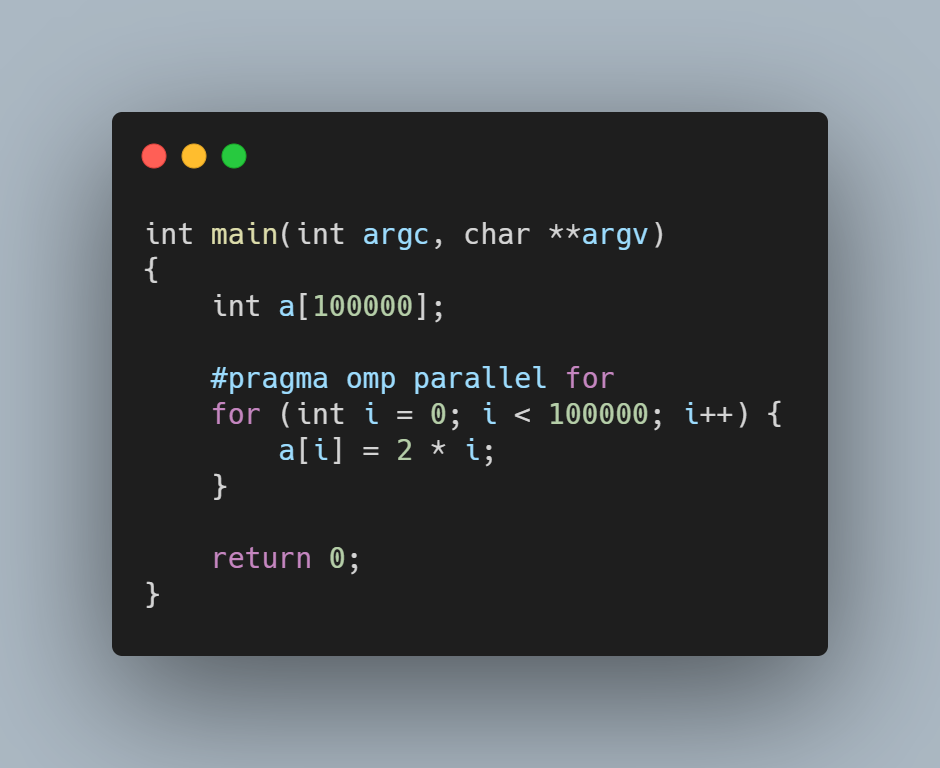
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და
ჩატის მოდელების ეფექტურობის გასაღები: ფორმატის მნიშვნელობა და Jinja შაბლონები
ეს სტატია განმარტავს, თუ რამდენად კრიტიკულია ჩატის ფორმატის შეხამება იმ ფორმატთან, რომელზეც ხელოვნური ინტელექტის მოდელები იყო გაწვრთნილი. არასწორი ფორმატის გამოყენება იწვევს მუშაობის სერიოზულ, ჩუმ გაუარესებას. Hugging Face-ის ტოკენიზატორების ახალი `chat_template` ატრიბუტი, რომელიც Jinja შაბლონებს იყენებს, მიზნად ისახავს ამ პრობლემის გადაჭრას საუბრების სწორად ფორმატირებით, რითაც უზრუნველყოფს მოდელის ოპტიმალურ მუშაობას და ხელს უშლის „განაწილების ცვლილებას“.

NVIDIA-ს რევოლუციური AI სიახლეები: Cosmos Transfer, Physical AI Dataset და Isaac GR00T N1
NVIDIA-მ წარადგინა ხელოვნური ინტელექტის (AI) სამი მნიშვნელოვანი სიახლე: Cosmos Transfer, რომელიც ზრდის ვირტუალური სამყაროს სცენების გენერირების სიზუსტეს; Physical AI Dataset, ღია კოდის მონაცემთა ნაკრები რობოტიკის ვარჯიშისთვის; და Isaac GR00T N1, მსოფლიოში პირველი ღია ფუნდამენტური მოდელი ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს ინოვაციები მიზნად ისახავს ვირტუალური სამყაროების, რობოტიკისა და ავტონომიური სისტემების განვითარებას.
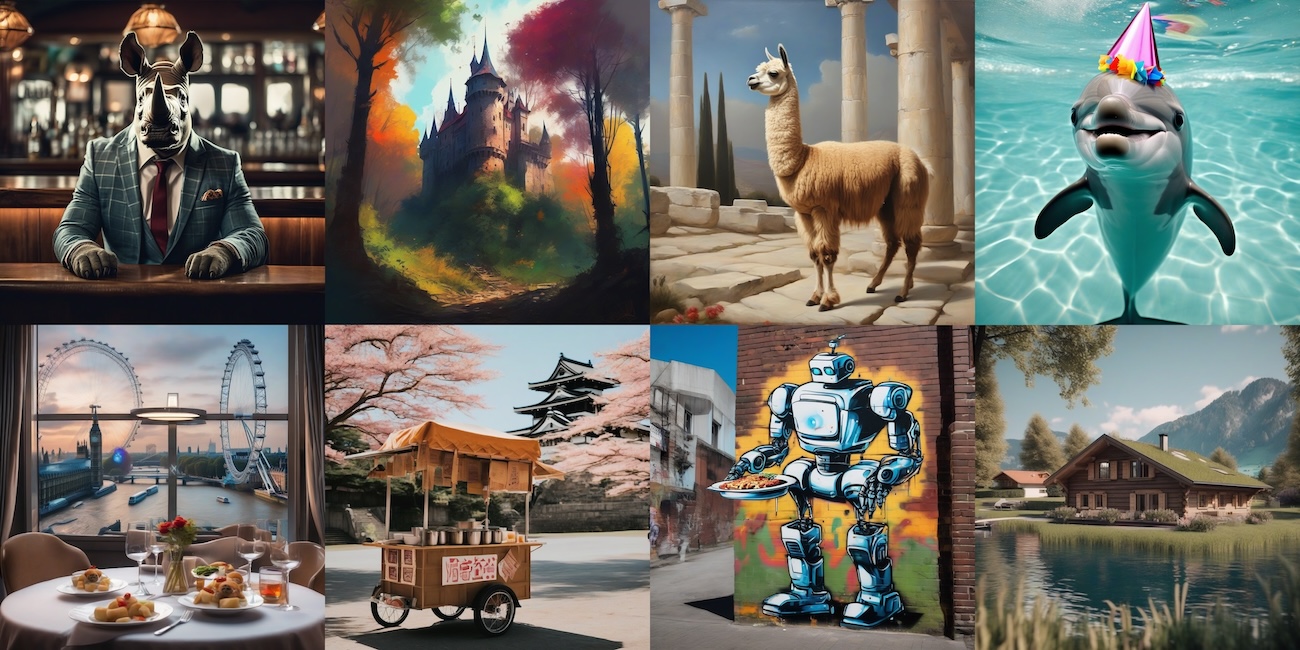
მაღალეფექტური და ხარჯთეფექტური SDXL სერვისინგი JAX-ით Google Cloud TPU v5e-ზე
Google Cloud-ის ახალი TPU v5e, JAX-თან და Diffusers-თან ერთად, შესაძლებელს ხდის დიდი ხელოვნური ინტელექტის მოდელების, მაგალითად SDXL-ის, მაღალპროდუქტიულ და ხარჯთეფექტურ ტრეინინგსა და ინფერენსს. სტატია მიმოიხილავს, თუ როგორ ხდის JIT კომპილაცია და XLA-ზე დაფუძნებული პარალელიზაცია მასშტაბურ გენერაციულ AI-ს ხელმისაწვდომსა და ეფექტურს, წარმოადგენს დემოს და განმარტავს ამ ტექნოლოგიების გამოყენების დეტალებს.
ხელოვნური ინტელექტის ღია მიდგომების წარმატება: რატომ არის ის სასიცოცხლოდ მნიშვნელოვანი?
ხელოვნური ინტელექტის (AI) განვითარებაში ღია მიდგომები არამხოლოდ უფრო გამჭვირვალე, ადაპტირებადი და მეცნიერულად დასაბუთებულია, არამედ მუდმივად აჭარბებს კომერციული შეთავაზებების წარმადობას. უახლესი მაგალითები, როგორიცაა OlympicCoder-ისა და OLMo 2-ის წარმატებები, ადასტურებს, რომ მძლავრი AI სტრატეგია ღია და კოლაბორაციულ განვითარებას უნდა ეფუძნებოდეს, რათა ხელი შეუწყოს ტექნოლოგიის წარმადობას, დანერგვასა და უსაფრთხოებას. სტატია გვთავაზობს სამ ძირითად რეკომენდაციას AI-ის ტექნიკური და ეკონომიკური წარმატე

ღია კოდის რევოლუცია კოდირების AI-ში: OlympicCoder 7B აჯობებს წამყვან მოდელებს და მისი ინტეგრაცია IDE-ში
ეს სტატია იკვლევს ღია კოდის ხელოვნური ინტელექტის მოდელების მზარდ პოტენციალს კოდირების ასისტენტების სფეროში, განსაკუთრებით ხაზს უსვამს OlympicCoder 7B-ს. LiveCodeBench-ის შეფასებების მიხედვით, ეს 7B პარამეტრის მქონე ვარიანტი აღემატება ისეთ პოპულარულ მოდელებს, როგორიცაა Claude 3.7 Sonnet და GPT-4o. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ მოდელების, კერძოდ OlympicCoder 7B-ის, ინტეგრირება ინტეგრირებულ განვითარების გარემოში (IDE), როგორიცაა VSCode, LM Studio-ს გამოყენებით ოპტიმალური ლოკალური ინ
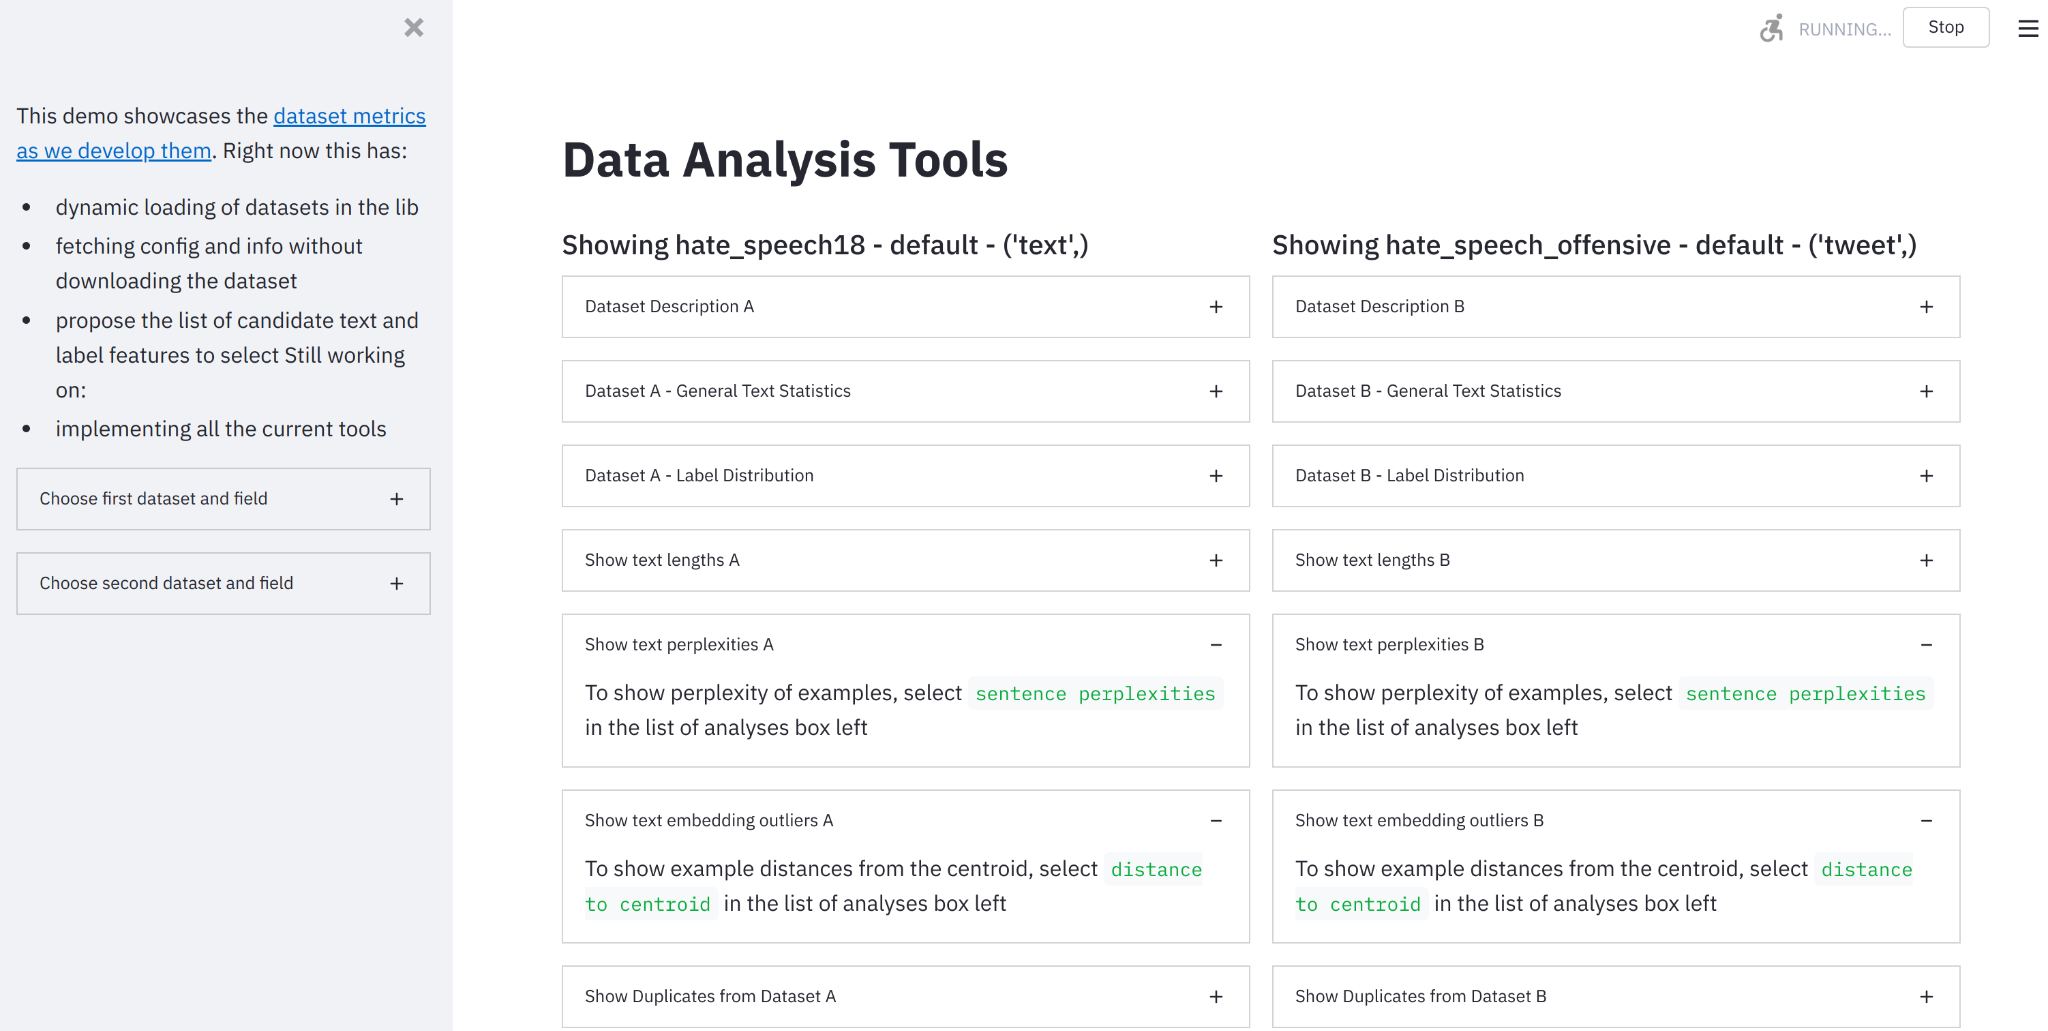
Hugging Face წარმოგიდგენთ მონაცემთა გაზომვის ხელსაწყოს AI მონაცემთა პასუხისმგებლიანი განვითარებისთვის
Hugging Face-ის გუნდმა გამოუშვა ღია კოდის Python ბიბლიოთეკა და უკოდო ინტერფეისი, სახელწოდებით „მონაცემთა გაზომვის ხელსაწყო“ (Data Measurements Tool - DMT). ეს ინსტრუმენტი მიზნად ისახავს მანქანური სწავლების მონაცემთა ნაკრებების გაგებას, შექმნას, კურირებასა და შედარებას. DMT პასუხობს ხელოვნური ინტელექტის განვითარებაში მონაცემთა გააზრებული ანალიზის ხარვეზს, განსაკუთრებით „დიდი მონაცემების“ გამოყენებისას არსებულ მიკერძოებებსა და ხარვეზებს. ის მომხმარებლებს საშუალებას აძლევს ავტომატურად გამოთვალონ მნ
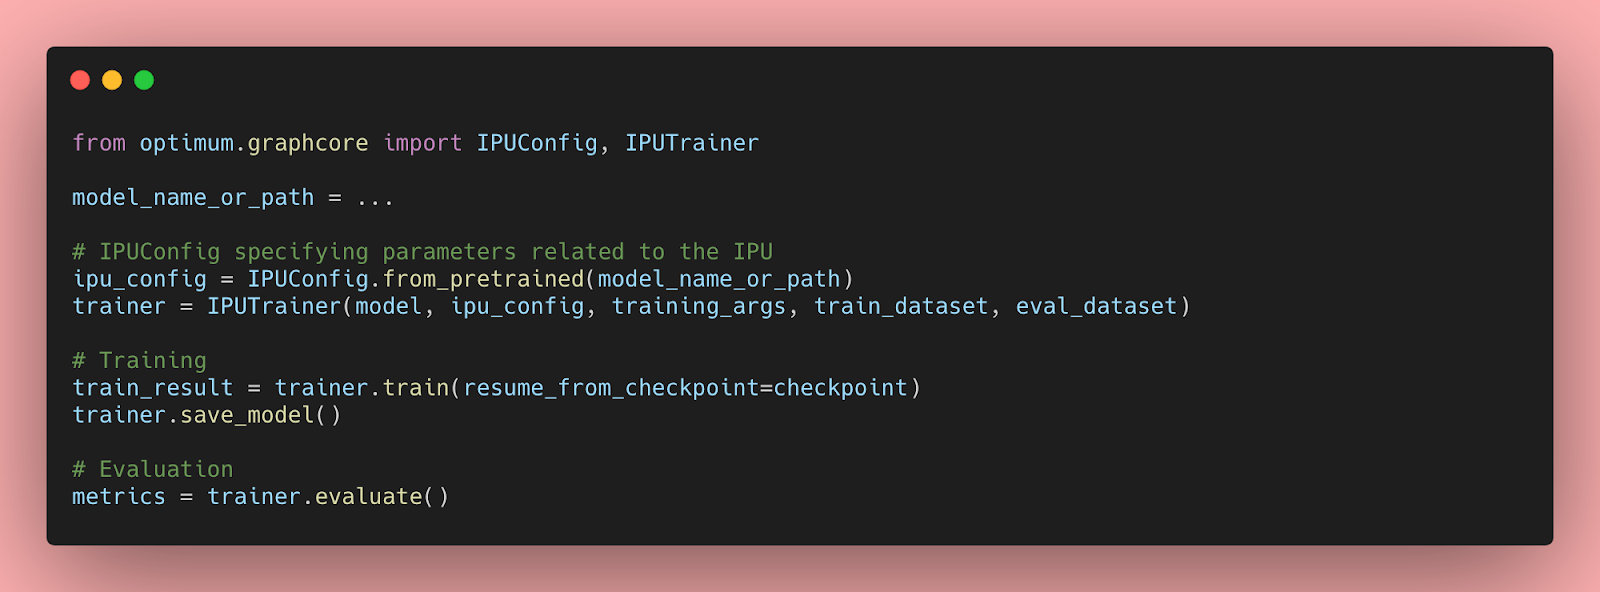
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
Perceiver: ტრანსფორმერის არქიტექტურის შეზღუდვების დაძლევა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს Transformer-ის მოდელის რევოლუციურ ზეგავლენას ხელოვნური ინტელექტის (AI) სფეროზე, თუმცა ხაზს უსვამს მის მნიშვნელოვან შეზღუდვას: თვითყურადღების მექანიზმის გამო, ის ცუდად მასშტაბირდება მაღალი განზომილების მონაცემებთან. სტატია წარმოგიდგენთ Perceiver-ის არქიტექტურას, როგორც ამ პრობლემის გადაჭრის საშუალებას. Perceiver იყენებს ლატენტურ ცვლადებსა და ჯვარედინ ყურადღებას, რაც უზრუნველყოფს ხაზოვან დამოკიდებულებას შეყვანის ზომაზე და საშუალებას აძლევს მას ეფექტურად იმუშაოს მრავალფეროვან მ
Hugging Face-ი Gradio-ს იძენს: მანქანური სწავლის ხელმისაწვდომობის ახალი ეტაპი
მანქანური სწავლის სტარტაპ Gradio-ს Hugging Face-ის მიერ შეძენა მნიშვნელოვანი ნაბიჯია ხელოვნური ინტელექტის დემოკრატიზაციისკენ. ეს შერწყმა საშუალებას მისცემს დეველოპერებს, მონაცემთა მეცნიერებს და არატექნიკურ მომხმარებლებს, უფრო მარტივად შექმნან, გააზიარონ, გამოიყენონ და შეაფასონ მანქანური სწავლის მოდელები. გაერთიანებული ძალებით, Hugging Face და Gradio ისახავენ მიზნად, რომ ხელოვნური ინტელექტი ხელმისაწვდომი გახადონ ყველასთვის, ვისაც ინტერნეტთან წვდომა აქვს, რაც კიდევ უფრო გააფართოვებს ინოვაციების შე
კოდის გენერაციის მოდელების პერსონალიზაცია: HugCoder-ის შექმნა და თქვენი საკუთარი Copilot-ის შესაძლებლობები
მიუხედავად იმისა, რომ წინასწარ გაწვრთნილი ხელოვნური ინტელექტის მოდელები შთამბეჭდავად მუშაობენ სხვადასხვა ამოცანებში, მომავალი შესაძლებლობა მდგომარეობს კოდის გენერაციის მოდელების კონკრეტულ საჭიროებებზე მორგებაში, რაც ქმნის პერსონალიზებულ კოდირების ასისტენტებს საწარმოო მასშტაბით. ეს ბლოგ-პოსტი წარმოგიდგენთ HugCoder-ს – კოდის დიდ ენობრივ მოდელს (LLM), რომელიც დამატებით გაიწრთვნა Hugging Face-ის GitHub-ის საჯარო რეპოზიტორიებიდან შეგროვებულ კოდის შიგთავსზე. დეტალურად განვიხილავთ მონაცემთა შეგროვების,
AutoNLP და Prodigy: ხელოვნური ინტელექტის მოდელების სწრაფი და ეფექტური შექმნა
სტატია მიმოიხილავს Hugging Face-ის AutoNLP-სა და Explosion-ის Prodigy-ს, ორ მძლავრ ინსტრუმენტს ღრმა სწავლის მოდელების შესაქმნელად და მონაცემთა ანოტაციისთვის. აღწერილია, თუ როგორ ამარტივებს AutoNLP უახლესი ტრანსფორმატორის მოდელების წვრთნას სხვადასხვა ბუნებრივი ენის დამუშავების ამოცანებისთვის (კლასიფიკაცია, სახელობითი ერთეულების ამოცნობა) მინიმალური კოდირებით. Prodigy წარმოდგენილია როგორც მოქნილი, რეალურ დროში ანოტაციის ინსტრუმენტი, რომელიც მხარს უჭერს ბუნებრივი ენის დამუშავების, კომპიუტერული მხედ

Hugging Face-ის სასწავლო პლატფორმის მასშტაბური განახლება: NLP კურსი ახლა LLM კურსია
Hugging Face აცხადებს hf.co/learn პლატფორმის მასშტაბურ განახლებას, რომლის ფარგლებშიც პოპულარული NLP კურსი LLM კურსად გარდაიქმნა. ეს ცვლილება ასახავს ხელოვნური ინტელექტის სფეროში მიმდინარე სწრაფ განვითარებას, ამატებს ახალ თავებს დიდი ენობრივი მოდელების დახვეწასა და მსჯელობის მოდელების შექმნაზე, აფართოებს საზოგადოებასთან თანამშრომლობას და გეგმავს სერტიფიცირების პროგრამას მომავალში.