Hugging Face Datasets: ახალი შესაძლებლობები აუდიო და გამოსახულების მონაცემებთან მუშაობისთვის
Hugging Face Datasets ბიბლიოთეკა აფართოებს თავის მხარდაჭერას ტექსტური მონაცემთა ნაკრებების მიღმა, რათა მოიცვას აუდიო და გამოსახულების ფორმატები. განახლებები მოიცავს ახალ ინსტრუმენტებს, როგორიცაა ImageFolder გამოსახულების მონაცემთა ნაკრებების მარტივად ჩატვირთვისა და მართვისთვის, to_tf_dataset ფუნქცია TensorFlow-თან ინტეგრაციის გასამარტივებლად და გაუმჯობესებულ დოკუმენტაციას სხვადასხვა მონაცემთა მოდალობასთან მუშაობისთვის. ეს ცვლილებები მიზნად ისახავს დეველოპერებისთვის მოდელების გაწვრთნისა და აპლიკა

SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
AI-ის რევოლუცია მონაცემებთან ურთიერთობაში: DuckDB-NSQL-7B და ტექსტიდან SQL-ზე გადასვლა
ხელოვნური ინტელექტის (AI) და დიდი ენობრივი მოდელების (LLM) განვითარება რევოლუციას ახდენს მონაცემთა ანალიზში. ტრადიციულად, SQL ქუერების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, რაც ხელმისაწვდომობის ხარვეზს ქმნიდა. MotherDuck-მა და Numbers Station-მა წარმოადგინეს DuckDB-NSQL-7B, LLM, რომელიც სპეციალურად DuckDB SQL-ისთვისაა შექმნილი. ეს მოდელი მომხმარებლებს საშუალებას აძლევს, ბუნებრივი ენით ჩამოაყალიბონ მონაცემთა მოთხოვნები, რომლებსაც მოდელი ავტომატურად თარგმნის SQL ბრძანებებში. სტატიაში დეტალურად არ

ეტინი: უახლესი ენკოდერ-დეკოდერ მოდელები, რომლებიც Llama 3.2 1B-ს და SmolLM2-ს აღემატებიან
რა მოხდებოდა, ModernBERT-ის რეცეპტი მხოლოდ დეკოდერის მოდელზე რომ გამოგვეყენებინა? აღმოჩნდა, რომ შეიქმნებოდა უახლესი დეკოდერული ენის მოდელი, რომელიც Llama 3.2 1B-სა და SmolLM2-ს ჯობნის. ჩვენ წარმოგიდგენთ Ettin-ს, უახლესი, დაწყვილებული მხოლოდ-ენკოდერისა და მხოლოდ-დეკოდერის მოდელების პირველ სერიას (17M-1B პარამეტრი), რომლებიც გაწვრთნილია იდენტური მონაცემებით (2T ტოკენი), არქიტექტურითა და წვრთნის რეცეპტებით. Ettin შესაძლებელს ხდის არქიტექტურებს შორის სამართლიან შედარებებს და უზრუნველყოფს უმაღლეს შეს
Hugging Face Hub: მანქანური სწავლების პროექტების დაჩქარება და კოლაბორაცია
სტატია განიხილავს მანქანური სწავლების (ML) განვითარების გამოწვევებს, როგორიცაა მოდელების პროდუქტიულ ფაზაში ვერ გადასვლა და თანამშრომლობის სირთულეები. წარმოდგენილია Private Hub-ისა და განსაკუთრებით Hugging Face Hub-ის როლი, როგორც ამ პრობლემების გადაწყვეტა. Hugging Face Hub გთავაზობთ ღია წყაროს პლატფორმას მოდელების, მონაცემთა ნაკრებებისა და აპლიკაციების ფართო კოლექციით, Git-ზე დაფუძნებულ რეპოზიტორიებსა და თანამშრომლობით ხელსაწყოებს ML სამუშაო პროცესების დასაჩქარებლად, კვლევიდან დაწყებული წარმოება
Google-მა CodeGemma - კოდზე ორიენტირებული დიდი ენობრივი მოდელები - გამოუშვა
Google-მა გამოუშვა CodeGemma, კოდზე სპეციალიზებული დიდი ენობრივი მოდელების (LLM) ოჯახი, რომელიც ეფუძნება 2B და 7B Gemma მოდელებს. ის ხელმისაწვდომია Hugging Face Hub-ზე სამ ვერსიად – CodeGemma 2B, CodeGemma 7B და CodeGemma 7B Instruct – და გამიზნულია კოდის შევსების, გენერაციისა და გაგების ამოცანებისთვის, ასევე მათემატიკური და ლოგიკური მსჯელობის გასაუმჯობესებლად. მოდელები გაწვრთნილია დამატებით 500 მილიარდ ტოკენზე და აჩვენებენ მაღალ წარმადობას კოდის შეფასების პოპულარულ ბენჩმარკებზე, როგორიცაა Human

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.
Google Cloud-ი და Hugging Face-ი გენერაციული AI მოდელების განთავსებას ამარტივებენ
Google Cloud-მა და Hugging Face-მა გამოუშვეს ახალი ფუნქცია „Deploy on Google Cloud“, რომელიც დეველოპერებს საშუალებას აძლევს, შექმნან საწარმოო მზადყოფნის გენერაციული ხელოვნური ინტელექტის (AI) აპლიკაციები ინფრასტრუქტურის მართვის გარეშე, პირდაპირ მათ უსაფრთხო Google Cloud გარემოში. ეს გაფართოება Google-ის მომხმარებლებისთვის ღია გენერაციული AI მოდელებზე წვდომასა და მათ განთავსებას ამარტივებს, Vertex AI-სა და GKE-ზე 1-კლიკით განთავსების გამოცდილებას სთავაზობს.

Consilium: ხელოვნური ინტელექტის მოდელების თანამშრომლობა კონსენსუსისთვის
Consilium წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დიდ ენობრივ მოდელებს (LLM) აძლევს საშუალებას, მიაღწიონ კონსენსუსს დისკუსიის გზით. ჰაკათონის ფარგლებში შექმნილი პროექტი აერთიანებს Gradio ინტერფეისს და MCP სერვერს, რაც LLM-ებს საშუალებას აძლევს ითანამშრომლონ, შექმნან დასაბუთებული პასუხები და მიიღონ გადაწყვეტილებები. პლატფორმა ვიზუალურად წარმოადგენს მრგვალ მაგიდას, სადაც მოდელები დისკუსიას აწარმოებენ, ხოლო Microsoft-ის AI Diagnostic Orchestrator-ის მიერ მიღწეული შედეგები ადასტურებს, რომ მრავალი
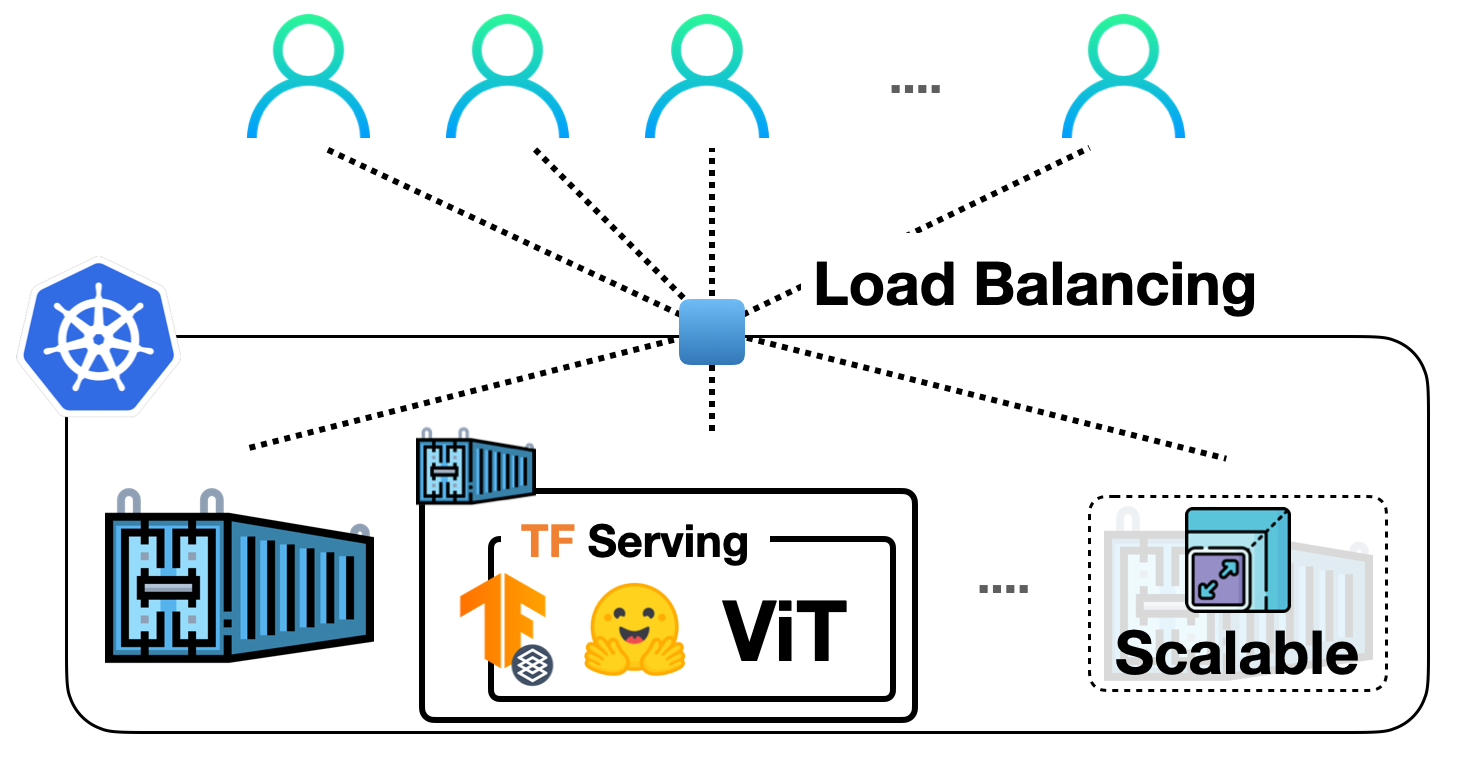
ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr
ხედვითი ენის მოდელები: შესაძლებლობები, შეფასება და სწავლება
ხედვითი ენის მოდელები (VLM) არის ხელოვნური ინტელექტის მოდელები, რომლებსაც შეუძლიათ ერთდროულად ისწავლონ გამოსახულებებიდან და ტექსტებიდან, რაც მათ საშუალებას აძლევს შეასრულონ მრავალი დავალება, როგორიცაა ვიზუალურ კითხვებზე პასუხის გაცემა და გამოსახულების აღწერა. ისინი გენერაციული მოდელებია, რომლებიც იღებენ გამოსახულებისა და ტექსტის შეტანას და წარმოქმნიან ტექსტურ გამოსავალს. ამ მოდელებს გააჩნიათ კარგი „ნულოვანი-კადრის“ (zero-shot) შესაძლებლობები და გამოიყენება გამოსახულებებზე საუბრისთვის, დოკუმენტებ
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
Hugging Face-ის ტრანსფორმატორები TensorFlow-ის ინჟინრებისთვის: გზამკვლევი
სტატია განიხილავს PyTorch-ის ინჟინრების მიერ TensorFlow-თან მიდგომის ხშირ შეცდომას, კერძოდ, Keras-ის მაღალი დონის API-ის უგულებელყოფას. ხაზგასმულია, რომ Keras-ის გამოყენება TensorFlow-სთან ოპტიმალურია. შემდეგ წარმოდგენილია Hugging Face-ის ტრანსფორმატორები, როგორც ძლიერი ინსტრუმენტები, რომლებიც TensorFlow-ის ინჟინრებს საშუალებას აძლევს, გამოიყენონ უახლესი მოდელები ნაცნობი Keras API-ის მეშვეობით. დეტალურად არის ახსნილი ტრანსფერული სწავლის (transfer learning) კონცეფცია, როგორც ML პრობლემების გადაჭრ

NVIDIA NIM ამარტივებს ხელოვნური ინტელექტის მოდელების, მათ შორის LLM-ების განთავსებას
NVIDIA NIM ინფერენციის მიკროსერვისები მომხმარებლებსა და პარტნიორებს საშუალებას აძლევს, გამარტივებული მიდგომით, სწრაფად და საიმედოდ განათავსონ ხელოვნური ინტელექტის უახლესი მოდელები, განსაკუთრებით დიდი ენობრივი მოდელები (LLM). ის მხარს უჭერს 100 000-ზე მეტ LLM-ს Hugging Face-ზე, მუშაობს ერთ Docker კონტეინერში და უზრუნველყოფს ავტომატურ ოპტიმიზაციას კონფიგურაციის გარეშე. ეს სისტემა მიზნად ისახავს AI ინოვაციების დაჩქარებას NVIDIA-ს აჩქარებულ ინფრასტრუქტურაზე, რაც დეველოპერებსა და საწარმოებს ეხმარება
Hugging Face-მა ახალი ბიბლიოთეკა Skops წარადგინა: scikit-learn მოდელების ჰოსტინგი და თანამშრომლობა გაუმჯობესდა
Hugging Face-მა წარმოადგინა Skops, ახალი ბიბლიოთეკა, რომელიც შექმნილია scikit-learn მოდელების Hugging Face Hub-ზე განთავსების პროცესის გასამარტივებლად. Skops უზრუნველყოფს მოდელების უსაფრთხო ჰოსტინგს, დოკუმენტაციას მოდელის ბარათების მეშვეობით და გაუმჯობესებულ თანამშრომლობას, რითაც ღია კოდის მანქანური სწავლების პროექტებისთვის რეპროდუცირებადობა და ახსნადობა უფრო ხელმისაწვდომი ხდება.
ენის დიდი მოდელების ოპტიმიზაცია: Hugging Face-ის LLM.int8() ინტეგრაცია
ენის დიდი მოდელები (LLM) მუდმივად იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა, BigScience-თან თანამშრომლობით, წარმოადგინა LLM.int8() ინტეგრაცია, რომელიც საშუალებას აძლევს ამ მასშტაბურ მოდელებს იმუშაონ ნაკლებ GPU-ზე, მეხსიერების მოხმარების 2-ჯერ შემცირებით, პროგნოზირების სიზუსტის შენარჩუნებით. სტატია დეტალურად განიხილავს ამ ტექნოლოგიას და სხვადასხვა მცოცავწერტილიანი მონაცემთა ტიპებს, რომლებიც მოდელის ზომასა და მუშაობაზე ახდენენ გავლენას.
LLM.int8(): როგორ გავხადოთ გიგანტური ენის მოდელები უფრო ხელმისაწვდომი
თანამედროვე ენის მოდელები სულ უფრო იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა და BigScience-მა წარმოადგინეს LLM.int8() ინტეგრაცია, რომელიც მოდელების პროგნოზირების ხარისხის შენარჩუნებით ამცირებს მათ მეხსიერების მოხმარებას 2-ჯერ. სტატია დეტალურად განმარტავს ამ კვანტიზაციის ტექნოლოგიას, მონაცემთა სხვადასხვა ტიპის სიზუსტესა და პარტნიორობის სამომავლო მიზნებს.
Zama-ს Concrete ML: კონფიდენციალურობის დაცვა მანქანურ სწავლებაში Hugging Face-ზე
თვრამეტი თვის წინ Zama-მ შექმნა Concrete ML – მანქანური სწავლების ფრეიმვორკი, რომელიც უზრუნველყოფს მონაცემთა კონფიდენციალურობას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით. ეს კრიპტოგრაფიული ინსტრუმენტი შესაძლებელს ხდის პირდაპირ გამოთვლებს დაშიფრულ მონაცემებზე პირადი გასაღების ცოდნის გარეშე. დღეიდან, Zama-ს წინასწარ კომპილირებული FHE-თან თავსებადი მოდელები ხელმისაწვდომია Hugging Face Endpoints-ზე, რაც მომხმარებლებს საშუალებას აძლევს, ერთი დაწკაპუნებით განათავსონ და გამოიყენონ კონფიდენციალურობ

TimeScope: ახალი ბენჩმარკი ხელოვნური ინტელექტის გრძელი ვიდეოების აღქმის სიღრმის შესამოწმებლად
TimeScope არის ახალი ღია კოდის ბენჩმარკი, რომელიც შექმნილია იმის შესაფასებლად, თუ რამდენად კარგად ესმით ვიზუალურ-ლინგვისტურ მოდელებს გრძელი ვიდეოები. ის ვიდეოებში (1 წუთიდან 8 საათამდე) მოკლე „ნემსის“ კლიპების ჩართვით აფასებს მოდელების უნარს არა მხოლოდ ინფორმაციის მოძიებაში, არამედ მის სინთეზში, ლოკალიზაციასა და წვრილმარცვლოვან მოძრაობის ანალიზში, რითაც არსებულ ტესტებში არსებულ ხარვეზებს ავსებს და AI-ს გრძელი ვიდეოების გაგების ნამდვილ შესაძლებლობებს ავლენს.

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.
LiveCodeBench: ხელოვნური ინტელექტის პროგრამირების აგენტების შეფასების ინოვაციური სისტემა კონტამინაციის პრევენციით
LiveCodeBench არის პლატფორმა, რომელიც აგროვებს კოდირების ამოცანებს სხვადასხვა კონკურსის პლატფორმებიდან და აღნიშნავს მათ გამოშვების თარიღებს. ეს საშუალებას იძლევა მოდელების შეფასებას დროთა განმავლობაში, რაც ხელს უშლის მონაცემთა დაბინძურებას (კონტამინაციას). სტანდარტული კოდის გენერაციის გარდა, LiveCodeBench ასევე აფასებს თვითშეკეთებას, ტესტის შედეგის პროგნოზირებას და კოდის შესრულებას, რაც ჰოლისტურ ხედვას იძლევა AI პროგრამირების აგენტების შესაძლებლობებზე. ამოცანები LeetCode-დან, AtCoder-იდან და Cod
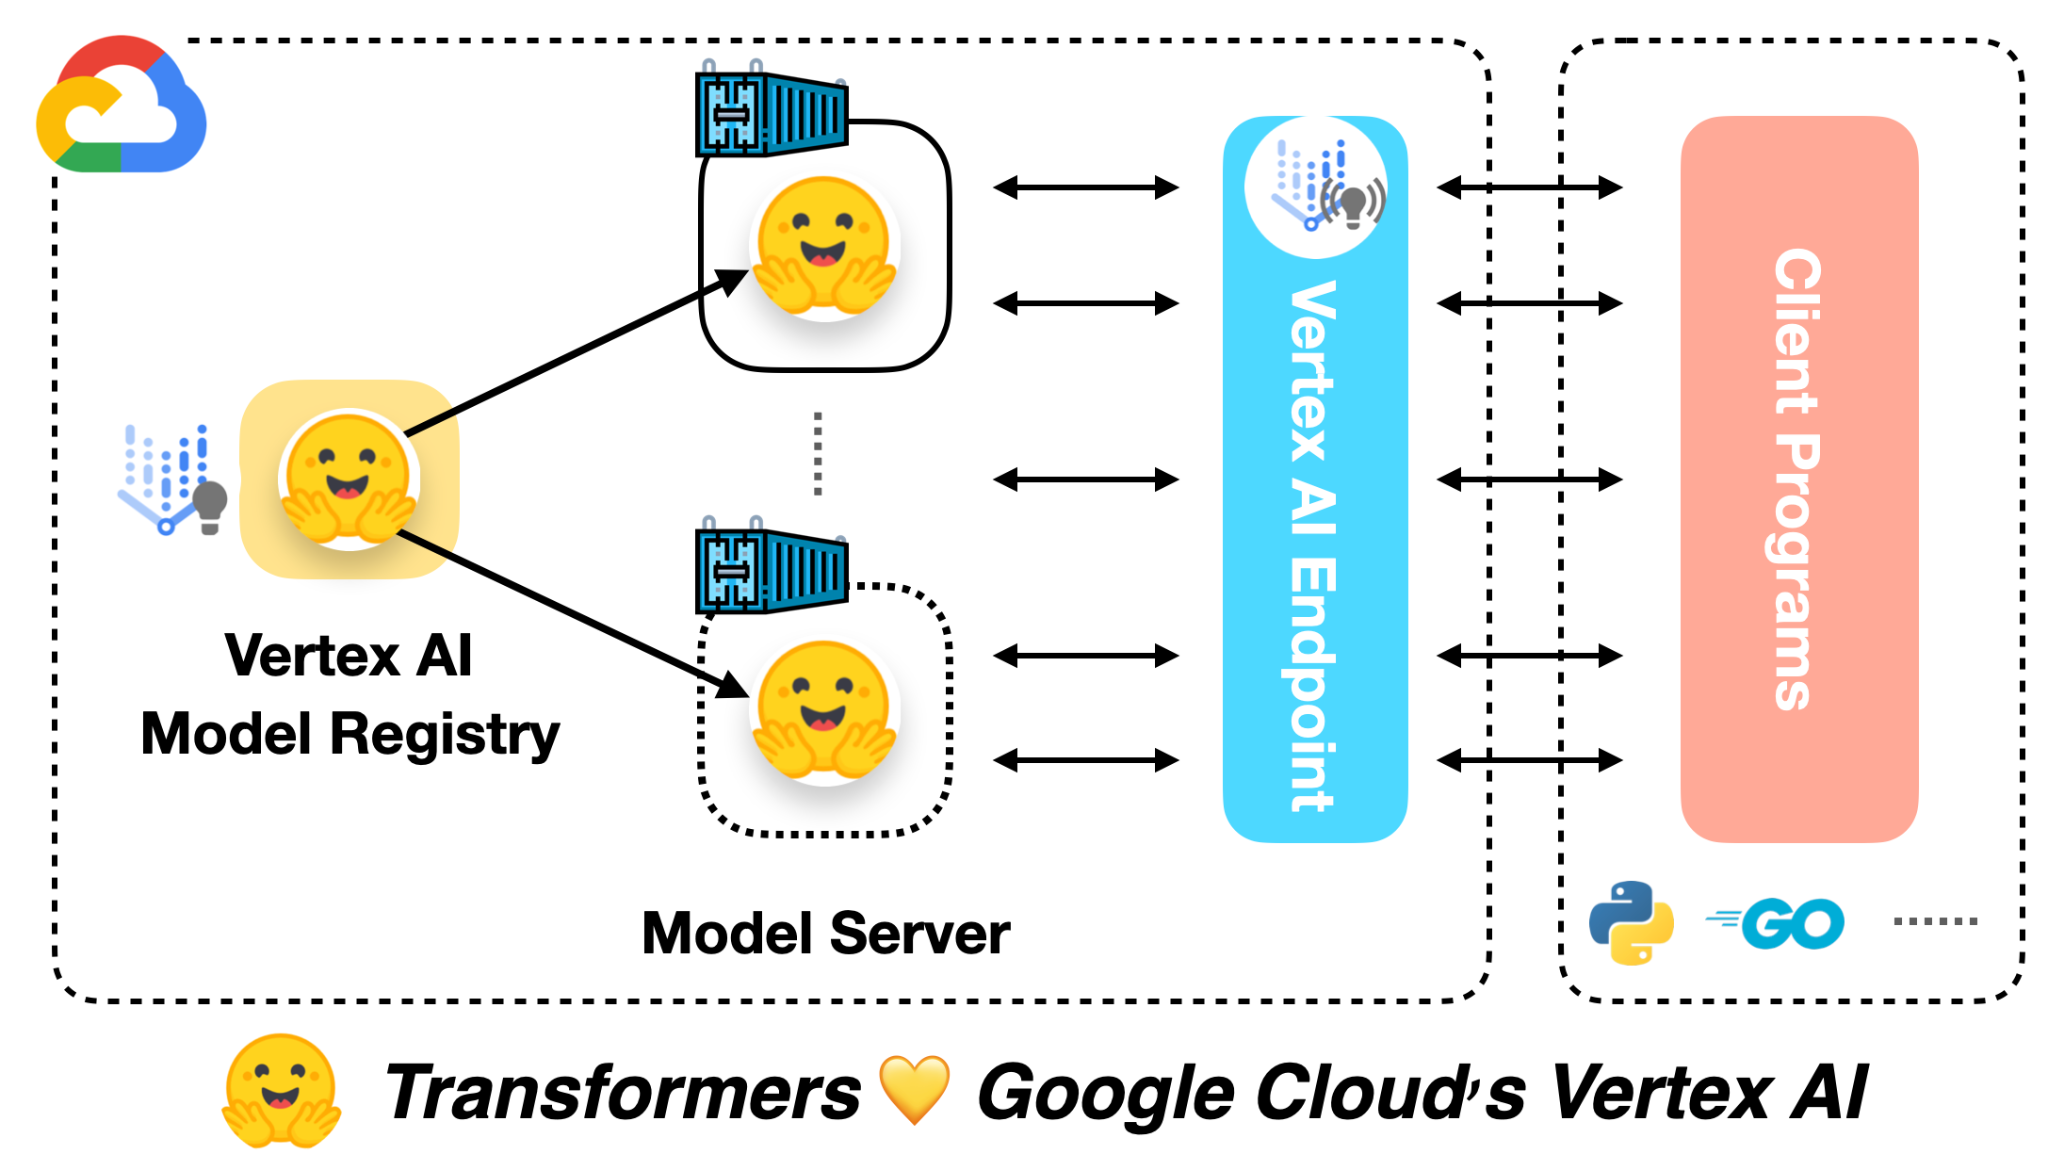
Vertex AI-ის გამოყენება ML მოდელების განლაგებისთვის: დეტალური მიმოხილვა
ეს პუბლიკაცია განიხილავს Google Cloud-ის Vertex AI პლატფორმის შესაძლებლობებს მანქანური სწავლის (ML) მოდელების განლაგებისთვის. ის მოიცავს ისეთ ფუნქციებს, როგორიცაა აუთენტიფიკაცია, ავტომატური სკალირება, მოდელის ვერსიონირება და მონიტორინგი, ასევე TensorFlow მოდელებთან მუშაობის სპეციფიკას. განმარტებულია Vertex AI Model Registry-ის და Endpoint-ის როლი, და მოცემულია განლაგების ნაბიჯ-ნაბიჯ ინსტრუქცია Python SDK-ის გამოყენებით.

Hugging Face-ის Trackio: ახალი ღია კოდის გადაწყვეტა მანქანური სწავლის ექსპერიმენტების თრექინგისთვის
Trackio არის Hugging Face-ის მიერ შემუშავებული ღია კოდის Python ბიბლიოთეკა მანქანური სწავლის მოდელების ვარჯიშის პროგრესის თრექინგისთვის. ის გვთავაზობს მარტივ გაზიარებას, მონაცემთა ხელმისაწვდომობას, ენერგიის მოხმარების გამჭვირვალობას და მოქნილობას ექსპერიმენტებისთვის. ბიბლიოთეკა, რომელიც თავსებადია ისეთ ინსტრუმენტებთან, როგორიცაა wandb, საშუალებას გაძლევთ ადვილად ვიზუალიზაცია მოახდინოთ Gradio დაფაზე და სინქრონიზაცია გაუკეთოთ Hugging Face Spaces-ს.