
ინდოეთი ChatGPT-ის უდიდეს ბაზრებს შორის: 100 მილიონი ყოველკვირეული აქტიური მომხმარებელი
OpenAI-ის აღმასრულებელმა დირექტორმა სემ ალტმანმა განაცხადა, რომ ინდოეთს ჰყავს 100 მილიონი ყოველკვირეული აქტიური ChatGPT მომხმარებელი, რაც მას მსოფლიოში ერთ-ერთ უმსხვილეს ბაზრად აქცევს. ინდოეთი, განსაკუთრებით სტუდენტების აქტივობით, აშშ-ის შემდეგ სიდიდით მეორე მომხმარებლის ბაზაა. OpenAI გეგმავს ინდოეთის მთავრობასთან თანამშრომლობის გაღრმავებას AI-ზე ხელმისაწვდომობის გაფართოებისთვის, მიუხედავად ადგილობრივი ბაზრის ფასისადმი მგრძნობელობისა და ინფრასტრუქტურული შეზღუდვებისა. ქვეყნის მზარდი გავლენა გლობა

ბრძოლა კორპორატიული ხელოვნური ინტელექტისთვის მწვავდება: Glean-ის სტრატეგია, როგორც ინტელექტუალური ფენა
კორპორატიული ხელოვნური ინტელექტის ბაზარზე კონკურენცია მწვავდება: Microsoft-ი Copilot-ს Office-ში აერთიანებს, Google კი Gemini-ს Workspace-ში ნერგავს. OpenAI და Anthropic პირდაპირ მსხვილ კომპანიებს სთავაზობენ სერვისებს. ამ ფონზე, Glean, რომელიც თავდაპირველად საწარმოსთვის განკუთვნილი საძიებო ინსტრუმენტი იყო, სტრატეგიას ცვლის და მიზნად ისახავს გახდეს ინტელექტუალური ფენა, რომელიც AI მოდელებს კორპორატიულ მონაცემებთან დააკავშირებს. კომპანია ფსონს დებს მოქნილობაზე, მრავალმოდელურ მხარდაჭერაზე და მონაცემ

AI კომპანიები ტალანტების გადინების და შიდა ძვრების პირისპირ: xAI-სა და OpenAI-ში მნიშვნელოვანი ცვლილებებია
AI კომპანიები ბოლო კვირების განმავლობაში მნიშვნელოვან კადრების გადინებას და შიდა რესტრუქტურიზაციას განიცდიან. xAI-ის დამფუძნებელი გუნდის ნახევარმა კომპანია დატოვა, ხოლო OpenAI-ში საკადრო ცვლილებები ხდება, მისიის გასწორების გუნდის დაშლისა და ხელმძღვანელი პირების გათავისუფლების ჩათვლით. TechCrunch-ის პოდკასტი Equity განიხილავს ამ მოვლენებს, აგრეთვე ტექნოლოგიური სექტორის უმსხვილეს გარიგებებსა და ტალანტების მიგრაციას.

AI კომპანიები კადრებს კარგავენ: xAI-სა და OpenAI-ში შიდა ცვლილებებია
ხელოვნური ინტელექტის კომპანიები, მათ შორის xAI და OpenAI, კადრების მნიშვნელოვან გადინებასა და შიდა რესტრუქტურიზაციას განიცდიან. xAI-მ დამფუძნებელი გუნდის ნახევარი დაკარგა, ხოლო OpenAI აუქმებს ძირითად გუნდებს და ათავისუფლებს აღმასრულებლებს პოლიტიკის უთანხმოების გამო. ეს ცვლილებები ემთხვევა Equity პოდკასტზე ტექნოლოგიური სფეროს უმსხვილესი გარიგებებისა და ცვლილებების განხილვას.

OpenAI აჩერებს საკამათო GPT-4o-სა და სხვა მოძველებული მოდელების წვდომას
OpenAI პარასკევიდან წყვეტს ხუთ მოძველებულ ChatGPT მოდელზე წვდომას, მათ შორის საკამათო GPT-4o-ზე, რომელიც მომხმარებლის თვითდაზიანებასთან, ბოდვით ქცევასთან და ხელოვნური ინტელექტის ფსიქოზთან იყო დაკავშირებული. მიუხედავად იმისა, რომ მას მომხმარებელთა მხოლოდ 0.1% იყენებს, ეს მაინც 800 000 ადამიანს შეადგენს, რამაც ათასობით მომხმარებლის პროტესტი გამოიწვია.
DeepSeek-R1-ის გარღვევა მსჯელობის მოდელებში და Open-R1 პროექტი: საიდუმლოების გამჟღავნებისკენ
DeepSeek-R1-ის ახალი მოდელი, რომელიც OpenAI-ის o1-ს უტოლდება ან აღემატება, დეტალური ტექნიკური ანგარიშით გამოვიდა, რამაც ხელოვნური ინტელექტის საზოგადოებაში დიდი აჟიოტაჟი გამოიწვია. მოდელი ეფუძნება ინოვაციურ მიდგომას, მათ შორის გაძლიერებულ სწავლებას ადამიანის ზედამხედველობის გარეშე. თუმცა, DeepSeek-მა არ გაასაჯაროვა თავისი მონაცემთა ნაკრებები და კოდი, რამაც Open-R1 პროექტი გააჩინა, რომელიც მიზნად ისახავს DeepSeek-R1-ის „რეცეპტის“ რეკონსტრუქციას, გამჭვირვალობის გაზრდას და ღია წყაროს მსჯელობის მოდელ
DeepSeek-R1-ის რევოლუცია: ღია წყაროს ინიციატივა მსჯელობის მოდელების გასახსნელად
DeepSeek-R1-ის გამოშვებამ ხელოვნური ინტელექტის სამყაროში მნიშვნელოვანი გარღვევა მოახდინა, წარმოადგინა მსჯელობის უნარის მქონე მოდელი, რომელიც OpenAI-ის o1-ზე არანაკლებ ან უკეთესად მუშაობს. მისი შექმნის მეთოდოლოგია, განსაკუთრებით კი გაძლიერებითი სწავლის (RL) გამოყენება ადამიანის ზედამხედველობის გარეშე, დეტალურად იქნა აღწერილი. მიუხედავად იმისა, რომ მოდელის წონები ღიაა, მისი სავარჯიშო მონაცემები და კოდი საიდუმლოდ დარჩა. ამის საპასუხოდ, Open-R1 პროექტი მიზნად ისახავს DeepSeek-R1-ის მონაცემთა და სავა

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ

Deepseek R1-ის 'აჰა მომენტი' და მისი ხელახლა შექმნა GRPO-სა და Countdown თამაშის მეშვეობით
Deepseek R1-ის გამოშვებამ ინდუსტრია შეძრა, რადგან ის არის ღია მოდელი, რომელიც OpenAI-ის o1-ს ეჯიბრება კომპლექსური მსჯელობის ამოცანებში. მოდელი გამოირჩევა „აჰა მომენტით“ – თვითვერიფიკაციის უნარით ადამიანური ჩარევის გარეშე. ეს ბლოგ პოსტი მიზნად ისახავს ამ უნიკალური ქცევის ხელახლა შექმნას Group Relative Policy Optimization (GRPO) და Countdown თამაშის გამოყენებით, დისტრიბუციულ ტრენინგზე ფოკუსირებით Deepspeed-ისა და vLLM-ის მეშვეობით.
OpenAI-მ Deep Research გამოუშვა: ვებ-დათვალიერების სისტემა და ღია კოდით მისი რეპროდუცირების მცდელობები
OpenAI-მ წარმოადგინა „Deep Research“ – ინოვაციური სისტემა, რომელიც ვებ-კონტენტს აჯამებს და კითხვებზე პასუხობს. სისტემამ შთამბეჭდავი შედეგები აჩვენა General AI Assistants (GAIA) ბენჩმარკზე, მიაღწია თითქმის 67%-იან სიზუსტეს საშუალოდ და 47.6%-ს რთულ „დონე 3“ კითხვებზე. Deep Research აგებულია დიდ ენობრივ მოდელზე (LLM) და აგენტურ ჩარჩოზე, რომელიც მას ინსტრუმენტების გამოყენებაში ეხმარება. მიუხედავად OpenAI-ს მიერ აგენტური ჩარჩოს დეტალების არგამჟღავნებისა, ღია კოდის საზოგადოებამ 24-საათიანი მისია დაიწყ

Few-Shot Learning ხელოვნურ ინტელექტში: GPT-Neo და აჩქარებული დასკვნის API
სტატია განმარტავს „Few-Shot Learning“ (რამდენიმე მაგალითზე დაფუძნებული სწავლების) კონცეფციას, როგორც მანქანური სწავლების ტექნიკას, რომელიც მოდელს მცირე რაოდენობის მონაცემებით წვრთნის. განხილულია მისი გამოყენება ბუნებრივი ენის დამუშავებაში (NLP) დიდი ენობრივი მოდელების, როგორიცაა EleutherAI GPT-Neo და OpenAI GPT-3, მეშვეობით. სტატია ასევე მიმოიხილავს Hugging Face-ის აჩქარებული დასკვნის (Accelerated Inference) API-ის როლს, ამ ტექნიკის ოპტიმიზაციას, გამოწვევებს (მაგ., მოდელის მგრძნობელობა მაგალითებ
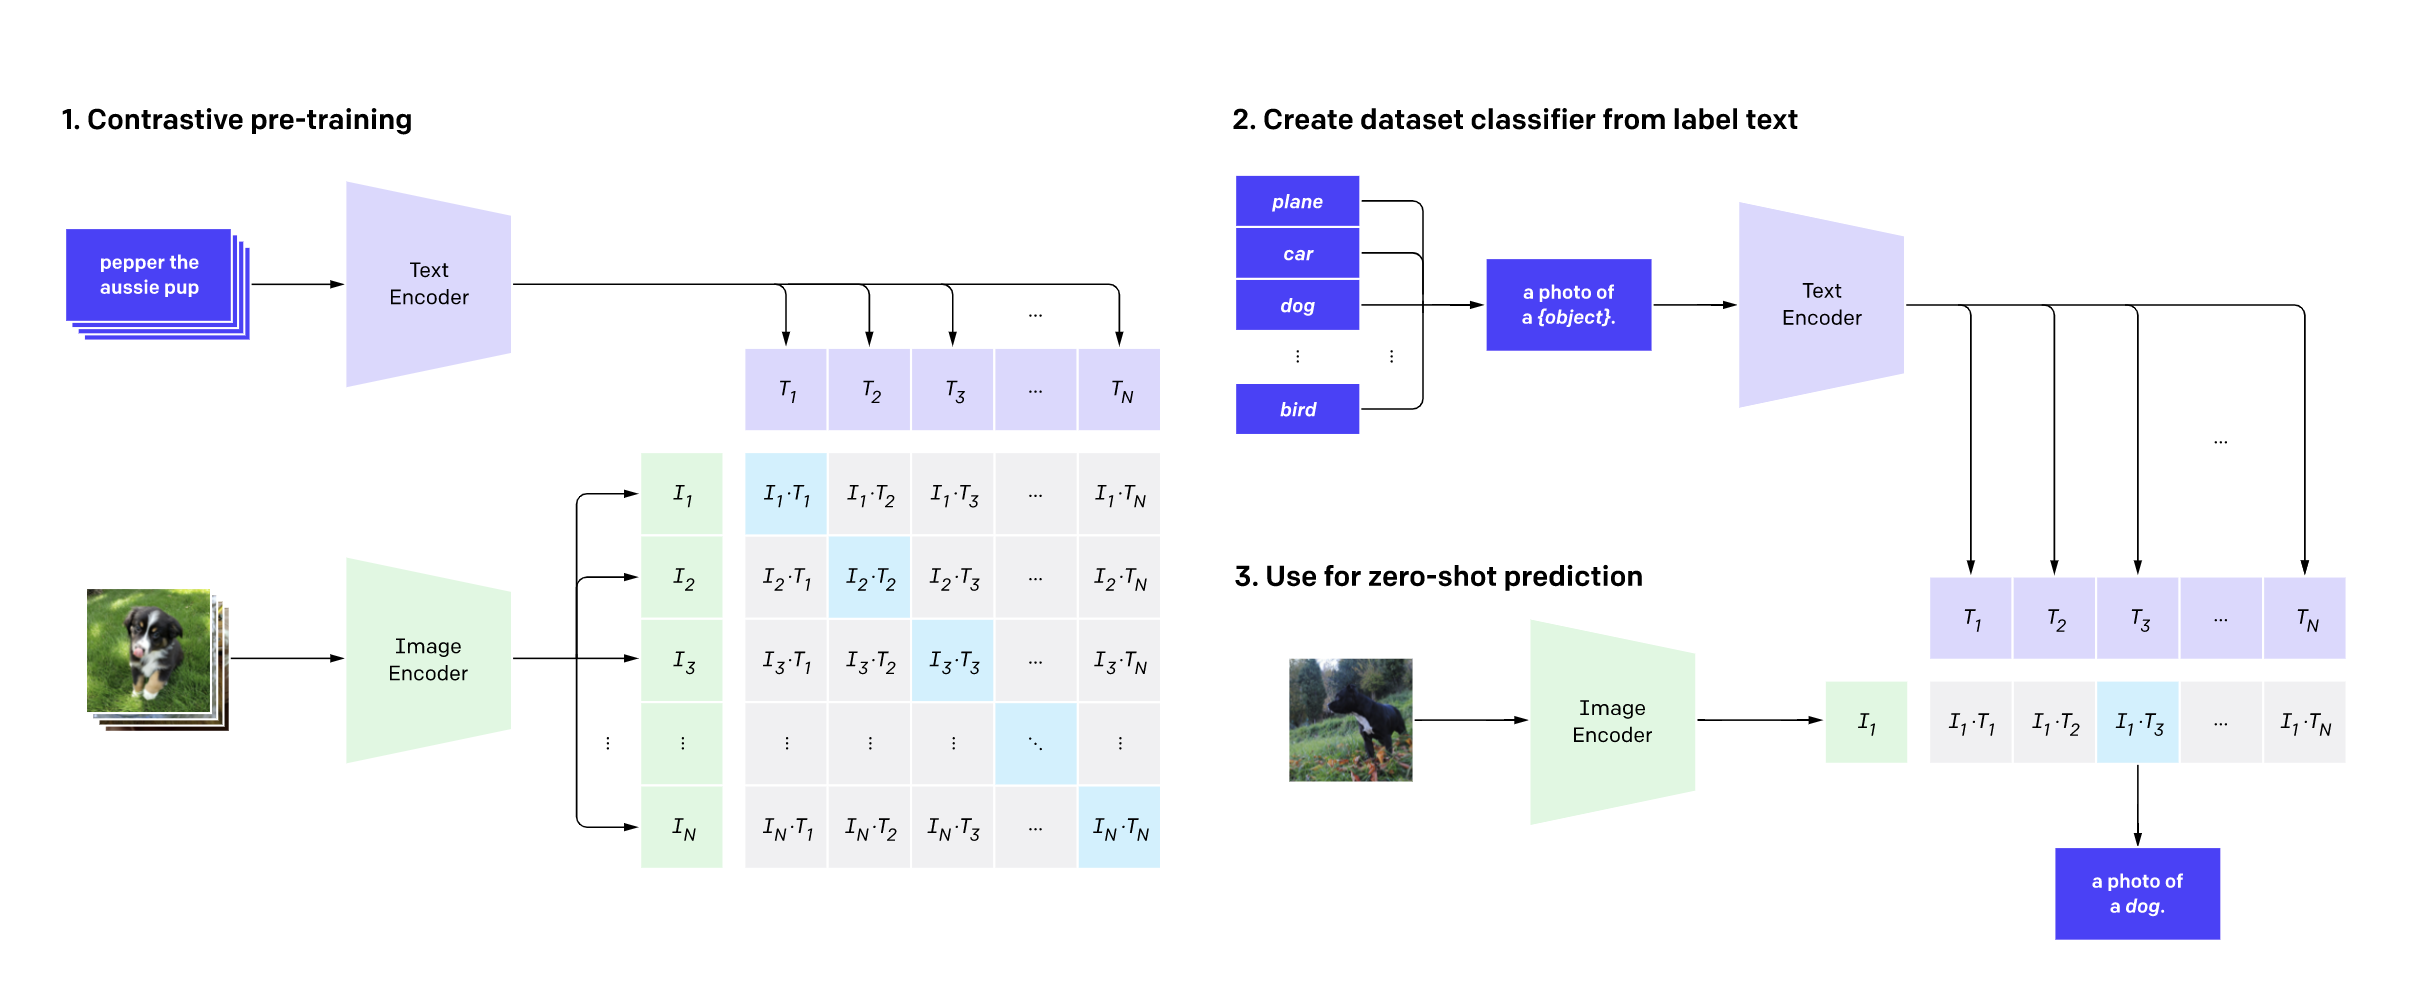
CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ
OpenAI-ის RLHF შედეგების რეპროდუცირება: ტექნიკური დეტალების სიღრმისეული ანალიზი
მოცემული ნაშრომი მიზნად ისახავს OpenAI-ის (OAI) სტილისტური ამოცანების (როგორიცაა სენტიმენტი და აღწერილობითობა) RLHF (Reinforcement Learning from Human Feedback) შედეგების რეპროდუცირებას. ჩვენი კოდების ბაზა OAI-ის კოდების ბაზის თითქმის იდენტურ სწავლის მრუდებს აჩვენებს. სტატია დეტალურად განიხილავს იმპლემენტაციის ტექნიკურ ნიუანსებს, მათ შორის, როგორ გენერირდება ჯილდოები/მნიშვნელობები და პასუხები, შევსების (padding) მექანიზმებს, ლოგიტების გამოთვლას და პასუხების გენერაციის დროს შერჩევის პროცესს. ასევ

ღია კოდის ემბედინგის მოდელების განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და დაბალი ხარჯები
Hugging Face Inference Endpoints-ზე ღია კოდის ემბედინგის მოდელების განთავსების შესახებ სტატია აღწერს, თუ როგორ უზრუნველყოფს Text Embedding Inference (TEI) ამ მოდელების სწრაფ და ხარჯთეფექტურ გამოყენებას. ემბედინგის მოდელები, LLM-ებთან შედარებით, მცირე ზომისაა და სწრაფ ინფერენსს გვთავაზობს, რაც გადამწყვეტია ოპტიმალური მომხმარებლის გამოცდილებისა და ხარჯების შესამცირებლად. TEI-ის საშუალებით შესაძლებელია 450+ მოთხოვნა/წამში წარმადობის მიღწევა და 64-ჯერ უფრო დაბალი ხარჯები, ვიდრე OpenAI Embeddings-ის
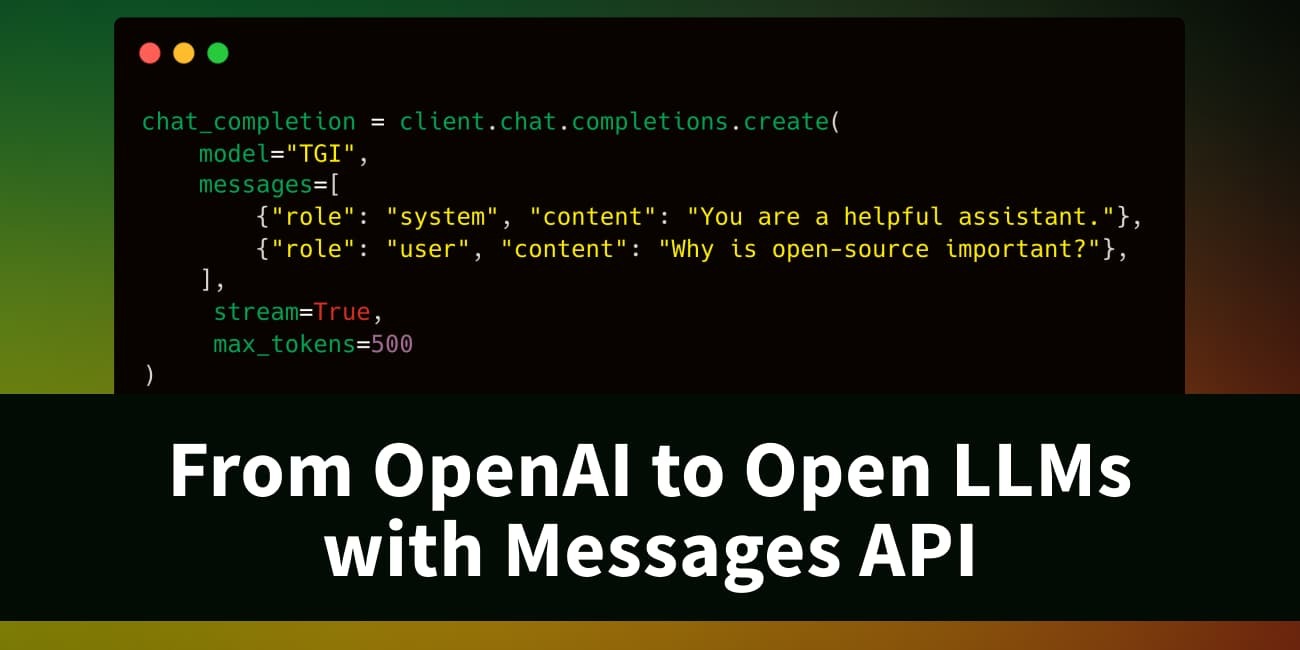
TGI-ის Messages API: OpenAI-თან თავსებადობა და შეუფერხებელი გადასვლა ღია LLM-ებზე
TGI-ის (Text Generation Inference) ვერსია 1.4.0-დან დაწყებული, ხელმისაწვდომია ახალი Messages API, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-სთან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდ ენობრივ მოდელებზე (LLM). API შეიძლება გამოყენებულ იქნას OpenAI-ის კლიენტის ბიბლიოთეკებთან ან მესამე მხარის ხელსაწყოებთან, როგორიცაა LangChain და LlamaIndex. Messages API ასევე ხელმისაწვდომია Hugging Face-ის Inference Endpoints-ზე
TGI-ის Messages API: უწყვეტი გადასვლა ღია LLM-ებზე OpenAI-ის თავსებადობით
TGI (Text Generation Inference) 1.4.0 ვერსიიდან მოყოლებული, გთავაზობთ Messages API-ს, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-თან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდი ენის მოდელებზე (LLM-ებზე), არსებული კლიენტის ბიბლიოთეკების ან მესამე მხარის ხელსაწყოების (როგორიცაა LangChain და LlamaIndex) გამოყენებით. სტატია დეტალურად აღწერს მოდელების Hugging Face Inference Endpoints-ზე განთავსების, ტექნიკური კონფიგურაც

OpenAI-ის GPT OSS მოდელები Hugging Face-ზე: გაუმჯობესებული ხელმისაწვდომობა და ოპტიმიზებული წარმადობა
OpenAI-მ Apache 2.0 ლიცენზიით გამოუშვა ღია კოდის GPT OSS მოდელები, რომელთა მიზანია ხელოვნური ინტელექტის ფართო ხელმისაწვდომობის უზრუნველყოფა უსაფრთხო და პასუხისმგებლიანი გამოყენებით. Hugging Face-თან ინტეგრაციით, მომხმარებლებს შეუძლიათ ისარგებლონ გაუმჯობესებული არქიტექტურით, მათ შორის mxfp4 კვანტიზაციით, Flash Attention 3-ითა და MegaBlocks MoE ქერნელებით, რაც უზრუნველყოფს მნიშვნელოვან მეხსიერების დაზოგვას და მაღალ წარმადობას როგორც NVIDIA, ისე AMD GPU-ებზე. ეს ინიციატივა ხელს უწყობს AI-ის ინოვაცი
OpenAI-ის „Whisper“: გარღვევა მეტყველების ამოცნობის ტექნოლოგიაში
OpenAI-ის მიერ 2022 წლის სექტემბერში გამოქვეყნებული „Whisper“ არის წინასწარ გაწვრთნილი მოდელი მეტყველების ავტომატური ამოცნობისთვის (МАА). ის იყენებს 680,000 საათის უზარმაზარ მარკირებულ აუდიო-ტრანსკრიფციის მონაცემთა ნაკრებს, მათ შორის მრავალენოვან მონაცემებს, რათა მიაღწიოს მოწინავე შედეგებს მეტყველება-ტექსტის კონვერტაციაში 96-ზე მეტ ენაზე, მინიმალური დამატებითი დაზუსტებით.
OpenAI-ის „Whisper“: რევოლუცია მეტყველების ავტომატურ ამოცნობაში
OpenAI-ის Whisper, 2022 წლის სექტემბერში გამოქვეყნებული ავტომატური მეტყველების ამოცნობის (ამოკრ.) მოდელი, რევოლუციას ახდენს დარგში. წინამორბედებისგან განსხვავებით, ის გაწვრთნილია უპრეცედენტო მოცულობის, 680,000 საათის ეტიკეტირებულ აუდიო-ტრანსკრიფციის მონაცემებზე, მათ შორის 117,000 საათის მულტილინგვურ მონაცემებზე, რაც 96-ზე მეტი ენის მხარდაჭერას უზრუნველყოფს. ზედამხედველობითი წინასწარი გაწვრთნა საშუალებას აძლევს მას პირდაპირ ისწავლოს მეტყველებიდან ტექსტზე გადასვლა, რაც მინიმალურ დახვეწას მოითხოვს
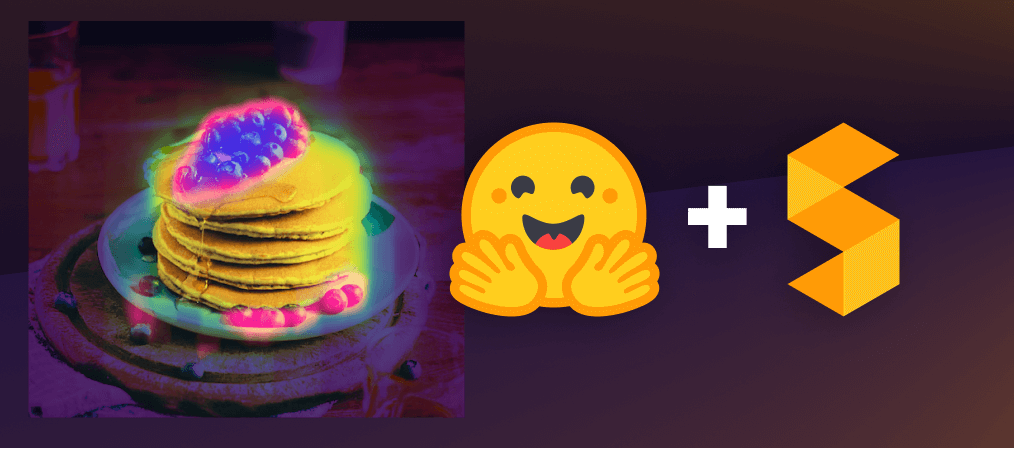
CLIPSeg: რევოლუციური ხელოვნური ინტელექტი, რომელიც ნებისმიერი ობიექტის სეგმენტაციას დამატებითი წვრთნის გარეშე ახდენს
სტატია განიხილავს გამოსახულების სეგმენტაციას, მის არსებულ შეზღუდვებს (ფიქსირებული კატეგორიები, წვრთნის მაღალი ღირებულება) და წარმოგიდგენთ CLIPSeg-ს. CLIPSeg არის "ნულოვანი-კადრის" (zero-shot) სეგმენტაციის მოდელი, რომელიც OpenAI-ის CLIP-ზეა დაფუძნებული და შეუძლია თითქმის ნებისმიერი ობიექტის სეგმენტაცია დამატებითი წვრთნის გარეშე. ის იყენებს CLIP-ის უნარს, შექმნას გამოსახულებებისა და ტექსტის აბსტრაქტული წარმოდგენები, ტრანსფორმატორზე დაფუძნებული დეკოდერის დახმარებით სეგმენტაციის ნიღბების შესაქმნელად

ChatGPT-ში რეკლამები გამოჩნდება - OpenAI ახალ სტრატეგიას აანონსებს
OpenAI აპირებს ChatGPT-ში რეკლამების ტესტირებას უფასო და Go-გეგმის მომხმარებლებისთვის, რომელიც რამდენიმე კვირაში აშშ-ში დაიწყება. რეკლამები გამოჩნდება ჩატბოტის პასუხების ბოლოში და მკაფიოდ იქნება მონიშნული, როგორც სპონსორირებული. კომპანია ირწმუნება, რომ რეკლამები გავლენას არ მოახდენს პასუხების შინაარსზე და მომხმარებლის მონაცემებს კონფიდენციალურად შეინარჩუნებს, თუმცა ექსპერტები ეჭვქვეშ აყენებენ პერსონალიზებული რეკლამების ეთიკურ ასპექტებს თვალთვალის საჭიროების გამო.

მეხსიერების გლობალური კრიზისი: ხელოვნური ინტელექტის გავლენა RAM-ისა და SSD-ის ფასებზე
2025 წლის დეკემბერში დაიწყო გლობალური ფასების კრიზისი RAM-ისა და SSD-ის ბაზარზე, რამაც გამოიწვია მეხსიერების ფასების 500%-მდე ზრდა და SSD-ის ფასების გაორმაგება. მიზეზი ხელოვნური ინტელექტის (AI) გიგანტების, განსაკუთრებით OpenAI-სა და Nvidia-ს მიერ, მეხსიერების ჩიპების მასშტაბური შესყიდვებია. OpenAI-ის „Stargate“ პროექტი თვეში 900 000 DRAM ვაფლს მოითხოვს, რაც მსოფლიო წარმოების 40%-ს შეადგენს. ეს იწვევს გლობალურ დეფიციტს, ფასების ზრდას სამომხმარებლო ელექტრონიკაზე და შესაძლოა, ტექ-კომპანიების სტრატე

ChatGPT Health: ხელოვნური ინტელექტი ჯანმრთელობისთვის - შესაძლებლობები და საფრთხეები
OpenAI-მ 2026 წლის იანვარში გამოუშვა ChatGPT Health, ახალი სპეციალიზებული ფუნქცია, რომელიც მომხმარებლებს საკუთარი ჯანმრთელობის უკეთ გაგებასა და მართვაში ეხმარება. სერვისი სამედიცინო ჩანაწერებისა და ჯანმრთელობის აპლიკაციების დაკავშირების საშუალებას იძლევა პერსონალური რჩევებისთვის, თუმცა ის არ არის ხელმისაწვდომი ევროკავშირის ქვეყნებში. ექსპერტები სერიოზულ რისკებზე საუბრობენ, მათ შორის არასწორი ინფორმაციის მიწოდებაზე, სახიფათო სიმპტომების გამოტოვებაზე და პასუხისმგებლობის საკითხის ბუნდოვანებაზე, რამ

ახალი კვლევა AI-ს მტკიცებებს ძირს უთხრის: მოდელები საავტორო უფლებებით დაცულ კონტენტს ინახავენ და იმეორებენ
სტენფორდისა და იელის უნივერსიტეტების ახალმა კვლევამ აჩვენა, რომ წამყვანი AI კომპანიების ენობრივი მოდელები, როგორიცაა OpenAI, Anthropic და Google, საავტორო უფლებებით დაცული სავარჯიშო მონაცემების ასლებს ინახავენ და არა მხოლოდ „შაბლონებს სწავლობენ“. ეს აღმოჩენა ფუნდამენტურად ეჭვქვეშ აყენებს კომპანიების იურიდიულ არგუმენტებს „კეთილსინდისიერი გამოყენების“ (fair use) შესახებ, ვინაიდან მოდელებს მარტივი მოთხოვნებით შეუძლიათ ცნობილი ნაწარმოებებიდან ათასობით სიტყვის სიტყვასიტყვით რეპროდუცირება.