MIT-ის მკვლევარები LLM-ების წვრთნის სიჩქარეს აორმაგებენ გამოთვლითი რესურსების ოპტიმიზაციით
მსხვილი ენობრივი მოდელების (LLM) წვრთნა უზარმაზარ გამოთვლით რესურსებს მოითხოვს, თუმცა პროცესის არაეფექტურობის გამო პროცესორების ნაწილი ხშირად უქმად რჩება. MIT-ის მკვლევარებმა შეიმუშავეს მეთოდი, რომელიც ამ გამოუყენებელ დროს იყენებს უფრო პატარა, სწრაფი მოდელის საწვრთნელად. ეს პატარა მოდელი წინასწარმეტყველებს დიდი LLM-ის გამომუშავებას, რასაც შემდეგ დიდი მოდელი ამოწმებს. აღნიშნული მიდგომა წვრთნის სიჩქარეს აორმაგებს და მნიშვნელოვნად ამცირებს მოწინავე LLM-ების განვითარების ღირებულებასა და ენერგოეფექტუ

MatX-მა 500 მილიონი დოლარის ინვესტიცია მოიზიდა Nvidia-სთვის კონკურენციის გასაწევად AI ჩიპების ბაზარზე
Google-ის ყოფილი ინჟინრების მიერ დაარსებულმა ჩიპების სტარტაპმა MatX-მა 500 მილიონი დოლარის სერია B დაფინანსება მოიზიდა Jane Street-ისა და Situational Awareness-ისგან. კომპანიის მიზანია შექმნას პროცესორები, რომლებიც 10-ჯერ უფრო ეფექტური იქნება დიდი ენობრივი მოდელების (LLM) წვრთნაში, ვიდრე Nvidia-ს გრაფიკული პროცესორები (GPU). ახალი დაფინანსება MatX-ს TSMC-თან ერთად ჩიპების წარმოებაში დაეხმარება, მათი მიწოდება კი 2027 წელს დაიწყება.

LeMaterial-ის გაშვება: ღია კოდის კოლაბორაციული პროექტი მასალების კვლევისთვის Entalpic-ისა და Hugging Face-ისგან
Entalpic-ისა და Hugging Face-ის მიერ ინიცირებული ღია კოდის კოლაბორაციული პროექტი LeMaterial ამოქმედდა, რომლის მიზანია მასალების კვლევის გამარტივება და დაჩქარება. პროექტი ხელს შეუწყობს მანქანური სწავლების მოდელების გაწვრთნას, ახალი მასალების იდენტიფიცირებას და ქიმიური სივრცეების შესწავლას. პირველ ეტაპზე გამოვიდა LeMat-Bulk მონაცემთა ნაკრები, რომელიც აერთიანებს, ასუფთავებს და სტანდარტიზაციას უკეთებს წამყვან მონაცემთა ბაზებს (Materials Project, Alexandria, OQMD), ქმნის 6.7 მილიონი ჩანაწერისა და 7 მ
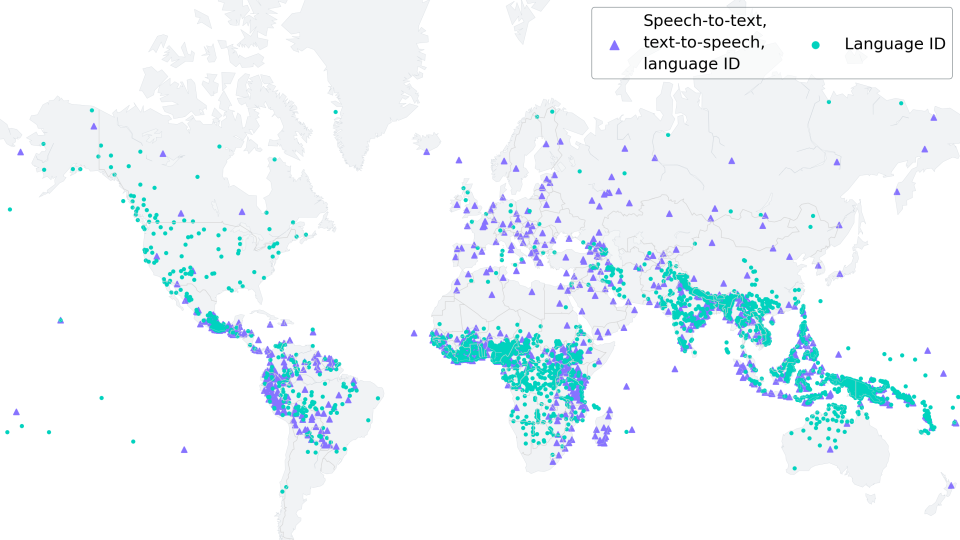
Meta AI-ის რევოლუციური MMS მოდელი: 1100-ზე მეტი ენის მხარდაჭერა და გადაშენების პირას მყოფი ენების შენარჩუნება
Meta AI-მ წარმოადგინა Massive Multilingual Speech (MMS) მოდელი, რომელსაც შეუძლია 1100-ზე მეტი ენის ამოცნობა, ტრანსკრიფცია და გენერაცია. ეს ინოვაციური სისტემა, რომელიც იყენებს „ადაპტერის“ წვრთნის მეთოდს, მნიშვნელოვნად ამცირებს შეცდომის მაჩვენებელს მცირე რესურსების მქონე ენებისთვის და ხელს უწყობს გადაშენების პირას მყოფი ენების შენარჩუნებას, რადგან მათთვის წერილობითი ჩანაწერების შექმნასა და მშობლიურ ენაზე კომუნიკაციას უწყობს ხელს. MMS-ის ადაპტერის წვრთნა უფრო ეფექტურია მეხსიერების თვალსაზრისით, უფრ
ენკოდერ-დეკოდერ მოდელების ეფექტური წვრთნა: წინასწარ გაწვრთნილი კომპონენტების გამოყენების უპირატესობები
ახალი კვლევა გვთავაზობს ენკოდერ-დეკოდერ მოდელების წვრთნის ინოვაციურ მეთოდს, რომელიც მნიშვნელოვნად ამცირებს გამოთვლით ხარჯებს. BERT-ისა და GPT2-ის მსგავსი წინასწარ გაწვრთნილი ენკოდერის ან/და დეკოდერის კომპონენტების გამოყენებით, შესაძლებელია მაღალხარისხიანი შედეგების მიღწევა თანმიმდევრობა-თანმიმდევრობაზე ამოცანებში, როგორიცაა ტექსტის შეჯამება და მანქანური თარგმანი, სრული წინასწარი წვრთნის გარეშე. ეს მიდგომა ხელს უწყობს ხელოვნური ინტელექტის განვითარებას მცირე რესურსების მქონე გუნდებისთვისაც.
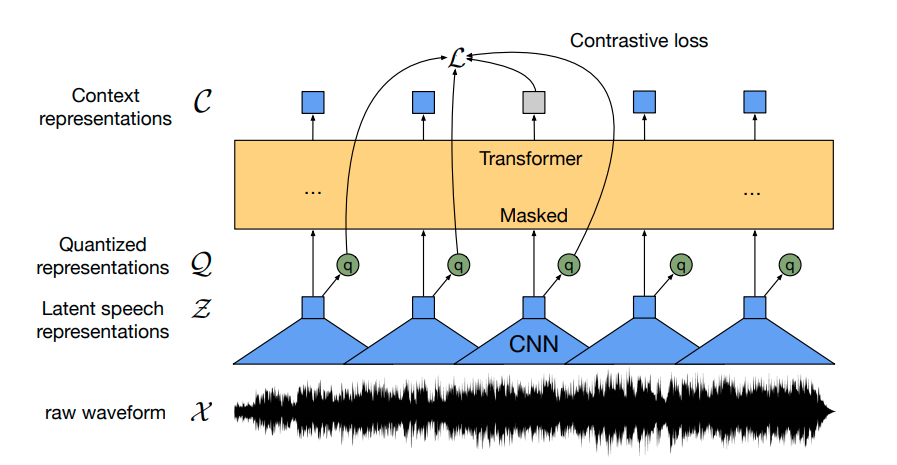
Wav2Vec2: ახალი ეპოქა მეტყველების ავტომატურ ამოცნობაში
Wav2Vec2 წარმოადგენს ინოვაციურ მოდელს, რომელიც იყენებს კონტრასტულ წინასწარ წვრთნას 50 000 საათზე მეტი არადანიშნული მეტყველების მონაცემებიდან მძლავრი წარმოდგენების შესასწავლად. BERT-ის მსგავსად, ის ნიღბავს ფუნქციის ვექტორებს კონტექსტუალიზებული წარმოდგენების მისაღებად. მოდელმა აჩვენა კონკურენტული შედეგები თანამედროვე ავტომატური მეტყველების ამოცნობის (ASR) სისტემებთან, მინიმალური, სულ რაღაც 10 წუთის, დანიშნულ მონაცემებზე დამატებითი წვრთნის შემდეგ. ეს სტატია დეტალურად განმარტავს Wav2Vec2-ის წინასწარ
Hugging Face-ისა და Amazon-ის სტრატეგიული პარტნიორობა: უახლესი ML მოდელების გამოყენების გამარტივება SageMaker-ში
Hugging Face-მა და Amazon-მა სტრატეგიული პარტნიორობა გამოაცხადეს, რათა კომპანიებისთვის უახლესი მანქანური სწავლების (ML) მოდელების გამოყენება და NLP ფუნქციების სწრაფად დანერგვა გაამარტივონ. Hugging Face Amazon Web Services-ს (AWS) სასურველ ღრუბლოვან პროვაიდერად ირჩევს. ამ თანამშრომლობის პირველი ნაბიჯი Hugging Face-ის ახალი ღრმა სწავლების კონტეინერების (DLCs) შეთავაზებაა, რაც Amazon SageMaker-ში Transformer მოდელების გაწვრთნას უპრეცედენტოდ ამარტივებს.
3D Gaussian Splatting: რა არის და რატომ იპყრობს ის ყურადღებას?
3D Gaussian Splatting არის რასტერიზაციის ინოვაციური ტექნიკა, რომელიც საშუალებას იძლევა მაღალი ხარისხის 3D სცენების რეალურ დროში რენდერირებისთვის. ის იყენებს გაუსიანებს სამკუთხედების ნაცვლად, რათა შექმნას სივრცის მკვრივი წარმოდგენა. მეთოდი იწყება SfM-ით წერტილოვანი ღრუბლის შეფასებით, რასაც მოჰყვება გაუსიანებად გარდაქმნა და სტოქასტური გრადიენტული დაშვების გამოყენებით წვრთნა. მისი პოტენციალი მოიცავს ანიმაციას, ანარეკლებს და მნიშვნელოვან გავლენას Embodied AI-ის კვლევაზე, თუმცა მისი სრული ინტეგრაცია
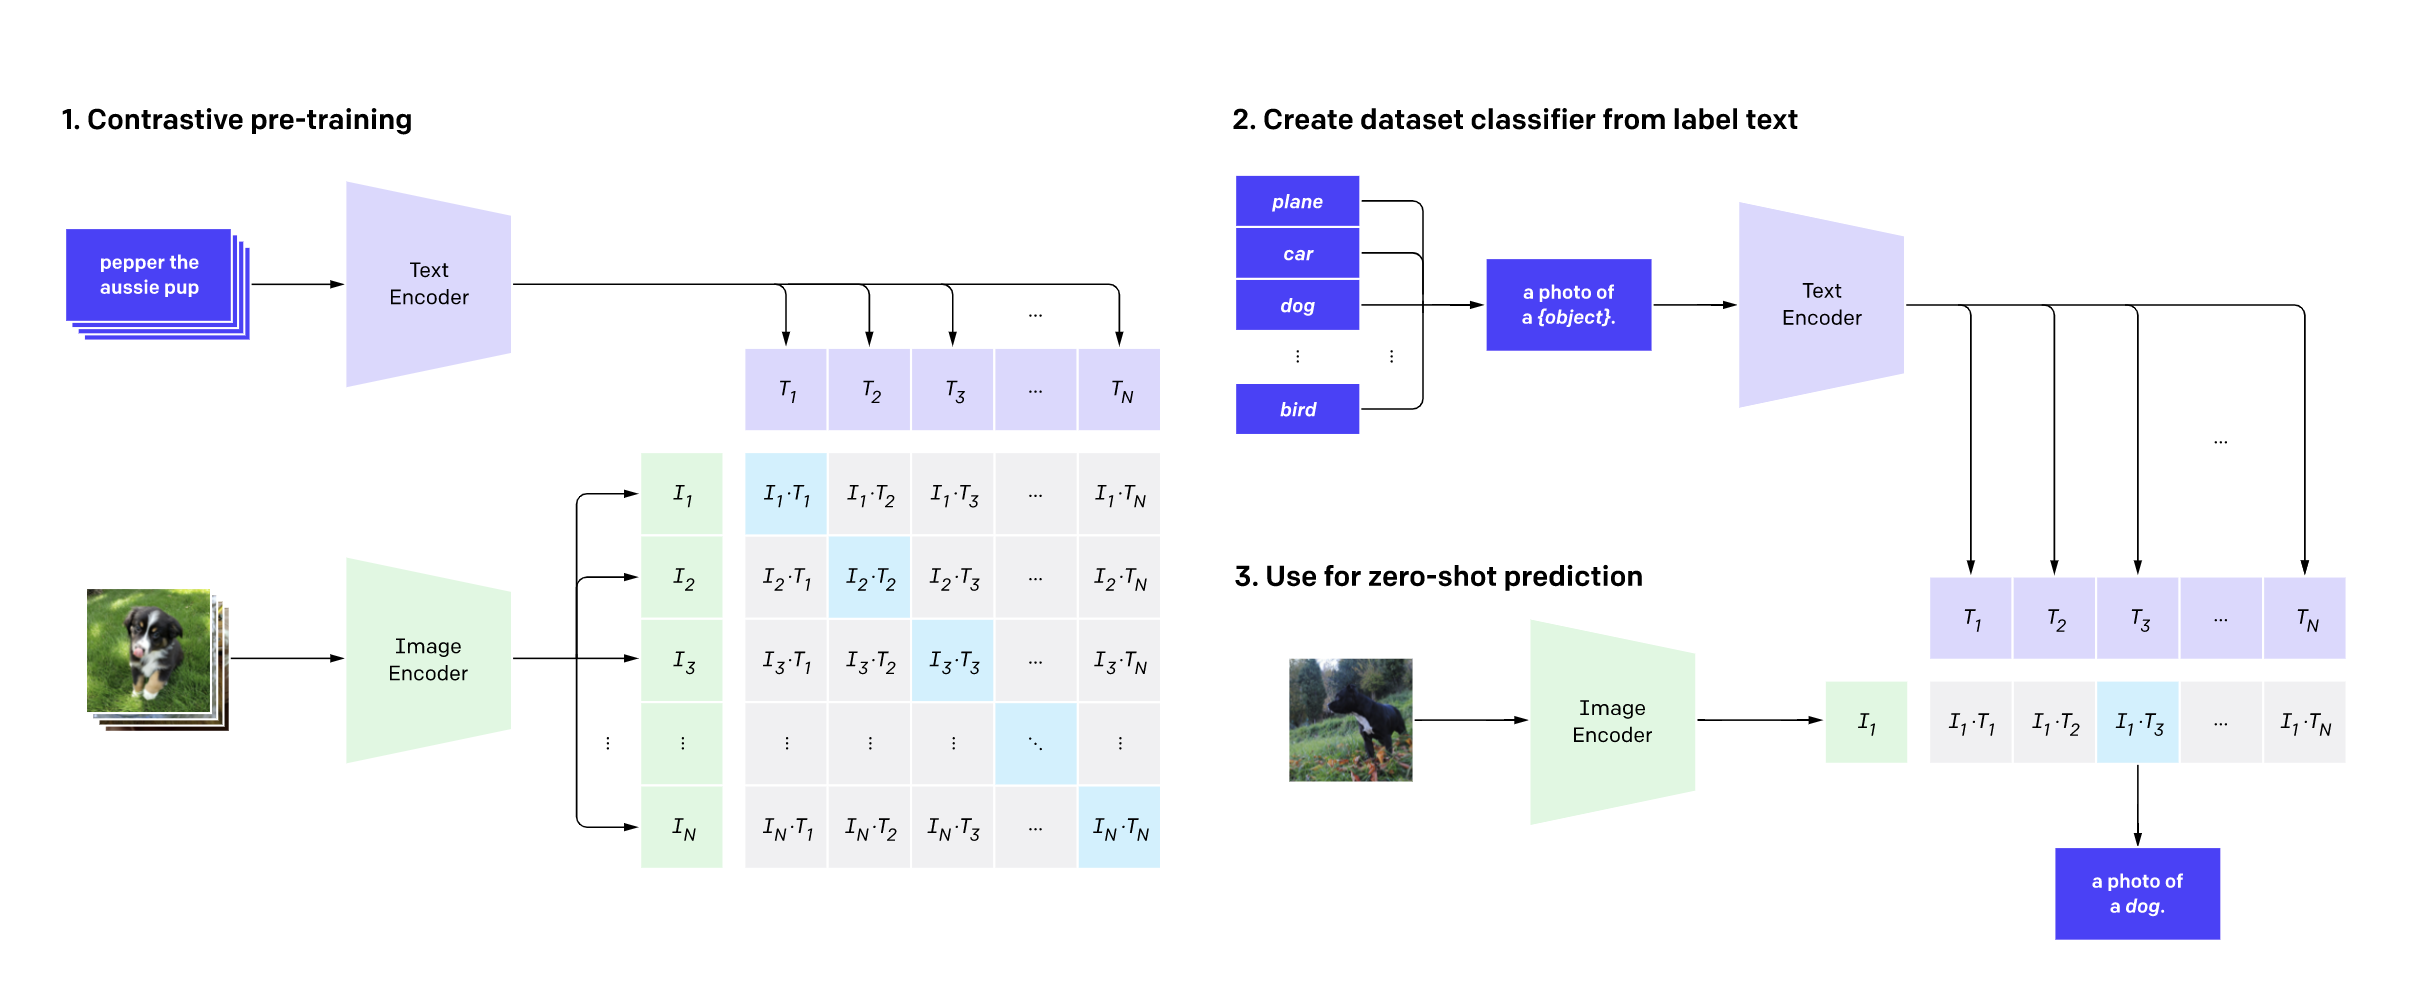
CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ
კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)
AutoNLP და Prodigy: ხელოვნური ინტელექტის მოდელების სწრაფი და ეფექტური შექმნა
სტატია მიმოიხილავს Hugging Face-ის AutoNLP-სა და Explosion-ის Prodigy-ს, ორ მძლავრ ინსტრუმენტს ღრმა სწავლის მოდელების შესაქმნელად და მონაცემთა ანოტაციისთვის. აღწერილია, თუ როგორ ამარტივებს AutoNLP უახლესი ტრანსფორმატორის მოდელების წვრთნას სხვადასხვა ბუნებრივი ენის დამუშავების ამოცანებისთვის (კლასიფიკაცია, სახელობითი ერთეულების ამოცნობა) მინიმალური კოდირებით. Prodigy წარმოდგენილია როგორც მოქნილი, რეალურ დროში ანოტაციის ინსტრუმენტი, რომელიც მხარს უჭერს ბუნებრივი ენის დამუშავების, კომპიუტერული მხედ
Prodigy-HF: Hugging Face მოდელების გაწვრთნა და ანოტირებული მონაცემთა ნაკრებების გაზიარება
Explosion-მა გამოუშვა Prodigy-HF, ახალი პლაგინი, რომელიც Prodigy-ის ანოტაციის ხელსაწყოს Hugging Face-ის ეკოსისტემასთან აინტეგრირებს. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს, გაწვრთნან Hugging Face მოდელები საკუთარ ანოტირებულ მონაცემებზე (მაგ. დასახელებული ერთეულების ამოცნობისთვის და ტექსტის კლასიფიკაციისთვის) და გამოაქვეყნონ ეს მონაცემთა ნაკრებები Hugging Face Hub-ზე, რაც ხელს უწყობს მოქნილობას, თანამშრომლობას და დროის დაზოგვას ხელოვნური ინტელექტის პროექტებში.

გამოსახულებების ტოკენიზაცია და ViT მოდელების დახვეწა გამოსახულების კლასიფიკაციისთვის
ეს სტატია განიხილავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია ტრანსფორმატორის მოდელებისთვის, ნატურალური ენის დამუშავების (NLP) ამოცანების ანალოგიით. დეტალურად არის აღწერილი 🤗 datasets-ისა და 🤗 transformers-ის გამოყენებით ViT (Vision Transformer) მოდელის წინასწარი წვრთნა და დახვეწა გამოსახულების კლასიფიკაციის ამოცანებისთვის. მოცემულია ინსტრუქციები მონაცემთა ჩამოტვირთვის, დამუშავების, გამოსახულების ტრანსფორმაციებისა და წვრთნის კონვეიერის დაყენების შესახებ, მათ შორის ისეთი კომპონენტების, როგორიც
ხელოვნური ინტელექტი: გამოსახულებების ტოკენიზაცია და ViT მოდელების წვრთნა
ეს სტატია განმარტავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია წინადადებების მსგავსად, რაც მათ საშუალებას აძლევს, დამუშავდეს ტრანსფორმერული მოდელებით. დეტალურად არის აღწერილი 🤗 datasets-ის გამოყენებით მონაცემთა მომზადება, ViTImageProcessor-ის ინტეგრირება და წინასწარ გაწვრთნილი ViT მოდელების დაზუსტება. მიმოხილულია ტრენინგის კონფიგურაციის, შეფასების მეტრიკების განსაზღვრისა და ეფექტური წვრთნის კონვეიერის აგების პროცესები, რაც მნიშვნელოვან წინსვლას წარმოადგენს გამოსახულების კლასიფიკაციის ამოცანებშ
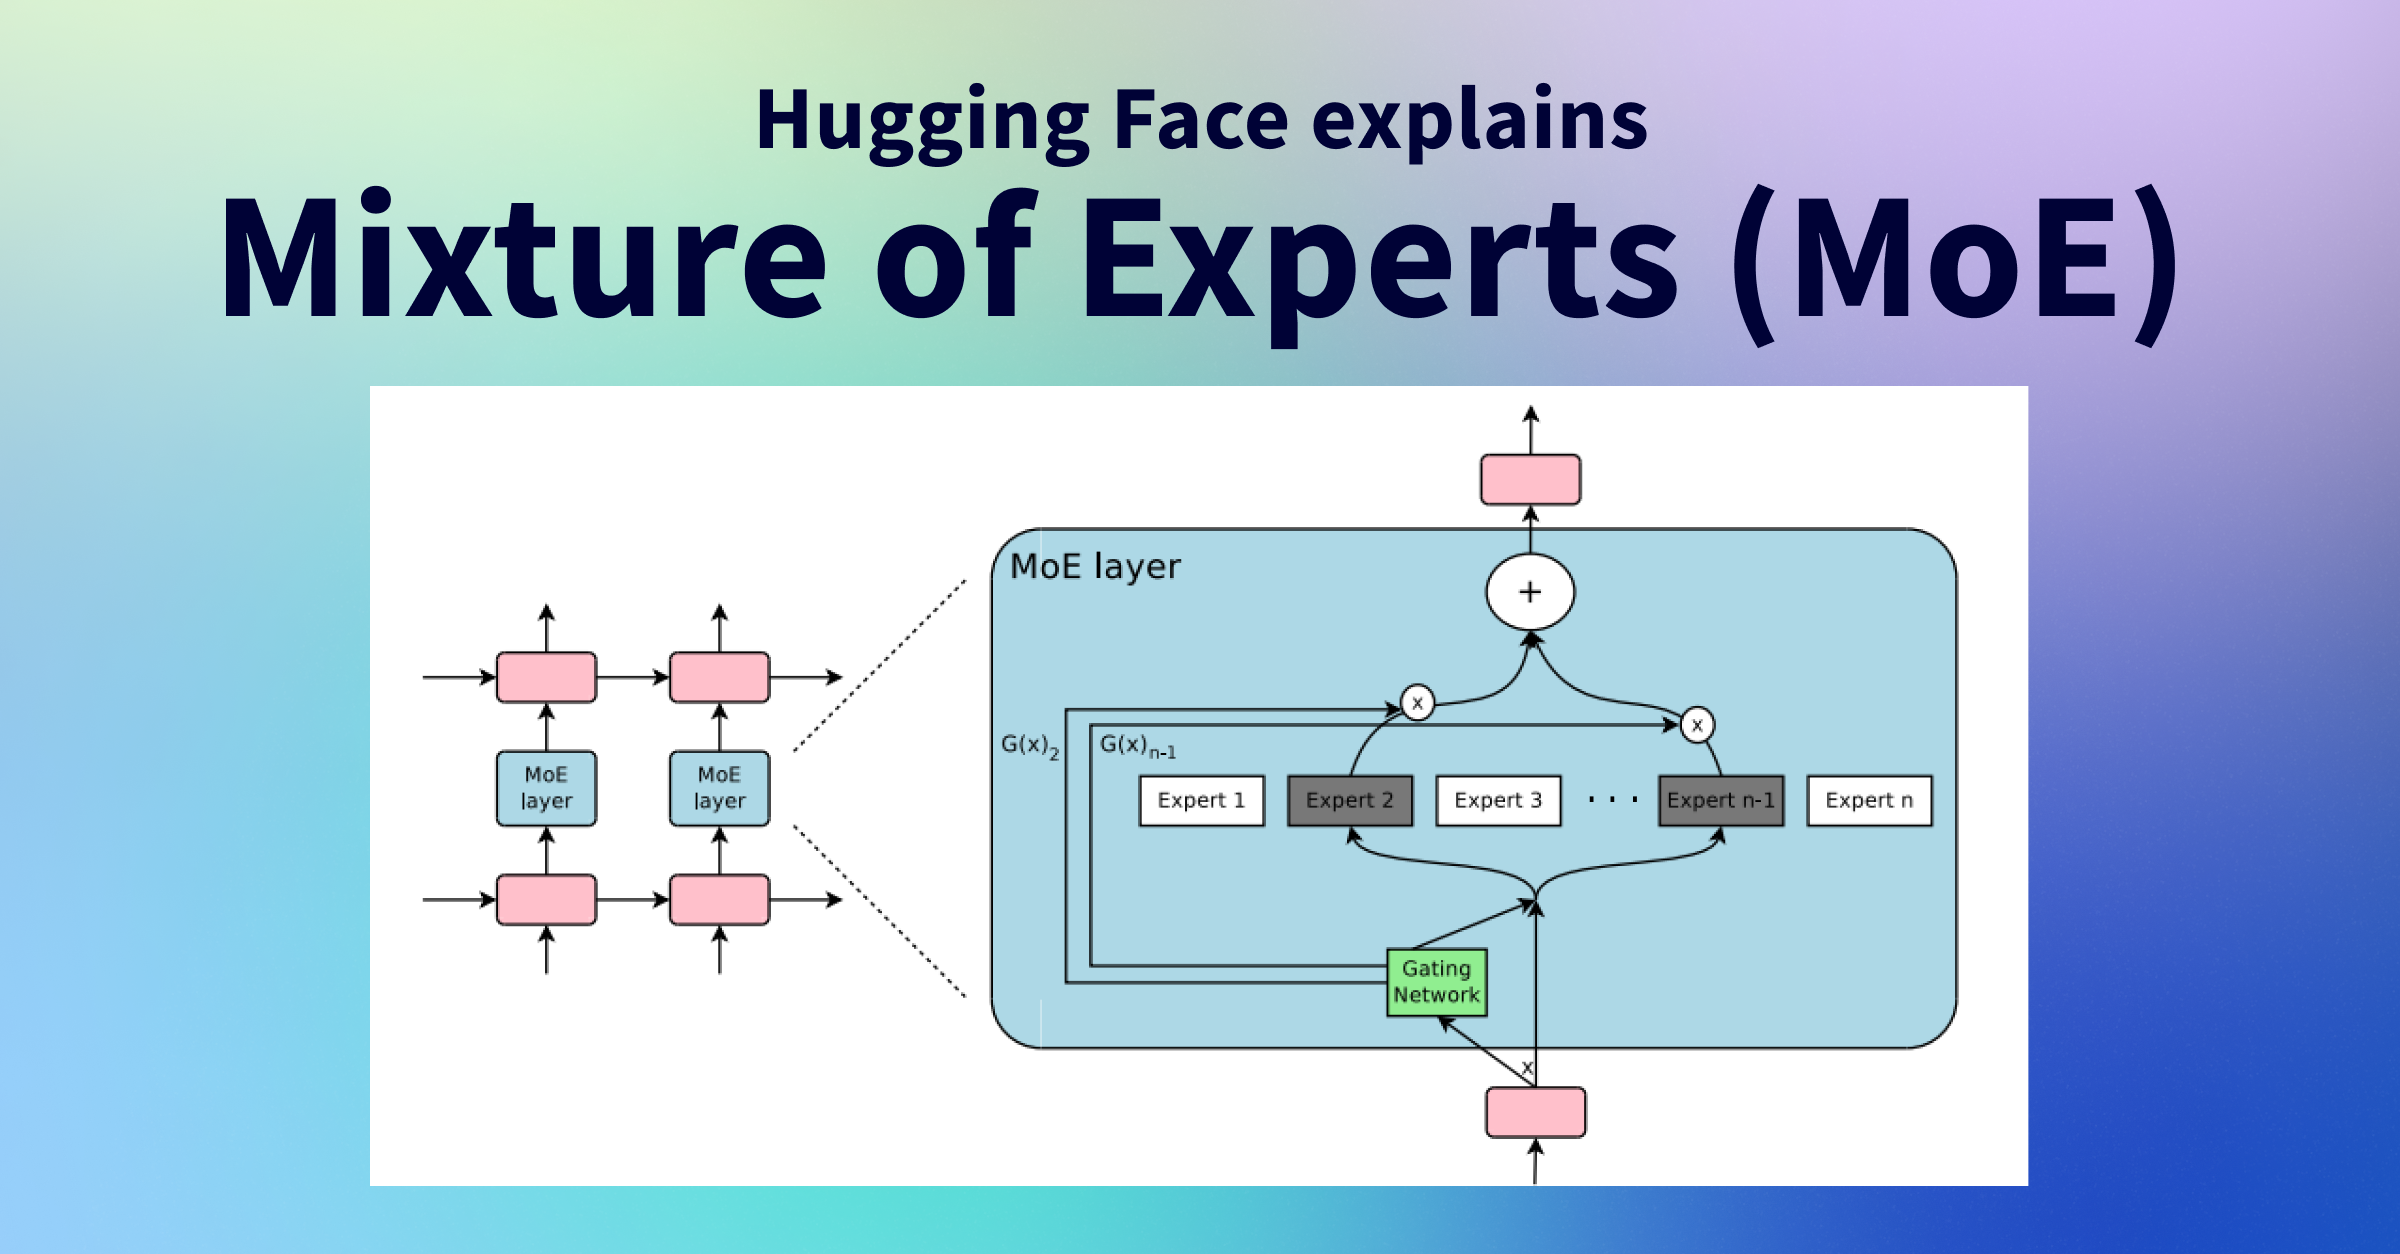
ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი
ახალი მიდგომა SDXL Dreambooth LoRA-ს გაწვრთნისთვის: Pivotal Tuning-ისა და Prodigy ოპტიმიზატორის კომბინაცია
Replicate-ის SDXL Cog ტრენერში გამოყენებული Pivotal Tuning ტექნიკისა და Kohya ტრენერში გამოყენებული Prodigy ოპტიმიზატორის (სხვა მრავალ ოპტიმიზაციასთან ერთად) შერწყმით, მიღწეულია შესანიშნავი შედეგები SDXL-ისთვის Dreambooth LoRA-ების გაწვრთნაში. LoRA Dreambooth-ით დახვეწილი SDXL მოდელები საოცარ შედეგებს იძლევა ახალი კონცეფციების დაფიქსირებაში, მცირე რაოდენობის გამოსახულებების გამოყენებით, თანაც ინარჩუნებენ SDXL-ის ესთეტიკასა და ხარისხს და მოითხოვენ შედარებით მცირე გამოთვლით რესურსებს. ტრენინგის სკ

TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.

OOM შეცდომების დავიწყება: დიდი მოდელების ეფექტური წვრთნა DeepSpeed ZeRO-ს გამოყენებით
დაიღალეთ მეხსიერებიდან ამოწურვის (OOM) შეცდომებით დიდი ხელოვნური ინტელექტის მოდელების წვრთნისას? ეს სტატია წარმოგიდგენთ DeepSpeed ZeRO (Zero Redundancy Optimizer) ტექნოლოგიას, რომელიც მონაცემთა პარალელიზმის (Data Parallelism) გამოყენებით საშუალებას გაძლევთ მაქსიმალურად გამოიყენოთ არსებული აპარატურა. ჩვენ განვიხილავთ ZeRO-ს სხვადასხვა სტადიას, ოპტიმიზატორის მდგომარეობების, გრადიენტებისა და მოდელის პარამეტრების დანაწილების ჩათვლით. სტატია აჩვენებს, თუ როგორ შეუძლია DeepSpeed ZeRO Stage-2-ს, Accele
როგორ გავხადოთ ხელოვნური ინტელექტის მოდელები უფრო სანდო: დინამიური მოწინააღმდეგე მონაცემთა შეგროვება MNIST-ის მაგალითზე
სტატიკური ბენჩმარკები ხელოვნური ინტელექტის მოდელების შეფასებისას მრავალ პრობლემას ქმნის. სტატია განიხილავს დინამიურ მოწინააღმდეგე მონაცემთა შეგროვების (DADC) მეთოდს, რომელიც ამცირებს ამ ნაკლოვანებებს და ხელს უწყობს სანდო მოდელების შექმნას. MNIST-ის მაგალითზე ნაჩვენებია, თუ როგორ შეუძლიათ ადამიანებს მოდელების „მოტყუება“ და მათი გაწვრთნა უფრო გამძლე სისტემების მისაღებად.
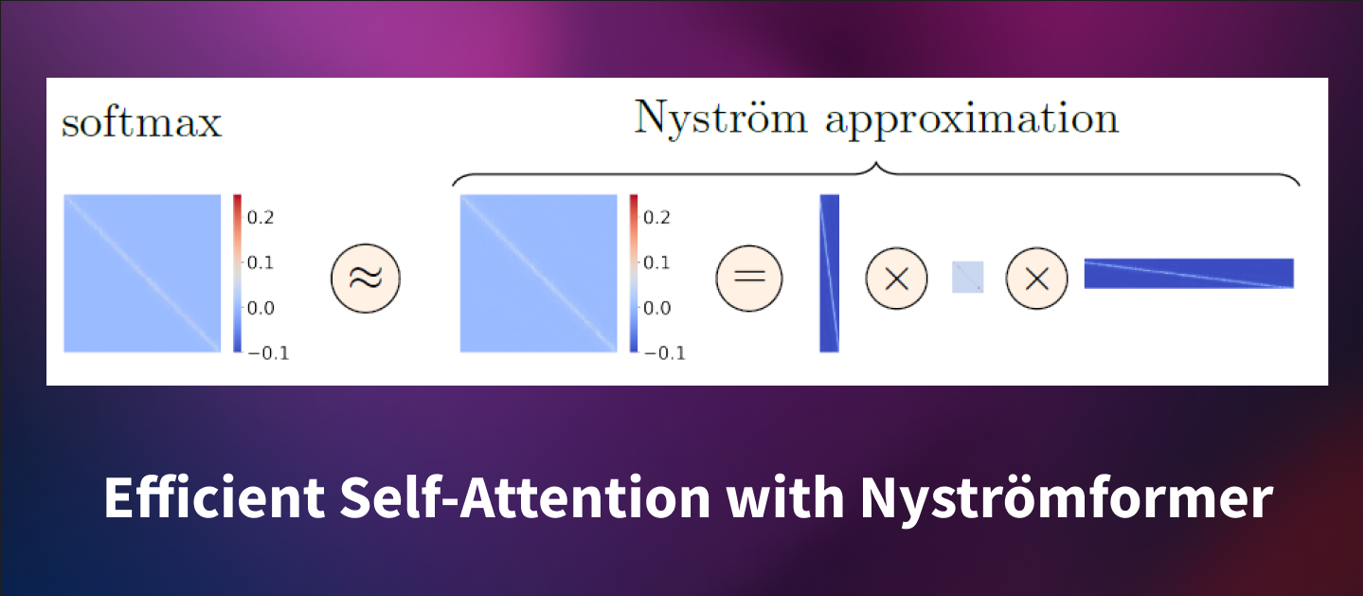
Nyströmformer: ტრანსფორმერების თვითყურადღების მექანიზმის ოპტიმიზაცია ნიუსტრიომის მეთოდით
ტრანსფორმერებმა შთამბეჭდავი შედეგები აჩვენეს ბუნებრივი ენის დამუშავებისა (NLP) და კომპიუტერული ხედვის (CV) ამოცანებში, თუმცა მათი სტანდარტული თვითყურადღების მექანიზმი ხასიათდება O(n²) სირთულით, რაც მის წვრთნას ძვირადღირებულს ხდის გრძელი თანმიმდევრობებისთვის. Nyströmformer წარმოადგენს ეფექტურ ტრანსფორმერულ მოდელს, რომელიც ნიუსტრიომის მეთოდის გამოყენებით სტანდარტულ თვითყურადღებას O(n) სირთულით აპროქსიმირებს. ეს სტატია განმარტავს ნიუსტრიომის მეთოდს და მის ადაპტირებას თვითყურადღების მექანიზმის ოპტიმ
Megatron-LM: დიდი ტრანსფორმერული მოდელების ოპტიმიზებული წვრთნა NVIDIA GPU-ებზე
ეს სტატია განიხილავს Megatron-LM-ს, NVIDIA-ს მძლავრ ფრეიმვორკს დიდი ტრანსფორმერული მოდელების წინა-წვრთნისთვის. მიუხედავად იმისა, რომ ის დამწყებთათვის შეიძლება რთული იყოს, Megatron-LM უაღრესად ოპტიმიზებულია GPU-ებზე წვრთნისთვის და გვთავაზობს მნიშვნელოვან აჩქარებას ისეთი მექანიზმების წყალობით, როგორიცაა ეფექტური DataLoader, Kernel Fusion და Fused AdamW. სტატიაში მოცემულია დეტალური გზამკვლევი GPT2 მოდელის წვრთნისთვის, მათ შორის გარემოს დაყენება, მონაცემთა წინასწარი დამუშავება და წვრთნის პარამეტრები

TRL წარმოგიდგენთ ახალ ალგორითმებს Vision Language მოდელების გასაუმჯობესებლად: MPO, GRPO და GSPO
Vision Language მოდელების (VLM) მუშაობის გაუმჯობესებაზე ფოკუსირებით, TRL-მა წარმოადგინა ინოვაციური ალგორითმები - შერეული პრეფერენციის ოპტიმიზაცია (MPO), ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO) და ჯგუფური თანმიმდევრობის პოლიტიკის ოპტიმიზაცია (GSPO). ეს მეთოდები სცილდება ტრადიციული DPO-ს ფარგლებს, რაც უზრუნველყოფს უფრო მდიდარი სიგნალების ამოღებას მონაცემებიდან, სტაბილურ წვრთნას და მნიშვნელოვან გაუმჯობესებას მოდელების პასუხებში, განსაკუთრებით მულტიმოდალურ ამოცანებში. მათი ინტეგრაცია TRL-ის
ოფლაინ გადაწყვეტილების ტრანსფორმატორის მოდელის გაწვრთნა: ნახევრად-გეპარდის სიმულაციის მიღწევა
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა გაწვრთნათ ოფლაინ გადაწყვეტილების ტრანსფორმატორის (Decision Transformer) მოდელი ნულიდან, რათა სიმულაციურ გარემოში ნახევრად-გეპარდმა შეძლოს მოძრაობა. განხილულია მოდელის ფუნდამენტური პრინციპები, რომელიც განმტკიცებით სწავლებას მიმდევრობის მოდელირების პრობლემად აღიქვამს და წარსული მონაცემებისა და სასურველი შედეგების საფუძველზე სამომავლო მოქმედებებს აგენერირებს. პრაქტიკული გაკვეთილი, რომელიც Google Colab-ზე სრულდება, ხსნის მონაცემთა დამუშავებასა და Hugging Fac
Hugging Face AutoTrain-ი კომპიუტერული ხედვისთვის: ნულოვანი კონფიგურაციით მაღალეფექტური მოდელები
Hugging Face-ის AutoTrain პლატფორმა ახლა უკვე კომპიუტერული ხედვის ამოცანებსაც უჭერს მხარს, მათ შორის გამოსახულების კლასიფიკაციას. ეს ინსტრუმენტი მომხმარებლებს საშუალებას აძლევს, გაწვრთნან მაღალეფექტური AI მოდელები ნულოვანი კონფიგურაციით, მონაცემების ატვირთვით და სასურველი ამოცანის არჩევით, რაც პროცესს ხელმისაწვდომს ხდის ტექნიკური გამოცდილების გარეშეც კი.