
Google Pixel 10a: როგორ მიიღოთ ახალი სმარტფონი უფასოდ Verizon-ისგან
ZDNET განმარტავს თავისი რეკომენდაციების მეთოდოლოგიას, რომელიც დაფუძნებულია მრავალსაათიან ტესტირებასა და კვლევაზე, რათა მომხმარებლებმა მიიღონ ინფორმირებული გადაწყვეტილებები. სტატია ყურადღებას ამახვილებს Google Pixel 10a-ის გამოშვებაზე, საშუალო დონის სმარტფონზე, რომლის საწყისი ფასი 499 დოლარია. Verizon გთავაზობთ Pixel 10a-ის უფასოდ მიღებას ახალი სატელეფონო ხაზის გახსნის შემთხვევაში, თუმცა აღნიშნულია, რომ „უფასო“ შეთავაზებებს, როგორც წესი, თან ახლავს გეგმის გამოწერები. Pixel 10a აღჭურვილია Tensor G

Google Pixel 10a: საშუალო კლასის მძლავრი სმარტფონი ფლაგმანური მახასიათებლებით
ახალი Google Pixel 10a წარმოდგენილია 499 დოლარის საწყისი ფასით, განახლებული ბრტყელი დიზაინით, გაუმჯობესებული კამერის შესაძლებლობებით, მათ შორის უმაღლესი დონის ხელოვნური ინტელექტის ხელსაწყოებით (როგორიცაა Auto Best Take და Camera Coach). მას აქვს უფრო ნათელი 6.3-ინჩიანი ეკრანი, გაზრდილი გამძლეობა, უფრო სწრაფი დატენვა და უსაფრთხოების ახალი ფუნქციები, მათ შორის სატელიტური SOS. ტელეფონი მუშაობს Tensor G4 ჩიპზე, რაც მას მიმზიდველ ვარიანტად აქცევს საშუალო კლასის სმარტფონების ბაზარზე.

Nemora Uncensored Chat: AI ჩეთბოტი თავისუფალი და ბუნებრივი დიალოგისთვის
Nemora Uncensored Chat არის ხელოვნური ინტელექტის ჩეთბოტი, რომელიც შექმნილია ღია და შეუზღუდავი დიალოგის მხარდასაჭერად, ფილტრებისა და სკრიპტული პასუხების გარეშე. სტატია დეტალურად აღწერს Nemora-ს მომხმარებლის გამოცდილებას, მის ინტუიციურ ინტერფეისს და ფასების მოქნილ მოდელს. ასევე მიმოხილვაში მოცემულია სხვა ტრენდული შეუზღუდავი AI ჩეთბოტები, როგორიცაა Candy AI, Mydreamcompanion და Promptchan, რომლებიც ფოკუსირებულია მომხმარებლის კონტროლსა და კრეატიულ თავისუფლებაზე.

Google Pixel 10a-ის წინასწარი შეკვეთა AT&T-ზე: დაზოგეთ 70%-ზე მეტი და მიიღეთ უფასო Pixel Buds
AT&T აცხადებს Google Pixel 10a-ის წინასწარი შეკვეთის სპეციალურ შეთავაზებას, რაც მომხმარებლებს 70%-ზე მეტის დაზოგვის საშუალებას აძლევს შეუზღუდავი მობილური გეგმის გააქტიურებისას. შეთავაზება მოიცავს Google Pixel 10a-ის მიღებას თვეში მხოლოდ $3.99-ად და Google Pixel Buds 2a-ის უფასოდ, ონლაინ შეძენის შემთხვევაში. ახალ Pixel 10a-ს აქვს Google Tensor G4 S5400 პროცესორი, 128GB მეხსიერება, 30-საათიანი ბატარეა (120 საათი ექსტრემალური რეჟიმში), 6.3-ინჩიანი OLED ეკრანი, ორმაგი კამერა და სატელიტური SOS მხარდა

Google Pixel 10a წარდგენილია: დიზაინის, კამერისა და AI-ს გაუმჯობესებები 499 დოლარად
Google-მა ოფიციალურად წარადგინა Pixel 10a, რომელიც გამოირჩევა გაუმჯობესებული დიზაინით, მათ შორის სრულად სწორი კამერის პანელით უკანა მხარეს. 499 დოლარიან ფასად, ახალი მოდელი გთავაზობთ კამერისა და ხელოვნური ინტელექტის ინსტრუმენტებს, რომლებიც ადრე მხოლოდ Pixel 10-ისა და Pro მოდელებისთვის იყო ხელმისაწვდომი. ის აღჭურვილია Tensor G4 ჩიპით, უფრო კაშკაშა ეკრანით, გაუმჯობესებული ბატარეით და IP68 დაცვით, ასევე, A-სერიისთვის პირველად, Satellite SOS ფუნქციით. Pixel 10a ბაზარზე 5 მარტიდან გამოვა.
BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან
Hugging Face აუმჯობესებს BERT მოდელების ინფერენციის სიჩქარეს: დეტალური ბენჩმარკინგი და CPU ოპტიმიზაცია
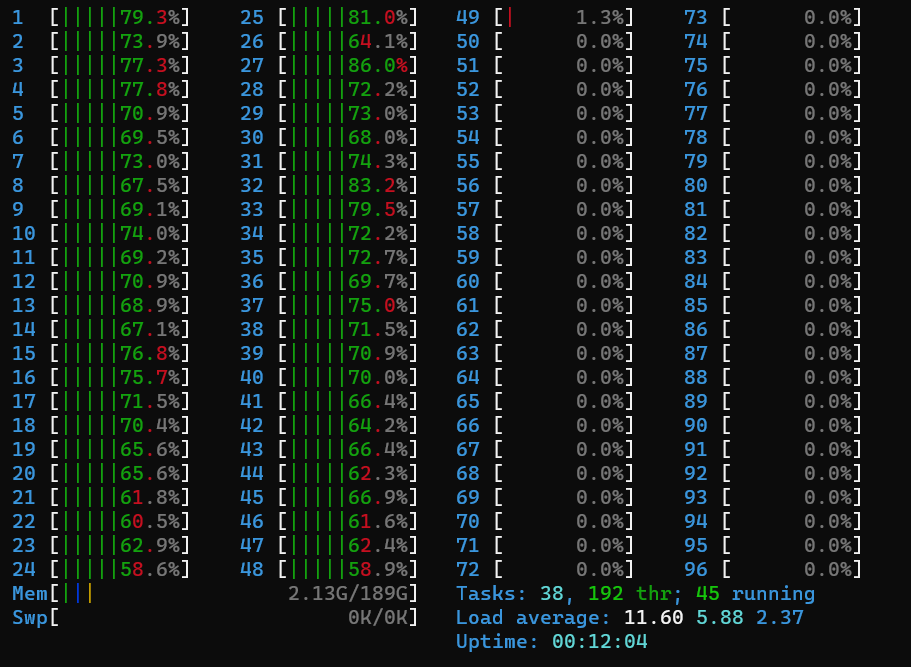
Hugging Face წარმოგიდგენთ განახლებულ ბენჩმარკინგის მეთოდოლოგიას და ახალ Inference API-ს, რათა ხელი შეუწყოს BERT-ის მსგავსი მოდელების ეფექტურ განლაგებასა და გაშვებას წარმოებაში. სტატია განიხილავს CPU-ზე დაფუძნებულ ტექნიკურ და პროგრამულ ოპტიმიზაციებს, აანალიზებს PyTorch-ისა და TensorFlow-ის მუშაობას და წარმოგიდგენთ მომავალ გაუმჯობესებებს, როგორიცაა კვანტიზაცია, დისტილაცია და პრუნინგი. მიზანია მომხმარებლებს გაუადვილდეს მოდელების ოპტიმიზებული სახით გამოყენება და ღირებულების შექმნაზე ფოკუსირება.
Hugging Face-ის სიახლეები: ივნისი, ივლისი, აგვისტო
ბოლო თვეებში Hugging Face Hub მნიშვნელოვნად გაფართოვდა, დაინერგა „Spaces“ მანქანური სწავლების დემო აპლიკაციებისთვის, ასევე დაემატა ახალი ფუნქციები, როგორიცაა რეპოზიტორების მოწონება, TensorBoard-ის ინტეგრაცია და შეფასების დეტალური მეტრიკა. დაინერგა ახალი ვიჯეტები სხვადასხვა ხელოვნური ინტელექტის მოდელებისთვის (ტექსტი, აუდიო, გამოსახულება). პლატფორმამ გააუმჯობესა დოკუმენტაცია, რეპოზიტორების მართვა და გამოუშვა უფასო ონლაინ კურსი. დიდი საზოგადოებრივი ღონისძიება, რომელშიც 800-მდე მონაწილე იყო ჩართული,
Hugging Face-ის ზაფხულის განახლებები: ივნისი, ივლისი, აგვისტო
ეს პოსტი აჯამებს Hugging Face-ის ივნის-აგვისტოს განახლებებს, მათ შორის საჯარო მოდელების რეპოზიტორიების 10,000-დან 16,000-მდე ზრდას. წარმოდგენილია ახალი ფუნქციები, როგორიცაა „Spaces“ ML დემო აპლიკაციების ჰოსტინგისთვის, ნივთების „მოწონების“ შესაძლებლობა, TensorBoard-ის ინტეგრაცია, შეფასების მეტრიკები, რომლებიც დაკავშირებულია Papers With Code-თან, ახალი ვიჯეტები სხვადასხვა ML ამოცანებისთვის (აუდიო, სტრუქტურირებული მონაცემები, გამოსახულება), გაუმჯობესებული დოკუმენტაცია, რეპოზიტორიების გადატანა/გადარ
CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
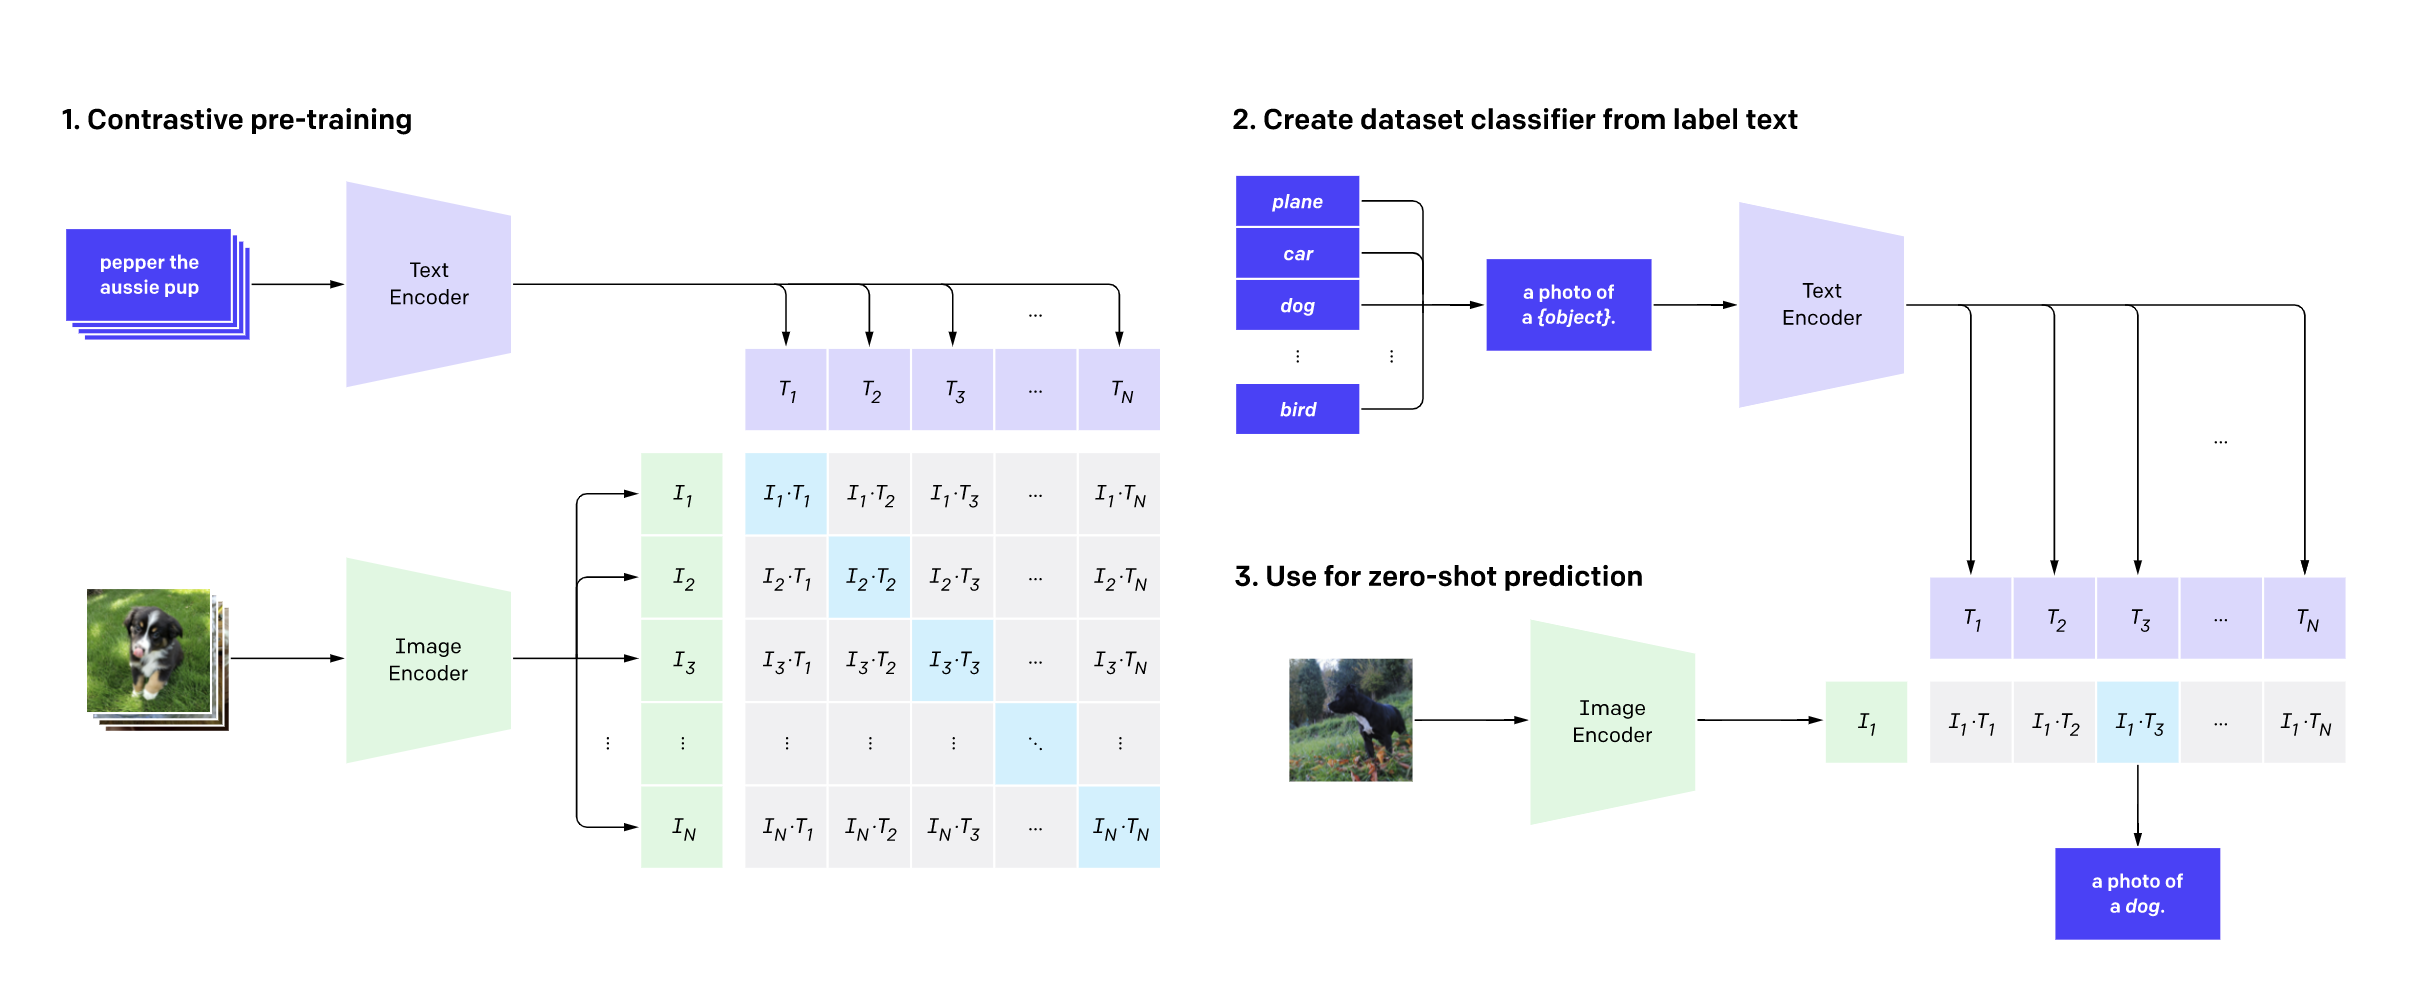
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ
Intel Xeon Ice Lake: AI ამოცანების ოპტიმიზაცია პროგრამული გაუმჯობესებებით
Intel-ის უახლესი Ice Lake თაობის Xeon პროცესორები მნიშვნელოვან გაუმჯობესებას გვთავაზობს ხელოვნური ინტელექტის (AI) ამოცანებისთვის, განსაკუთრებით პროგრამული ოპტიმიზაციების დახმარებით. სტატია დეტალურად განიხილავს, თუ როგორ უზრუნველყოფს Intel-ი მაღალ ეფექტურობას AVX512, VNNI და oneAPI კომპონენტების, როგორიცაა oneMKL და oneDNN, მეშვეობით, ასევე სპეციალიზებული ფრეიმვორკებით, როგორიცაა Intel TensorFlow და PyTorch Extension. მიმოხილულია აპარატურული და პროგრამული ინოვაციების კომბინაცია, რამაც Ice Lake-ს
Intel Xeon Ice Lake: პროგრამული ოპტიმიზაციები ხელოვნური ინტელექტის ამოცანებისთვის
ეს ბლოგპოსტი დეტალურად განიხილავს Intel-ის ახალი Ice Lake თაობის Xeon CPU-ების პროგრამულ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს ხელოვნური ინტელექტის (AI) დატვირთვების ეფექტურობის გაზრდას. აღწერილია, თუ როგორ იყენებს Intel როგორც აპარატურულ, ასევე პროგრამულ გაუმჯობესებებს, რათა მიაღწიოს 75%-ით უფრო სწრაფ ინფერენციას NLP ამოცანებში. სტატია ხაზს უსვამს Intel-ის როლს წამყვანი AI ფრეიმვორკების (როგორიცაა TensorFlow და PyTorch) ოპტიმიზაციაში, oneAPI ბიბლიოთეკების მნიშვნელობას მაღალი წარმადობისთვის, და
ONNX Runtime მნიშვნელოვნად აჩქარებს SD Turbo-სა და SDXL Turbo-ს NVIDIA GPU-ებზე
SD Turbo და SDXL Turbo, Stable Diffusion-ის სწრაფი, გენერაციული ტექსტიდან გამოსახულების მოდელები, რომლებსაც შეუძლიათ გამოსაყენებელი სურათების გენერირება ერთ ნაბიჯში, ახლა ONNX Runtime-ის მეშვეობით კიდევ უფრო სწრაფი ხდება. ONNX Runtime-ის CUDA და TensorRT შესრულების პროვაიდერებში ოპტიმიზაციებმა გამოიწვია გამტარუნარიანობის 229%-მდე ზრდა SDXL Turbo-სთვის და 120%-მდე SD Turbo-სთვის NVIDIA GPU-ებზე, რაც მნიშვნელოვნად აღემატება PyTorch-ის მაჩვენებლებს. ეს გაუმჯობესება, გარდა შესრულების უპირატესობებისა
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ
Hugging Face-ი და NVIDIA-ი „ტრენინგს DGX Cloud-ზე“ უშვებენ Enterprise Hub-ის ორგანიზაციებისთვის
Hugging Face-მა NVIDIA-სთან ერთად წარადგინა „ტრენინგი DGX Cloud-ზე“, ახალი სერვისი Hugging Face Hub-ზე, რომელიც განკუთვნილია Enterprise Hub-ის ორგანიზაციებისთვის. ეს პლატფორმა მომხმარებლებს აძლევს მყისიერ წვდომას NVIDIA H100 Tensor Core GPU-ებზე, რათა მარტივად დახვეწონ პოპულარული გენერაციული AI მოდელები, როგორიცაა Llama, Mistral და Stable Diffusion. სერვისი ამარტივებს ხელოვნური ინტელექტის მოდელების წვრთნის პროცესს კოდის გარეშე მუშაობის (no-code) და მოხმარების მიხედვით გადახდის (pay-as-you-go) მო
Hugging Face-ი NVIDIA-სთან პარტნიორობით „Train on DGX Cloud“ სერვისს უშვებს Enterprise Hub ორგანიზაციებისთვის
Hugging Face-ი, NVIDIA-სთან ერთად, წარმოგიდგენთ „Train on DGX Cloud“-ს – ახალ სერვისს, რომელიც ხელმისაწვდომია Enterprise Hub ორგანიზაციებისთვის Hugging Face Hub-ზე. ეს პლატფორმა ამარტივებს ღია მოდელების გამოყენებას NVIDIA DGX Cloud-ის მაღალსიჩქარიან გამოთვლით ინფრასტრუქტურასთან. სერვისი მომხმარებლებს აძლევს მყისიერ წვდომას უახლეს NVIDIA H100 Tensor Core GPU-ებზე, რაც მათ საშუალებას აძლევს, მარტივად დააზუსტონ პოპულარული გენერაციული AI მოდელები, როგორიცაა Llama, Mistral და Stable Diffusion. „Train
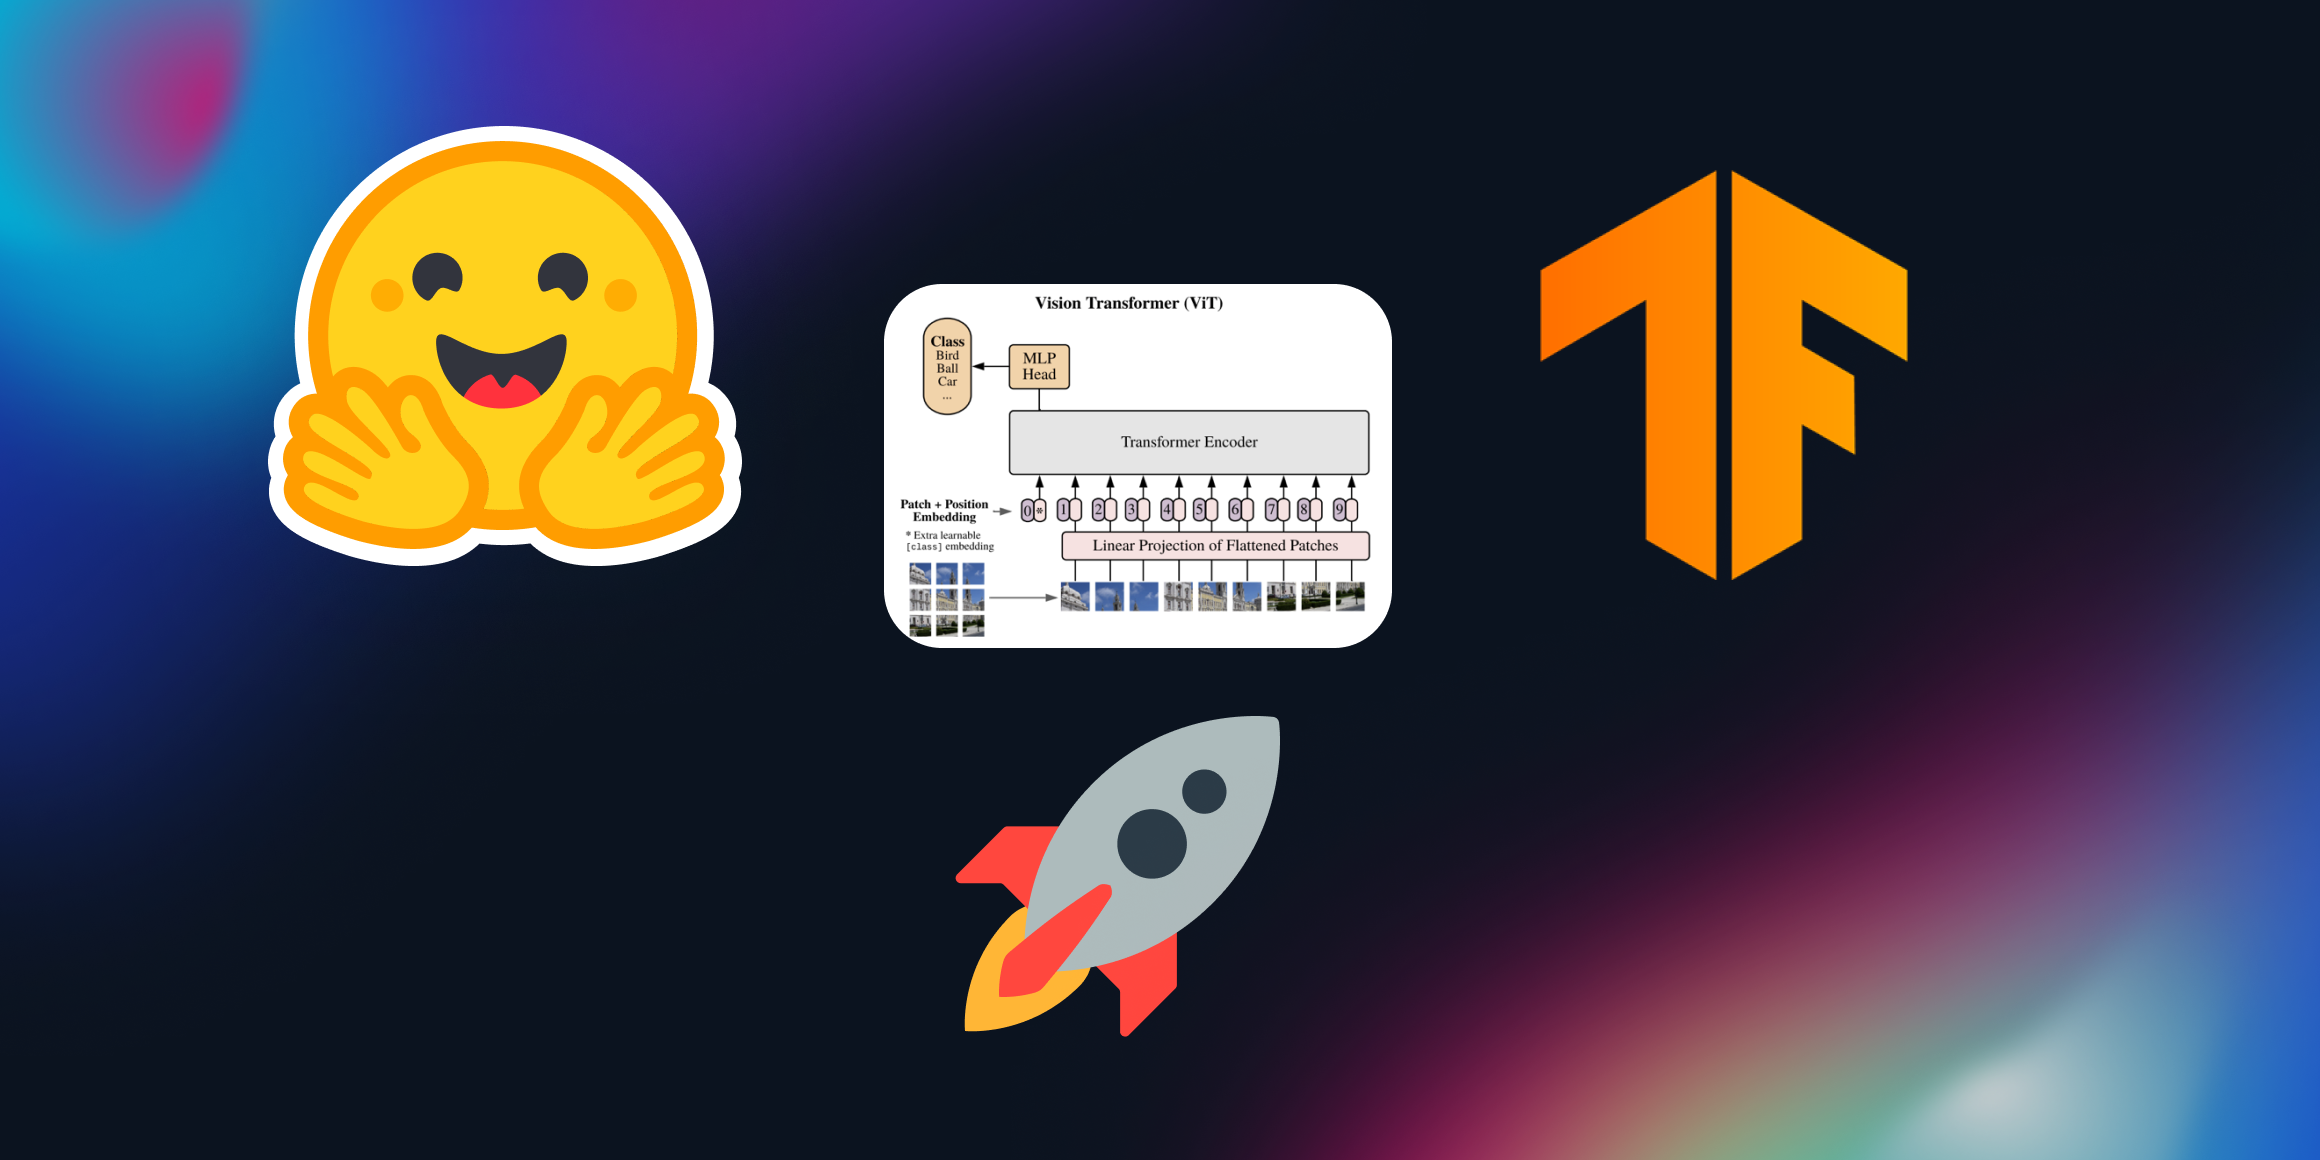
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.

TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო
Hugging Face Datasets: ახალი შესაძლებლობები აუდიო და გამოსახულების მონაცემებთან მუშაობისთვის
Hugging Face Datasets ბიბლიოთეკა აფართოებს თავის მხარდაჭერას ტექსტური მონაცემთა ნაკრებების მიღმა, რათა მოიცვას აუდიო და გამოსახულების ფორმატები. განახლებები მოიცავს ახალ ინსტრუმენტებს, როგორიცაა ImageFolder გამოსახულების მონაცემთა ნაკრებების მარტივად ჩატვირთვისა და მართვისთვის, to_tf_dataset ფუნქცია TensorFlow-თან ინტეგრაციის გასამარტივებლად და გაუმჯობესებულ დოკუმენტაციას სხვადასხვა მონაცემთა მოდალობასთან მუშაობისთვის. ეს ცვლილებები მიზნად ისახავს დეველოპერებისთვის მოდელების გაწვრთნისა და აპლიკა
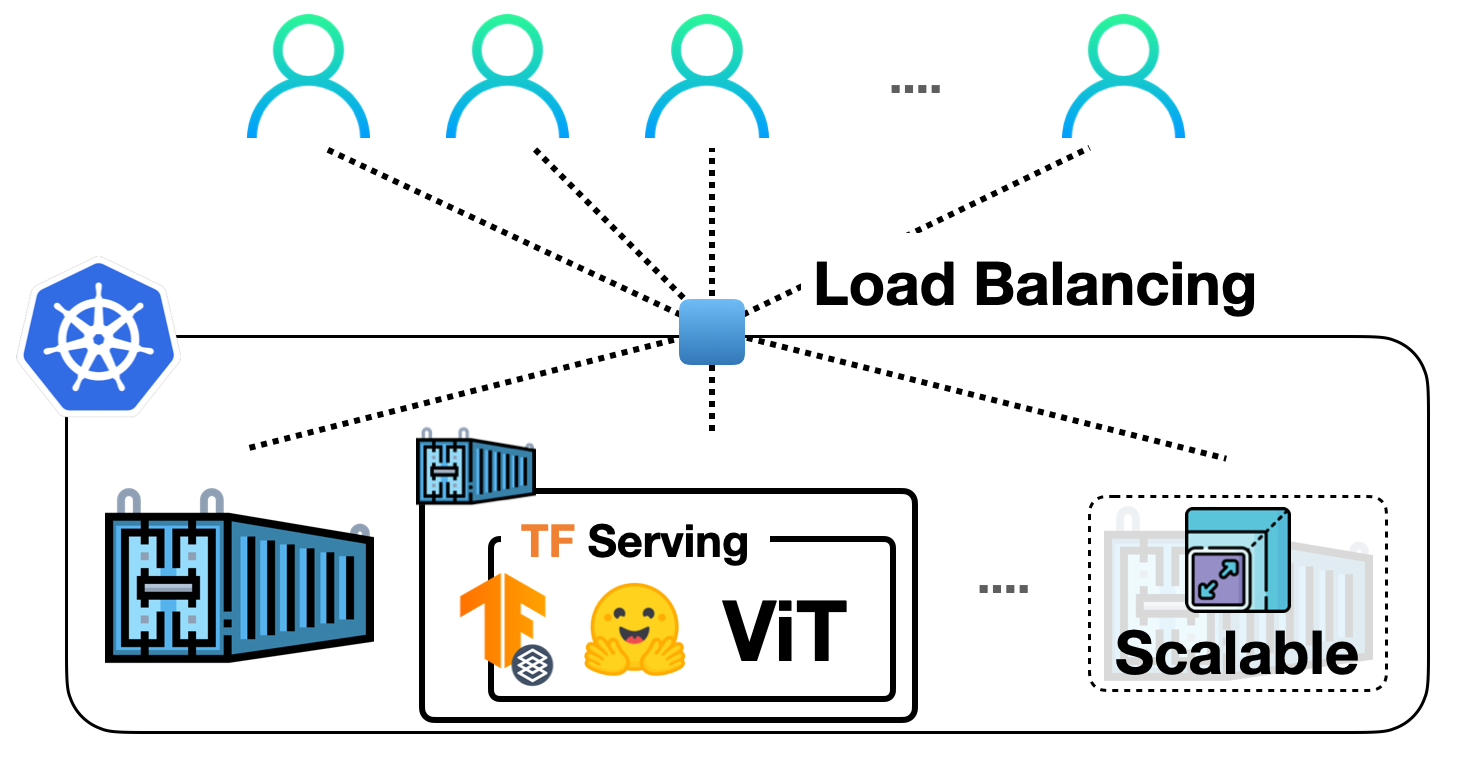
ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
Hugging Face-ის ტრანსფორმატორები TensorFlow-ის ინჟინრებისთვის: გზამკვლევი
სტატია განიხილავს PyTorch-ის ინჟინრების მიერ TensorFlow-თან მიდგომის ხშირ შეცდომას, კერძოდ, Keras-ის მაღალი დონის API-ის უგულებელყოფას. ხაზგასმულია, რომ Keras-ის გამოყენება TensorFlow-სთან ოპტიმალურია. შემდეგ წარმოდგენილია Hugging Face-ის ტრანსფორმატორები, როგორც ძლიერი ინსტრუმენტები, რომლებიც TensorFlow-ის ინჟინრებს საშუალებას აძლევს, გამოიყენონ უახლესი მოდელები ნაცნობი Keras API-ის მეშვეობით. დეტალურად არის ახსნილი ტრანსფერული სწავლის (transfer learning) კონცეფცია, როგორც ML პრობლემების გადაჭრ
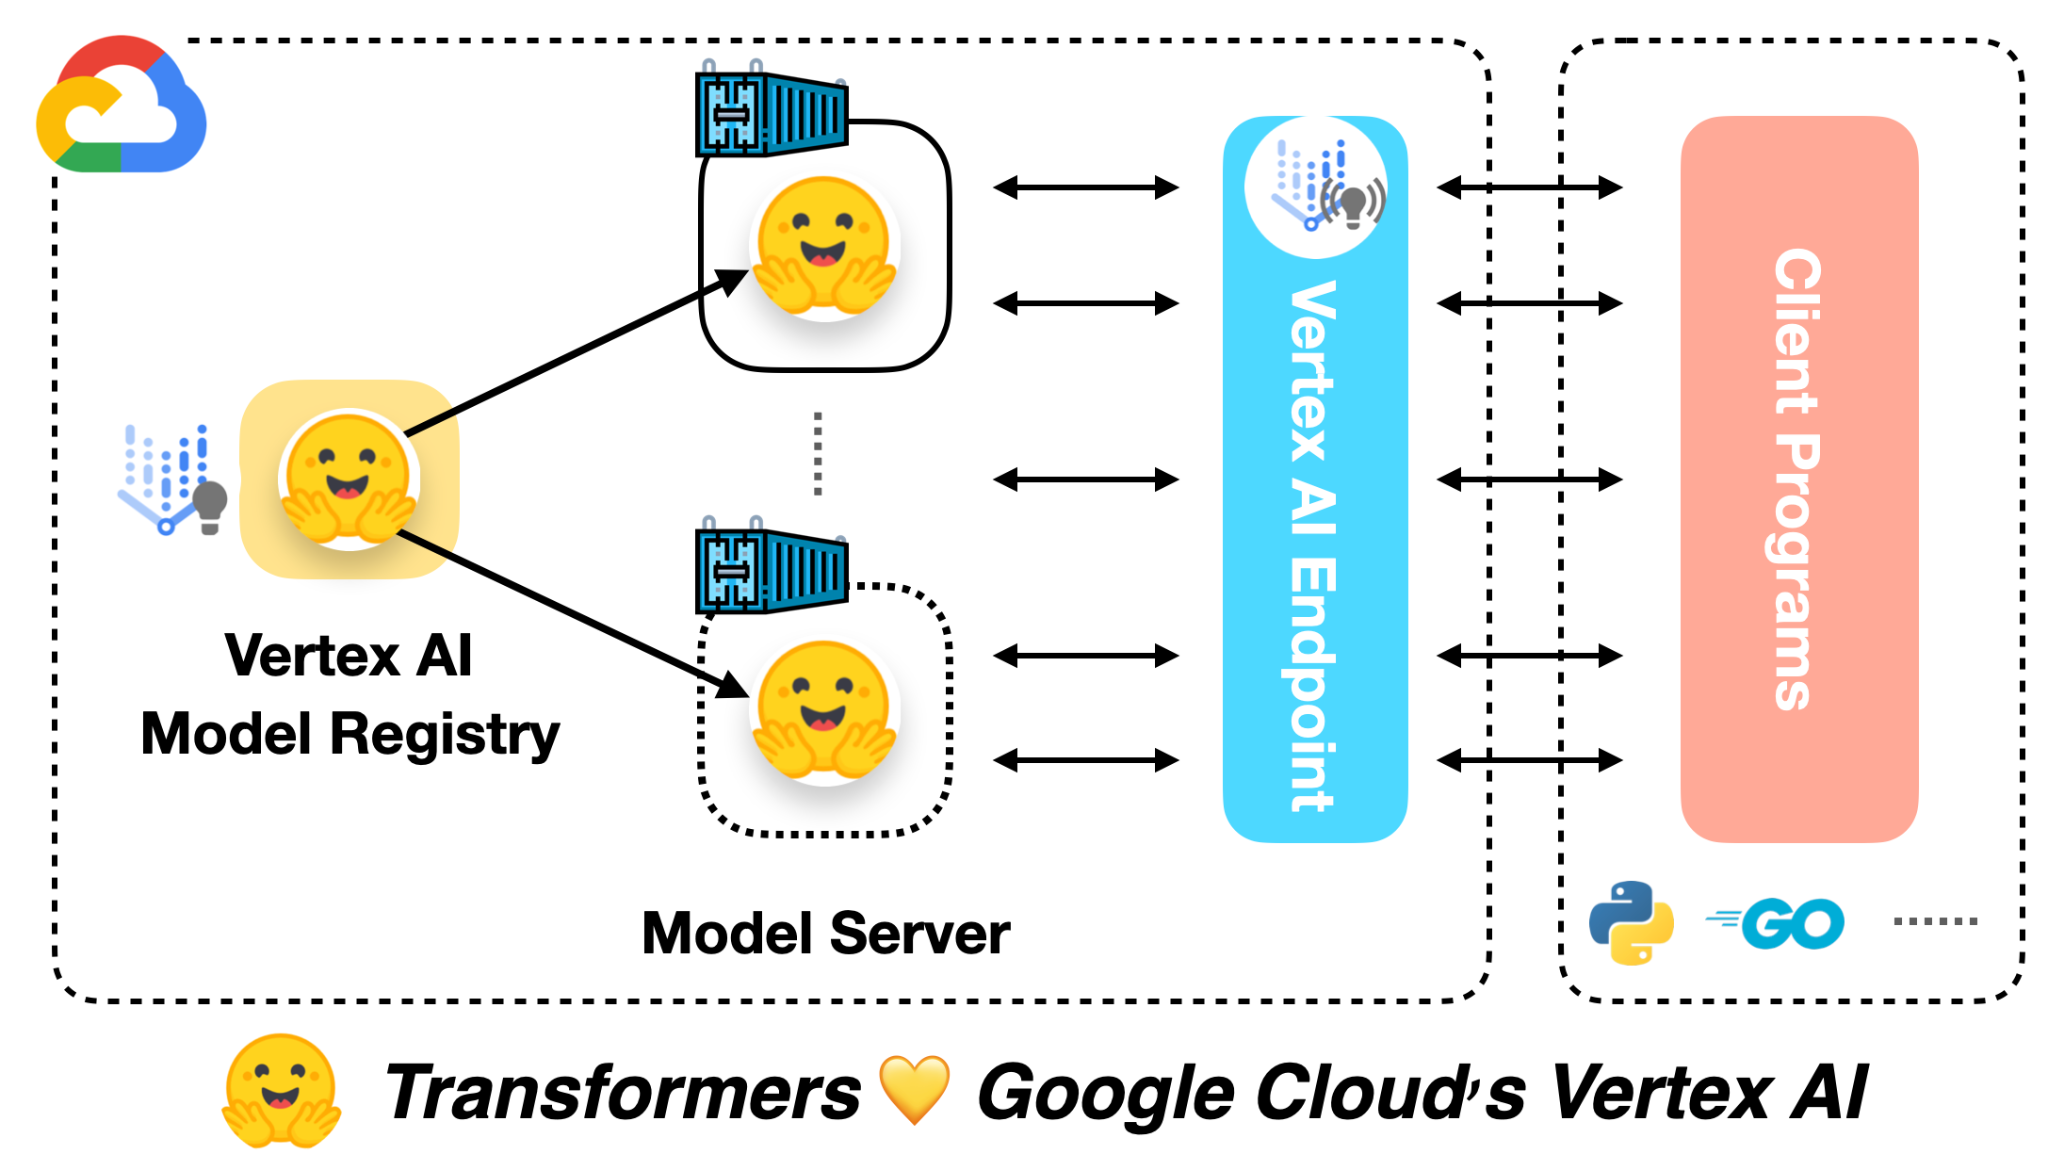
Vertex AI-ის გამოყენება ML მოდელების განლაგებისთვის: დეტალური მიმოხილვა
ეს პუბლიკაცია განიხილავს Google Cloud-ის Vertex AI პლატფორმის შესაძლებლობებს მანქანური სწავლის (ML) მოდელების განლაგებისთვის. ის მოიცავს ისეთ ფუნქციებს, როგორიცაა აუთენტიფიკაცია, ავტომატური სკალირება, მოდელის ვერსიონირება და მონიტორინგი, ასევე TensorFlow მოდელებთან მუშაობის სპეციფიკას. განმარტებულია Vertex AI Model Registry-ის და Endpoint-ის როლი, და მოცემულია განლაგების ნაბიჯ-ნაბიჯ ინსტრუქცია Python SDK-ის გამოყენებით.

KerasHub-ისა და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი ხდება 300 ათასზე მეტი AI მოდელი
KerasHub-მა და Hugging Face-მა მნიშვნელოვანი ნაბიჯი გადადგეს წინ, წარმოადგინეს მოდელების შენახვის საერთო ფორმატი, რომელიც KerasHub-ის მომხმარებლებს საშუალებას აძლევს პირდაპირ გამოიყენონ Transformers ბიბლიოთეკის 300 ათასზე მეტი მოდელი Hugging Face Hub-იდან. ეს ინტეგრაცია მნიშვნელოვნად აფართოებს მოდელების არჩევანსა და შესაძლებლობებს, მხარს უჭერს TensorFlow, JAX და PyTorch უკანა სისტემებს, რაც ამარტივებს AI მოდელების განთავსებას და კვლევას. თავდაპირველად ფოკუსირებულია Gemma (1 და 2), Llama 3 და Pal