
LLM-ების ოპტიმიზაცია: TRL-ის ახალი მიდგომა GRPO სწავლების მეხსიერების შესამცირებლად
დიდი ენობრივი მოდელების (LLM) დახვეწა განმტკიცებითი სწავლის (RL) გამოყენებით გადამწყვეტია რთული ქცევების მისაღწევად. ტრადიციულად ამისთვის გამოიყენება PPO ალგორითმი RLHF-თან ერთად, რაც, თუმცა, რესურსმომხმარებელია და მრავალი მოდელის მეხსიერებაში ჩატვირთვას მოითხოვს. DeepSeek-ის R1 მოდელთან ერთად პოპულარობას იძენს ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO), რომელიც იყენებს შემოწმებად ჯილდოს ფუნქციებს გარე ჯილდოს მოდელის გარეშე, რაც მნიშვნელოვან გაუმჯობესებას იძლევა. მიუხედავად ამისა, RL სწავლე
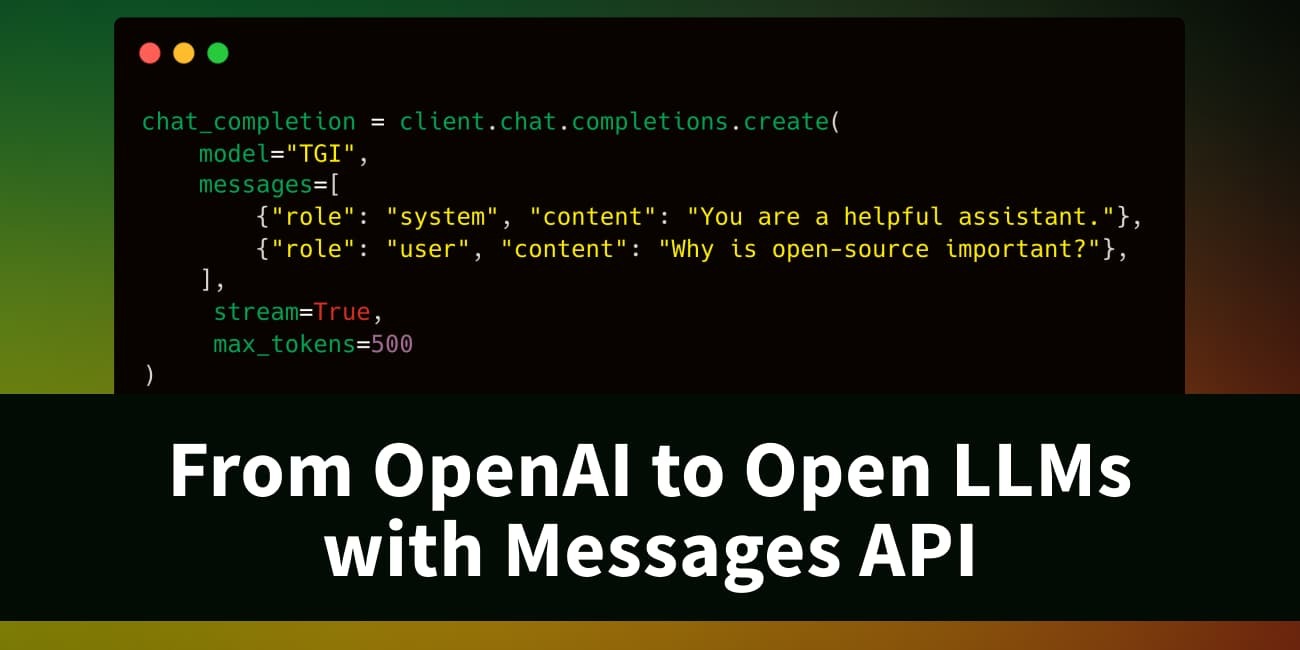
TGI-ის Messages API: OpenAI-თან თავსებადობა და შეუფერხებელი გადასვლა ღია LLM-ებზე
TGI-ის (Text Generation Inference) ვერსია 1.4.0-დან დაწყებული, ხელმისაწვდომია ახალი Messages API, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-სთან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდ ენობრივ მოდელებზე (LLM). API შეიძლება გამოყენებულ იქნას OpenAI-ის კლიენტის ბიბლიოთეკებთან ან მესამე მხარის ხელსაწყოებთან, როგორიცაა LangChain და LlamaIndex. Messages API ასევე ხელმისაწვდომია Hugging Face-ის Inference Endpoints-ზე
TGI-ის Messages API: უწყვეტი გადასვლა ღია LLM-ებზე OpenAI-ის თავსებადობით
TGI (Text Generation Inference) 1.4.0 ვერსიიდან მოყოლებული, გთავაზობთ Messages API-ს, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-თან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდი ენის მოდელებზე (LLM-ებზე), არსებული კლიენტის ბიბლიოთეკების ან მესამე მხარის ხელსაწყოების (როგორიცაა LangChain და LlamaIndex) გამოყენებით. სტატია დეტალურად აღწერს მოდელების Hugging Face Inference Endpoints-ზე განთავსების, ტექნიკური კონფიგურაც
TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.
TRL და vLLM: GPU-ის ეფექტურობის ახალი ერა კოლოკაციის წყალობით
TRL-ის ბიბლიოთეკამ მნიშვნელოვანი სიახლე დანერგა, რაც LLM-ების (დიდი ენობრივი მოდელების) წვრთნის პროცესს vLLM-თან GRPO ალგორითმის გამოყენებით უფრო ეფექტურს ხდის. ადრე vLLM სერვერის რეჟიმში მუშაობდა, რაც GPU-ის რესურსების არაეფექტურ გამოყენებასა და უმოქმედო დროს იწვევდა. ახალი „კოლოკაციის“ რეჟიმი წვრთნისა და ინფერენციის ერთსა და იმავე GPU-ებზე, ერთსა და იმავე პროცესთა ჯგუფში გაშვების საშუალებას იძლევა, რაც მნიშვნელოვნად ზრდის შესრულებას, ამცირებს აპარატურულ დანახარჯებს და ამარტივებს დეპლოირებას.
Hugging Face და AMD აძლიერებენ ხელოვნური ინტელექტის განვითარებას AMD GPU-ებზე
Hugging Face-ი და AMD-ი აცხადებენ მნიშვნელოვან პროგრესს AMD GPU-ებზე დიდი ენობრივი მოდელების (LLM) მხარდაჭერაში, რაც უზრუნველყოფს ტრანსფორმერული მოდელების უწყვეტ გაშვებას კოდის შეცვლის გარეშე. დამატებითი აჩქარების ინსტრუმენტები, როგორიცაა ONNX, Optimum-Benchmark და DeepSpeed, უკვე მხარდაჭერილია. კომპანიები ასევე ხელს უწყობენ დეველოპერებს PC AI კონკურსის ფარგლებში ინოვაციური AI აპლიკაციების შექმნაში AMD Ryzen AI-ით აღჭურვილ კომპიუტერებზე.
პერსონალიზებული AI მოდელები LLM-ების დახმარებით: დაზოგეთ ხარჯები და გაზარდეთ ეფექტურობა
სტატია განიხილავს პერსონალიზებული ხელოვნური ინტელექტის (AI) მოდელების დახვეწასა და LLM API-ების გამოყენებას შორის არსებულ დილემას, შემდეგ კი წარმოადგენს ინოვაციურ ჰიბრიდულ მიდგომას. ეს მეთოდი იყენებს ღია კოდის LLM-ებს მაღალი ხარისხის სინთეზური მონაცემების გენერირებისთვის, რათა მოამზადოს სპეციალიზებული მოდელები. შემთხვევის შესწავლა აჩვენებს ხარჯების, ენერგიის მოხმარების და დაყოვნების დროის მნიშვნელოვან გაუმჯობესებას GPT-4-ის მსგავს დიდ LLM API-ებთან შედარებით, პარალელურად ინარჩუნებს მსგავს ეფექტუ
Open Ko-LLM ლიდერბორდი: კორეული ხელოვნური ინტელექტის განვითარების ახალი ეტაპი
Upstage-მა 2023 წლის სექტემბერში Open Ko-LLM ლიდერბორდი წარადგინა, რომლის მიზანიც კორეული დიდი ენობრივი მოდელების (LLM) შეფასების ეკოსისტემის შექმნა და გამჭვირვალობის ხელშეწყობა იყო. პლატფორმა, რომელიც კორეული ენის უნიკალურ მახასიათებლებს ითვალისწინებს, მოკლე დროში დიდი პოპულარობით სარგებლობს, 5 თვეში 1000-ზე მეტი მოდელის წარდგენით. მიუხედავად ინფრასტრუქტურული გამოწვევებისა, ლიდერბორდი აქტიურად ვითარდება, რათა რეალურ სამყაროში გამოყენების შემთხვევებს უკეთ მოერგოს და კორეული AI-ის განვითარებას ხე

KV ქეშირება nanoVLM-ში: 38%-იანი აჩქარება გენერაციაში
ეს ბლოგ-პოსტი აღწერს KV ქეშირების ტექნიკას, რომელიც nanoVLM საცავში ნულიდან დავნერგეთ და რომელმაც ენობრივი მოდელების გენერაციაში 38%-იანი აჩქარება მოგვცა. სტატია განმარტავს ავტორეგრესიულ მოდელებში გამოთვლითი სიჭარბის პრობლემას და იმას, თუ როგორ აგვარებს მას KV ქეშირება Q, K, V მნიშვნელობების შენახვით. მოცემულია თეორიული საფუძვლები, nanoVLM-ში პრაქტიკული იმპლემენტაცია და ზოგადი გაკვეთილები, რომლებიც ყველა ავტორეგრესიული ენობრივი მოდელის გენერაციას ეხება. ეს ოპტიმიზაცია აუცილებელია LLM-ების ეფექტუ
Google-მა Gemma, უახლესი ღია LLM-ების ოჯახი გამოუშვა
Google-მა დღეს გამოუშვა Gemma, ხელოვნური ინტელექტის (AI) უახლესი ღია ენის მოდელების (LLM) ოჯახი, რაც აძლიერებს კომპანიის ერთგულებას ღია კოდის AI მიმართ. Gemma ხელმისაწვდომია ორი ზომის (7B და 2B პარამეტრი) და ორი ვარიანტის (ძირითადი და ინსტრუქციებზე მორგებული) სახით. ის შექმნილია ეფექტური გამოყენებისთვის სხვადასხვა მოწყობილობაზე, მათ შორის სამომხმარებლო GPU-ებზე, CPU-ებზე და ჩაშენებულ სისტემებზე. Hugging Face-თან თანამშრომლობით უზრუნველყოფილია სრული ინტეგრაცია და ყველა ვარიანტი ხელმისაწვდომია Hug
Haize Labs-ი Hugging Face-ის მხარდაჭერით LLM-ების „წითელი გუნდის“ წინააღმდეგობის ახალ ბენჩმარკს წარადგენს
ხელოვნური ინტელექტის (AI) სფეროში, დიდი ენობრივი მოდელების (LLM) უსაფრთხოებასა და არასასურველ ქცევებთან დაკავშირებით მზარდი შეშფოთებაა. ამ გამოწვევის საპასუხოდ, Haize Labs-მა, Hugging Face-ის გუნდის მხარდაჭერით, შექმნა „Red Teaming Resistance Benchmark“ – ახალი საორიენტაციო სისტემა. ის მიზნად ისახავს უახლესი LLM მოდელების მდგრადობის შემოწმებას ადამიანის მიერ შემუშავებული, დახვეწილი „წითელი გუნდის“ (red teaming) შეტევების გამოყენებით, რათა გამოავლინოს მათი სისუსტეები და მოწყვლადობები. ბენჩმარკი ფ

vLLM-ის ოპტიმიზაცია: პრეფილის სტრატეგიები და გრძელი მოთხოვნების მართვა
სტანდარტულად, vLLM-ში პრეფილის ფაზა თანმიმდევრულად ამუშავებს მოთხოვნებს, რაც პრობლემური ხდება გრძელი "პრომპტების" შემთხვევაში, რადგან მათ შეუძლიათ შეაფერხონ შემდგომი მოთხოვნები და გაზარდონ შეყოვნება. მიუხედავად იმისა, რომ პარალელური პრეფილის მცდელობები არსებობდა, ისინი რესურსების ოპტიმიზაციის პრობლემებს აწყდებოდნენ. vLLM-ის უახლესმა განახლებამ წარმოადგინა გაუმჯობესებული სტრატეგია, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას გრძელი მოთხოვნების შეფერხების გარეშე, რაც მნიშვნელოვ
vLLM-ის ოპტიმიზაცია: პრეფილისა და დეკოდირების გამოწვევების დაძლევა
ეს სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაციის გამოწვევებს vLLM-ში, განსაკუთრებით "პრეფილის" ფაზაში, სადაც გრძელ პრომპტებს შეუძლიათ შეაფერხონ მომდევნო მოთხოვნები. იგი აღწერს გაუმჯობესებულ სტრატეგიას, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას, ხოლო გრძელი მოთხოვნებისთვის თანმიმდევრულ დამუშავებას ინარჩუნებს. ასევე წარმოდგენილია "დეზაგრეგირებული პრეფილი" – უფრო რადიკალური გადაწყვეტა ტოკენის გენერაციის შენელების აღმოსაფხვრელად, თუმცა რესურსების უფრო
წარმოგიდგენთ StarCoder2-ს: ინოვაცია პროგრამირების ენობრივ მოდელებში
StarCoder2 არის ღია კოდის დიდი ენობრივი მოდელების (LLM) ოჯახი, შექმნილი კოდის გენერაციისა და ანალიზისთვის. ის ხელმისაწვდომია სამი ზომის ვარიანტში – 3B, 7B და 15B პარამეტრით. ფლაგმანი StarCoder2-15B მოდელი გაწვრთნილია 4 ტრილიონზე მეტ ტოკენსა და 600-ზე მეტ პროგრამირების ენაზე The Stack v2 მონაცემთა ბაზიდან, რაც მას თავის ზომის კლასში საუკეთესოდ აქცევს და კონკურენციას უწევს 33B+ ზომის მოდელებს. პროექტი არის BigCode-ის თანამშრომლობის ნაწილი, რომელიც მიზნად ისახავს კოდისთვის განკუთვნილი LLM-ების პასუ

Groq Hugging Face Hub-ის დასკვნის პროვაიდერებს უერთდება: ხელოვნური ინტელექტის აჩქარება LPU ტექნოლოგიით
Hugging Face Hub-მა განაცხადა, რომ Groq ახლა მისი მხარდაჭერილი დასკვნის პროვაიდერია. ეს ინტეგრაცია მნიშვნელოვნად აფართოებს სერვერული დასკვნის შესაძლებლობებს Hub-ის მოდელის გვერდებზე, განსაკუთრებით LPU™-ზე დაფუძნებული ტექნოლოგიით, რომელიც უზრუნველყოფს ულტრა-დაბალ შეყოვნებასა და მაღალ გამტარუნარიანობას დიდ ენობრივ მოდელებზე (LLMs) დაფუძნებული რეალურ დროში ხელოვნური ინტელექტის აპლიკაციებისთვის.
წარდგენა Quanto-სი: PyTorch-ის კვანტიზაციის ახალი ბეკენდი ხელოვნური ინტელექტის მოდელების ეფექტურობისთვის
Hugging Face წარმოგიდგენთ „quanto“-ს, PyTorch-ის კვანტიზაციის ახალ ბეკენდს Optimum-ისთვის, რომელიც შექმნილია ღრმა სწავლების მოდელების კვანტიზაციის გასამარტივებლად და სტანდარტიზებისთვის. Quanto მიზნად ისახავს მსხვილი ენობრივი მოდელების (LLM) უფრო ეფექტურს გახადოს სამომხმარებლო მოწყობილობებისთვის მეხსიერების შემცირებით და სპეციალიზებული აპარატურის ოპტიმიზაციების ჩართვით, გთავაზობთ მრავალმხრივ და მოწყობილობისგან დამოუკიდებელ გადაწყვეტას.

კონკურსი LLM-ების სამეცნიერო ცოდნისა და ადრეული განვითარების შესაფასებლად
დიდი ენობრივი მოდელების (LLM) ადრეული ტრენინგის ეტაპების შეფასება, განსაკუთრებით სამეცნიერო ცოდნის დომენში, არსებული ბენჩმარკებით გამოწვევას წარმოადგენს. Hugging Face-ზე დაწყებული კონკურსი მიზნად ისახავს ახალი, ეფექტური ბენჩმარკების შექმნას, რომლებიც ამ გამოწვევას გაუმკლავდება. მონაწილეები შეაფასებენ თავიანთ გადაწყვეტილებებს სიგნალის ხარისხის, რანჟირების თანმიმდევრულობისა და სამეცნიერო ცოდნასთან შესაბამისობის კრიტერიუმებით.
BLOOM: წარდგენილია მსოფლიოში პირველი გამჭვირვალე, მრავალენოვანი დიდი ენობრივი მოდელი (LLM)
დიდი ენობრივი მოდელები (LLM) რევოლუციას ახდენენ ხელოვნური ინტელექტის კვლევებში, თუმცა მათზე სრული წვდომა მხოლოდ შეზღუდულ ინდუსტრიულ ლაბორატორიებს აქვთ. ამ სტატუს კვოს შესაცვლელად წარმოდგენილია BLOOM – პირველი მრავალენოვანი LLM, რომელიც სრული გამჭვირვალობით გაიარა ტრენინგი. 176 მილიარდი პარამეტრით, BLOOM-ს შეუძლია ტექსტის გენერირება 46 ბუნებრივ და 13 პროგრამირების ენაზე. ეს არის AI მკვლევართა ყველაზე მასშტაბური თანამშრომლობის შედეგი, რაც მოდელს ხელმისაწვდომს ხდის ფართო სამეცნიერო საზოგადოებისთვის
კოსმოპედია: უპრეცედენტო სინთეზური მონაცემები დიდი ენობრივი მოდელებისთვის
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) წვრთნისთვის ძვირადღირებული ადამიანური ანოტაციებიდან სინთეზურ მონაცემთა ნაკრებებზე გადასვლას. მიუხედავად იმისა, რომ Microsoft-ის Phi მოდელებმა სინთეზური მონაცემების გამოყენებით შესანიშნავი შედეგები აჩვენეს, მათი შექმნის დეტალები გაუმჟღავნებელი დარჩა. ამ ხარვეზის აღმოსაფხვრელად, წარმოდგენილია კოსმოპედია – უმსხვილესი ღია სინთეზური მონაცემთა ნაკრები (30 მილიონზე მეტი ფაილი, 25 მილიარდი „ტოკენი“), რომელიც გენერირებულია Mixtral-8x7B-Instruct-v0.1-ის მიერ

SmolLM3: მაღალი წარმადობა 3 მილიარდ პარამეტრზე და ინოვაციური საინჟინრო გეგმა
ახალი 3 მილიარდპარამეტრიანი ენობრივი მოდელი, SmolLM3, აჭარბებს კონკურენტებს, როგორიცაა Llama-3.2-3B და Qwen2.5-3B, ამასთანავე, კონკურენტუნარიანია უფრო დიდ 4 მილიარდპარამეტრიან მოდელებთან (Qwen3 და Gemma3). მისი შემქმნელები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას, არქიტექტურულ დეტალებს, მონაცემთა ნარევებსა და სამსაფეხურიან წინასწარი ვარჯიშის სტრატეგიას. ეს გამჭვირვალე მიდგომა, რომელიც მოიცავს ისეთ ინოვაციებს, როგორიცაა Grouped Query Attention (GQA) და NoPE, მიზნად ისახავს AI საზოგადოებისთვ
SmolLM3: ოპტიმალური ეფექტურობის 3B მოდელი სრული საინჟინრო პროექტით
SmolLM3-ის 3 მილიარდი პარამეტრის მოდელი აღემატება Llama-3.2-3B და Qwen2.5-3B მოდელებს, ამავდროულად ინარჩუნებს კონკურენტუნარიანობას უფრო დიდ 4B ალტერნატივებთან (Qwen3 და Gemma3). მისი უნიკალურობა მდგომარეობს იმაში, რომ დეველოპერები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას – არქიტექტურის დეტალებს, მონაცემთა შერევის მეთოდებსა და სამეტაპიან წინასწარ ვარჯიშის მიდგომას, რაც ჩვეულებრივ თვეების უკუინჟინერიას მოითხოვდა. არქიტექტურული ინოვაციები მოიცავს Grouped Query Attention (GQA), NoPE პოზიციური

როგორ გავუშვათ მოწინავე LLM-ები ჩვეულებრივ ლეპტოპზე?
ოდესღაც შეუძლებლად მიჩნეული მაღალეფექტური დიდი ენობრივი მოდელების (LLM) გაშვება ჩვეულებრივ პერსონალურ კომპიუტერებზე დღეს უკვე რეალობაა. სტატია იკვლევს, თუ როგორ ხდის თანამედროვე ტექნოლოგიები, როგორიცაა აპარატურის აჩქარება (მათ შორის Intel Meteor Lake-ის NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია, შესაძლებელს ამ მიღწევას. განხილულია Microsoft-ის Phi-2 მოდელისა და Intel OpenVINO-ს ინტეგრაციის გამოყენება Intel Core Ultra პროცესორზე, რათა LLM-ები ეფექტურად იმუშაოს საშუალო დონის ლეპტოპებზე.
როგორ გავუშვათ მოწინავე ხელოვნური ინტელექტის მოდელები ჩვეულებრივ ლეპტოპებზე?
თანამედროვე დიდი ენობრივი მოდელები (LLM) ძლიერ აპარატურას მოითხოვს, რაც ხელმისაწვდომი ლეპტოპებისთვის გამოწვევას წარმოადგენს. თუმცა, ხელოვნური ინტელექტის საზოგადოება აქტიურად მუშაობს მოდელების ზომის შემცირებაზე და მათ ოპტიმიზაციაზე. ამ მიზნის მისაღწევად გამოიყენება სამი ძირითადი მიდგომა: აპარატურული აჩქარება (მათ შორის Intel-ის ახალი NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია. ამ სტატიაში განხილულია, თუ როგორ შეიძლება Microsoft Phi-2 მოდელის 4-ბიტიანი კვანტიზაცია Intel OpenVINO-სა და Opti

MCP პროტოკოლი: Hugging Face Spaces როგორც LLM-ის შესაძლებლობების „აპლიკაციების მაღაზია“
მოდელის კონტექსტის პროტოკოლი (MCP) არის ღია სტანდარტი, რომელიც დეველოპერებს საშუალებას აძლევს, შექმნან უსაფრთხო, ორმხრივი კავშირები დიდ ენობრივ მოდელებსა (LLM) და ინსტრუმენტების კომპლექტს შორის. ამ ინტეგრაციის წყალობით, Hugging Face Spaces, რომელიც Gradio-ს მეშვეობით აერთიანებს ათასობით AI აპლიკაციას, იქცევა LLM-ებისთვის „აპლიკაციების მაღაზიად“, სადაც მათ შეუძლიათ შეიძინონ ახალი შესაძლებლობები, როგორიცაა გამოსახულების რედაქტირება ან ვიდეო ტრანსკრიფცია, რაც LLM-ებს საშუალებას აძლევს, გაცილდნენ მა